跳至内容
人工智能
大语言模型

LLM 蒸馏详解:应用、实现与更多

蒸馏是一种用于 LLM 训练的技术,通过让更小、更高效的模型(如 GPT-4o mini)模仿更大、更复杂模型(如 GPT-4o)的行为与知识来进行学习。
Stanislav Karzhev's photo
Stanislav Karzhev
已更新 · 12分钟 阅读

使用 AI 探索

ChatGPTClaudePerplexity

创建您的免费账户

实践并学习路径你的进步。

使用 Google 继续
继续操作即表示您接受我们的《使用条款》和《隐私政策》,并同意您的数据存储在美国。

大型语言模型(LLM)不断在复杂度与规模上增长,部署它们面临诸多挑战。

LLM 蒸馏成为应对这一问题的有力方案,可将大型、复杂的语言模型(“教师”)中的知识迁移到体量更小、更高效的版本(“学生”)。

近期 AI 领域的一个例子是将GPT-4o mini(学生)从GPT-4o(教师)中蒸馏得到。

这一过程可类比为教师向学生传授经验,目标是在不携带大型模型复杂性“包袱”的情况下提炼关键信息。一起深入了解吧!

什么是 LLM 蒸馏?

LLM 蒸馏是一种在尽量保持大型语言模型性能的同时,减少其规模与计算开销的技术。 

想象一位资深教授向新生分享专长。教授代表教师模型,传达复杂概念与洞见;学生模型则以更简化、更高效的方式学习并模仿这些“教导”。 

该过程既保留教师的核心能力,又优化学生以实现更快、更灵活的应用。

为什么 LLM 蒸馏很重要?

大型语言模型的体量不断增长,其计算需求也水涨船高,阻碍了广泛采用与部署。对高性能硬件与不断增加的能耗的依赖,常使这些模型难以触达,尤其是在资源受限的环境,如移动设备或边缘计算平台。

LLM 蒸馏通过生成更小更快的模型来应对这些挑战,使其更易集成到更广泛的设备与平台中。 

这一创新不仅让更多人能够接触先进 AI,也支持速度与效率同样关键的实时应用。通过提升可达性与可扩展性,LLM 蒸馏推动了 AI 技术的落地实施。

LLM 蒸馏如何运作:知识迁移过程

LLM 蒸馏包含多种技术,确保学生模型在更高效运行的同时保留关键信息。以下介绍实现高效知识迁移的核心机制。

教师—学生范式

在 LLM 蒸馏的核心,是教师—学生范式,它驱动着知识迁移。在这种设置中,体量更大、能力更强的模型将知识传递给更小、更轻量的模型。

教师模型通常是具备大量训练与计算资源的前沿语言模型,信息极为丰富。学生模型则通过模仿教师的行为来学习,并内化其知识。

学生模型的首要任务是在显著更小的规模与更低的计算需求下,复现教师的输出。这要求学生观测并学习教师在不同输入上的预测、调整与响应。

通过这种方式,学生可达到相近的性能与理解力,适合在资源受限环境中部署。 

蒸馏技术

为实现教师到学生的知识迁移,可采用多种蒸馏技术。这些方法不仅提升学生的学习效率,还确保其保留教师模型的关键知识与能力。以下是 LLM 蒸馏中常见的技术。

知识蒸馏(KD)

LLM 蒸馏中最具代表性的技术之一是知识蒸馏(KD)。在 KD 中,学生模型在训练时会同时使用教师模型的输出概率(即软目标)与真实标签(即硬目标)。 

软目标提供了教师预测的细腻视角,给出对可能输出的概率分布,而非单一正确答案。这些额外信息有助于学生捕捉教师响应中编码的细微模式与复杂知识。

借助软目标,学生更易理解教师的决策过程,从而获得更准确、更可靠的表现。该方法既保留教师的关键信息,也让学生的训练过程更顺滑、更高效。 
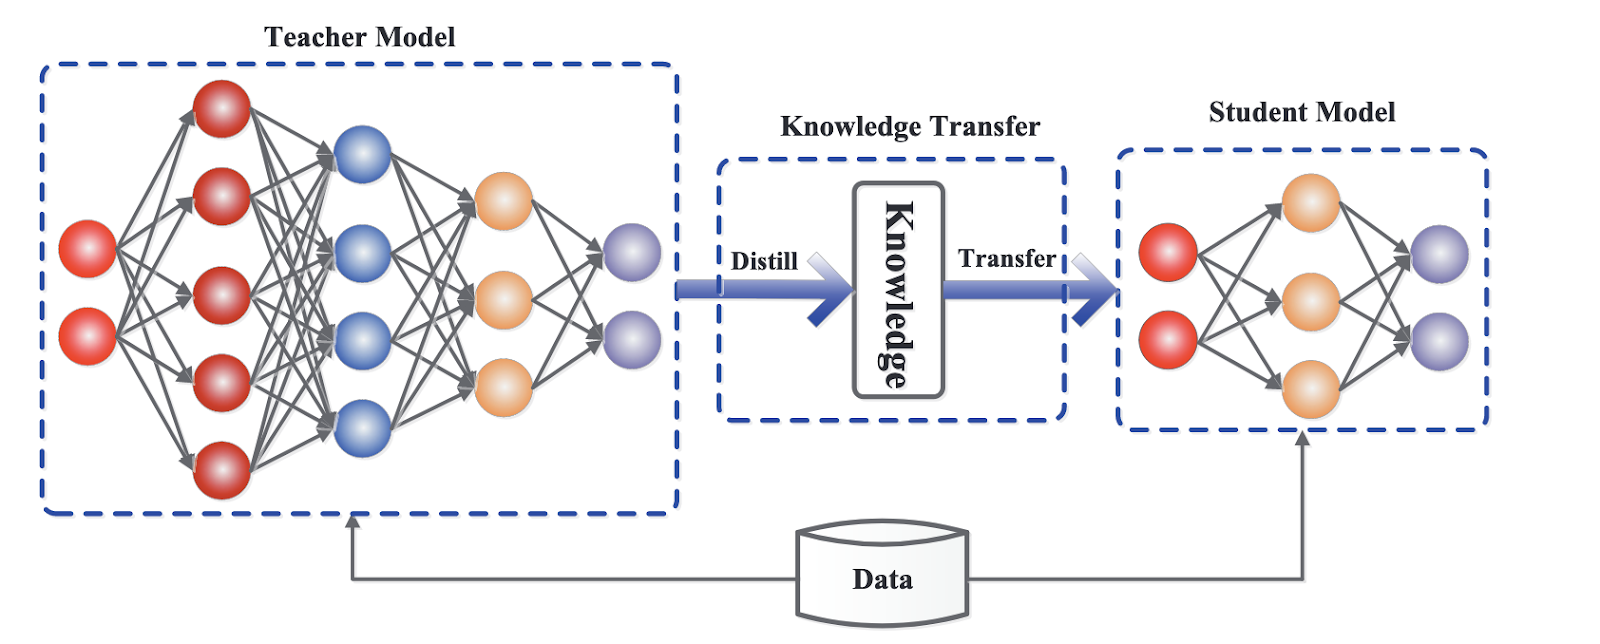
Diagram illustrating the generic student-teacher framework for knowledge distillation.

知识蒸馏的一般框架。来源

其他蒸馏技术

除 KD 外,还有多种方法可改进 LLM 蒸馏过程:

  • 数据增强: 使用教师模型生成额外训练数据。更大、更包容的数据集可让学生接触更广泛的情景与示例,提升泛化能力。
  • 中间层蒸馏: 不仅关注最终输出,还从教师模型的中间层向学生传递知识。学习这些中间表征可帮助学生捕捉更细致、结构化的信息,从而整体性能更佳。
  • 多教师蒸馏: 学生可同时向多个教师学习。聚合多位教师的知识能带来更全面的理解与更强的鲁棒性,融合不同视角与洞见。

LLM 蒸馏的优势

LLM 蒸馏带来多方面的显著收益,提升语言模型的可用性与效率,使其更适用于多元场景。

下面介绍几个关键优点。

更小的模型体量

首要收益之一是能得到显著更小的模型。通过将大型教师模型的知识转移给较小的学生模型,学生能保留教师的大部分能力,但体量仅为其一小部分。 

体量缩小带来:

  • 更快推理: 更小的模型处理数据更快,响应时间更短。
  • 更低存储需求: 更小的模型占用空间更少,便于存储与管理,尤其适用于存储受限的环境。

更快的推理速度

蒸馏后的小模型可直接带来更快的推理速度。对于需要实时处理与快速响应的应用,这尤为重要。 

具体体现在:

  • 实时应用: 更快的推理速度使蒸馏模型能用于实时应用,如聊天机器人、虚拟助手与交互系统,对时延要求高的场景尤为合适。
  • 资源受限设备: 蒸馏模型可部署在计算资源有限的设备上,如智能手机、平板与边缘设备,且不牺牲性能。

更低的计算成本

LLM 蒸馏的另一大优势是降低计算成本。小模型运行所需算力更少,从而在多个方面节省成本:

  • 云环境: 在云环境运行更小的模型,减少对昂贵高性能硬件的需求并降低能耗。
  • 本地部署: 对于偏好本地部署的组织,小模型意味着更低的基础设施与运维成本。

更广的可达性与部署

蒸馏后的 LLM 更通用且更易获取,便于跨平台部署。这种扩展带来多方面影响:

  • 移动设备: 可在移动设备上部署蒸馏模型,以便以便携、友好的形式提供先进 AI 功能。
  • 边缘设备: 在边缘设备上运行可将 AI 能力更贴近数据产生处,减少对持续联网的依赖并提升数据隐私。
  • 更广泛的应用: 从医疗到金融再到教育,蒸馏模型都可集成到大量场景中,使先进 AI 能力触达更多行业与用户。

蒸馏 LLM 的应用

LLM 蒸馏的价值不仅在于效率与成本。蒸馏后的语言模型可广泛应用于各类自然语言处理(NLP)任务与行业场景,使 AI 方案能在多个领域落地。

高效的 NLP 任务

蒸馏 LLM 在诸多 NLP 任务上表现出色。其体量更小、性能更优,尤其适用于需实时处理且算力要求较低的任务。

聊天机器人

蒸馏 LLM 能驱动更小、更快的聊天机器人,流畅处理客服与支持任务。在无需大量算力的前提下,能够实时理解并回应用户问题,提供顺畅的体验。

文本摘要

基于蒸馏 LLM 的摘要工具,可将新闻、文档或社交媒体内容压缩为简明摘要,帮助用户快速把握要点,而无需阅读全文。

机器翻译

蒸馏模型让翻译服务在各类设备上更快、更易用。它们可部署在手机、平板,甚至离线应用中,提供更低时延与更小开销的实时翻译。

其他任务

蒸馏 LLM 不仅适用于常见 NLP 任务,在需要快速处理与高准确度的专门领域同样出色。

  • 情感分析:分析文本情感(如评论或社交媒体帖)更轻松、更迅速,帮助企业快速把握舆情与客户反馈。
  • 问答系统: 蒸馏模型可驱动精准、及时的问答系统,提升虚拟助手与教育工具中的用户体验。
  • 文本生成: 无论是内容创作、故事生成,还是自动化报告撰写,蒸馏 LLM 都能更顺畅地生成连贯、上下文相关的文本。

行业场景

蒸馏 LLM 不仅局限于通用 NLP 任务,还能在众多行业中优化流程、改善体验并推动创新。

医疗

在医疗行业,蒸馏 LLM 能更高效地处理病历与诊断数据,支持更快更准的诊断。此类模型可部署在医疗设备中,为医生与医护人员提供实时数据分析与决策支持。

金融

在金融领域,蒸馏模型可升级欺诈检测系统与客户交互模型。通过快速识别交易模式与客户问题,蒸馏 LLM 有助于防范欺诈,并提供个性化的理财建议与支持。

教育

在教育领域,蒸馏 LLM 有助于打造自适应学习系统与个性化辅导平台。系统可分析学生表现并提供定制内容,提升学习效果,让教育更普惠、更具影响力。

LLM 蒸馏的实施

实施 LLM 蒸馏需要一系列步骤,并借助专门的框架与库来简化流程。以下介绍蒸馏大型语言模型所需的工具与步骤。

框架与库

为简化蒸馏过程,有若干框架与库可用,各具特色,支持 LLM 蒸馏。

Hugging Face transformers

备受欢迎的Hugging Face transformers 库提供了 Distiller 类,简化教师向学生的知识迁移过程。 

借助 Distiller 类,实践者可利用预训练模型,在特定数据集上微调,并应用蒸馏技术以获得理想效果。

其他库

除 Hugging Face Transformers 外,还有许多库支持 LLM 蒸馏:

  • TensorFlow 模型优化: 提供剪枝、量化与蒸馏工具,是构建高效模型的多面手。
  • PyTorch distiller: PyTorch 的Distiller 旨在压缩深度学习模型,支持多种蒸馏技术,并提供一系列工具以管理蒸馏流程与提升效率。
  • DeepSpeed: 由微软开发的深度学习优化库,包含模型蒸馏相关特性,支持大型模型的训练与部署。

实施步骤

实施 LLM 蒸馏需要周密规划与执行。以下为关键步骤。

数据准备

首先要准备适合训练学生模型的数据集。数据应能代表模型将要执行的任务,确保学生具备良好的泛化能力。 

同时可采用数据增强,为学生提供更广的样本范围。

教师模型选择

选择合适的教师模型对蒸馏成功至关重要。教师应是表现良好的预训练模型,并在目标任务上具备高准确度。教师模型的质量与特性将直接影响学生表现。

蒸馏过程

蒸馏过程包括以下步骤:

  1. 训练配置: 初始化学生模型并配置训练环境,包括学习率、批大小等超参数。
  2. 知识迁移: 使用教师模型为训练数据生成软目标(概率分布)。结合硬目标(真实标签)共同训练学生模型。
  3. 训练循环: 基于软目标与硬目标的组合训练学生模型。优化目标是最小化损失函数,即学生预测与教师提供的软目标之间的差异。

评估指标

评估蒸馏后模型的表现至关重要,以确保其达标。常见评估指标包括:

  • 准确率: 衡量学生模型相对真实标签的正确预测比例。
  • 推理速度: 评估模型处理输入并生成输出所需时间。
  • 模型体量: 评估模型大小的缩减,以及由此带来的存储与计算效率收益。
  • 资源使用: 监测学生模型在推理时的资源占用,确认其满足部署环境的约束。

关于 LLM 评估,我在这篇文章中有更深入的介绍:LLM 评估:指标、方法论与最佳实践。

LLM 蒸馏:挑战与最佳实践

尽管 LLM 蒸馏优势众多,但也存在需要应对的挑战,以确保成功落地。

知识流失

LLM 蒸馏的主要障碍之一是可能出现知识流失。在蒸馏过程中,教师模型中的某些细微信息与特征可能未被学生充分捕捉,导致性能下降,尤其在需要深度理解或专业知识的任务中更为明显。

以下策略可缓解知识流失:

  • 中间层蒸馏: 从教师的中间层迁移知识,帮助学生获取更细致、结构化的信息。
  • 数据增强: 利用教师生成的增强数据,给学生提供更广的训练样本,促进学习。
  • 迭代蒸馏: 通过多轮蒸馏逐步优化学生,使其逐渐捕捉到更多教师知识。

超参数调优

谨慎的超参数调优对蒸馏成功至关重要。诸如温度与学习率等关键超参数,会显著影响学生从教师学习的能力:

  • 温度: 控制教师输出概率分布的平滑度。更高温度会产生更“柔和”的分布,有助于学生更充分地从教师预测中学习。
  • 学习率: 合理设置学习率可在训练速度与稳定性间取得平衡。适当的学习率可确保学生收敛至较优解,避免过拟合或欠拟合。

效果评估

评估蒸馏模型的有效性至关重要,以确保其达到预期表现,尤其是相对于其前辈与替代方案。这包括将学生与教师及其他基线进行对比,判断蒸馏在多大程度上保留或提升了模型功能。 

评估时应关注以下指标:

  • 准确率: 比较学生相对教师与其他基线的准确率,了解精度的保留或损失情况。
  • 推理速度: 对比学生与教师的推理速度,突出处理时间的改进。
  • 模型体量: 比较学生与教师以及其他基线的大小差异,评估蒸馏带来的效率提升。
  • 资源使用: 分析学生与教师在资源占用上的差异,确保在不牺牲性能的前提下,学生提供更具性价比的选择。

最佳实践

遵循最佳实践可显著提升 LLM 蒸馏效果,这些原则强调实验、持续评估与策略性实施。

  • 持续试验: 定期尝试不同的蒸馏技术与超参数设置,为您的具体场景找出最优配置。
  • 持续评估: 持续使用相关基准与数据集评估学生模型表现。迭代测试与优化是达成最佳结果的关键。
  • 平衡训练: 结合教师的软目标与硬目标,确保训练过程平衡。此举有助于学生既捕捉细腻知识,又保持准确性。
  • 定期更新: 关注 LLM 蒸馏研究的最新进展,将新技术与新发现融入您的蒸馏流程。

研究进展与未来方向

LLM 蒸馏领域正在快速演进。本节将探讨最新趋势、当前研究挑战与新兴技术。

最新研究与进展

近期研究聚焦于提出新的技术与架构,以提升蒸馏过程的效率与效果。值得关注的进展包括:

  • 渐进式蒸馏: 分阶段蒸馏知识,即通过中间学生模型逐步从教师蒸馏。该技术有望提升最终学生模型的性能与稳定性。
  • 任务无关蒸馏: 研究者探索以任务无关的方式蒸馏知识,使学生无需针对特定任务进行微调也能跨任务泛化,从而大幅减少新应用的训练时间与算力成本。
  • 跨模态蒸馏: 在文本、图像、音频等不同模态间进行知识蒸馏,旨在打造能处理多种输入数据的多才多艺学生模型,拓展蒸馏模型的适用范围。

未解问题与未来方向

尽管进展显著,LLM 蒸馏仍有若干挑战与开放问题:

  • 提升泛化: 如何进一步增强蒸馏模型的泛化能力,使其在多种任务与数据集上稳定表现,仍是研究重点。
  • 跨领域迁移: 在不同领域间进行有效的知识迁移同样关键。如何将蒸馏得到的知识应用到全新且差异显著的领域而不显著损失性能,是重要目标。
  • 可扩展性: 如何高效地将蒸馏技术扩展到更大的模型与数据集,是持续挑战。研究正致力于优化流程,以实现更好的可扩展性。

新兴技术

为应对这些挑战并推动领域发展,不断有新技术与创新提出,颇具前景的方法包括:

  • 零样本与小样本适配: 将零样本与小样本学习能力融入蒸馏模型是热门方向。这些技术让模型在几乎没有任务专属数据的情况下执行任务,提升通用性与实用性。
  • 自蒸馏: 学生模型使用自身预测作为软目标来训练。通过迭代利用已学知识,可提升模型性能与鲁棒性。
  • 对抗蒸馏: 将对抗训练与蒸馏结合。对抗蒸馏不仅让学生模仿教师,还要提升其抵御对抗攻击的能力,增强安全性与可靠性。

结语

LLM 蒸馏是让大型语言模型更实用、更高效的关键技术。通过将复杂教师模型的核心知识迁移至更小的学生模型,既保留性能,又降低体量与计算需求。

这一过程让从实时 NLP 任务到医疗、金融等专门场景的 AI 应用更快、更易获取。尽管实施需要周密规划与合适工具,但其带来的益处——如更低成本与更广部署——十分可观。

随着研究不断推进,LLM 蒸馏将在推动 AI 普及中发挥越来越重要的作用,使强大的模型在更多情境下可用、易用。


Stanislav Karzhev's photo
Author
Stanislav Karzhev
LinkedIn

刚毕业的理学硕士,专攻人工智能

主题
人工智能
大语言模型

通过这些课程学习 LLM!

课程

Large Language Models (LLMs) 概念

2 小时
113.3K
通过我们的概念性课程,发掘 LLM 的全部潜力,涵盖 LLM 应用、训练方法、伦理考量和最新研究。
查看详情开始课程

创建您的免费账户

实践并学习路径你的进步。

使用 Google 继续
继续操作即表示您接受我们的《使用条款》和《隐私政策》,并同意您的数据存储在美国。
查看更多