

配置 AWS CLI 与 AWS S3
在深入 aws s3 cp 命令之前,您需要在系统上安装并正确配置 AWS CLI。即便您从未使用过 AWS 也无需担心——整个设置过程很简单,通常不超过 10 分钟。
我会将其拆解为三个简单阶段:安装 AWS CLI 工具、配置您的凭证,以及创建您的第一个用于存储的 S3 存储桶。
安装 AWS CLI
安装步骤会因您所使用的操作系统而略有不同。
Windows 系统:
- 前往官方 AWS CLI 文档页面
- 下载 64 位 Windows 安装程序
- 启动下载的文件并按照安装向导完成安装
Linux 系统:
在终端中运行以下三条命令:
curl "https://awscli.amazonaws.com/awscli-exe-linux-x86_64.zip" -o "awscliv2.zip"
unzip awscliv2.zip
sudo ./aws/installmacOS 系统:
假设您已安装 Homebrew,在终端中运行这行命令:
brew install awscli如果您没有安装 Homebrew,请改用以下两条命令:
curl "https://awscli.amazonaws.com/AWSCLIV2.pkg" -o "AWSCLIV2.pkg"
sudo installer -pkg AWSCLIV2.pkg -target /为确认安装成功,请在终端中运行 aws --version。您应能看到类似如下的输出:
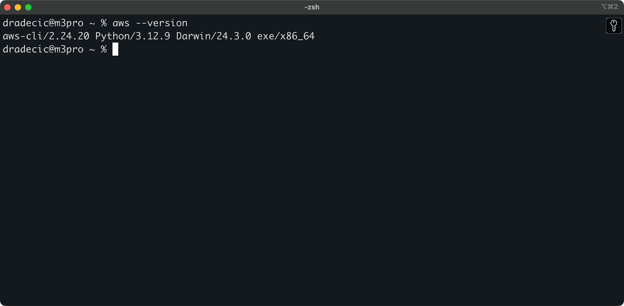
图片 1 - AWS CLI 版本
配置 AWS CLI
安装好 CLI 后,就该设置 AWS 凭证以进行身份验证了。
首先登录您的 AWS 账户并进入 IAM 服务控制台。创建一个具有编程访问权限的新用户,并附加合适的 S3 权限策略:
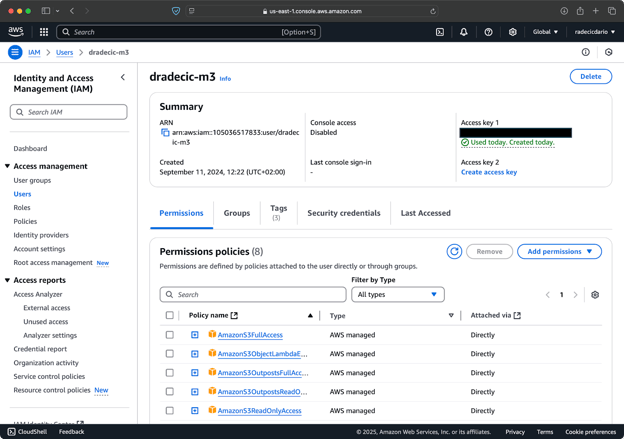
图片 2 - AWS IAM 用户
接着,访问“安全凭证”(Security credentials)选项卡并生成新的访问密钥对。务必妥善保存访问密钥 ID 与私有访问密钥——离开该页面后 Amazon 不会再显示私钥:
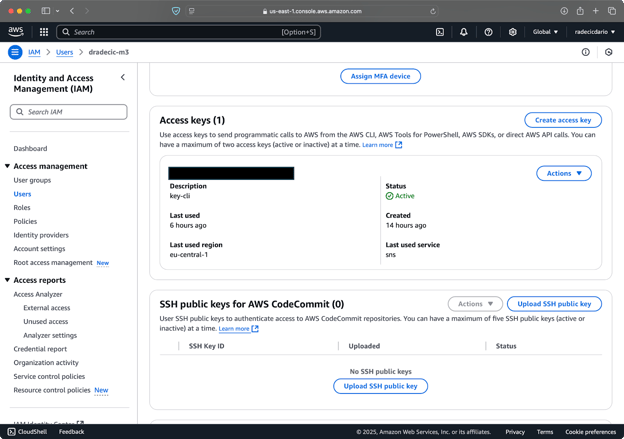
图片 3 - AWS IAM 用户凭证
现在打开终端并执行 aws configure 命令。系统会提示您输入四项信息:访问密钥 ID、私有访问密钥、默认区域(本文示例使用 eu-central-1),以及首选输出格式(通常为 json):
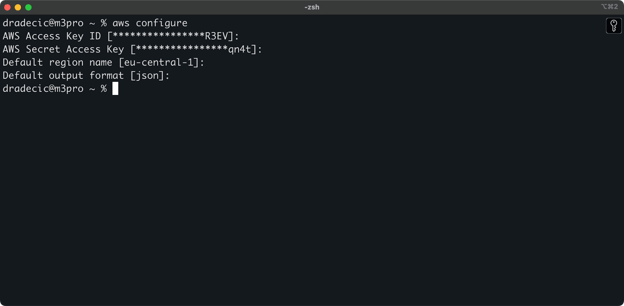
图片 4 - AWS CLI 配置
为确保连接正常,请运行以下命令验证身份:
aws sts get-caller-identity若配置正确,您将看到账户详细信息:
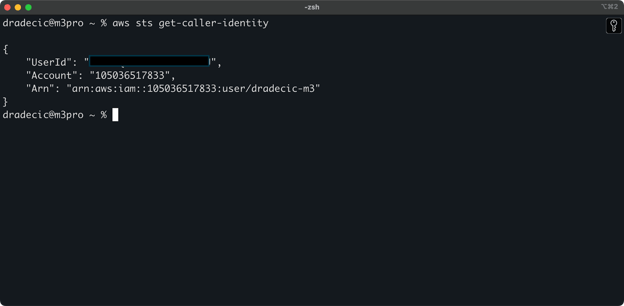
图片 5 - AWS CLI 测试连接命令
创建 S3 存储桶
最后,您需要创建一个 S3 存储桶,用于存放即将复制的文件。
前往 AWS 控制台的 S3 服务页面并点击“Create bucket”。请记住,存储桶名称在整个 AWS 中必须全局唯一。选择一个独特的名称,暂时保留默认设置,然后点击“Create”:
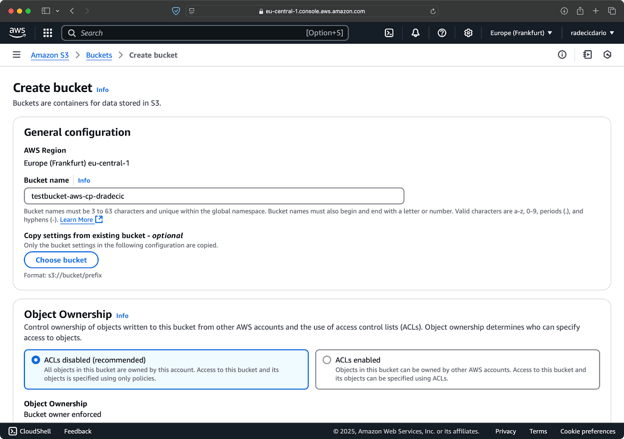
图片 6 - 创建 AWS 存储桶
创建完成后,新的存储桶会显示在控制台中。您也可以通过命令行确认其存在:
aws s3 ls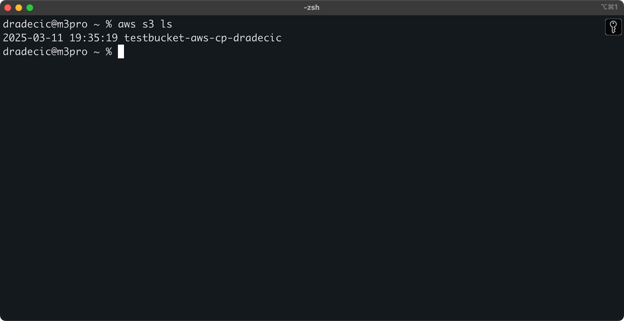
图片 7 - 所有可用的 S3 存储桶
所有 S3 存储桶默认均为私有,请牢记这一点。如果您打算将该存储桶用于公开访问的文件,需要相应修改存储桶策略。
现在,您已完全具备使用 aws s3 cp 进行文件传输的条件。接下来从基础开始。
AWS S3 cp 命令的基础语法
既然一切都已就绪,让我们深入了解 aws s3 cp 命令的基础用法。和 AWS 的一贯风格一样,其美在于简洁,即便该命令能应对多种文件传输场景。
最基础的形式中,aws s3 cp 命令遵循如下语法:
aws s3 cp <source> <destination> [options]其中 <source> 与 <destination> 可以是本地文件路径或以 s3:// 开头的 S3 URI。我们来看看三种最常见的用例。
将文件从本地复制到 S3
要将本地系统的文件复制到 S3 存储桶,源为本地路径,目标为 S3 URI:
aws s3 cp /Users/dradecic/Desktop/test_file.txt s3://testbucket-aws-cp-dradecic/test_file.txt该命令会将指定目录中的 test_file.txt 上传到目标 S3 存储桶。若操作成功,您将在控制台看到类似如下输出:
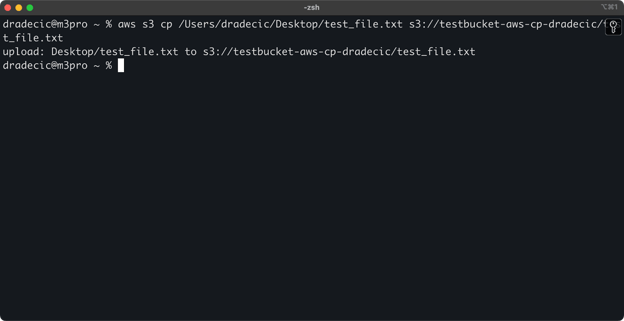
图片 8 - 复制本地文件后的控制台输出
在 AWS 管理控制台中,您也能看到文件已上传:
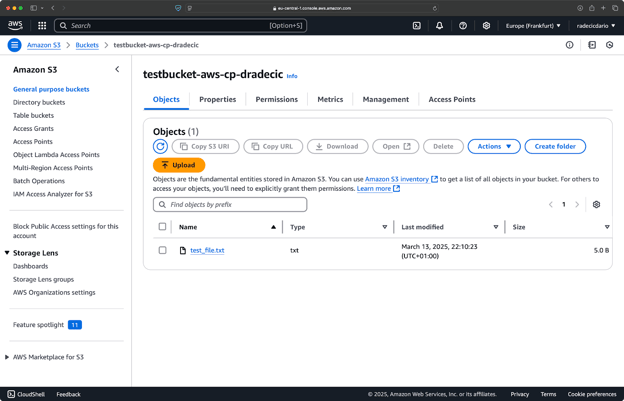
图片 9 - S3 存储桶内容
类似地,如果您想将本地文件夹复制到 S3 存储桶,并例如放入另一个嵌套文件夹中,可运行如下命令:
aws s3 cp /Users/dradecic/Desktop/test_folder s3://testbucket-aws-cp-dradecic/my-desired-folder/test_folder/ --recursive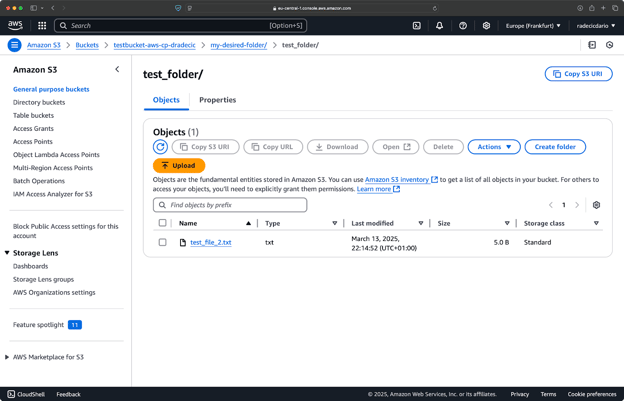
图片 10 - 上传文件夹后的 S3 存储桶内容
--recursive 标志可确保文件夹中的所有文件与子文件夹都会被复制。
但请注意——S3 实际上并不存在“文件夹”,路径结构只是对象键的一部分,不过从概念上与文件夹类似。
将文件从 S3 复制到本地
要将文件从 S3 复制到本地系统,只需将顺序反转——源为 S3 URI,目标为您的本地路径:
aws s3 cp s3://testbucket-aws-cp-dradecic/test_file.txt /Users/dradecic/Documents/s3-data/downloaded_test_file.txt该命令会从您的 S3 存储桶下载 test_file.txt,并在指定目录下保存为 downloaded_test_file.txt。您会立即在本地看到它:
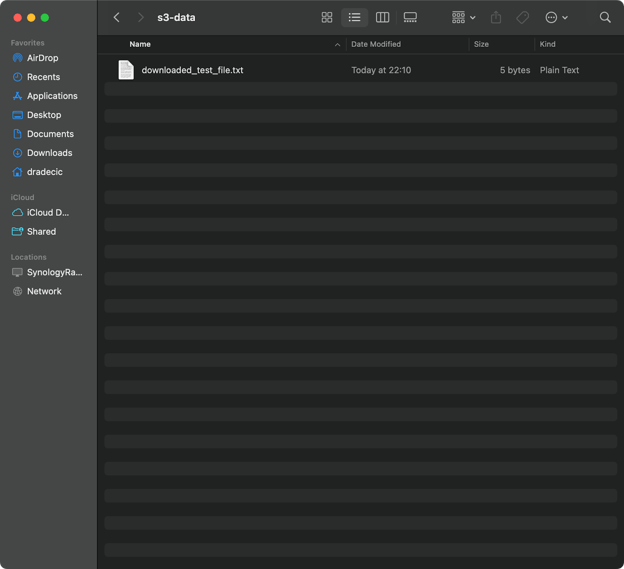
图片 11 - 从 S3 下载单个文件
如果您省略目标文件名,命令将使用原始文件名:
aws s3 cp s3://testbucket-aws-cp-dradecic/test_file.txt .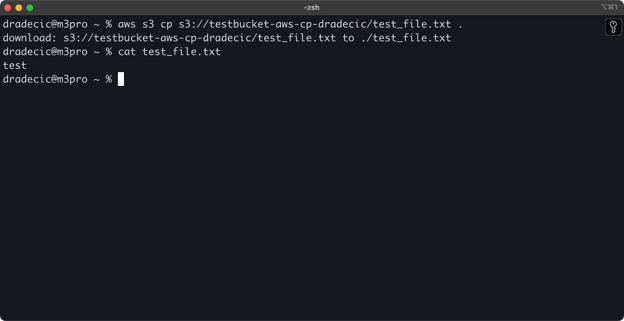
图片 12 - 下载文件的内容
句点(.)代表您当前的目录,因此该命令会将 test_file.txt 下载到当前路径。
最后,若要下载整个目录,可以使用类似如下的命令:
aws s3 cp s3://testbucket-aws-cp-dradecic/my-desired-folder/test_folder /Users/dradecic/Documents/test_folder --recursive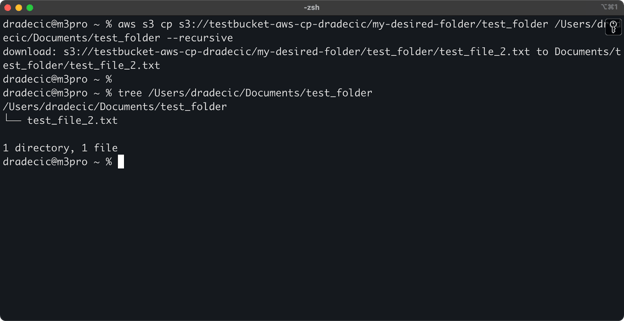
图片 13 - 下载文件夹的内容
请记住,在处理多个文件时,--recursive 标志至关重要——如果源是目录而未加该标志,命令将失败。
掌握了这些基础命令,您已经能完成大多数所需的文件传输任务。但在下一节中,您将学习更多高级选项,以便更好地控制复制过程。
AWS S3 cp 的高级选项与功能
AWS 提供了一些高级选项,帮助您最大化文件复制操作的效率。本节将介绍若干日常工作中非常实用的标志与参数。
使用 --exclude 与 --include 标志
有时您只想复制匹配特定模式的文件。--exclude 与 --include 标志可基于模式筛选文件,精确控制要复制的内容。
先交代一下背景,我当前使用的目录结构如下:
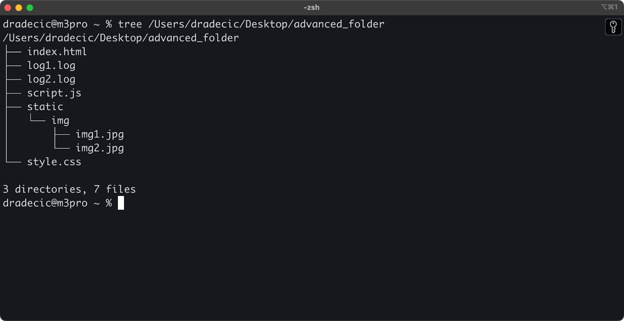
图片 14 - 目录结构
现在,假设您想复制该目录下除 .log 文件外的所有文件:
aws s3 cp /Users/dradecic/Desktop/advanced_folder s3://testbucket-aws-cp-dradecic/advanced_folder/ --recursive --exclude "*.log"该命令会将 advanced_folder 目录中的所有文件复制到 S3,但会排除所有 .log 扩展名的文件:
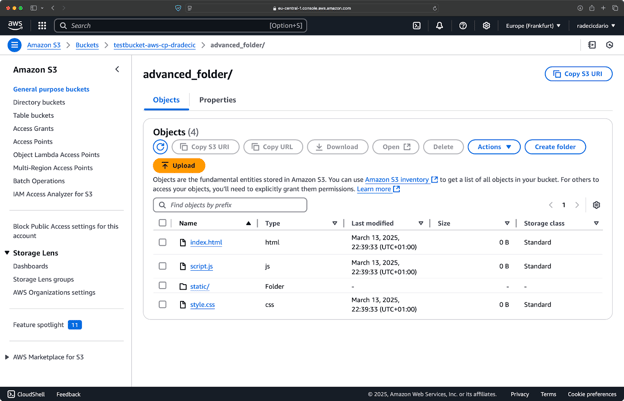
图片 15 - 文件夹复制结果
您也可以组合多个模式。比如只复制项目文件夹中的 HTML 与 CSS 文件:
aws s3 cp /Users/dradecic/Desktop/advanced_folder s3://testbucket-aws-cp-dradecic/advanced_folder/ --recursive --exclude "*" --include "*.html" --include "*.css"该命令先排除全部(--exclude "*"),再仅包含 .html 与 .css 扩展名的文件。结果如下所示:
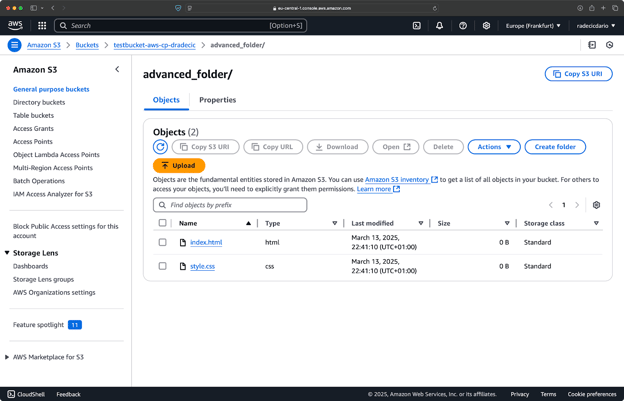
图片 16 - 文件夹复制结果(2)
请注意标志的顺序很重要——AWS CLI 会按顺序处理这些标志,因此如果将 --include 放在 --exclude 之前,结果会不同:
aws s3 cp /Users/dradecic/Desktop/advanced_folder s3://testbucket-aws-cp-dradecic/advanced_folder/ --recursive --include "*.html" --include "*.css" --exclude "*"这一次,存储桶中没有任何内容被复制:
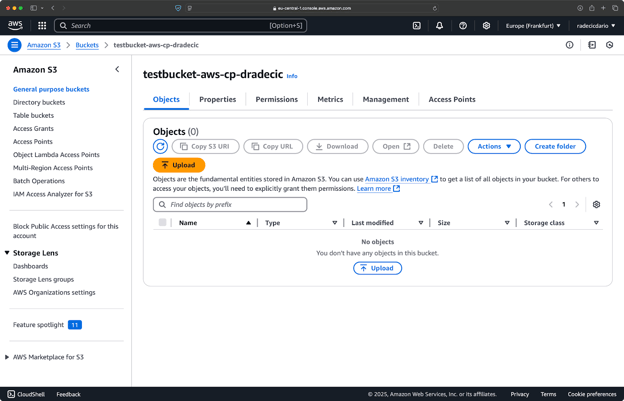
图片 17 - 文件夹复制结果(3)
指定 S3 存储类别
Amazon S3 提供不同的存储类别,成本与取回特性各不相同。默认情况下,aws s3 cp 会将文件上传至 Standard 存储类别,但您可以使用 --storage-class 标志指定其他类别:
aws s3 cp /Users/dradecic/Desktop/large-archive.zip s3://testbucket-aws-cp-dradecic/archives/ --storage-class GLACIER该命令会将 large-archive.zip 上传至 Glacier 存储类别,该类别存储成本很低,但取回成本更高且耗时更长:
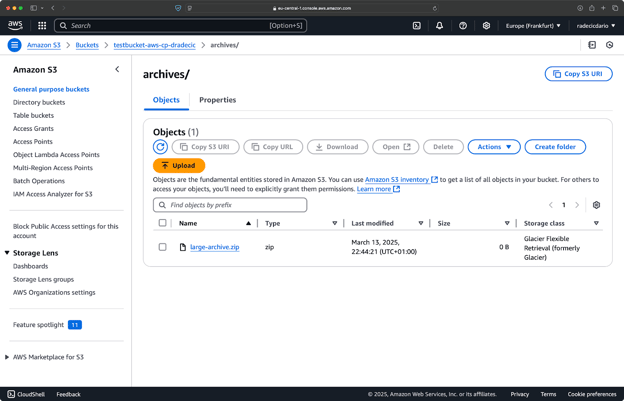
图片 18 - 以不同存储类别复制到 S3
可用的存储类别包括:
STANDARD(默认):通用存储,具备高耐久性与高可用性。REDUCED_REDUNDANCY(不再推荐):较低耐久性、节省成本的选项,现已弃用。STANDARD_IA(低频访问):适用于不常访问的数据,成本较低。ONEZONE_IA(单可用区低频访问):位于单个可用区的低频访问存储,成本更低。INTELLIGENT_TIERING:根据访问模式自动在存储层级间移动数据。GLACIER:低成本归档存储,数据取回需数分钟至数小时。DEEP_ARCHIVE:最低成本的归档存储,取回需数小时,适合长期备份。
如果您在备份短期内无需访问的文件,使用 GLACIER 或 DEEP_ARCHIVE 可显著节省存储成本。
使用 --exact-timestamps 同步文件
当您更新已存在于 S3 的文件时,可能只想复制发生变化的文件。--exact-timestamps 标志可对比源与目标的时间戳来实现这一点。
示例如下:
aws s3 cp /Users/dradecic/Desktop/advanced_folder s3://testbucket-aws-cp-dradecic/advanced_folder/ --recursive --exact-timestamps启用该标志后,命令仅在时间戳与 S3 中已存在文件不一致时才会复制,从而在定期更新大量文件时减少传输时间与带宽消耗。
为何有用?设想在部署场景中,您希望更新应用文件,但不想不必要地传输未变更的资源。
虽然 --exact-timestamps 有助于实现某种程度的同步,但若您需要更完善的方案,请考虑使用 aws s3 sync 替代 aws s3 cp。sync 命令专为保持目录同步而设计,并针对该目的提供更多能力。我在AWS S3 Sync 教程中对其作了详细介绍。
通过这些高级选项,您将更精细地掌控 S3 文件操作。您可以精准定位文件、优化存储成本,并高效地更新文件。下一节将学习如何通过脚本与定时任务实现自动化。
使用 AWS S3 cp 实现文件传输自动化
到目前为止,您已学会如何通过命令行手动在 S3 与本地之间复制文件。使用 aws s3 cp 的一大优势是,您可以轻松实现这些传输的自动化,从而节省大量时间。
我们来看看如何将 aws s3 cp 命令集成到脚本与定时任务中,实现免干预的文件传输。
在脚本中使用 AWS S3 cp
下面是一个简单的 bash 脚本示例:将目录备份到 S3、为备份添加时间戳,并实现错误处理与写入日志文件:
#!/bin/bash
# 设置变量
SOURCE_DIR="/Users/dradecic/Desktop/advanced_folder"
BUCKET="s3://testbucket-aws-cp-dradecic/backups"
DATE=$(date +%Y-%m-%d-%H-%M)
BACKUP_NAME="backup-$DATE"
LOG_FILE="/Users/dradecic/logs/s3-backup-$DATE.log"
# 确保存放日志的目录存在
mkdir -p "$(dirname "$LOG_FILE")"
# 执行备份并将输出写入日志
echo "Starting backup of $SOURCE_DIR to $BUCKET/$BACKUP_NAME" | tee -a $LOG_FILE
aws s3 cp $SOURCE_DIR $BUCKET/$BACKUP_NAME --recursive 2>&1 | tee -a $LOG_FILE
# 检查备份是否成功
if [ $? -eq 0 ]; then
echo "Backup completed successfully on $DATE" | tee -a $LOG_FILE
else
echo "Backup failed on $DATE" | tee -a $LOG_FILE
fi将其保存为 backup.sh,通过 chmod +x backup.sh 赋予可执行权限,即可获得一个可复用的备份脚本!
随后可通过以下命令运行它:
./backup.sh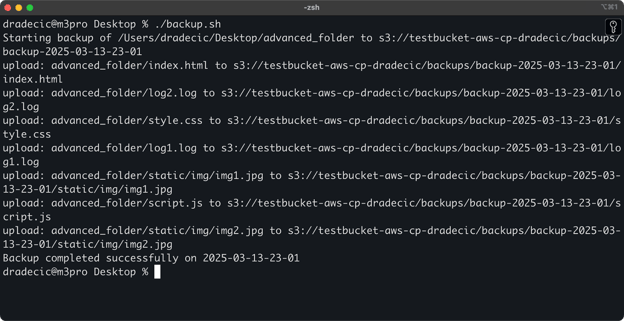
图片 19 - 终端中运行脚本
紧接着,存储桶中的 backups 文件夹会被填充:
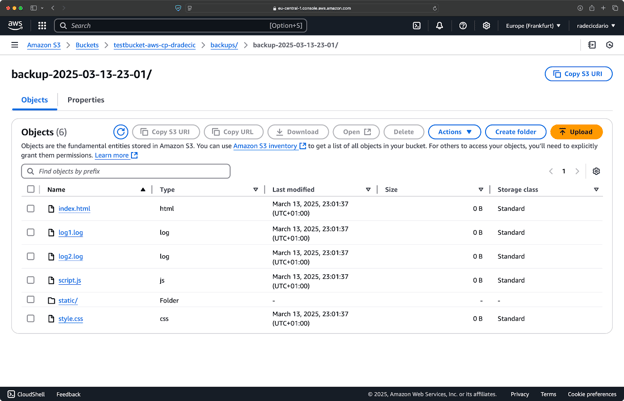
图片 20 - 备份已存入 S3 存储桶
下面我们将更进一步,通过计划任务定时运行脚本。
使用 cron 任务定时传输文件
在拥有脚本之后,下一步就是将其安排在特定时间自动运行。
如果您使用 Linux 或 macOS,可以使用 cron 来安排备份。以下示例展示如何设置一个 cron 任务,每天午夜运行一次备份脚本:
1. 打开个人的 crontab 进行编辑:
crontab -e2. 添加以下行以在每天午夜运行脚本:
0 0 * * * /path/to/your/backup.sh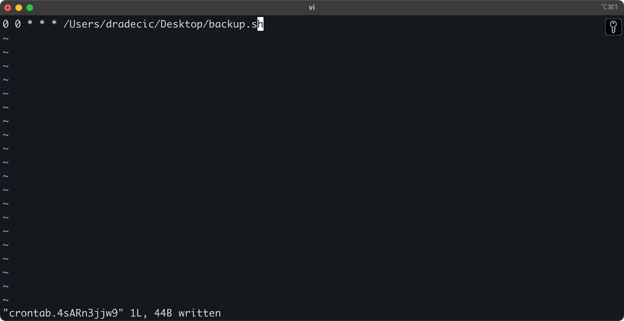
图片 21 - 每日运行脚本的 cron 任务
cron 任务的格式为 minute hour day-of-month month day-of-week command。以下是更多示例:
- 每小时运行一次:
0 * * * * /path/to/your/backup.sh - 每周一上午 9 点运行:
0 9 * * 1 /path/to/your/backup.sh - 每月 1 日运行:
0 0 1 * * /path/to/your/backup.sh
就这样!backup.sh 脚本将按计划周期自动运行。
将 S3 文件传输自动化是理想之选。以下场景尤为适用:
- 重要数据的每日备份
- 与网站同步产品图片
- 将日志文件迁移至长期存储
- 部署更新后的网站文件
通过这些自动化技巧,您可以建立可靠系统,无需人工干预即可处理文件传输。代码只需写一次,之后尽可高枕无忧。
下一节将介绍一些最佳实践,帮助您让 aws s3 cp 的使用更安全、更高效。
使用 AWS S3 cp 的最佳实践
尽管 aws s3 cp 易于使用,但仍可能出现问题。
遵循最佳实践可避免常见陷阱、优化性能并保障数据安全。下面就来探讨这些做法,使您的文件传输更高效。
高效的文件管理
在使用 S3 时,逻辑化地组织文件能为您长期节省时间与精力。
首先,建立一致的存储桶与前缀命名规范。例如,可按环境、应用或日期进行划分:
s3://company-backups/production/database/2023-03-13/
s3://company-backups/staging/uploads/2023-03/此类组织方式更便于:
- 在需要时快速定位特定文件。
- 在正确层级应用存储桶策略与权限。
- 为归档或删除旧数据设置生命周期规则。
另一个提示:在传输大量小文件时,考虑先将小文件打包(使用 zip 或 tar)再上传。这样可减少对 S3 的 API 调用次数,从而降低成本并加快传输。
# 与其复制成千上万的小日志文件
# 不如先打包再上传
tar -czf example-logs-2025-03.tar.gz /var/log/application/
aws s3 cp example-logs-2025-03.tar.gz s3://testbucket-aws-cp-dradecic/logs/2025/03/处理大规模数据传输
在复制大文件或一次性复制大量文件时,有一些技巧可让过程更可靠、更高效。
在脚本中运行时,您可以使用 --quiet 标志以减少输出:
aws s3 cp large-directory/ s3://testbucket-aws-cp-dradecic/backups/ --recursive --quiet该选项会抑制每个文件的进度信息,使日志更易管理;同时还能略微提升性能。
对于超大文件,考虑配合 --multipart-threshold 标志使用分片上传:
aws s3 cp huge-file.iso s3://testbucket-aws-cp-dradecic/backups/ --multipart-threshold 100MB上述设置告知 AWS CLI 将大于 100MB 的文件拆分为多个分片上传。这样有几点好处:
- 若连接中断,仅需重试受影响的分片。
- 分片可并行上传,潜在提升吞吐量。
- 可以暂停并恢复大文件上传。
在跨区域传输数据时,考虑使用 S3 传输加速(Transfer Acceleration)以获得更快的上传速度:
aws s3 cp large-file.zip s3://testbucket-aws-cp-dradecic/backups/ --endpoint-url https://s3-accelerate.amazonaws.com上述做法会通过 Amazon 的边缘网络路由您的传输,可显著加速跨区域传输。
确保安全性
在云端处理数据时,安全性始终应放在首位。
首先,确保您的 IAM 权限遵循最小权限原则,仅授予完成任务所需的特定权限。
以下是您可分配给用户的策略示例:
{
"Version": "2012-10-17",
"Statement": [
{
"Effect": "Allow",
"Action": [
"s3:PutObject",
"s3:GetObject"
],
"Resource": "arn:aws:s3:::testbucket-aws-cp-dradecic/backups/*"
}
]
}该策略仅允许对“my-bucket”中“backups”前缀下的对象进行上传与下载。
另一个提升安全性的方式是启用加密以保护敏感数据。您可以在上传时指定服务端加密:
aws s3 cp confidential.docx s3://testbucket-aws-cp-dradecic/ --sse AES256或者,为了更高的安全性,使用 AWS 密钥管理服务(KMS):
aws s3 cp secret-data.json s3://testbucket-aws-cp-dradecic/ --sse aws:kms --sse-kms-key-id myKMSKeyId不过,对于高度敏感的操作,考虑使用S3 的 VPC 终端节点。这样可将您的流量保持在 AWS 网络内,完全避开公共互联网。
下一节将介绍在使用该命令时可能遇到的常见问题及其排查方法。
排查 AWS S3 cp 错误
可以肯定的是——在使用 aws s3 cp 的过程中,您偶尔会遇到问题。但只要了解常见错误及其解决方法,当事情不按计划进行时就能节省时间与减少挫败感。
本节将展示最常见的问题及其修复方式。
常见错误及修复
错误:“Access Denied”
这大概是您最常遇到的错误:
upload failed: ./myfile.txt to s3://testbucket-aws-cp-dradecic/myfile.txt An error occurred (AccessDenied) when calling the PutObject operation: Access Denied通常意味着以下三种情况之一:
- 您的 IAM 用户没有执行该操作所需的足够权限。
- 存储桶策略限制了访问。
- 您的 AWS 凭证已过期。
排查方法:
- 检查您的 IAM 权限,确保具备所需的
s3:PutObject(上传)或s3:GetObject(下载)权限。 - 确认存储桶策略没有限制您的操作。
- 如果凭证已过期,运行
aws configure进行更新。
错误:“No such file or directory”
当您要复制的本地文件或目录不存在时会出现该错误:
upload failed: ./missing-file.txt to s3://testbucket-aws-cp-dradecic/missing-file.txt An error occurred (404) when calling the PutObject operation: Not Found解决方法很简单——仔细检查文件路径。路径区分大小写,请留意。同时确保在使用相对路径时,您位于正确的目录下。
错误:“The specified bucket does not exist”
如果您看到如下错误:
upload failed: ./myfile.txt to s3://testbucket-aws-cp-dradecic/myfile.txt An error occurred (NoSuchBucket) when calling the PutObject operation: The specified bucket does not exist请检查:
- 存储桶名称是否拼写错误。
- 您是否使用了正确的 AWS 区域。
- 该存储桶是否真实存在(它可能已被删除)。
您可以通过 aws s3 ls 列出所有存储桶以确认正确名称。
错误:“Connection timed out”
网络问题可能导致连接超时:
upload failed: ./largefile.zip to s3://testbucket-aws-cp-dradecic/largefile.zip An error occurred (RequestTimeout) when calling the PutObject operation: Request timeout解决方法:
- 检查您的互联网连接。
- 尝试使用较小文件或为大文件启用分片上传。
- 考虑使用 AWS 传输加速以提升性能。
处理上传失败
在传输大文件时更容易出现错误。这种情况下,请尽量优雅地处理失败。
例如,您可以使用 --only-show-errors 标志,让脚本中的错误诊断更容易:
aws s3 cp large-directory/ s3://testbucket-aws-cp-dradecic/ --recursive --only-show-errors该选项会屏蔽成功传输的消息,仅显示错误,使得大型传输的故障排查更轻松。
对于中断的传输,--recursive 命令会自动跳过在目标位置已存在且大小相同的文件。不过,为了更稳妥,您可以使用 AWS CLI 的内置重试机制来应对网络问题,可设置以下环境变量:
export AWS_RETRY_MODE=standard
export AWS_MAX_ATTEMPTS=5
aws s3 cp large-file.zip s3://testbucket-aws-cp-dradecic/这会让 AWS CLI 在操作失败时自动重试,最多 5 次。
但对于非常庞大的数据集,请考虑使用 aws s3 sync 而非 cp,因为它在处理中断方面表现更佳:
aws s3 sync large-directory/ s3://testbucket-aws-cp-dradecic/large-directory/sync 命令只会传输与目标不同的文件,非常适合在中断后恢复大型传输。
理解这些常见错误并在脚本中实现恰当的错误处理,将使您的 S3 复制操作更加稳健可靠。
总结 AWS S3 cp
总而言之,aws s3 cp 命令是一站式工具,可在本地与 S3 之间相互复制文件。
本文中,您已全面了解它。从基础与环境配置入手,最终编写出定时且自动化的复制脚本。您还学会了如何在移动文件(尤其是大文件)时处理常见错误与挑战。
因此,无论您是开发者、数据从业者还是系统管理员,都能从该命令中受益。熟练掌握的最佳方式就是经常使用。先理解基础,再花些时间将工作中繁琐的部分自动化。
若想深入学习 AWS,请参阅 DataCamp 的以下课程:
您还可以使用 DataCamp 为 AWS 认证考试做准备——AWS Cloud Practitioner(CLF-C02)。
FAQs
什么是 aws s3 cp 命令,它能用于哪些场景?
aws s3 cp 命令是 AWS 命令行界面中的一个工具,可在本地系统与 Amazon S3 存储之间复制文件。它旨在提供与标准 Linux cp 命令类似的命令行体验,但专为与 S3 存储桶交互而定制。您可以用它进行双向传输、递归复制整个目录结构、基于模式筛选文件,甚至指定不同的存储类别以优化成本。对于需要高效管理 S3 存储桶数据的 DevOps 工程师、数据科学家与系统管理员而言尤为实用。
如何设置 AWS CLI 以使用 aws s3 cp 命令?
要设置可使用 aws s3 cp 命令的 AWS CLI,需在系统上安装 AWS CLI、用您的 AWS 凭证进行配置,并创建一个 S3 存储桶。安装流程会因操作系统(Windows、Linux 或 macOS)略有不同。安装完成后,您需运行 aws configure 命令并提供访问密钥 ID、私有访问密钥、默认区域与首选输出格式。最后,您需要通过 AWS 管理控制台或直接使用 AWS CLI 创建一个 S3 存储桶。
aws s3 cp 的基础语法与常见用例是什么?
aws s3 cp 的基础语法为 aws s3 cp <source> <destination> [options],其中 source 与 destination 可以是本地文件路径或以 s3:// 开头的 S3 URI。常见用例包括:将本地文件上传至 S3、从 S3 下载文件到本地,以及使用 --recursive 标志递归复制整个目录。您还可以使用该命令在不同 S3 存储桶之间复制文件、为目标文件指定不同名称,并在存储桶内以嵌套“文件夹”结构组织文件。
如何使用 --exclude 与 --include 标志筛选特定文件?
使用 aws s3 cp 时,--exclude 与 --include 标志可基于模式筛选文件,让您精确控制要复制的内容。例如,您可以复制目录中的全部文件,但排除特定扩展名(如 --exclude "*.log");或先排除全部(--exclude "*"),再仅包含特定类型(如 --include "*.html" --include "*.css")。标志的顺序非常关键,因为 AWS CLI 会按顺序处理它们。借此,您可以为复杂的文件传输场景创建非常精细的筛选规则。
带有 --exact-timestamps 的 aws s3 cp 与 aws s3 sync 有何区别?
两者都可用于更新 S3 中的文件,但目的与行为有所不同。使用 aws s3 cp 配合 --exact-timestamps 时,仅当文件时间戳与 S3 中已存在的不同才会复制,可在更新文件时减少传输时间与带宽消耗。而 aws s3 sync 专为保持目录同步而设计,具备更完善的同步能力。若您需要定期更新大量文件且仅传输变化内容,通常 aws s3 sync 更合适,不过在较简单的同步需求下,配合 --exact-timestamps 的 aws s3 cp 也能胜任。

手动将文件复制到 AWS 存储既繁琐、易出错又低效——尤其是在处理海量数据时。您肯定不想这样做。
AWS 命令行界面(CLI)提供了一个名为
aws s3 cp的便捷工具,可简化这一流程。该命令让您通过简单且可编写脚本的指令,在所有操作系统上都能与 Amazon S3 存储桶之间互相复制文件。使用 AWS CLI 不仅能节省时间,还能实现例行文件传输任务的自动化。aws s3 cp命令提供了众多选项,可应对复杂的文件传输场景。您可以复制单个文件、递归传输整个目录、按模式筛选文件,甚至为成本优化指定不同的存储类别。在本教程中,我将带您全面掌握如何高效使用
aws s3 cp,从基础命令到高级技巧与自动化策略。> 刚接触 AWS,不确定云存储与 S3 的基础?我们详尽的 S3 与 EFS 指南是理想的起点。如果您只对 S3 感兴趣,欢迎阅读我们的深度 S3 指南。
什么是 AWS S3 cp?
aws s3 cp命令是 AWS 命令行界面中的一个工具,可在本地系统与 Amazon S3 存储之间复制文件。本质上,它旨在提供与标准 Linux
cp命令相似的命令行体验,但专为与 S3 存储桶交互而定制。从核心来看,
aws s3 cp连接了您的本地机器与 AWS 的云存储基础设施。当您执行aws s3 cp命令时,AWS CLI 会处理身份验证与大文件的分片,并在复制过程中确保数据完整性。该工具支持复制单个文件、使用通配符复制多个文件,以及通过递归操作复制整个目录结构。aws s3 cp的功能很多,这里仅列出几点:不过,
aws s3 cp的强大之处在于其灵活性和与 AWS 生态系统的集成。您可以指定不同参数来控制存储类别、加密、元数据、访问控制等方面。这使其既适用于一次性的简单文件传输,也适用于复杂的自动化备份方案。该命令不同于使用 AWS 管理控制台,后者需要手动导航和点击。
aws s3 cp可直接在终端执行,或纳入脚本与自动化工作流。对于许多技术从业者(尤其是 DevOps 工程师与数据科学家),这种以编程方式访问 S3 至关重要。总之,
aws s3 cp提供了可靠、可脚本化的解决方案,在保持性能的同时能够处理海量传输。它还能恢复中断的上传与下载,因此在网络不稳定或传输超大文件时尤其有用。接下来,我将带您完成那些略显无聊但必不可少的步骤——在您的系统上配置 AWS CLI。