随着应用走向全球化,传统数据库常常难以胜任。Azure Cosmos DB 是微软提供的全球分布式、多模型数据库,能够在各区域间实现低延迟访问、多种一致性模型以及无缝扩展。
本指南将介绍容器、项以及 SQL API 等关键概念,是希望上手(并在工作中使用)Azure 和 Cosmos DB 的云工程师必备基础。您将获得其架构的实用概览,以及它为何成为云原生、关键任务型应用的首选。
什么是 Azure Cosmos DB?
Azure Cosmos DB 是运行在 Microsoft Azure 上的全托管 NoSQL 数据库,专为高可用性、低延迟和全球可扩展性而构建。它支持多种数据模型,包括文档、键值、图和列族,因而可灵活适配多样化应用。
其核心优势是全球分布:只需几次点击,数据即可在多个 Azure 区域间复制,实现快速的本地访问。
开发者还可在多种一致性模型中进行选择,以平衡性能与数据准确性。如果您刚接触 Azure,强烈建议阅读这份 Azure 新手指南。
为何使用 Azure Cosmos DB?
Azure Cosmos DB 提供了一套强大的特性,专为构建可扩展、高性能的应用而设计:
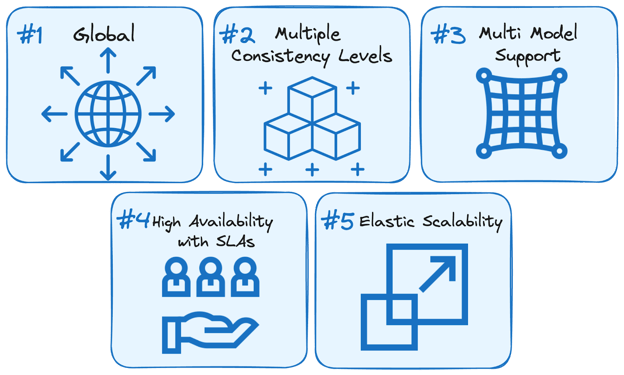
作者制图。为什么使用 Cosmos DB
- 低延迟的全球分布:自动在各个 Azure 区域间复制数据,确保全球用户均可快速本地访问。
- 多种一致性级别:在五种模型(Strong、Bounded Staleness、Session、Consistent Prefix、Eventual)中选择,以权衡一致性、可用性与性能。
- 多模型支持:支持文档(JSON)、键值、图和列族数据模型,适配多样化工作负载。
- 具备 SLA 的高可用性:为读写操作提供 SLA 保障,适用于关键任务系统。
- 弹性伸缩:可根据负载自动伸缩吞吐而不停机,在波动的负载下保持响应性。
这些能力使 Cosmos DB 成为构建全球分布式、云原生且要求实时性能与高韧性的应用的坚实基础。
Azure Cosmos DB 的使用场景
Azure Cosmos DB 是面向实时、可扩展应用的多面手,覆盖众多行业。其低延迟、全球分布式架构非常适合对高可用性和快速数据访问有要求的场景。以下为主要用例:
- AI 与机器学习:可集成实时 AI 流水线并支持向量搜索,助力构建如推荐引擎、语义搜索等智能应用。
- 电商与零售:通过捕获用户行为并即时提供推荐,支撑个性化购物体验。其全球分布确保跨区域的库存数据准确、低延迟访问。
- 游戏与社交媒体:以快速读写性能处理玩家实时数据、聊天和排行榜。会话级一致性确保全球用户体验顺畅。
- 物联网与时序数据:高效摄取与处理大量传感器与遥测数据。适用于预测性维护、异常检测与实时监控等场景。
从驱动在线商店到赋能智能 AI 应用,Cosmos DB 提供现代云原生解决方案所需的速度、规模与灵活性。若想进一步了解在 Cosmos DB 与 Azure 上可以做到什么,请查看这份微软云服务指南。
Cosmos DB 的特性与能力
本节将探讨帮助开发者构建快速、稳健且智能应用的核心能力,包括数据建模策略。
数据建模与索引
Azure Cosmos DB 允许容器存储 JSON 文档而无需预定义架构,便于您随时间演进与调整数据模型。
Cosmos DB 默认自动索引,开箱即用地为每个字段建立索引以支持快速查询。但这可能导致请求单位(RU)消耗增加,尤其是在写入密集型工作负载中。为优化性能,开发者可定义自定义索引策略。这些策略允许在不必要处禁用自动索引、为需索引的字段指定包含路径、并排除无关字段。
Cosmos DB 还提供变更馈送(Change Feed)功能,可实时捕获插入与更新,适用于构建事件驱动系统、触发工作流或向下游流式传输数据。另一个实用功能是生存时间(Time-to-Live)(TTL),可在指定期限后自动删除文档。
分区与性能优化
对于写入密集型工作负载,分区键应具备高基数且分布均匀,例如用户 ID、时间戳或地理区域,以避免热点分区与限流。在读取密集型场景下,常见做法是使用如客户 ID 之类的分区键将相关数据归组,从而高效执行范围或点查询。糟糕的分区设计会导致数据分布不均与性能下降。由于每个逻辑分区限制为 20 GB,需设计分区策略以避免单一键过载。
通过设计以单分区为目标的访问模式可进一步提升查询性能,因为这类查询更快且更节省资源。虽然支持跨分区查询,但通常会带来更高的延迟与 RU 消耗,因为需要扫描多个分区。为降低查询成本,应利用索引策略(如复合索引)并为高频访问数据考虑引入缓存机制。
在吞吐方面,Cosmos DB 允许开发者在容器级或数据库级配置请求单位(RU)。这种可调的吞吐模型有助于在出现峰值负载时,依然维持应用性能。
一致性模型与数据持久性
Azure Cosmos DB 提供五种可调一致性级别,远超多数非关系型数据库仅提供的最终一致或强一致两种选项。
在最弱级别,最终一致性提供最快且最高可用的选项,但在副本逐步同步期间,可能返回过期或乱序数据。略强的是一致前缀(Consistent Prefix),可确保读取反映写入顺序,但不一定是最新结果,适用于更看重操作顺序而非新鲜度的场景。
默认且对许多应用最实用的是会话一致性,可保证客户端在一个会话内总能读到自己刚写入的数据。有限陈旧性(Bounded Staleness)则更进一步,允许写读之间存在受控延迟,可按时间间隔(T)或版本数(K)定义。例如,在单区域内,滞后可限定为 5 秒或 10 个版本;在多区域部署下,可延长至 5 分钟或 100,000 个版本。
在最强一端是强一致性,确保所有读取均反映所有副本中最新提交的写入。该级别提供最严格保障,避免过期、脏读或幻读,行为与传统 ACID 合规系统非常接近。
多区域写入与全球可用性
Azure Cosmos DB 的亮点之一是通过主动-主动(多主)复制实现多区域写入支持。应用可在多个区域同时执行写操作,大幅降低全球用户的写入延迟。
Cosmos DB 还提供自动全球复制,确保数据在各 Azure 区域间保持同步。如遇区域性故障,系统会自动故障转移至下一个可用区域。
尽管 Cosmos DB 会自动处理分片与数据分布的机制,开发者仍需选择合适的分区键,以支持均匀分布与有效的水平扩展。对于可能超过每个逻辑分区 20 GB 限制的大型数据集,这一决策尤为重要。尽早规划分区可随应用增长避免瓶颈与性能问题。
Cosmos DB 的定价与成本管理
Azure Cosmos DB 的定价基于请求单位(RU),反映读取、写入和查询所用资源。一次简单的点读通常花费 1 RU。
定价模型
- 预置吞吐:为可预测的工作负载预留 RU,按吞吐与存储计费。
- 无服务器:按用量付费,适合零散或低流量工作负载。
成本优化
- 使用 Cosmos DB Profiler 监控并优化查询效率。
- 调优索引与分区以降低 RU 消耗。
- 通过 Azure Cost Management 跟踪费用并设置用量告警。
- 选择合适的模型并优化设计,可显著降低成本。
开始使用 Azure Cosmos DB
在使用 Azure Cosmos DB 前,您需要创建账户、选择配置,并创建第一个数据库与容器。以下分步指南将带您通过 Azure 门户完成整个过程。
步骤 1:注册 Azure 账户并通过 Azure 门户访问 Cosmos DB
先登录Azure 门户。在顶部全局搜索栏中输入“
Azure Cosmos DB”,并从结果中选择。在 Cosmos DB 窗格中点击“创建”以开始配置新实例。
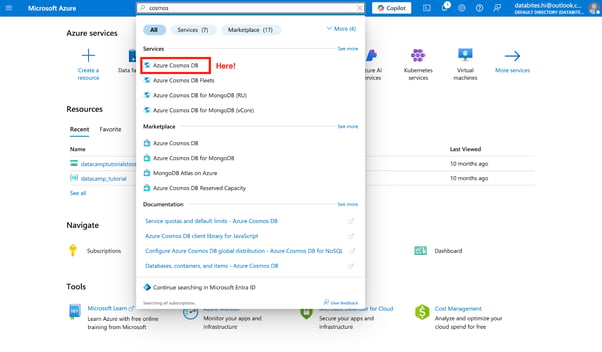
Azure 主登录页截图
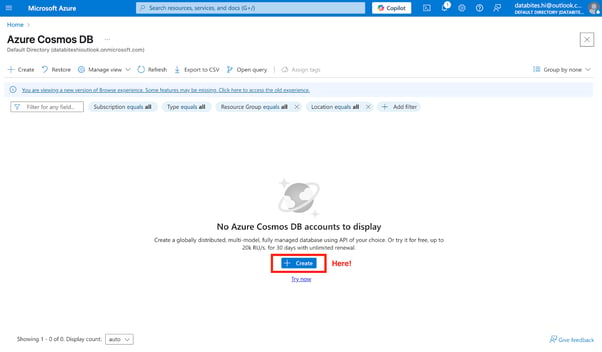
Azure Cosmos DB 主登录页截图
步骤 2:选择 API 并配置基础信息
选择Azure Cosmos DB for NoSQL 作为您的 API 模型(核心 SQL API)。
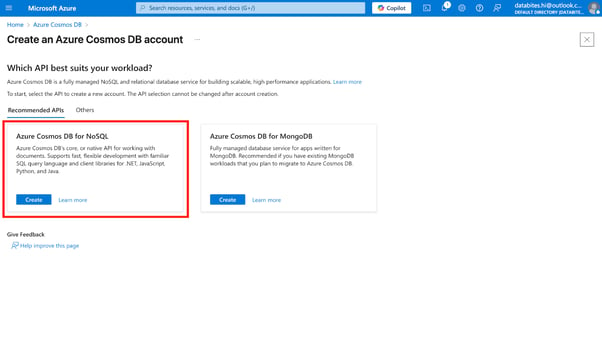
Azure Cosmos DB 截图。创建实例
随后在“基础”面板中,填写配置详情,包括 Azure 订阅、资源组(新建或现有)、全局唯一的账户名称以及首选 Azure 区域。可保持可用性区域为禁用状态。Cosmos DB 提供两种吞吐模式——面向可预测工作负载的预置吞吐,以及适合波动或低流量场景的无服务器。根据您的应用需求选择合适模式;随着工作负载演化,这些选项也可后续调整。
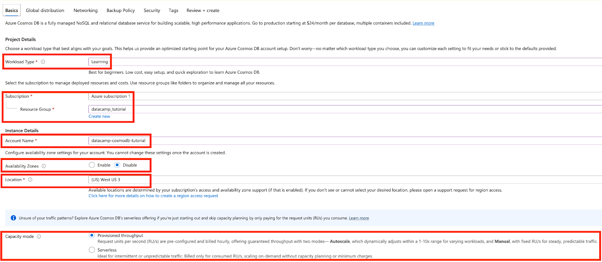
Azure Cosmos DB 截图。填写详细信息
完成后,点击查看+创建,然后确认点击创建以开始部署。
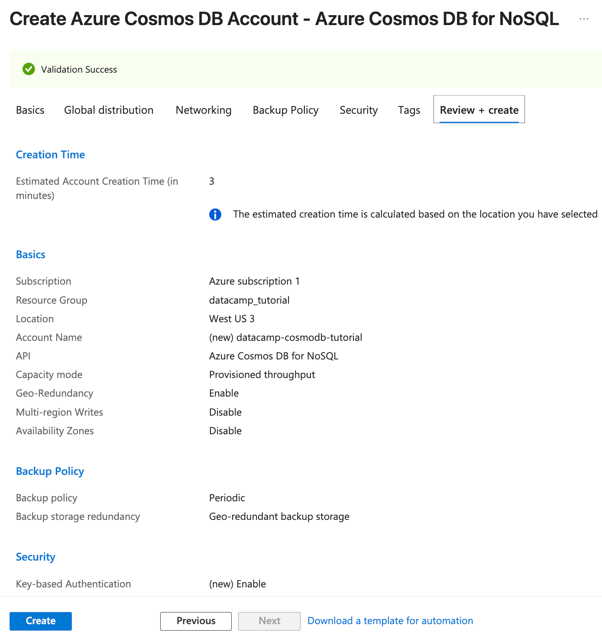
Azure Cosmos DB 截图。验证我们的实例
部署完成后,选择转到资源以访问新建的 Cosmos DB 帐户。
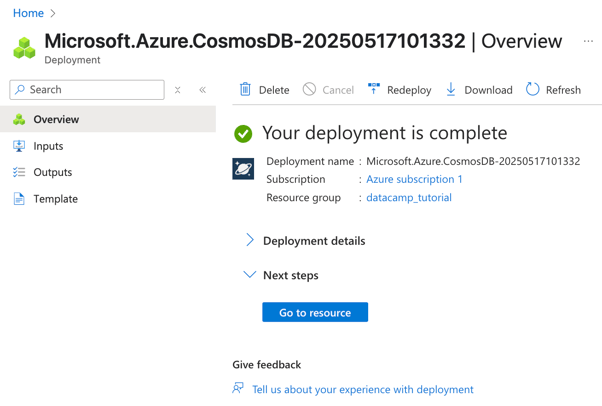
Azure Cosmos DB 截图。我们刚创建资源的信息
步骤 3:创建数据库与容器
在Cosmos DB 帐户菜单中,导航至数据资源管理器(Data Explorer)。
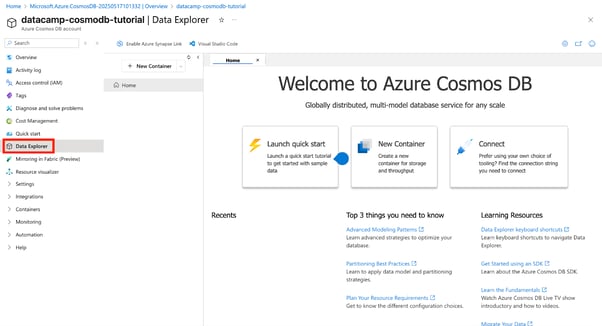
Azure Cosmos DB 截图。浏览数据
点击 新建容器 打开配置对话框。
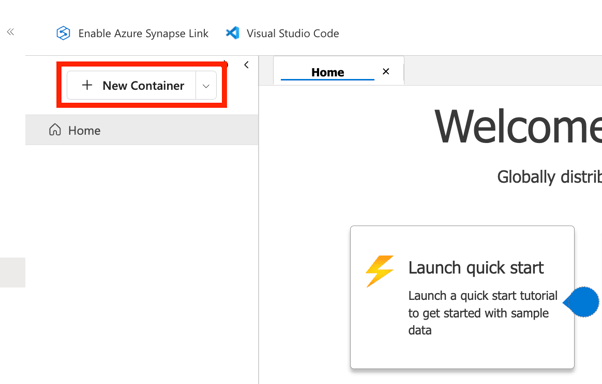
Azure Cosmos DB 截图。创建新容器
定义新的数据库名称与容器名称,并且务必指定分区键,以确保数据分布均匀与最佳性能。点击确定以创建数据库与容器。
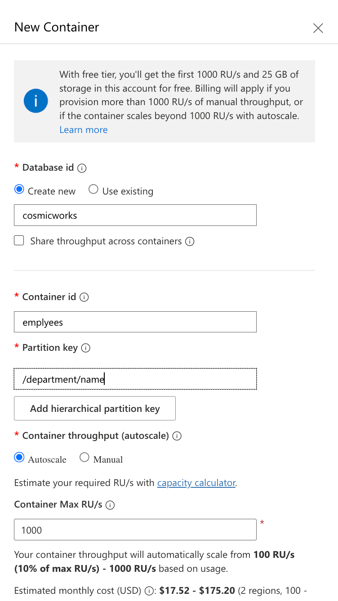
Azure Cosmos DB 截图。填写容器属性。
创建完成后,您将在数据资源管理器的层级结构中看到它们。
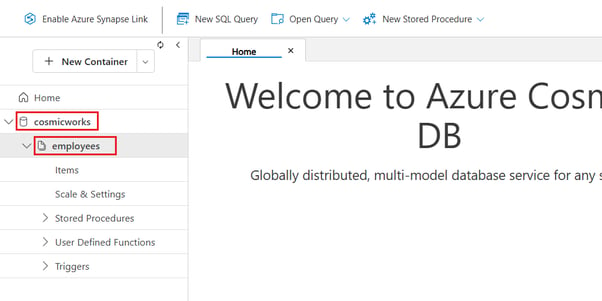
Azure Cosmos DB 截图。查看数据层级。
步骤 4:使用数据资源管理器进行查询与管理数据库对象
在新建的容器(employees)中,展开树视图并选择 Items。
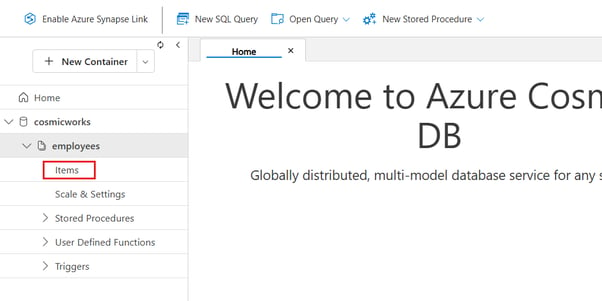
Azure Cosmos DB 截图。查看容器
点击新建项(New Item)。
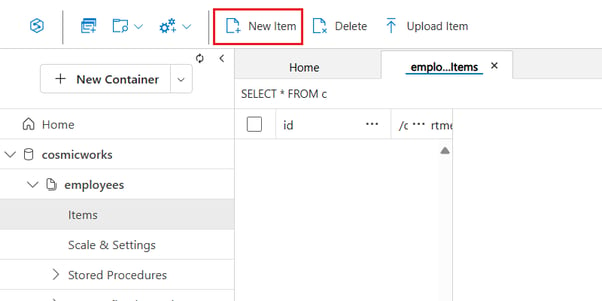
Azure Cosmos DB 截图。创建新项
插入以下示例 JSON,然后点击保存(Save):
{
  "id": "aaaaaaaa-0000-1111-2222-bbbbbbbbbbbb",
  "name": {
    "first": "Josep",
    "last": "Ferrer"
  },
  "email": "<[email protected]>",
  "department": {
    "name": "Data Science"
  }
}技术支持
要测试查询,请在菜单中选择新建 SQL 查询(New SQL Query),并输入以下 NoSQL 查询,它会对 Logistics 部门的员工执行不区分大小写的搜索。
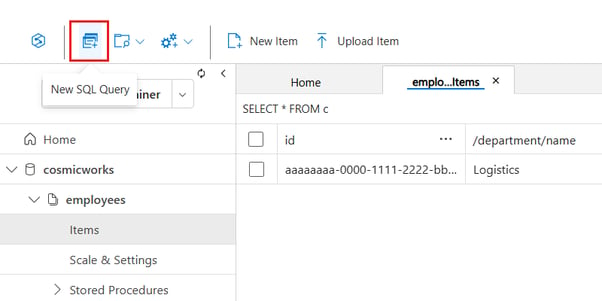
Azure Cosmos DB 截图。查看容器。
SELECT VALUE {
    "name": CONCAT(e.name.last, " ", e.name.first),
    "department": e.department.name,
    "emailAddresses": [
        e.email
    ]
}
FROM
    employees e
WHERE
    STRINGEQUALS(e.department.name, "logistics", true)技术支持
现在点击执行查询。它会返回结构化输出:
[
  {
    "name": "Josep Ferrer",
    "department": "Logistics",
    "emailAddresses": [
      "[email protected]"
    ]
  }
]技术支持
就这些!
Cosmos DB 的优缺点
优点
- 高可用性:内置多区域复制,确保全球范围的可靠性与正常运行时间。
- 架构灵活:支持无架构 JSON,并自动索引以实现快速查询。
- AI 集成:原生支持向量搜索与实时 AI 场景。
- 广泛的 API 支持:兼容 SQL、MongoDB、Cassandra、Gremlin 与 Table API。
- 全托管服务:负责伸缩、补丁与基础设施,降低运维开销。
缺点
- 有限的 SQL 功能:缺乏关系型数据库中的完整 JOIN 与 GROUP BY 能力。
- 大规模成本:若未优化,在高吞吐工作负载下成本可能较高。
结论
Azure Cosmos DB 是面向现代云原生应用的强大、全球分布式 NoSQL 数据库。凭借多模型支持、主动-主动复制与可调一致性级别,它在需要高可用性、实时响应与弹性伸缩的场景(如 AI 系统、电商平台与物联网解决方案)中表现出色。
其全托管基础设施、灵活的数据建模与丰富的 API 生态,使其成为开发者与架构师的有力之选。同时,团队在规划生产工作负载时,亦需谨慎评估 SQL 功能缺口与大规模成本等潜在限制。
若您希望继续提升技能,以下资源值得一看:



随着应用走向全球化,传统数据库常常难以胜任。Azure Cosmos DB 是微软提供的全球分布式、多模型数据库,能够在各区域间实现低延迟访问、多种一致性模型以及无缝扩展。
本指南将介绍容器、项以及 SQL API 等关键概念,是希望上手(并在工作中使用)Azure 和 Cosmos DB 的云工程师必备基础。您将获得其架构的实用概览,以及它为何成为云原生、关键任务型应用的首选。
什么是 Azure Cosmos DB?
Azure Cosmos DB 是运行在 Microsoft Azure 上的全托管 NoSQL 数据库,专为高可用性、低延迟和全球可扩展性而构建。它支持多种数据模型,包括文档、键值、图和列族,因而可灵活适配多样化应用。
其核心优势是全球分布:只需几次点击,数据即可在多个 Azure 区域间复制,实现快速的本地访问。
开发者还可在多种一致性模型中进行选择,以平衡性能与数据准确性。如果您刚接触 Azure,强烈建议阅读这份 Azure 新手指南。
为何使用 Azure Cosmos DB?
Azure Cosmos DB 提供了一套强大的特性,专为构建可扩展、高性能的应用而设计:
作者制图。为什么使用 Cosmos DB
这些能力使 Cosmos DB 成为构建全球分布式、云原生且要求实时性能与高韧性的应用的坚实基础。
Azure Cosmos DB 的使用场景
Azure Cosmos DB 是面向实时、可扩展应用的多面手,覆盖众多行业。其低延迟、全球分布式架构非常适合对高可用性和快速数据访问有要求的场景。以下为主要用例:
从驱动在线商店到赋能智能 AI 应用,Cosmos DB 提供现代云原生解决方案所需的速度、规模与灵活性。若想进一步了解在 Cosmos DB 与 Azure 上可以做到什么,请查看这份微软云服务指南。
Cosmos DB 的特性与能力
本节将探讨帮助开发者构建快速、稳健且智能应用的核心能力,包括数据建模策略。
数据建模与索引
Azure Cosmos DB 允许容器存储 JSON 文档而无需预定义架构,便于您随时间演进与调整数据模型。
Cosmos DB 默认自动索引,开箱即用地为每个字段建立索引以支持快速查询。但这可能导致请求单位(RU)消耗增加,尤其是在写入密集型工作负载中。为优化性能,开发者可定义自定义索引策略。这些策略允许在不必要处禁用自动索引、为需索引的字段指定包含路径、并排除无关字段。
Cosmos DB 还提供变更馈送(Change Feed)功能,可实时捕获插入与更新,适用于构建事件驱动系统、触发工作流或向下游流式传输数据。另一个实用功能是生存时间(Time-to-Live)(TTL),可在指定期限后自动删除文档。
分区与性能优化
对于写入密集型工作负载,分区键应具备高基数且分布均匀,例如用户 ID、时间戳或地理区域,以避免热点分区与限流。在读取密集型场景下,常见做法是使用如客户 ID 之类的分区键将相关数据归组,从而高效执行范围或点查询。糟糕的分区设计会导致数据分布不均与性能下降。由于每个逻辑分区限制为 20 GB,需设计分区策略以避免单一键过载。
通过设计以单分区为目标的访问模式可进一步提升查询性能,因为这类查询更快且更节省资源。虽然支持跨分区查询,但通常会带来更高的延迟与 RU 消耗,因为需要扫描多个分区。为降低查询成本,应利用索引策略(如复合索引)并为高频访问数据考虑引入缓存机制。
在吞吐方面,Cosmos DB 允许开发者在容器级或数据库级配置请求单位(RU)。这种可调的吞吐模型有助于在出现峰值负载时,依然维持应用性能。
一致性模型与数据持久性
Azure Cosmos DB 提供五种可调一致性级别,远超多数非关系型数据库仅提供的最终一致或强一致两种选项。
在最弱级别,最终一致性提供最快且最高可用的选项,但在副本逐步同步期间,可能返回过期或乱序数据。略强的是一致前缀(Consistent Prefix),可确保读取反映写入顺序,但不一定是最新结果,适用于更看重操作顺序而非新鲜度的场景。
默认且对许多应用最实用的是会话一致性,可保证客户端在一个会话内总能读到自己刚写入的数据。有限陈旧性(Bounded Staleness)则更进一步,允许写读之间存在受控延迟,可按时间间隔(T)或版本数(K)定义。例如,在单区域内,滞后可限定为 5 秒或 10 个版本;在多区域部署下,可延长至 5 分钟或 100,000 个版本。
在最强一端是强一致性,确保所有读取均反映所有副本中最新提交的写入。该级别提供最严格保障,避免过期、脏读或幻读,行为与传统 ACID 合规系统非常接近。
多区域写入与全球可用性
Azure Cosmos DB 的亮点之一是通过主动-主动(多主)复制实现多区域写入支持。应用可在多个区域同时执行写操作,大幅降低全球用户的写入延迟。
Cosmos DB 还提供自动全球复制,确保数据在各 Azure 区域间保持同步。如遇区域性故障,系统会自动故障转移至下一个可用区域。
尽管 Cosmos DB 会自动处理分片与数据分布的机制,开发者仍需选择合适的分区键,以支持均匀分布与有效的水平扩展。对于可能超过每个逻辑分区 20 GB 限制的大型数据集,这一决策尤为重要。尽早规划分区可随应用增长避免瓶颈与性能问题。
Cosmos DB 的定价与成本管理
Azure Cosmos DB 的定价基于请求单位(RU),反映读取、写入和查询所用资源。一次简单的点读通常花费 1 RU。
定价模型
成本优化
开始使用 Azure Cosmos DB
在使用 Azure Cosmos DB 前,您需要创建账户、选择配置,并创建第一个数据库与容器。以下分步指南将带您通过 Azure 门户完成整个过程。
步骤 1:注册 Azure 账户并通过 Azure 门户访问 Cosmos DB
先登录Azure 门户。在顶部全局搜索栏中输入“
Azure Cosmos DB”,并从结果中选择。在 Cosmos DB 窗格中点击“创建”以开始配置新实例。Azure 主登录页截图
Azure Cosmos DB 主登录页截图
步骤 2:选择 API 并配置基础信息
选择Azure Cosmos DB for NoSQL 作为您的 API 模型(核心 SQL API)。
Azure Cosmos DB 截图。创建实例
随后在“基础”面板中,填写配置详情,包括 Azure 订阅、资源组(新建或现有)、全局唯一的账户名称以及首选 Azure 区域。可保持可用性区域为禁用状态。Cosmos DB 提供两种吞吐模式——面向可预测工作负载的预置吞吐,以及适合波动或低流量场景的无服务器。根据您的应用需求选择合适模式;随着工作负载演化,这些选项也可后续调整。
Azure Cosmos DB 截图。填写详细信息
完成后,点击查看+创建,然后确认点击创建以开始部署。
Azure Cosmos DB 截图。验证我们的实例
部署完成后,选择转到资源以访问新建的 Cosmos DB 帐户。
Azure Cosmos DB 截图。我们刚创建资源的信息
步骤 3:创建数据库与容器
在Cosmos DB 帐户菜单中,导航至数据资源管理器(Data Explorer)。
Azure Cosmos DB 截图。浏览数据
点击 新建容器 打开配置对话框。
Azure Cosmos DB 截图。创建新容器
定义新的数据库名称与容器名称,并且务必指定分区键,以确保数据分布均匀与最佳性能。点击确定以创建数据库与容器。
Azure Cosmos DB 截图。填写容器属性。
创建完成后,您将在数据资源管理器的层级结构中看到它们。
Azure Cosmos DB 截图。查看数据层级。
步骤 4:使用数据资源管理器进行查询与管理数据库对象
在新建的容器(employees)中,展开树视图并选择 Items。
Azure Cosmos DB 截图。查看容器
点击新建项(New Item)。
Azure Cosmos DB 截图。创建新项
插入以下示例 JSON,然后点击保存(Save):
要测试查询,请在菜单中选择新建 SQL 查询(New SQL Query),并输入以下 NoSQL 查询,它会对
Logistics部门的员工执行不区分大小写的搜索。Azure Cosmos DB 截图。查看容器。
现在点击执行查询。它会返回结构化输出:
就这些!
Cosmos DB 的优缺点
优点
缺点
结论
Azure Cosmos DB 是面向现代云原生应用的强大、全球分布式 NoSQL 数据库。凭借多模型支持、主动-主动复制与可调一致性级别,它在需要高可用性、实时响应与弹性伸缩的场景(如 AI 系统、电商平台与物联网解决方案)中表现出色。
其全托管基础设施、灵活的数据建模与丰富的 API 生态,使其成为开发者与架构师的有力之选。同时,团队在规划生产工作负载时,亦需谨慎评估 SQL 功能缺口与大规模成本等潜在限制。
若您希望继续提升技能,以下资源值得一看: