
课程
数据库设计
4 小时
131.2K
当我被分配到第一个数据工程项目时,我已做了几年全栈工程师。在那之前,我经常编写前端代码、开发 API,并管理和部署云基础设施。
和许多早期初创公司的工程师一样,我也接触过数据库,时不时设计新表或新模式,并在各处迁移少量数据。但后来,我所在的公司开始收集海量数据,数据库性能开始下降。
我们的应用变慢了,延迟在增加,甚至在高峰负载时会出现停机。这是一个非常令人沮丧的问题,我的团队为此努力修复。也是在那时,我学到了很多关于数据库的知识、其工作方式,以及如何优化它们。
在这篇博文中,我将解释一个当时真正起到作用、而且在过去几年里多次奏效的概念: 数据库分片。
数据库分片是将数据库拆分为更小的子集(即分片)的做法,每个分片都作为独立数据库运行。可以把它想象成把一个巨大的电子表格拆成几个更小、更易管理的表格,每个表格承担自己那部分工作负载。
分片并不是解决所有数据库问题的答案。
还有其他更容易实施的横向扩展方法(如复制)或纵向扩展方法。请先看看这些,再考虑分片!
当数据库开始难以满足不断增长的应用需求时,分片就派上用场了。也许您的用户规模激增,或者应用每秒都在产生海量数据。如果您注意到查询变慢、延迟上升,或者在流量高峰时经常宕机,这很可能意味着数据库已触及其极限。
分片的一个重要原因是可扩展性。随着数据增长,给单台数据库服务器增加硬件(纵向扩展)只能带来有限提升,而且成本高昂。相比之下,分片通过将数据分布到多台服务器,实现横向扩展,每台服务器只处理一部分负载。
选择分片的另一个原因是性能。即使数据库能承载数据量,在海量信息中查询也会耗时。通过分片,您处理的是更小、更聚焦的数据集,从而带来更快的查询和更少的资源争用。
至于何时分片,通常在您的应用开始超出单一数据库所能处理的范围时就应考虑。具体时机取决于许多变量,例如您的资源和预期增长,这需要把握一个微妙的平衡。过早实施分片会引入不必要的复杂度,而本可用单库或简单优化解决;但若拖得太久,迁移会非常痛苦。
一个不错的经验法则是密切监控数据库性能指标并提前规划。如果您注意到瓶颈或快速增长的数据可能在不久的将来引发问题,那大概就是探索分片的时候了。相信我,未雨绸缪会为您省去很多后续的麻烦!
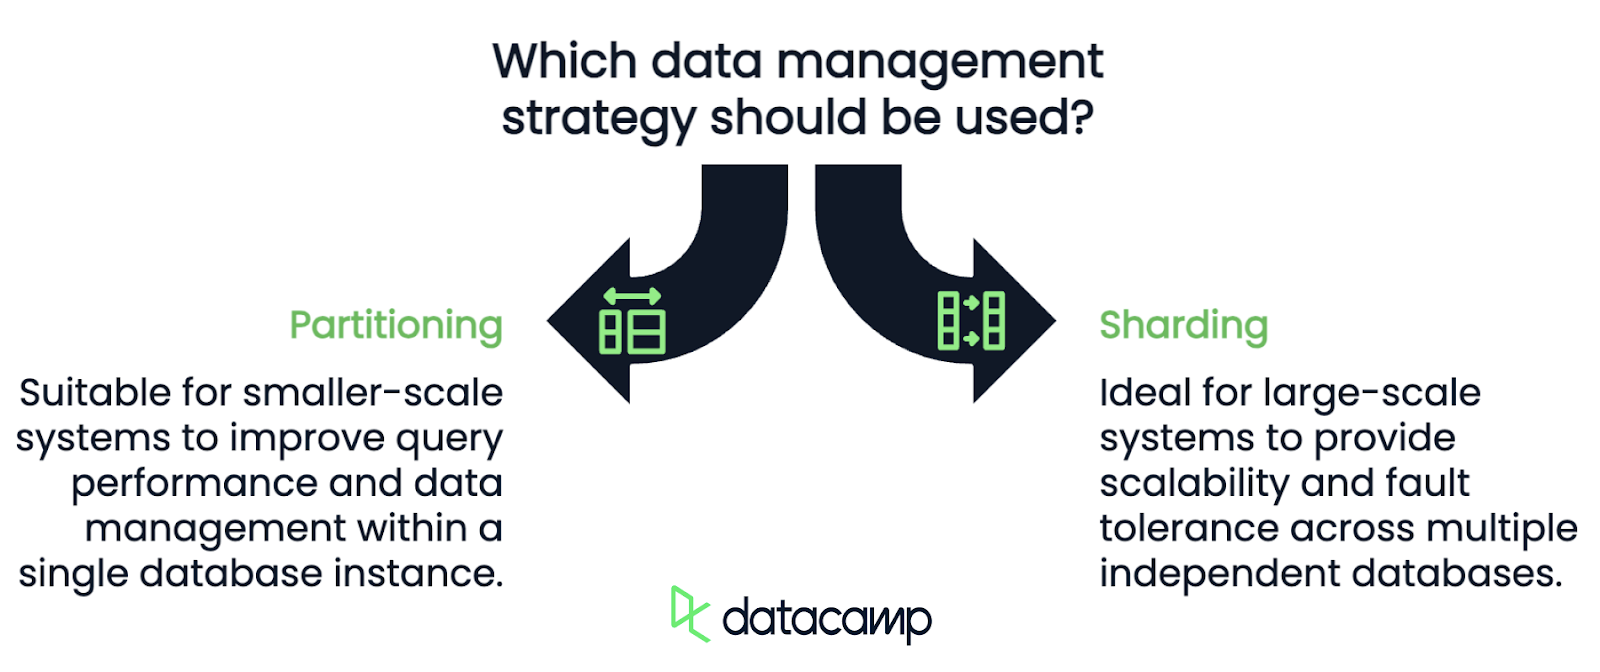
乍一看,分片和分区似乎是同一个概念,因为二者都涉及将数据拆分为更小的部分,以便更好地组织和提升性能。但它们服务于不同目的,适用于不同规模的场景。
分区是在同一数据库实例内,将数据划分为逻辑片段的过程。这些片段通常称为分区,可基于范围、列表或哈希等标准。例如,在用户数据库中,您可以把1月出生的用户放在一个分区,2月出生的放在另一个,且都在同一数据库内。
对于尚不需要横向扩展的小规模系统,分区是极佳选择。它通过限制查询时扫描的数据量来提升查询性能,并让数据管理更高效。
另一方面,分片将分区提升到新的层级,把这些逻辑片段分布到多个独立数据库中。每个分片都是一个独立数据库,处理自己的数据和查询。
这种方法非常适合单库已无法承载负载的大规模系统。分片既提供可扩展性,也带来容错性,因为每个分片都是独立运行的。
以我的经验,分区常常是迈向分片的过渡。如果您开始出现性能问题,但数据库尚未到达极限,分区能为您争取时间,以便为分片等更大规模的解决方案做准备。
如果您对数据库设计感兴趣,可以看看这门完整的数据库设计课程。您将学习如何组织、管理和优化 SQL 数据库,甚至如何设置不同类型的分区。
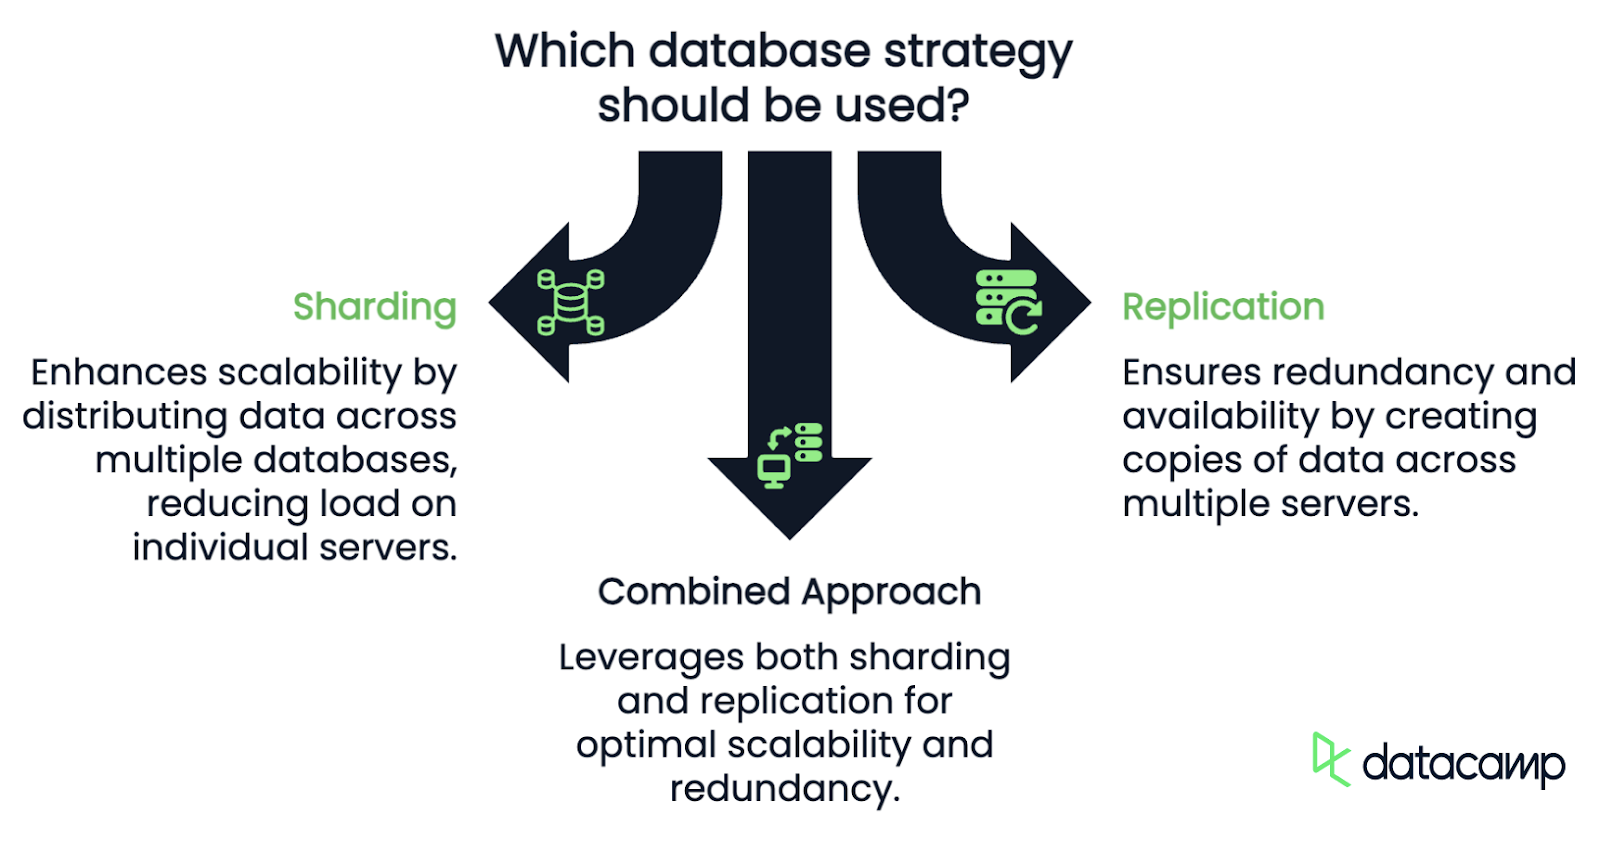
与上文相似,分片和复制经常被并列讨论,但它们解决的是不同问题,适用于不同场景。
分片的首要目标是可扩展性。通过将数据和工作负载拆分到多个数据库,您能降低任何单个数据库的负载。随着数据增长,分片可通过增加更多分片来容纳数据,从而维持性能并降低单库过载风险。
而复制是将相同数据复制到多台服务器上。每个副本都包含完整数据集,并可独立处理读操作,因此复制侧重于冗余和可用性,而非可扩展性。
拥有多个数据库副本可以防止数据丢失,并确保即使一台服务器宕机系统仍保持在线,但这并不能解决数据量增长的问题。事实上,由于每个副本都存储完整数据集,存储需求会随着副本数量成比例增长。除此之外,写入操作可能成为瓶颈,因为必须在所有副本上执行以保持数据一致。
事实是,这并非非此即彼。在实践中,许多大规模系统同时使用分片和复制。例如,一个分片数据库中的每个分片还可以有其副本。
那么,分片究竟如何工作?我们把它拆成三个关键组成部分。
分片的第一步是确定如何划分数据。分区逻辑是一组规则,决定数据如何在各分片之间拆分。常见的方式包括:
选择哪种分区逻辑取决于您的数据和应用需求。我个人见过基于范围的分区在按时间排序的数据(如交易历史)上表现良好,而在负载不可预测的系统中,基于哈希的方法往往更好。
一旦数据被分区,您需要一种方法将每个分区映射到对应的分片。
有的系统使用静态映射,即基于固定规则将数据分配到分片。也有的使用动态映射,通常由中心元数据服务管理,这样更易于按需添加或删除分片。无论哪种方式,目标都是确保系统确切知道每一条数据在哪里。
最后,您需要一种机制确保查询被发送到正确的分片。这称为查询路由,对让分片为您的应用发挥作用至关重要。当应用发出查询时,路由逻辑会确定哪个(些)分片保存相关数据,并将请求发送过去。
在某些情况下,这很简单:应用本身根据分区逻辑就知道该把查询发往哪里。在另一些架构中,由代理或中间层负责路由,从而将复杂性从应用中抽离出来。我两种方式都用过,虽然代理会增加一些开销,但在更大型系统中能为您省去大量工作。
分片没有唯一做法。您选择的策略高度依赖于数据结构及其用法。下面我将介绍几种最常见的策略,但远不止这三种。
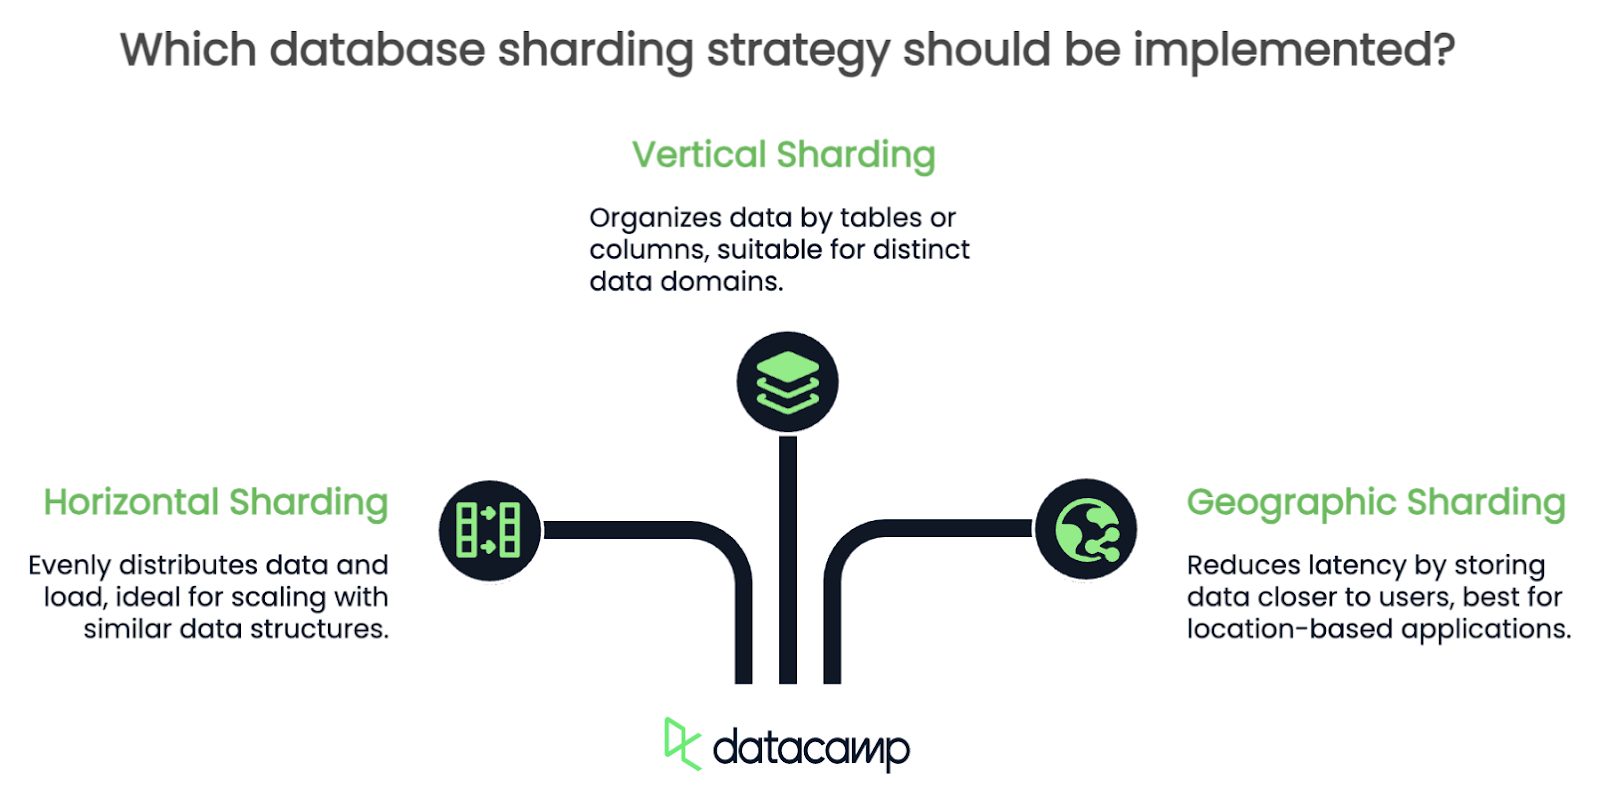
水平分片是将同一表的行拆分到多个分片。例如,在用户数据库中,您可以按用户 ID 分片:用户 1–1000 在一个分片,1001–2000 在另一个,依此类推。
这种方法非常流行,因为它能较为均衡地分配数据和负载,随着应用增长,便于横向扩展。特别适用于行数众多且结构相似的表。
使用水平分片时,选择分区逻辑必须非常谨慎。分布不佳会导致工作负载严重不均,有的分片过载,而有的则闲置。
垂直分片是按表或列来拆分数据库。例如,您可以把用户资料放在一个分片,交易数据放在另一个,日志放在第三个。每个分片本质上负责一个特定数据子集。
当应用具有清晰、相对独立且交互不多的数据域时,这一策略非常奏效。但需要注意跨分片查询。如果应用经常需要合并不同分片的数据,垂直分片可能反而会带来比起初更多的性能瓶颈!
地理分片按用户位置组织数据。例如,所有欧洲用户数据放在一个分片,北美数据放在另一个。该策略通过让用户数据更靠近其访问位置来降低延迟。
然而,地理分片也有自身挑战。您需要妥善处理在区域间移动的用户,或数据跨越多个位置的情况。保持跨分片数据一致性也可能变得棘手。
有时,组合多种策略是最佳方案——例如,在地理分片内再进行水平分片。关键在于平衡简单性、可扩展性和性能。创建这些分片之后还要维护数据库,所以请为未来的自己留出操作空间!
您不必从零开始、独自实现分片。有许多工具和框架可以简化分片,并提供内置功能为您处理其中的复杂性。
ProxySQL 充当智能代理层,为分片的MySQL 数据库处理查询路由和负载均衡。它维护哪个分片持有哪些数据的映射,当有查询进入时,会自动将其路由至相应分片,从而免除应用端自行处理逻辑。
我本人没用过 ProxySQL,但我的一位朋友证明,它处理查询路由的能力为他节省了大量手动配置的时间!
MongoDB 内置分片支持,这使其成为处理大型非结构化数据集的热门选择。MongoDB 使用分片键来决定文档如何分布到各分片,因此您需要慎重选择。选择不当会导致数据分布不均和性能问题!
随后 MongoDB 会处理其余工作:分区、数据均衡与自动查询路由。
Citus 是偏好关系型数据库人士的绝佳选择。它本质上是一个扩展,可将PostgreSQL 转变为分布式数据库。
我曾在一个团队中使用 Citus 来扩展一款 SaaS 应用,它让我们在处理海量数据的同时,仍能保持 PostgreSQL 的稳健性和结构化表的优势。
Citus 使用分布式查询规划器来处理跨分片的复杂查询,尤其适用于分析型应用,需要从多个分片汇总数据。它的学习曲线比 MongoDB 的内置分片更陡,但结果物有所值!
希望本指南能为您在自身系统中探索分片提供工具(或让您有底气说此刻它并非合适方案!)。请记住,它并非万能药,但在经过深思熟虑地使用时,是打造可扩展且高效架构的强大工具。
作为一个通过“踩坑”学到这些经验的人,我的建议是:别等到数据库不堪重负时才开始考虑分片。提前规划、不断试验、灵活调整!未来的您(以及您的用户)会感谢您的。
通过这些课程学习数据工程!
课程
学习路径
课程