我第一次接触“基数”这个概念是在攻读物理学位时上的量子力学课。在那门课里,基数指的是一个集合的大小,无论是有限还是无限,并与可数性与无穷等抽象概念相关。后来转向软件工程后,我意识到,对数据工程师或科学家而言,基数有着更实际的含义:数据集中数值的“区分度”。
在我最早分析真实世界数据的项目之一中,我深刻体会到了高基数有多棘手。它让我的数据库查询慢如蜗牛,把本应清晰的洞见变成一团乱麻。从那以后,我积累了一些实践经验,并整理了这份指南,希望能帮到身处同样境地的您。如果您想了解什么是高基数、它带来哪些挑战,以及如何以切实有效的方式驾驭它,那么您来对地方了!
什么是基数?什么是高基数?
基数与高基数听起来有些抽象,我们来拆解一下。
定义与示例
基数指的是数据集中某一列的唯一值数量。高基数列包含大量唯一值,而低基数列的唯一条目较少。
高基数在包含唯一标识符的数据集中尤为常见,例如:
- 时间戳: 当以毫秒或纳秒级记录数据时,几乎每个值都是唯一的。
- 客户 ID: 每位客户都有一个唯一标识符,用于跟踪其活动。
- 交易 ID: 金融数据集通常为每一笔交易分配唯一编码。
这些唯一值对于跟踪、聚合或个性化数据很重要。但它们数量庞大,会在存储、性能和可视化方面带来显著挑战,我们稍后会详细讨论。
常见的真实场景
高基数几乎在各行各业都会出现。下面我列举一些例子,帮助您从更实际的角度理解高基数。
电商与客户数据
电商平台每天都会生成海量的高基数数据:
- 客户 ID:每位用户被分配唯一标识符以跟踪其行为、购买与偏好。
- 会话 ID:每次浏览会话都会被唯一记录,导致会话跟踪数据集中存在大量不同值。
- 产品 SKU:库存量单位对每种产品变体都是唯一的,在库存与销售数据中形成高基数列。
这些数据集对于理解用户行为、跟踪库存与优化销售策略至关重要,但海量的唯一条目往往使分析变得复杂。
医疗与患者记录
在医疗领域,出于精确追踪和身份识别的需要,自然会产生高基数数据。例如:
- 患者 ID:每位患者拥有唯一标识符,确保记录准确且安全。
- 预约时间戳:从门诊就诊到实验室检测,每次交互都可能生成唯一时间戳。
- 保险理赔编号:每笔理赔都会被分配独立编码,便于记录与审计。
这些数据对于维护患者病史并确保遵守隐私法规是必需的。
物联网传感器与流式数据
物联网设备的激增带来了大量高基数数据集:
- 传感器 ID:每个 IoT 设备都有唯一标识符,用于跟踪其活动与位置。
- 时间戳数据:连续数据流常以毫秒或纳秒间隔记录事件,几乎每个值都唯一。
- 事件 ID:系统中记录的每个事件(从温度读数到运动检测)都会分配唯一标识符。
在 IoT 场景中,高基数源于需要处理来自众多设备的细粒度实时数据。这对于分析与监控至关重要,但在高效存储与查询方面充满挑战——后文还会谈到!
高基数的挑战
高基数在数据处理、工程、分析与机器学习各环节都会带来挑战。高基数数据集信息丰富,但往往会成为瓶颈,损害性能、可解释性与可扩展性。
数据存储与性能问题
高基数最大的挑战之一在于其对数据存储和系统性能的影响。
- 存储开销:高基数列(如唯一标识符或时间戳)会导致数据集变大。比如,在电商平台记录数百万次用户交互,由于会话 ID 或交易时间戳的唯一性,会带来巨大的存储开销。
- 查询性能下降:查询高基数列时,数据库在索引与扫描的复杂度上会更吃力。涉及在高基数列上筛选或连接的查询往往耗时更长,因为数据库需要在海量不同值中“筛沙取金”。
- 索引难题:索引本用于加速查询,但在高基数列上会变得臃肿且低效,导致查找变慢、性能退化。
以一个存储 IoT 传感器数据的数据库为例,其中包含唯一的传感器 ID 与精确时间戳。针对某个传感器与时间范围进行筛选的查询,可能要求数据库处理数百万个唯一条目,从而导致极慢的响应时间与高资源消耗。
数据可视化的困难
难点在于:如何把大量不同的值呈现得既可理解又有意义。如果缺乏周全考虑,高基数数据反而会遮蔽而非揭示洞见。
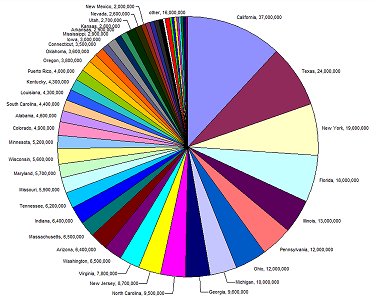
下面这个饼图就是个好例子。由于唯一条目(州)过多,图例与取值都无法辨认,这类图表并不适用。有时换一种图也有帮助,但并非总是如此。
来源:European Environment Agency
想象一张按会话 ID 展示电商平台客户活动的柱状图。成千上万甚至数百万个唯一 ID 会让图表变成无法阅读的“毛刺”,而换用其他图表类型大概率也无济于事。
那么,为什么不直接聚合数据,从图表中提炼模式与关系呢?可以,但必须谨慎。对高基数数据进行聚合,可能会丢失我们提炼洞见所需的细粒度。比如,将 IoT 数据按位置分组,可能会掩盖个体传感器层面细微但关键的变化。解决这类问题的技术往往颇为微妙。我推荐我们的Power BI 中级数据建模课程,动手实践一对一与一对多关系。
与机器学习的关联
高基数会在机器学习中带来显著挑战,尤其体现在特征工程、模型复杂度与可解释性上。机器学习模型需要结构化且有意义的输入,而高基数特征往往打破这种平衡,导致诸多问题:
- 稀疏性增加:高基数特征常导致稀疏数据集。例如,对类似邮编这样的高基数分类特征进行独热编码,会生成一个维度极高的矩阵,其中大部分单元都是空值。这种稀疏性让模型(尤其是基于距离的,如 K 近邻或聚类算法)更难在数据中找到有意义的关系。
- 过拟合风险:在将数据切分为细粒度类别的模型(如决策树或随机森林)中,高基数特征容易引发过拟合。当每个类别仅由少量样本表示时,模型可能学习到噪声而非真正的模式,从而在未见数据上泛化能力较差。
例如,在电商场景中,用于预测客户流失的模型可能会包含“用户 ID”或“产品 ID”等高基数特征。如果处理不当,模型会对训练数据中的特定客户或产品过拟合,学习到的是训练集特有的模式,而非可泛化的趋势,从而在新用户上的预测效果大打折扣。
管理高基数的策略
有效管理高基数需要结合领域特定策略与通用数据优化技术。这些方法不仅能提升系统性能,也能让数据更易解读、更可付诸行动。
利用技术与工具
幸运的是,高基数数据集带来的挑战足够普遍,已经催生并打磨出一系列专门应对它们的技术与工具。
数据库优化
在数据库中管理高基数,往往要从优化数据的存储与查询入手,而不仅仅是去重。常用技术包括:
- 分桶(或分箱): 将高基数数据归并为更宽泛的类别,减少唯一值数量。例如,按区域对邮编进行分组,而非逐个存储。
- 分区: 根据经常被查询的字段对表进行分区结构化。例如,将客户数据按国家分区,可提升地理分布式系统中的查询性能。
- 索引: 针对高基数字段使用专门的索引,如位图索引或复合索引,可在平衡存储效率的同时提升查询速度。
专业软件
如果您面对的是极高基数,有一些专用工具与平台可以助您一臂之力:
- 列式数据库: 如 Apache Parquet 或 Amazon Redshift,这类数据库面向分析型查询设计,能高效存储与处理高基数列。
- NoSQL 数据库: 在某些场景下,MongoDB 或 Elasticsearch 等 NoSQL 数据库能更好地处理高基数数据集的可变性与规模,尤其结合无模式设计时。
- 时序数据库:对于以时间戳与事件为主导的数据,例如 IoT 传感器数据或股票交易,InfluxDB 或 TimescaleDB 等时序数据库非常好用。它们专为高效存储高基数维度而优化,并采用高级压缩技术以在保持高性能的同时尽量降低存储成本。我参与过几个涉及海量 IoT 数据的项目,时序数据库在提炼趋势与预测方面起到了关键作用。若您感兴趣,我写过这篇时序数据库指南!
- 数据剖析工具: 如 Talend、OpenRefine,或自定义 Python 脚本,都能快速识别高基数字段,并帮助确定最佳的预处理或存储策略。
数据预处理技术
在数据科学与机器学习中,预处理指的是将原始数据清洗、转换和组织为适合分析或建模的格式所采取的步骤。
这是个分量十足的话题,如果您几乎没有数据工程或数据科学基础,本节内容可能有些难度。不过我也加入了相关链接与示例,帮助您跟上节奏!
数据预处理是管理高基数的关键步骤,它能降低复杂度、提升性能,并确保数据质量足以支持分析或机器学习任务。通过将原始数据转化为更易管理的形式,我们可以缓解诸如稀疏性、存储低效与计算瓶颈等问题。
降维
当高基数导致数据集拥有大量特征或稀疏矩阵时,降维技术尤为有用。这些方法在尽量保留关键信息的同时,将数据压缩到更少的维度。
主成分分析(PCA)
想象您有一个电商用户行为数据集,其中包含很多特征,比如用户查看产品的次数、对不同产品类别的互动、在网站上的停留时间等等。如果您跟踪了大量产品,每个特征都可能具有很高的基数。PCA 可以将这些特征组合为更少的成分,同时依然捕捉到数据中最重要的模式,比如整体参与度或对特定产品类型的兴趣。把它想象成数据界的 Marie Kondo:保留“怦然心动”的特征,温柔地舍弃其余的!
t-SNE 与 UMAP
t-SNE 与 UMAP 特别适合将高维数据映射到二维或三维,同时尽量保留其结构,便于可视化。例如,在医疗记录数据集中,UMAP 可以将患有相似病情或接受类似治疗方案的患者聚到一起,帮助发现共病或治疗结果等趋势。
特征选择
如果您要构建一个预测电商平台销售表现的机器学习模型,数据集中包含诸如客户点击广告次数、浏览产品数量、距上次购买的天数等特征,您会发现许多特征彼此相关,既造成高基数,也引入冗余。
使用互信息或递归特征消除等特征选择方法,可以识别哪些特征的预测力最强(例如,“距上次购买的时间”可能比“广告点击次数”更重要),并剔除无关特征,最终提升模型表现。
如果您想更深入学习这一主题,可以尝试这门机器学习预处理课程。您将使用 Python 在建模前清洗并准备数据。
编码方法
编码是处理分类数据的关键预处理步骤,尤其在面对高基数特征时。选择何种编码方法取决于具体用例与数据集的基数水平。
- 独热编码(One-Hot):独热编码为数据集中的每个唯一类别创建一个二进制列。它对低基数数据简单有效,但在高基数特征上会导致极度稀疏的矩阵。比如,对 1,000 个唯一邮编编码会产生 1,000 列二进制特征,可能拖垮内存与算力。相信我,我是“血的教训”才明白的……
- 目标编码(均值编码):此方法用各类别对应的目标变量均值替换分类值。例如,在预测客户流失时,可以用某地区客户的平均流失率替换邮编。该方法能降低维度,但可能引入偏差,需要谨慎验证以避免数据泄漏。
- 频数编码:以类别出现的频数作为其取值,减少唯一值数量。例如,在电商数据集中,可用产品的购买频次替换产品 ID。该技术资源高效,且常与特征重要性相关。
- 哈希编码:通过哈希函数将类别映射为整数,并将部分类别归入同一桶。它内存友好,适用于流式数据或极高基数,但会引入哈希冲突的风险。有没有想过,为什么您在网购网站搜机油却被推荐奶粉?这就是哈希冲突在“捣乱”。
- 嵌入层:对于神经网络等模型,嵌入层可将高基数分类特征转换为致密、低维的表示。这在推荐系统中应用广泛,比如对电商平台上数以百万计的产品 ID 或用户 ID 进行编码。
结语
高基数数据集有时会让人不知所措,从中提炼有价值的洞见的确充满挑战。下次遇到高基数数据集时,请记住:这不是数据的错——它只是蕴藏着尚待发掘的潜力。无论是通过降维、巧妙的编码技术,还是借助时序数据库等工具,您都可以有效管理数据集,把它们转化为强大的资产。
既然已经掌握了高基数数据的理论,是时候动手实践了:
- 亲手尝试降维与编码技术——从小处着手,逐步深入。我们的Python 降维课程是个不错的选择。
- 试试本文提到的一些工具(没错,时序数据库确实和它听起来一样酷!)。
最重要的是,拥抱挑战。高基数虽然棘手,却也是深入学习数据工程与分析的大好机会!


我第一次接触“基数”这个概念是在攻读物理学位时上的量子力学课。在那门课里,基数指的是一个集合的大小,无论是有限还是无限,并与可数性与无穷等抽象概念相关。后来转向软件工程后,我意识到,对数据工程师或科学家而言,基数有着更实际的含义:数据集中数值的“区分度”。
在我最早分析真实世界数据的项目之一中,我深刻体会到了高基数有多棘手。它让我的数据库查询慢如蜗牛,把本应清晰的洞见变成一团乱麻。从那以后,我积累了一些实践经验,并整理了这份指南,希望能帮到身处同样境地的您。如果您想了解什么是高基数、它带来哪些挑战,以及如何以切实有效的方式驾驭它,那么您来对地方了!
什么是基数?什么是高基数?
基数与高基数听起来有些抽象,我们来拆解一下。
定义与示例
基数指的是数据集中某一列的唯一值数量。高基数列包含大量唯一值,而低基数列的唯一条目较少。
高基数在包含唯一标识符的数据集中尤为常见,例如:
这些唯一值对于跟踪、聚合或个性化数据很重要。但它们数量庞大,会在存储、性能和可视化方面带来显著挑战,我们稍后会详细讨论。
常见的真实场景
高基数几乎在各行各业都会出现。下面我列举一些例子,帮助您从更实际的角度理解高基数。
电商与客户数据
电商平台每天都会生成海量的高基数数据:
这些数据集对于理解用户行为、跟踪库存与优化销售策略至关重要,但海量的唯一条目往往使分析变得复杂。
医疗与患者记录
在医疗领域,出于精确追踪和身份识别的需要,自然会产生高基数数据。例如:
这些数据对于维护患者病史并确保遵守隐私法规是必需的。
物联网传感器与流式数据
物联网设备的激增带来了大量高基数数据集:
在 IoT 场景中,高基数源于需要处理来自众多设备的细粒度实时数据。这对于分析与监控至关重要,但在高效存储与查询方面充满挑战——后文还会谈到!
高基数的挑战
高基数在数据处理、工程、分析与机器学习各环节都会带来挑战。高基数数据集信息丰富,但往往会成为瓶颈,损害性能、可解释性与可扩展性。
数据存储与性能问题
高基数最大的挑战之一在于其对数据存储和系统性能的影响。
以一个存储 IoT 传感器数据的数据库为例,其中包含唯一的传感器 ID 与精确时间戳。针对某个传感器与时间范围进行筛选的查询,可能要求数据库处理数百万个唯一条目,从而导致极慢的响应时间与高资源消耗。
数据可视化的困难
难点在于:如何把大量不同的值呈现得既可理解又有意义。如果缺乏周全考虑,高基数数据反而会遮蔽而非揭示洞见。
下面这个饼图就是个好例子。由于唯一条目(州)过多,图例与取值都无法辨认,这类图表并不适用。有时换一种图也有帮助,但并非总是如此。
来源:European Environment Agency
想象一张按会话 ID 展示电商平台客户活动的柱状图。成千上万甚至数百万个唯一 ID 会让图表变成无法阅读的“毛刺”,而换用其他图表类型大概率也无济于事。
那么,为什么不直接聚合数据,从图表中提炼模式与关系呢?可以,但必须谨慎。对高基数数据进行聚合,可能会丢失我们提炼洞见所需的细粒度。比如,将 IoT 数据按位置分组,可能会掩盖个体传感器层面细微但关键的变化。解决这类问题的技术往往颇为微妙。我推荐我们的Power BI 中级数据建模课程,动手实践一对一与一对多关系。
与机器学习的关联
高基数会在机器学习中带来显著挑战,尤其体现在特征工程、模型复杂度与可解释性上。机器学习模型需要结构化且有意义的输入,而高基数特征往往打破这种平衡,导致诸多问题:
例如,在电商场景中,用于预测客户流失的模型可能会包含“用户 ID”或“产品 ID”等高基数特征。如果处理不当,模型会对训练数据中的特定客户或产品过拟合,学习到的是训练集特有的模式,而非可泛化的趋势,从而在新用户上的预测效果大打折扣。
管理高基数的策略
有效管理高基数需要结合领域特定策略与通用数据优化技术。这些方法不仅能提升系统性能,也能让数据更易解读、更可付诸行动。
利用技术与工具
幸运的是,高基数数据集带来的挑战足够普遍,已经催生并打磨出一系列专门应对它们的技术与工具。
数据库优化
在数据库中管理高基数,往往要从优化数据的存储与查询入手,而不仅仅是去重。常用技术包括:
专业软件
如果您面对的是极高基数,有一些专用工具与平台可以助您一臂之力:
数据预处理技术
在数据科学与机器学习中,预处理指的是将原始数据清洗、转换和组织为适合分析或建模的格式所采取的步骤。
这是个分量十足的话题,如果您几乎没有数据工程或数据科学基础,本节内容可能有些难度。不过我也加入了相关链接与示例,帮助您跟上节奏!
数据预处理是管理高基数的关键步骤,它能降低复杂度、提升性能,并确保数据质量足以支持分析或机器学习任务。通过将原始数据转化为更易管理的形式,我们可以缓解诸如稀疏性、存储低效与计算瓶颈等问题。
降维
当高基数导致数据集拥有大量特征或稀疏矩阵时,降维技术尤为有用。这些方法在尽量保留关键信息的同时,将数据压缩到更少的维度。
主成分分析(PCA)
想象您有一个电商用户行为数据集,其中包含很多特征,比如用户查看产品的次数、对不同产品类别的互动、在网站上的停留时间等等。如果您跟踪了大量产品,每个特征都可能具有很高的基数。PCA 可以将这些特征组合为更少的成分,同时依然捕捉到数据中最重要的模式,比如整体参与度或对特定产品类型的兴趣。把它想象成数据界的 Marie Kondo:保留“怦然心动”的特征,温柔地舍弃其余的!
t-SNE 与 UMAP
t-SNE 与 UMAP 特别适合将高维数据映射到二维或三维,同时尽量保留其结构,便于可视化。例如,在医疗记录数据集中,UMAP 可以将患有相似病情或接受类似治疗方案的患者聚到一起,帮助发现共病或治疗结果等趋势。
特征选择
如果您要构建一个预测电商平台销售表现的机器学习模型,数据集中包含诸如客户点击广告次数、浏览产品数量、距上次购买的天数等特征,您会发现许多特征彼此相关,既造成高基数,也引入冗余。
使用互信息或递归特征消除等特征选择方法,可以识别哪些特征的预测力最强(例如,“距上次购买的时间”可能比“广告点击次数”更重要),并剔除无关特征,最终提升模型表现。
如果您想更深入学习这一主题,可以尝试这门机器学习预处理课程。您将使用 Python 在建模前清洗并准备数据。
编码方法
编码是处理分类数据的关键预处理步骤,尤其在面对高基数特征时。选择何种编码方法取决于具体用例与数据集的基数水平。
结语
高基数数据集有时会让人不知所措,从中提炼有价值的洞见的确充满挑战。下次遇到高基数数据集时,请记住:这不是数据的错——它只是蕴藏着尚待发掘的潜力。无论是通过降维、巧妙的编码技术,还是借助时序数据库等工具,您都可以有效管理数据集,把它们转化为强大的资产。
既然已经掌握了高基数数据的理论,是时候动手实践了:
最重要的是,拥抱挑战。高基数虽然棘手,却也是深入学习数据工程与分析的大好机会!