
Cours
Comprendre Microsoft Azure
3 h
49.9K
Quand les applications passent à l’échelle mondiale, les bases de données traditionnelles montrent vite leurs limites. Azure Cosmos DB, la base de données multi-modèles distribuée à l’échelle globale de Microsoft, offre un accès à faible latence, plusieurs modèles de cohérence et un passage à l’échelle fluide entre régions.
Ce guide couvre les notions clés comme les conteneurs, les éléments et les API SQL — des essentiels pour tout ingénieur cloud qui souhaite démarrer (et travailler) avec Azure et Cosmos DB. Vous obtiendrez une vue d’ensemble pratique de son architecture et comprendrez pourquoi c’est un choix de référence pour les applications cloud natives critiques.
Azure Cosmos DB est une base de données NoSQL entièrement managée sur Microsoft Azure, conçue pour la haute disponibilité, la faible latence et l’évolutivité mondiale. Elle prend en charge plusieurs modèles de données : document, clé-valeur, graphe et famille de colonnes, offrant une grande flexibilité pour des applications variées.
Son principal atout : la distribution globale. En quelques clics, les données peuvent être répliquées sur des régions Azure pour un accès local et rapide.
Les développeurs peuvent aussi choisir parmi différents modèles de cohérence pour arbitrer entre performances et exactitude des données. Si vous débutez sur Azure, nous vous recommandons vivement de lire le guide du débutant sur Azure.
Azure Cosmos DB propose un ensemble puissant de fonctionnalités taillé pour créer des applications à l’échelle, performantes et réactives :
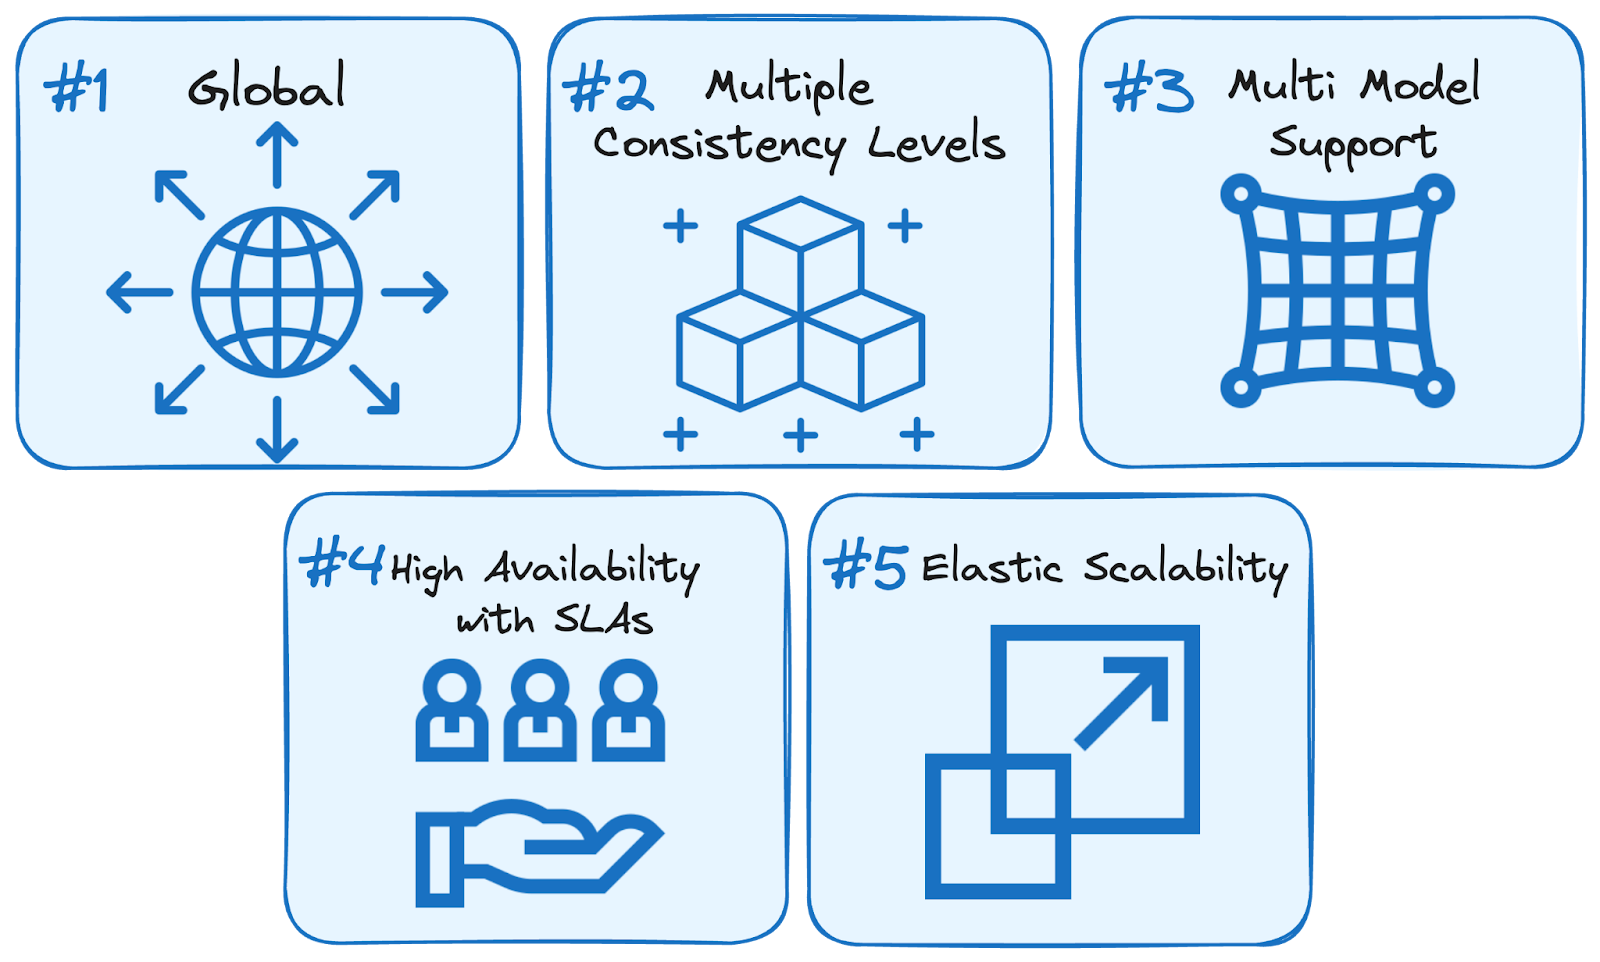
Image par l’auteur. Pourquoi utiliser Cosmos DB
Réunies, ces capacités font de Cosmos DB une base solide pour des applications cloud natives, distribuées mondialement, qui exigent des performances temps réel et de la résilience.
Azure Cosmos DB est un choix polyvalent pour des applications temps réel et à l’échelle, dans de nombreux secteurs. Son architecture à faible latence et distribuée mondialement est idéale quand haute disponibilité et accès rapide aux données sont indispensables. Exemples clés :
Qu’il s’agisse d’alimenter une boutique en ligne ou de déployer des applications pilotées par l’IA, Cosmos DB offre la vitesse, l’échelle et la flexibilité requises pour des solutions cloud natives modernes. Pour mieux comprendre ce que vous pouvez faire avec Cosmos DB et Azure, consultez ce guide des offres cloud de Microsoft.
Dans cette section, nous passons en revue les capacités essentielles pour créer des applications rapides, résilientes et intelligentes, y compris des stratégies de modélisation des données.
Azure Cosmos DB permet à des conteneurs de stocker des documents JSON sans schéma prédéfini, ce qui facilite l’évolution du modèle de données dans le temps.
L’indexation est automatique par défaut, chaque champ étant indexé pour des requêtes rapides dès le départ. Cela peut toutefois augmenter la consommation de Request Units (RU), notamment pour des charges à écritures intensives. Pour optimiser, les développeurs peuvent définir des politiques d’indexation personnalisées : désactiver l’indexation automatique là où elle n’est pas utile, spécifier les chemins inclus à indexer et exclure les champs non pertinents.
Cosmos DB intègre aussi la fonctionnalité Change Feed, qui capture en temps réel les insertions et mises à jour : idéale pour des systèmes événementiels, le déclenchement de workflows ou le streaming en aval. Autre atout : le Time-to-Live (TTL), qui permet la suppression automatique de documents après une durée définie.
Pour des charges à écritures intenses, les clés de partition doivent avoir une forte cardinalité et une distribution homogène (par exemple : IDs utilisateur, horodatages, régions géographiques) afin d’éviter les partitions chaudes et le throttling. Pour des charges à lectures dominantes, il est souvent plus efficace de regrouper les données liées avec des clés telles que des IDs client, pour des requêtes par intervalle ou par point plus efficaces. Un mauvais partitionnement entraîne une distribution inégale des données et une dégradation des performances. Chaque partition logique étant limitée à 20 Go, il est crucial de conçoir une stratégie évitant la surcharge d’une clé unique.
Les performances des requêtes s’améliorent encore lorsque les modèles d’accès ciblent une seule partition, plus rapide et plus économe en ressources. Les requêtes multi-partitions, bien que prises en charge, entraînent généralement une latence plus élevée et une consommation RU supérieure, car elles balaient plusieurs partitions. Pour réduire les coûts de requête, servez-vous des stratégies d’indexation (dont les index composites) et envisagez de mettre en cache les données fréquemment consultées.
Côté débit, Cosmos DB permet de configurer les Request Units au niveau du conteneur ou de la base de données. Ce modèle de débit ajustable aide à maintenir les performances même en période de pic de charge.
Azure Cosmos DB propose cinq niveaux de cohérence ajustables — bien au-delà des simples options « strong » ou « eventual » courantes dans les bases non relationnelles.
Au niveau le plus faible, la cohérence éventuelle offre la disponibilité et la rapidité maximales, au prix de données potentiellement périmées ou désordonnées le temps que les réplicas se synchronisent. Légèrement plus forte, la cohérence « prefixe cohérent » garantit que les lectures respectent l’ordre des écritures, sans assurer la plus récente, utile quand l’ordre prime sur la fraîcheur.
Le réglage par défaut, et souvent le plus pratique, est la cohérence de session, qui garantit qu’un client lit toujours ses propres écritures au sein d’une session. La cohérence à fraîcheur bornée (« bounded staleness ») va plus loin en autorisant un décalage contrôlé entre écritures et lectures, défini par un intervalle de temps (T) ou un nombre de versions (K). Par exemple, en mono-région, le décalage peut être limité à 5 secondes ou 10 versions, et en multi-régions jusqu’à 5 minutes ou 100 000 versions.
Au niveau le plus fort, la cohérence stricte garantit que toutes les lectures reflètent la dernière écriture validée sur l’ensemble des réplicas. Elle évite les lectures périmées, sales ou fantômes, et se rapproche du comportement des systèmes ACID traditionnels.
L’une des fonctionnalités phares d’Azure Cosmos DB est la prise en charge des écritures multi-régions via une réplication active-active (multi-maître). Les applications peuvent ainsi écrire simultanément dans plusieurs régions, réduisant fortement la latence pour les utilisateurs du monde entier.
Cosmos DB inclut également la réplication globale automatique, garantissant la synchronisation des données entre régions Azure. En cas d’incident régional, un basculement automatique est déclenché vers la prochaine région disponible.
Même si Cosmos DB prend en charge automatiquement la fragmentation (sharding) et la distribution des données, le choix d’une clé de partition pertinente reste à la charge des développeurs pour assurer une répartition homogène et un passage à l’échelle horizontal efficace. Ce choix est crucial pour les grands volumes susceptibles de dépasser la limite de 20 Go par partition logique. Anticiper le partitionnement évite les goulots d’étranglement et les problèmes de performances à mesure que l’application grandit.
La tarification d’Azure Cosmos DB repose sur les Request Units (RU), qui reflètent les ressources consommées pour les lectures, écritures et requêtes. Une lecture ponctuelle simple coûte généralement 1 RU.
Avant de travailler avec Azure Cosmos DB, vous devez créer un compte, choisir votre configuration, puis créer votre première base et votre premier conteneur. Ce pas-à-pas vous guide dans le Portail Azure.
Commencez par vous connecter au Portail Azure. Dans la barre de recherche globale en haut, tapez « Azure Cosmos DB » et sélectionnez-le dans les résultats. Depuis la page Cosmos DB, cliquez sur « Create » pour commencer la configuration de votre instance.
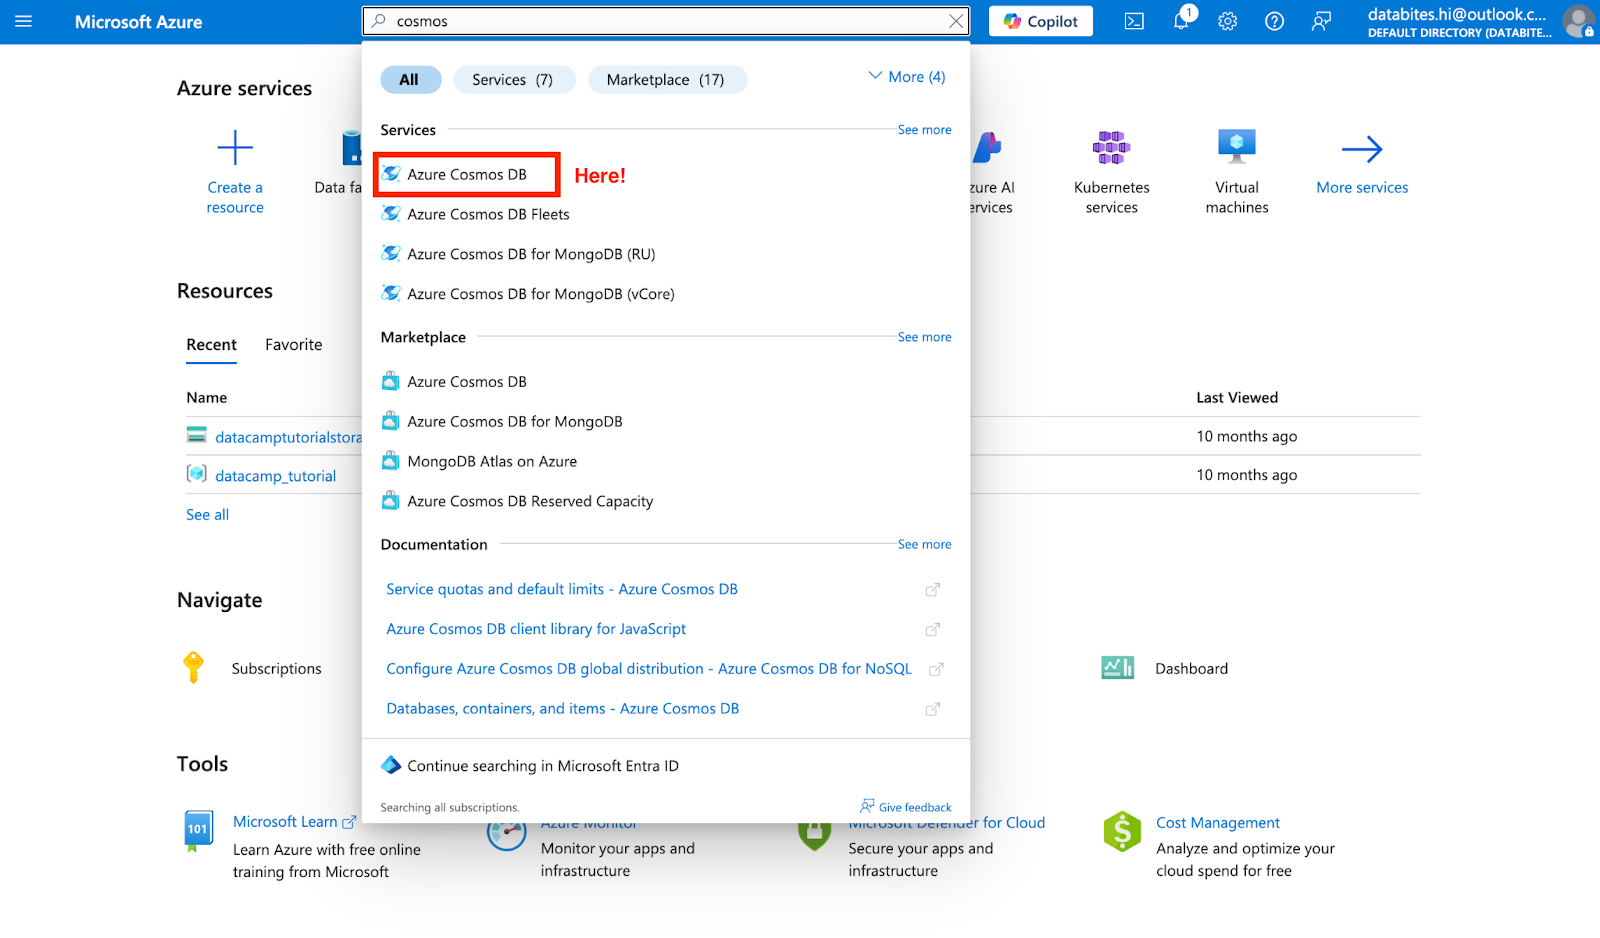
Capture d’écran de la page d’accueil Azure
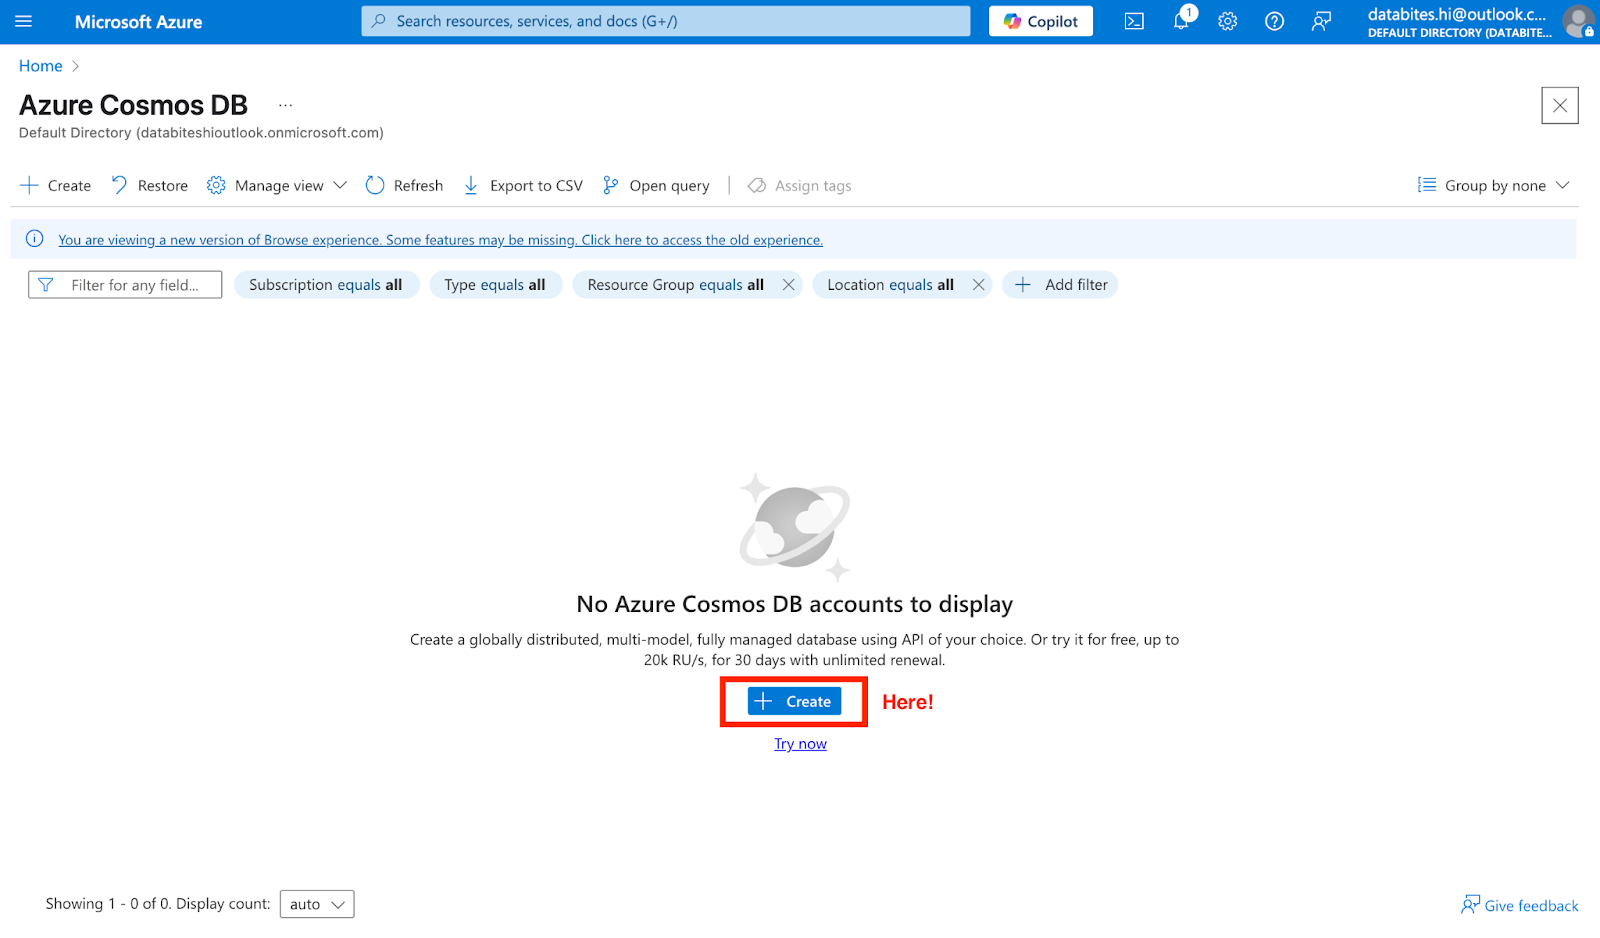
Capture d’écran de la page d’accueil d’Azure Cosmos DB
Sélectionnez Azure Cosmos DB for NoSQL comme modèle d’API (Core SQL API).
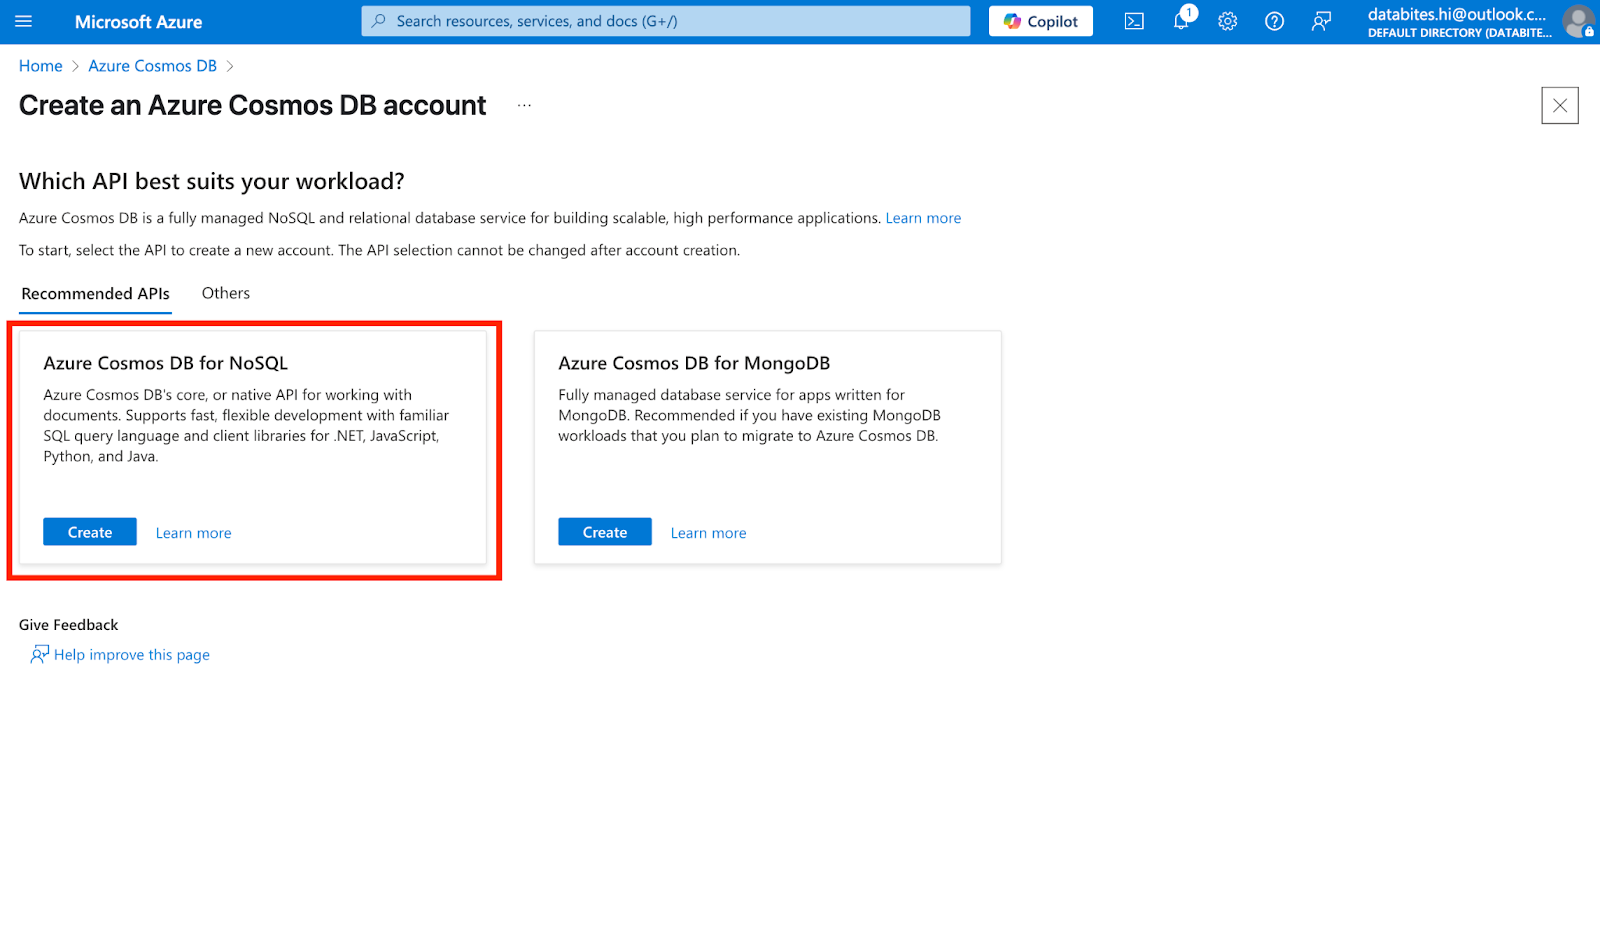
Capture d’écran d’Azure Cosmos DB. Création d’une instance
Dans l’onglet Basics, renseignez votre configuration : abonnement Azure, groupe de ressources (nouveau ou existant), nom de compte unique à l’échelle mondiale et région Azure préférée. Vous pouvez laisser les Zones de disponibilité désactivées. Cosmos DB propose deux modes de débit : débit provisionné pour des charges prévisibles et sans serveur pour des charges variables ou à faible trafic. Choisissez le mode adapté à votre application à l’installation ; vous pourrez aussi l’ajuster plus tard si la charge évolue.
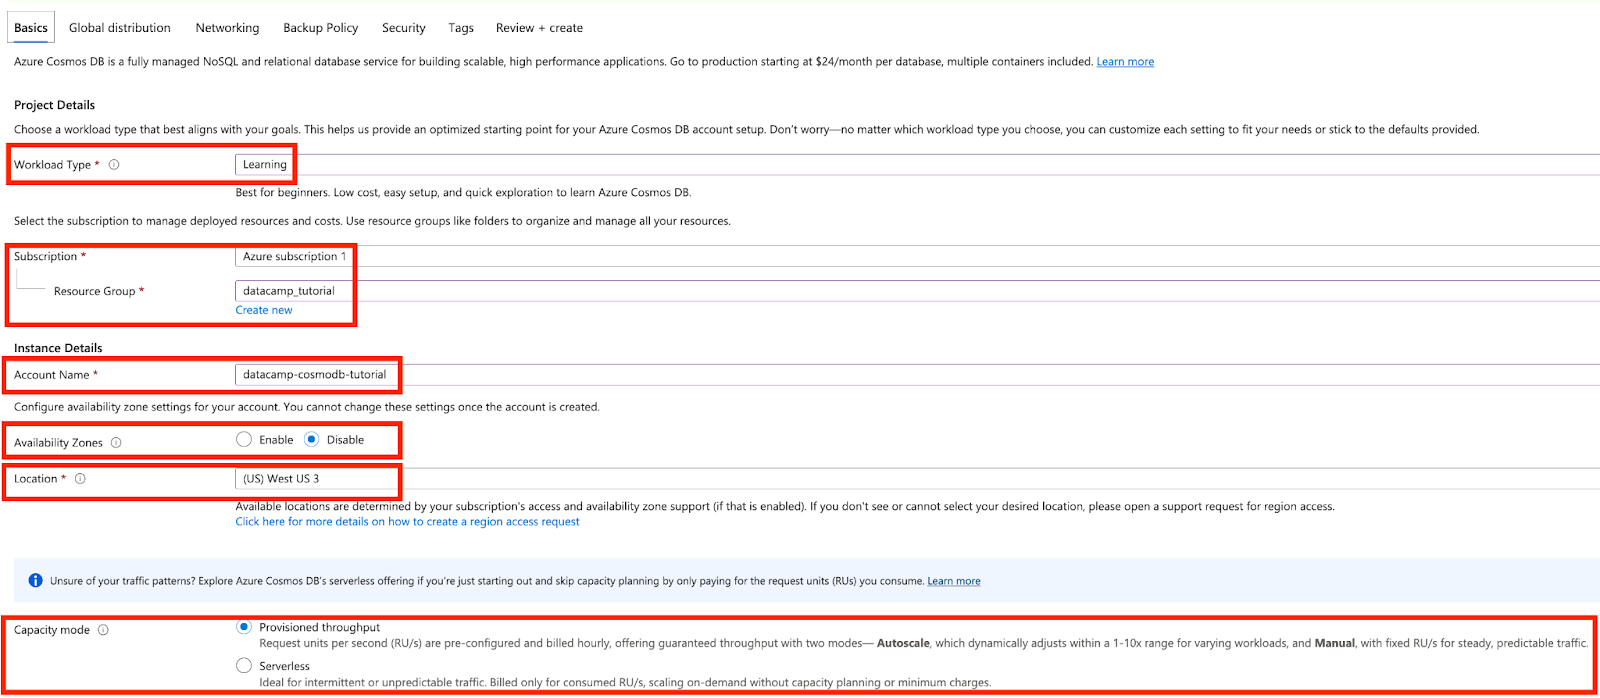
Capture d’écran d’Azure Cosmos DB. Saisie des informations
Une fois terminé, cliquez sur Review + Create, puis confirmez avec Create pour lancer le déploiement.
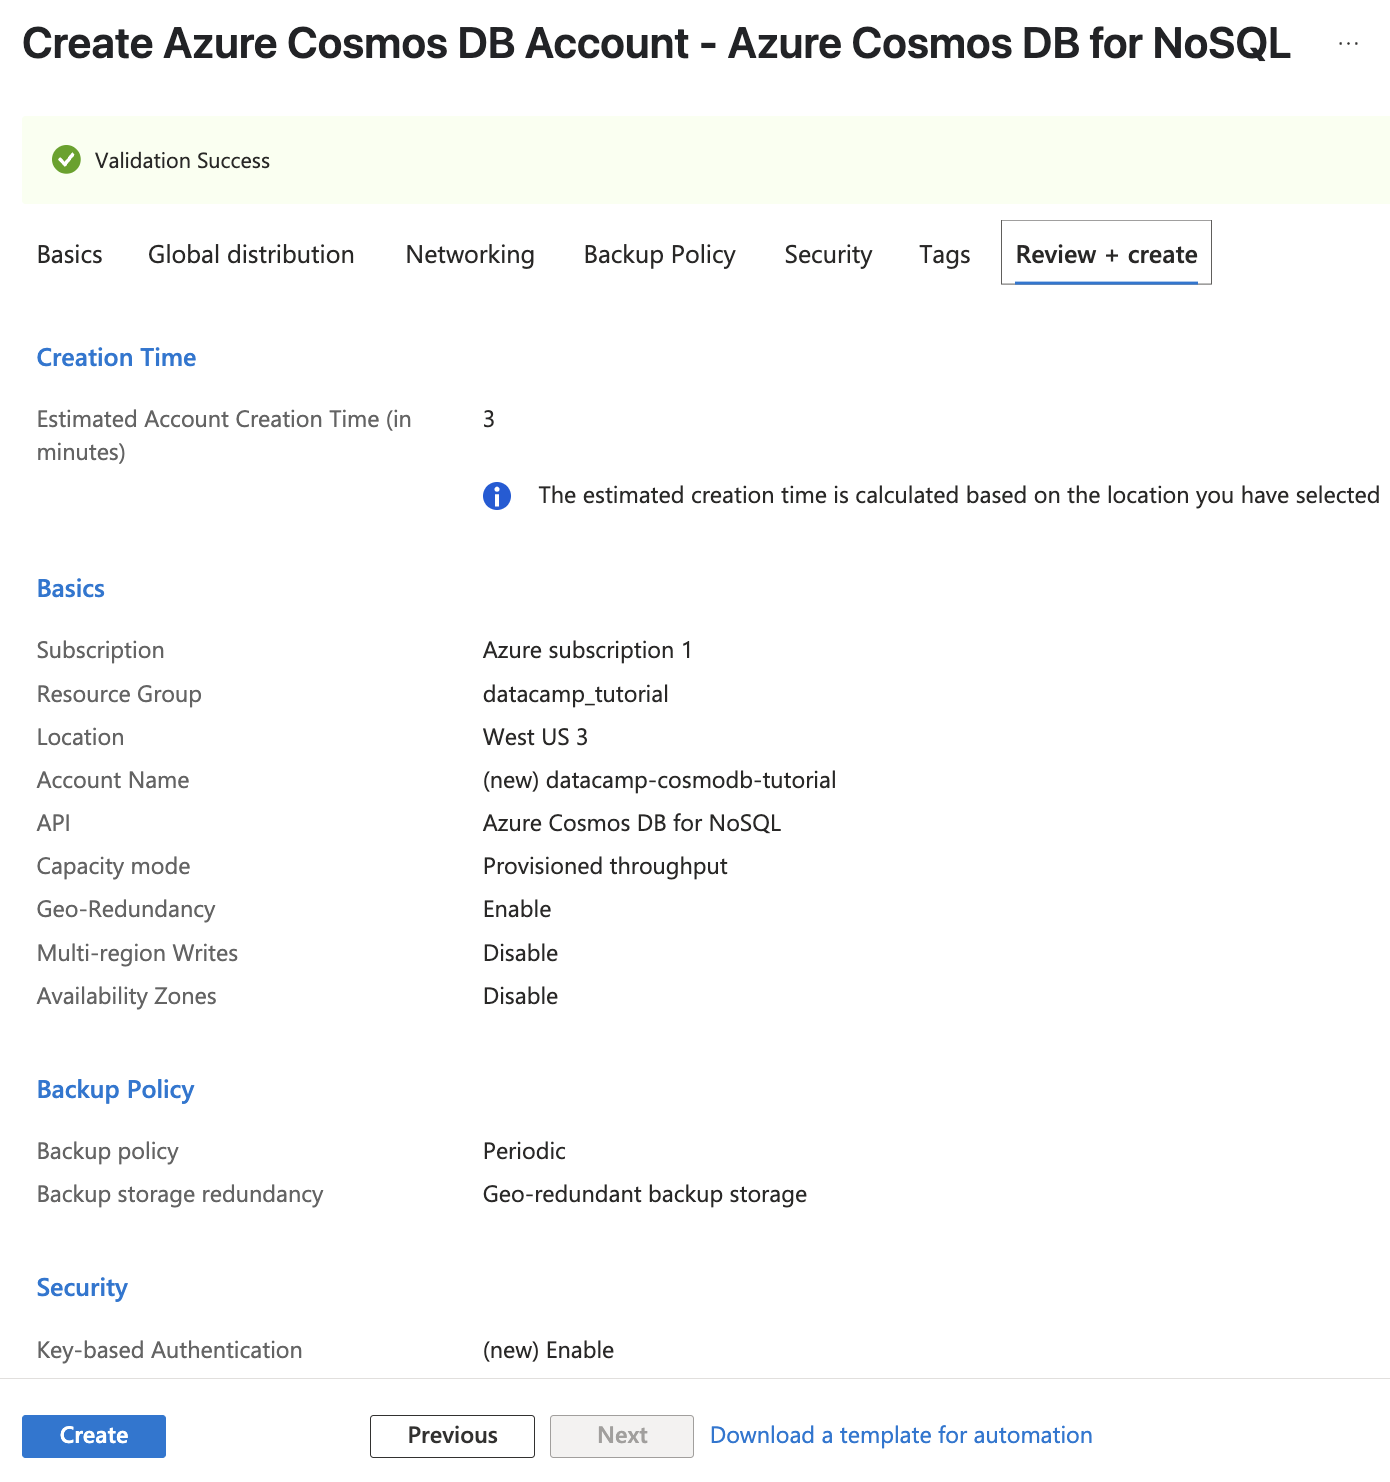
Capture d’écran d’Azure Cosmos DB. Validation de l’instance
Une fois le déploiement terminé, sélectionnez Go to resource pour accéder à votre nouveau compte Cosmos DB.
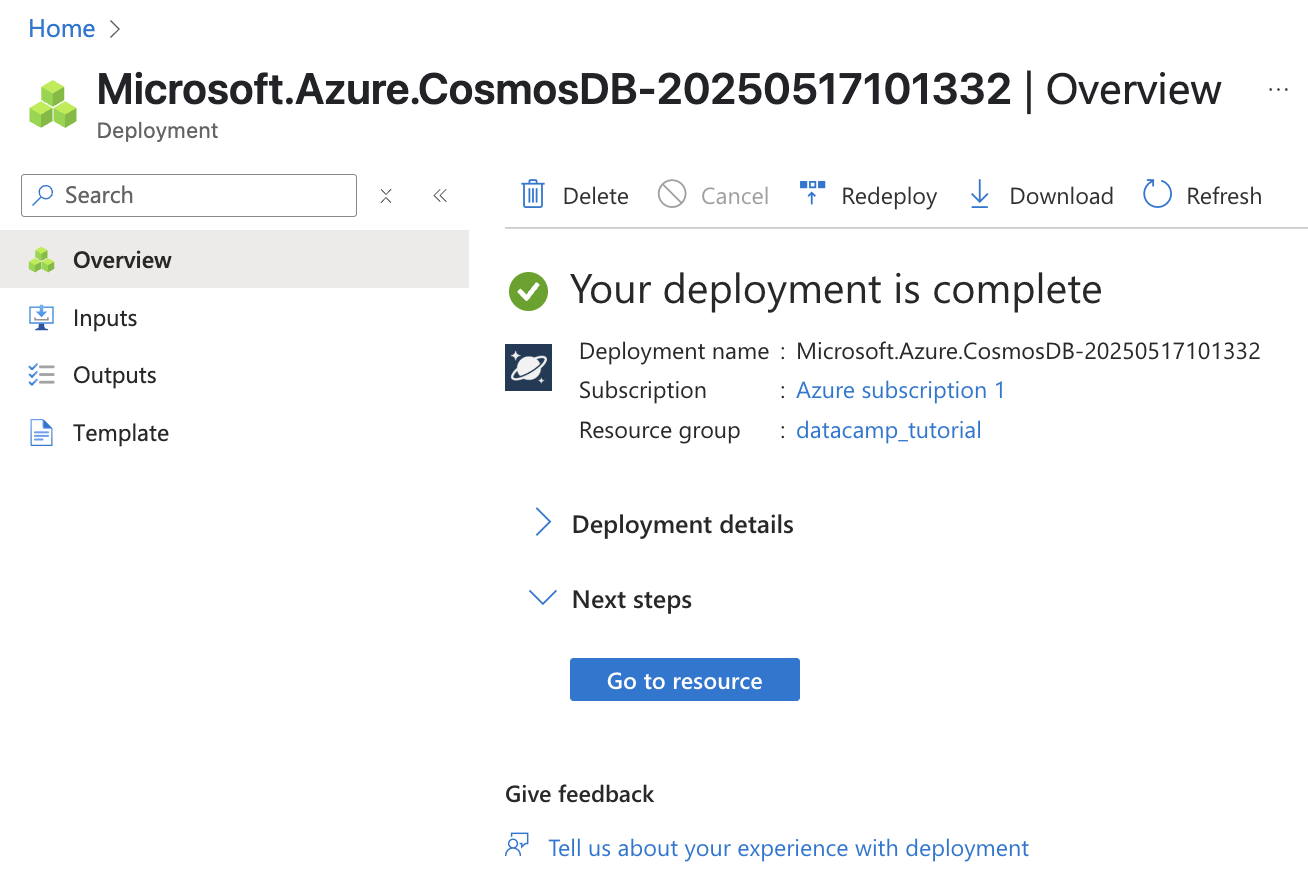
Capture d’écran d’Azure Cosmos DB. Informations sur la ressource créée
Dans le menu du compte Cosmos DB, ouvrez Data Explorer.
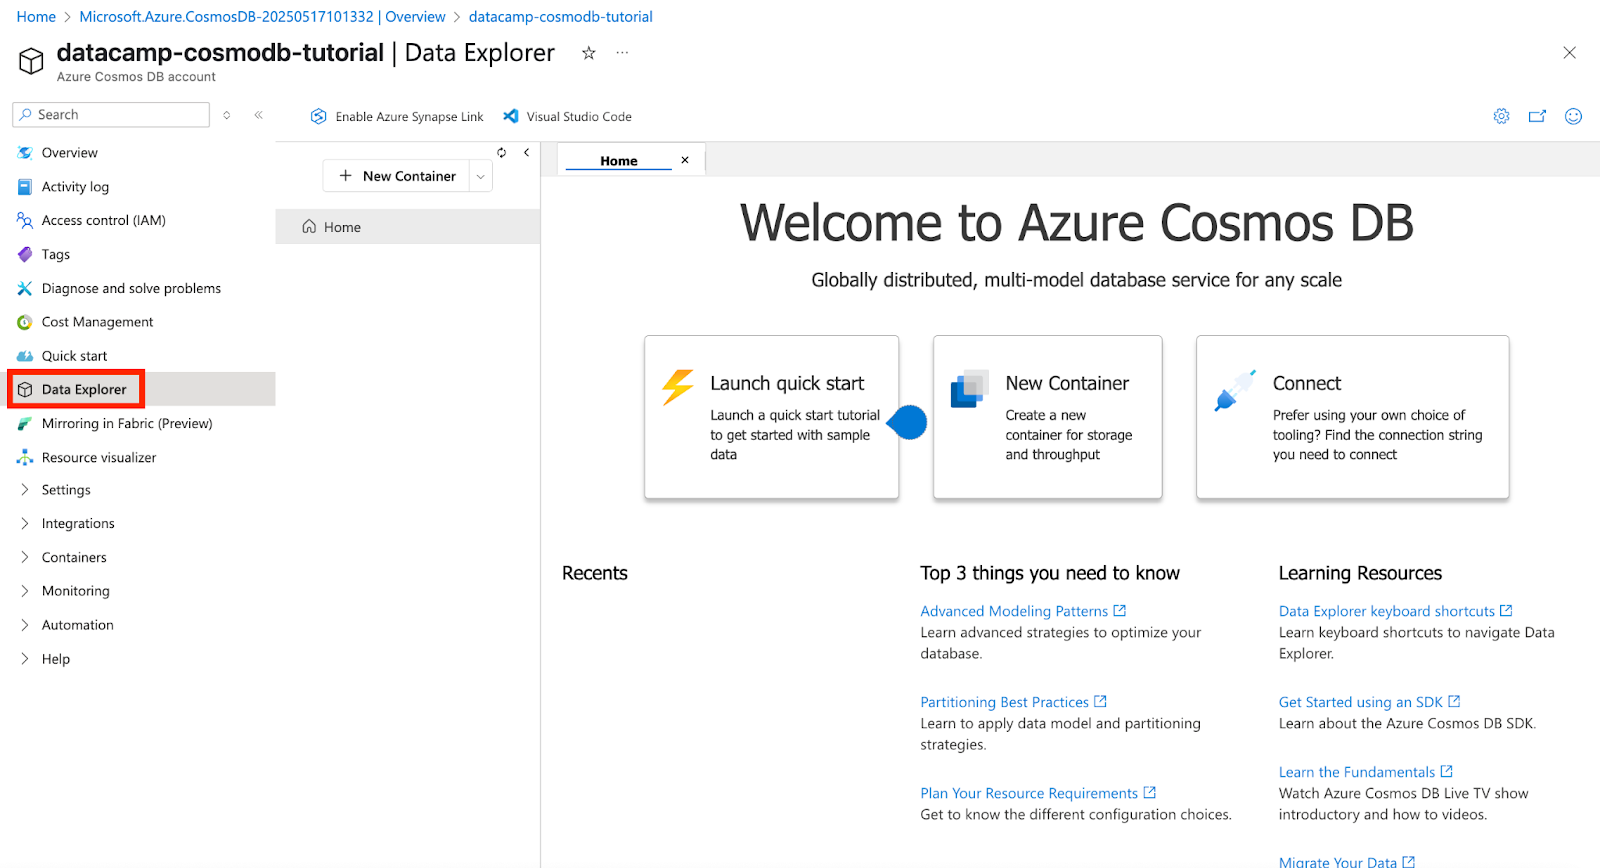
Capture d’écran d’Azure Cosmos DB. Exploration des données
Cliquez sur New Container pour ouvrir la boîte de dialogue de configuration.
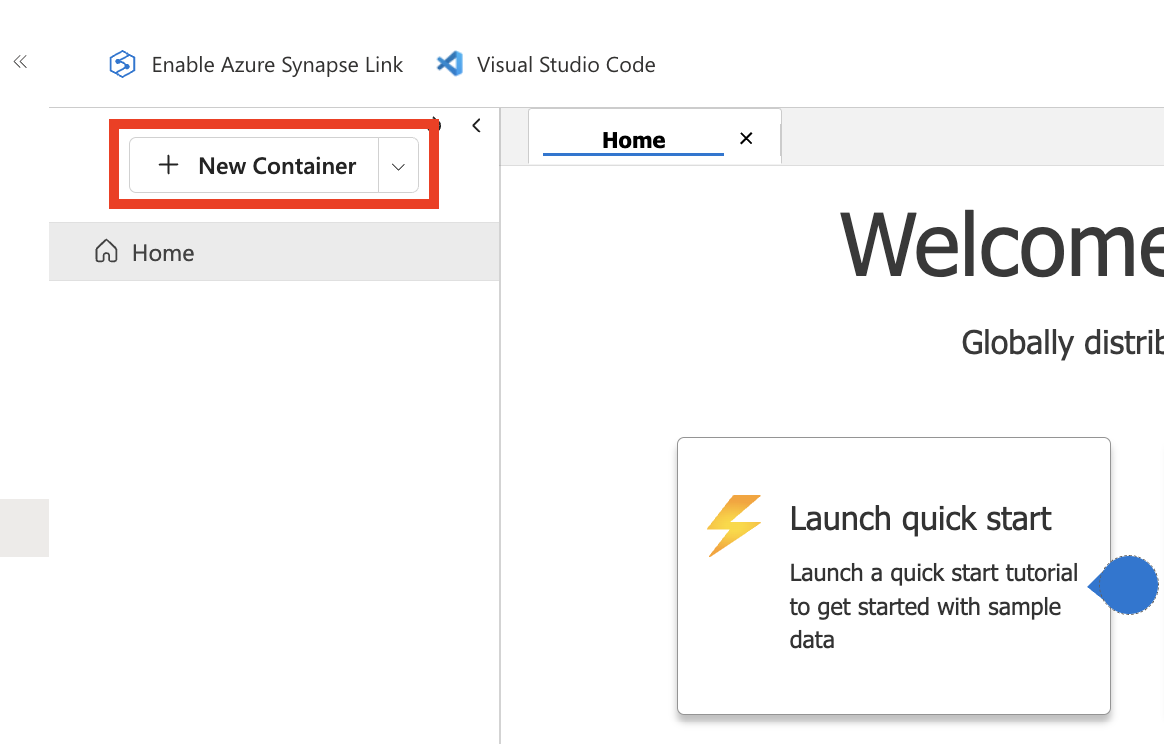
Capture d’écran d’Azure Cosmos DB. Création d’un nouveau conteneur
Définissez un nom de base de données et un nom de conteneur, et surtout, spécifiez une clé de partition pour assurer une répartition équilibrée des données et des performances optimales. Cliquez sur OK pour créer la base et le conteneur.
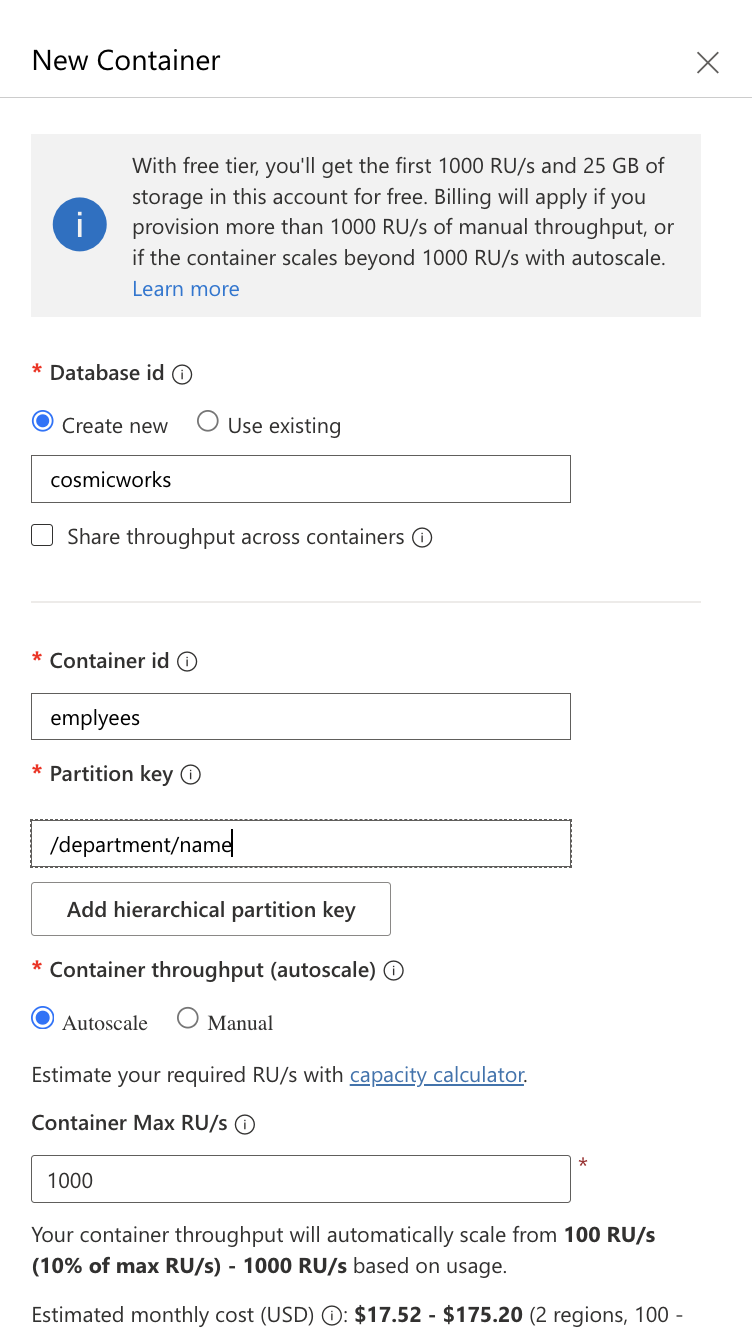
Capture d’écran d’Azure Cosmos DB. Saisie des caractéristiques du conteneur
Une fois créés, vous verrez les deux objets dans l’arborescence de Data Explorer.
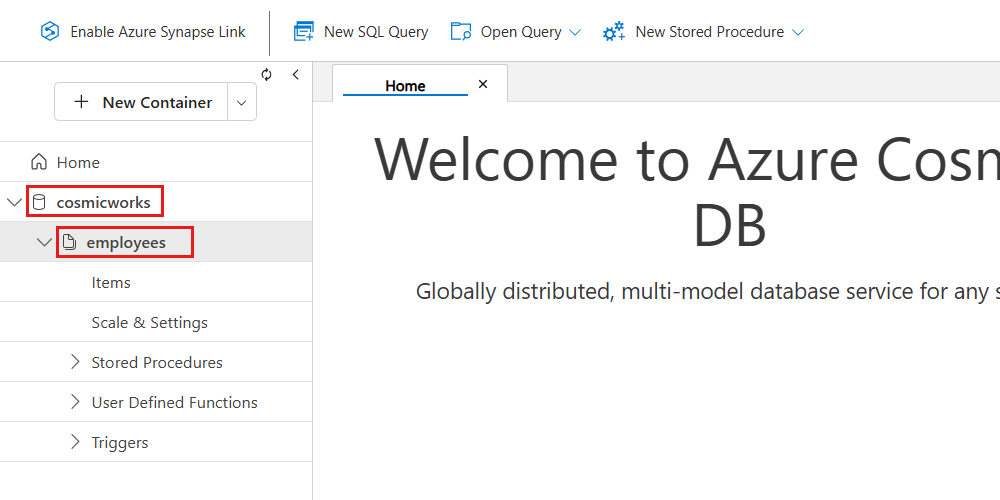
Capture d’écran d’Azure Cosmos DB. Vérification de l’arborescence des données
Dans le conteneur nouvellement créé (employees), déployez l’arborescence et sélectionnez Items.
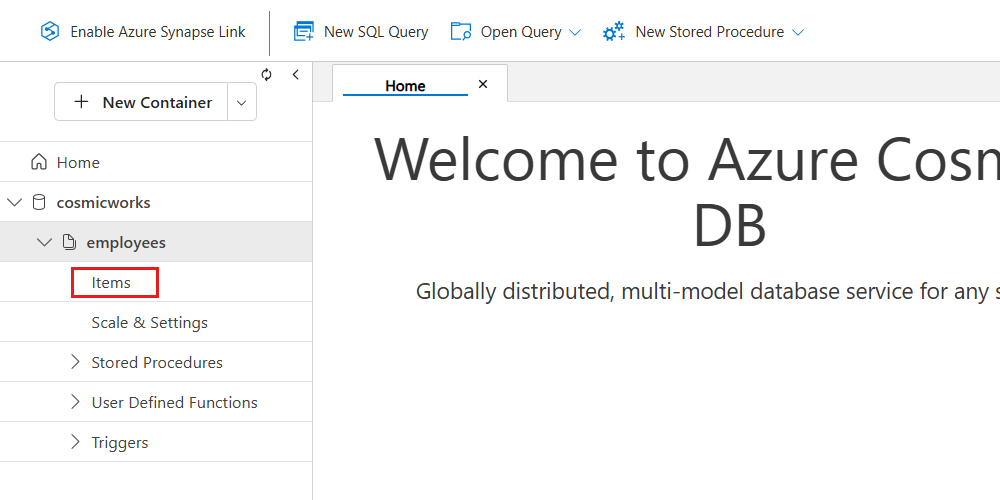
Capture d’écran d’Azure Cosmos DB. Consultation du conteneur
Cliquez sur New Item.
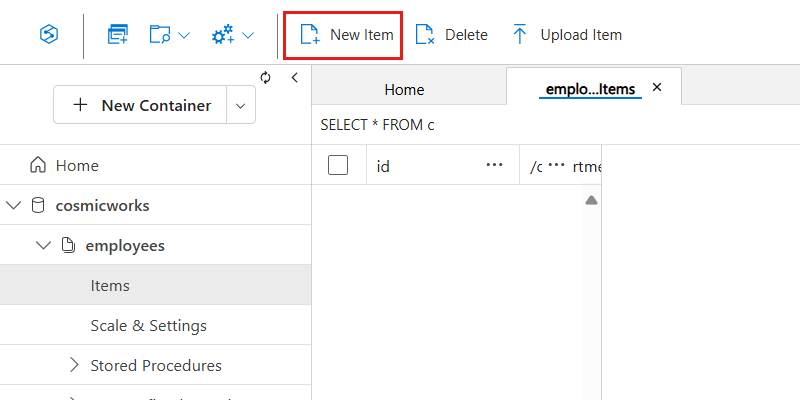
Capture d’écran d’Azure Cosmos DB. Création d’un nouvel élément
Insérez le JSON d’exemple ci-dessous, puis cliquez sur Save :
{
  "id": "aaaaaaaa-0000-1111-2222-bbbbbbbbbbbb",
  "name": {
    "first": "Josep",
    "last": "Ferrer"
  },
  "email": "<jferrers@datacampdummy.com>",
  "department": {
    "name": "Data Science"
  }
}
Pour tester une requête, sélectionnez New SQL Query dans le menu et saisissez la requête NoSQL suivante, qui effectue une recherche insensible à la casse des employés du département Logistics.
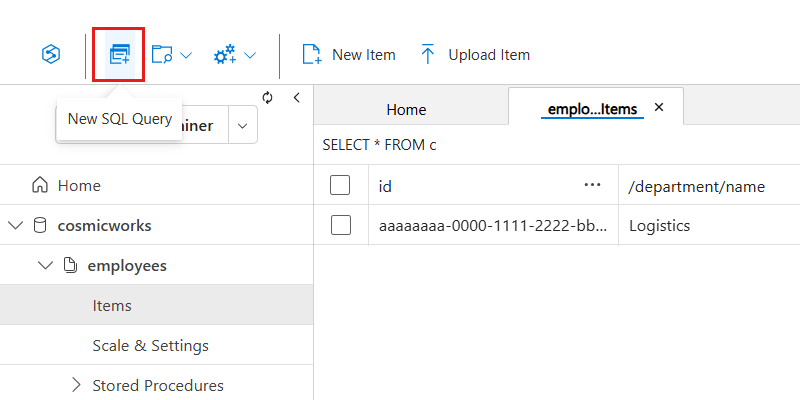
Capture d’écran d’Azure Cosmos DB. Contrôle du conteneur
SELECT VALUE {
    "name": CONCAT(e.name.last, " ", e.name.first),
    "department": e.department.name,
    "emailAddresses": [
        e.email
    ]
}
FROM
    employees e
WHERE
    STRINGEQUALS(e.department.name, "logistics", true)
Exécutez la requête : elle renvoie une réponse structurée :
[
  {
    "name": "Josep Ferrer",
    "department": "Logistics",
    "emailAddresses": [
      "jferrers@datacampdummy.com"
    ]
  }
]
Et voilà !
Azure Cosmos DB est une base NoSQL robuste, distribuée à l’échelle mondiale, pensée pour les applications cloud natives modernes. Avec son support multi-modèle, sa réplication active-active et ses niveaux de cohérence ajustables, elle excelle dans les scénarios exigeant haute disponibilité, réactivité temps réel et évolutivité élastique : systèmes dopés à l’IA, plateformes e-commerce, solutions IoT, etc.
Son infrastructure managée, sa modélisation flexible et son riche écosystème d’API en font un excellent choix pour développeurs et architectes. Cela dit, évaluez avec soin les limites potentielles (lacunes SQL, coûts à l’échelle) lors de la planification de charges en production.
Pour continuer à progresser, découvrez ces ressources :
Formez-vous avec DataCamp
Cours
Cours
Cours