
课程
R 语言网页抓取
4 小时
15.2K
实践并学习路径你的进步。
使用 Google 继续本教程旨在向您展示如何通过 R 的网页抓取来收集 H1B 签证相关数据。接下来,您还将学习如何解析 JSON 对象,以及如何存储和处理数据,从而对大规模的 H1B 申报数据集进行基础探索性数据分析(EDA)。
也许您能学到如何更好地定位自己成为候选人,或者学到一些新的 R 代码!
上周,DataCamp 博客“数据能否帮助您的 H-1B 签证申请”展示了多年来对 H-1B 数据分析的一些结果。现在,是时候亲自动手,自己分析数据,看看还能发现什么!Ted Kwartler 将通过一系列 R 教程引导您完成这一过程。
我有一位在德州律师事务所工作的朋友负责提交 H1B 签证。H1B 是美国的一种非移民签证,允许美国雇主临时雇用从事特殊职业的外国员工。显然,被接受非常困难,因为签证数量有限,而申请者成千上万。虽然这只是个例,但我决定自己探索这些数据,希望能帮助合格的候选人了解到美国是一个友好的地方!
我的 DataCamp 同事向我推荐了这个网站,其中包含 2012 至 2016 年的 H1B 数据。该站点声称将 200 万份 H1B 申请整理为一张表。我决定用编程方式收集这些数据(也就是网页抓取),因为我可不想用一辈子来复制/粘贴!如您所见,下面的图片展示了网站中波士顿的部分 H1B 数据:
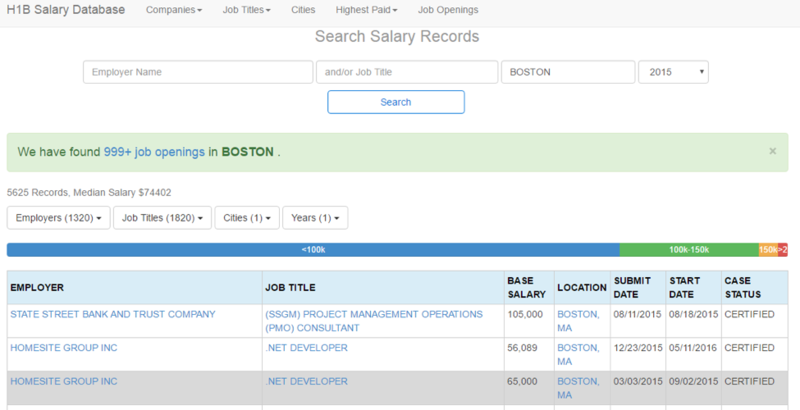
本教程将用到的库包括用于解析 JSON 对象的 jsonlite,用于“收割”HTML 的 rvest,pbapply(我个人很喜欢,因为它为基础apply 函数添加了进度条),以及提升 R 在大数据框上性能的 data.table。
library(jsonlite)
library(rvest)
library(pbapply)
library(data.table)在浏览该站点时,您会发现搜索表单会提供预填选项。例如,在城市字段中输入 “B” 会弹出下图所示的建议框。下面的图片显示了我输入 “B” 时的预填选项:
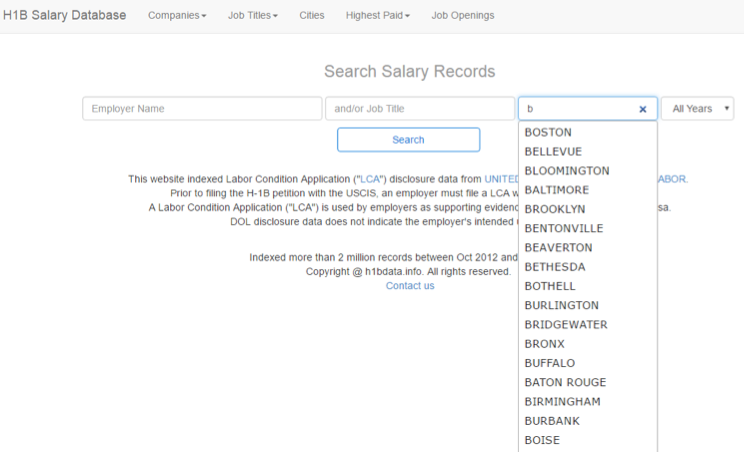
这意味着您可以把预填当作高效的站点查询方式。使用 Chrome,您可以刷新后右键“检查”页面,然后在开发者面板的“Network(网络)”中输入 “B” 来加载该弹窗。查看网络面板中的链接,您会发现有一个 PHP 查询会返回城市的 JSON 对象,如这个。目标是先收集所有建议城市,然后用该列表去抓取包含 H1B 数据的众多页面。观察上面的 URL,您会注意到它以一个字母结尾。因此,您可以将 paste0() 与 URL 基础部分 http://h1bdata.info/cities.php?term= 以及 letters 结合使用。基础部分会对 letters 中的每个值复用。 letters 对象是 R 内置的从 “a” 到 “z” 的向量。 json.cities 对象则是包含 a 到 z 所有预填建议 JSON 的 URL 向量。
json.cities<-paste0('http://h1bdata.info/cities.php?term=', letters)json.cities 对象是包含 26 个链接的向量,需要由 R 读取。结合使用 lapply() 或 pblapply() 与 fromJSON,R 会解析每个 JSON 对象以创建 all.cities。将结果嵌套在 unlist 中,使输出成为简单的字符串向量。通过这段代码,您就得到了所有预填城市的向量,可用于构建包含数据的实际网页。all.cities<-unlist(pblapply(json.cities,fromJSON))expand.grid()。在下面的代码中,您可以看到传入了城市信息 all.cities,以及使用 seq() 指定 2012 到 2016 年的年份。该函数创建了 5000 多个城市与年份的组合。expand.grid() 会以编程方式创建“Boston 2012、Boston 2013、Boston 2014”等组合,因为每个城市与每个年份代表唯一的因子组合。
city.year<-expand.grid(city=all.cities,yr=seq(2012,2016))url_encode() 函数会将 “Los Angeles” 改为 Los%20Angeles 以保证地址有效。您传入整个向量,url_encode() 会逐行处理:
city.year$city<-urltools::url_encode(as.character(city.year$city))paste0() 函数,将基础 URL 与 city.year 中的城市和州组合连接起来。可在这里查看示例链接。
all.urls<-paste0('http://h1bdata.info/index.php?em=&job=&city=', city.year[,1],'&year=', city.year[,2])完成上述步骤后,您可以创建一个名为 main 的自定义函数,以从每个页面收集数据。这是一个使用 rvest 函数的简单流程。首先,接收一个 URL,并由 read_html() 解析页面内容。接着,从页面的所有 HTML 信息中选择唯一的 html_table。main 函数将对象 x 转换为 data.table,以便在内存中高效存储。最后,在 main 结束前,您可以添加 Sys.sleep,以免被视为 DDOS 攻击。
main<-function(url.x){
  x<-read_html(url.x)
  x<-html_table(x)
  x<-data.table(x[[1]])
  return(x)
  Sys.sleep(5)
}
开抓!我喜欢使用带有进度条的 pblapply(),这样可以跟踪抓取进度。
只需在 pblapply() 中传入 all.urls 和主函数。R 会立即开始加载页面、收集表格,并在内存中保存该页面的 data.table。每个 URL 依次被收集并保存在内存中。
all.h1b<-pblapply(all.urls, main)呼!这花了好几个小时!此时 all.h1b 是一个 data.table 列表,每页一个。要将该列表统一为一个 data.table,您可以使用 rbindlist。这类似于 do.call(rbind, all.h1b),但更快。
all.h1b<-rbindlist(all.h1b)
最后保存数据,以免重来。幸运的是,我已在此保存了一份副本。
write.csv(all.h1b,'h1b_data.csv', row.names=F)
即使您已经抓取到了数据,仍需进行一些额外步骤,才能使其成为可管理的格式。
您将使用 lubridate 来帮助整理日期,也会用到提供字符串处理封装的 stringr。
library(lubridate)
library(stringr)
虽然这是个人偏好,但我喜欢设置 scipen=999。这不是必需的,但它能去除科学计数法。
options(scipen=999)事实证明,网页抓取共捕获了 200 万条 H1B 记录中的 180 万条。在我看来,180 万已经足够了。那么,让我们使用 fread() 来加载数据:这个函数类似 read.csv,但更高效,是“快速且友好的文件处理器”。
h1b.data<-fread('h1b_data.csv')抓取的数据列名为大写且包含空格。
因此,按名称引用它们会很麻烦,所以您首先要做的就是重命名。
重命名列名需要在赋值运算符(<-)两侧都使用函数。左侧使用 colnames() 并传入数据框;右侧可以传入字符串向量。
在这个示例中,您先用 tolower() 将原始名称转为小写。第二行使用全局替换函数 gsub()。
当 gsub() 识别到某个模式(此处为空格)时,会将所有实例替换为第二个参数(下划线)。最后,您需要告诉 gsub() 在 names(h1b.data)(代表已转为小写的数据框列名)上执行替换。
colnames(h1b.data)<-tolower(names(h1b.data))
colnames(h1b.data)<-gsub(' ', '_', names(h1b.data))
在探索数据时,我常用的第一个函数是 tail()。该函数会返回底部的若干行。此处 tail() 将返回最后 8 行。
这有助于您快速查看数据形状和向量情况。
tail(h1b.data, 8)接下来,我总会检查向量的类型。对于网页抓取的数据,数值或因子可能会变成文本。您会发现,尽早修正类型能避免日后麻烦!
使用 apply() 函数,传入 h1b.data、2 和函数 class。由于选择了 2,R 会检查每一列的类型并返回到控制台。您也可以用 apply() 的 1 来按行应用函数,但在此并无帮助。
apply(h1b.data,2,class)糟了!
所有列都是“character”,必须纠正。我将向您展示如何修改其中一个日期列,其余的留给您。使用 tail(),您可以查看被误分类日期的最后 6 行。
要修正日期,需要将 / 斜杠改为 -。再次使用 gsub() 搜索 / 并替换为 -。
tail(h1b.data$submit_date)
h1b.data$submit_date<-gsub('/', '-', h1b.data$submit_date)
加上短横线后,应用 mdy()(代表“月-日-年”)。因为日期就是按这个顺序声明的。如果顺序不同,您需要相应调整 mdy 字母的排列。
为确保列已正确更改,重新查看尾部并检查类型。tail() 应打印类似“2016-03-11 UTC”的日期,且向量类型应为“POSIXct”,而非“character”。
h1b.data$submit_date<-mdy(h1b.data$submit_date)
tail(h1b.data$submit_date)
class(h1b.data$submit_date)
对于此类分析,建议仅从日期中提取月份和年份到新列中。下面的代码声明了两个新列 $submit_month 和 $submit_yr。
在 lubridate 中,month() 函数可应用于整列以从日期中提取月份值。year() 函数同样接受日期列以创建 h1b.data$submit_yr。使用 head() 后,您应能看到新增了两列。
h1b.data$submit_month<-month(h1b.data$submit_date, label=T)
h1b.data$submit_yr<-year(h1b.data$submit_date)
head(h1b.data)
接下来,我们看看 $base_salary 列。它在千位处有逗号,R 将其视为字符,因此必须更改。gsub() 再次出场,移除逗号并替换为空字符。然后对 h1b.data$base_salary 应用 as.numeric(),正式将其改为数值。
您可以在第三行用 head() 查看该新向量的一部分。
h1b.data$base_salary<-gsub(',','',h1b.data$base_salary)
h1b.data$base_salary<-as.numeric(h1b.data$base_salary)
head(h1b.data$base_salary)
另一种切分数据的方式是按州。检查 h1b.data$location 列时,您会看到城市和州由逗号分隔。下面的代码使用 str_split_fixed() 按第一个逗号拆分位置信息。只需传入该列、分隔字符以及要返回的列数。所得的 state 对象是一个大型矩阵,行数与 h1b.data 相同,包含 2 列。
state<-str_split_fixed(h1b.data$location,', ', 2)接下来的两行代码将各自的州信息向量以 $city 和 $state 绑定到 h1b.data。这些向量并不完美,因为拼写可能不同,例如 “Winston Salem” 与 “Winston-Salem”。总体来说,这种方法对简单 EDA 已足够,但请记住,在其他分析中可能需要进行一定的术语聚合。
h1b.data$city<-state[,1]
h1b.data$state<-state[,2] 如果您正在申请 H1B 签证,您会想知道哪些州的数量最多,以提高被接受的几率。table() 函数用于统计分类变量,并可轻松应用于 h1b.data$state。第二行中,您可以创建一个小数据框来保存州名和统计得到的 H1B 数据。
state.tally<-table(h1b.data$state)
state.tally<-data.frame(state=names(state.tally), h1b=as.vector(state.tally))
使用 state.tally 和 barplot() 将创建按州划分的 H1B 值基础柱状图。第二个参数 names.arg 声明柱状标签,las=3 指示 R 将标签垂直放置。您会看到由于逗号拆分导致的一些位置名称不够规范,但意思很清晰……H1B 申请者很可能在 CA、NJ、NY 或 TX。
barplot(state.tally$h1b,
        names.arg = names(table(h1b.data$state)),
        las=3)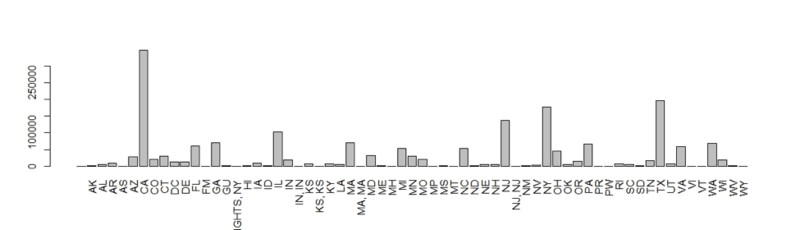
您看到了 2012 至 2016 年各州的 H1B 签证计数。
接下来,让我们尝试理解 H1B 签证与外部事实之间的相关性。为简单起见,R 内置了一个名为 state.x77 的数据集。这是一个包含 50 行(每州一行)的矩阵,记录了 1977 年美国人口普查中的人口、预期寿命等信息。
提示:在您自己的分析中请使用更近期的数据源。
目前,使用 state.x77 是一个很好的学习示例。使用 head() 查看这个内置数据集。
head(state.x77)让我们把这些信息与 state.tally 合并到一个更大的数据框中,以理解它们的关系。为此,创建包含州缩写(state.abb)和旧的 1977 年普查数据的 state.data 数据框。然后调用 merge,传入 state.tally 和 state.data。
您可以显式声明以 state 列为连接键。在第三行中通过索引第 15 到 20 行来查看数据框的一部分。
state.data<-data.frame(state=state.abb,state.x77)
state.data<-merge(state.tally,
                  state.data,
                  by='state')
state.data[15:20,]
一个基础的 EDA 函数是 cor:它会打印两个变量之间的相关系数。
请记住,相关系数范围从 -1 到 1:0 表示变量没有相关性,可能不相关;接近 1 表示正相关(希望像 R 编程与收入一样);负数表示关系呈相反方向,例如 R 编程与社交生活!
这段代码将 cor 应用于 1977 年的各州人口与当前的 H1B 计数。请记住,尽管存在时间不匹配,这段代码旨在说明如何进行分析。您可以将 $Population 更改为数据框中的其他向量。
cor(state.data$Population, state.data$h1b)研究变量关系的另一种方法是使用散点图,尤其是散点图矩阵。使用 pairs() 可以快速绘制散点图矩阵。下面的代码使用公式来定义关系。每一列单独声明,并用加号连接。data 参数接受数据框,main 用于声明图标题。
pairs(~ h1b + Population + Income,
      data = state.data,
      main='h1b relationships')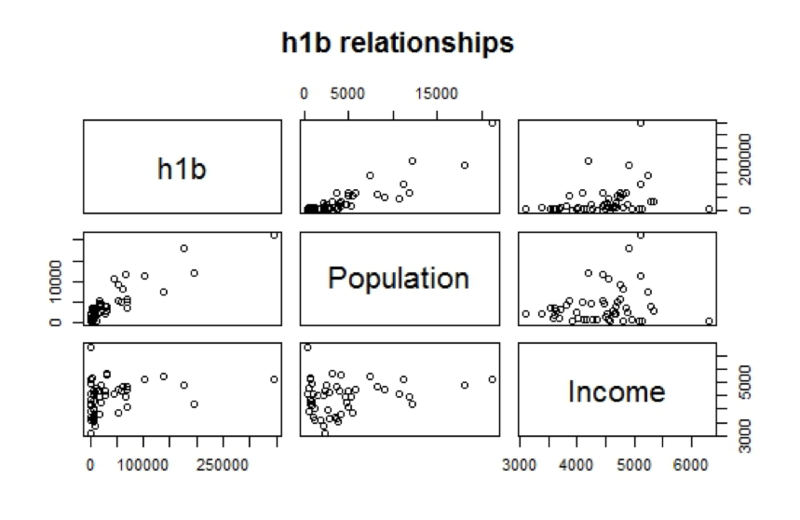
您可以看到该散点图矩阵将 H1B 计数与各州的 Population 和 Income 进行了可视化。
您可以观察到 Population 与 h1b 之间存在一定关系。这在直觉上也说得通:人口更多的州会有更多需要 H1B 签证的工作机会。
要从矩阵中“放大”到单个图,只需调用 plot() 并传入两个变量。
plot(state.data$Income,state.data$h1b,
main = 'Income to H1B')您才刚刚开始我们的 H1B 签证探索!这个数据集非常丰富,在下一篇文章中,您将探索薪资数据,去除异常值,并制作更有说服力的 ggplot2 可视化。
您还将基于这些 EDA 概念,探索 H1B 状态随时间的变化以及顶级雇主。我先给您展示一个很酷的可视化——箱线图,它用以下代码展示了按 H1B 签证状态划分的薪资分布:
ggplot(h1b.data) +
geom_boxplot(aes(factor(case_status),base_salary,fill=as.factor(case_status))) +
  ylim(0,100000) +
  theme_gdocs() +
  scale_fill_gdocs() +
  theme(axis.text.x=element_blank())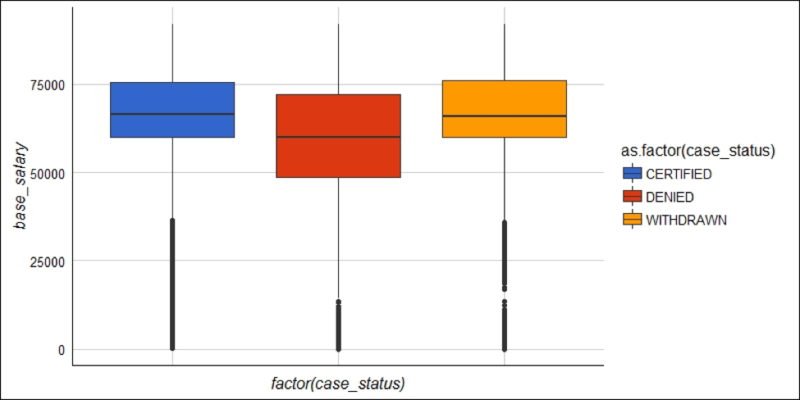
请继续关注“用 R 探索 H-1B 数据”系列教程的后续内容!与此同时,欢迎查看我们的 R 数据框教程、R 数据导入进阶课程或 用 dplyr 进行 R 中数据处理课程。
R 课程
课程
课程
实践并学习路径你的进步。
使用 Google 继续