{count, plural, one {Kursus} other {Kursus}}
Web Scraping di R
{hours} jam
15.2K
Tujuan tutorial ini adalah menunjukkan cara Anda dapat mengumpulkan data tentang visa H1B melalui web scraping dengan R. Selanjutnya, Anda juga akan mempelajari cara mem-parsing objek JSON, serta cara menyimpan dan memanipulasi data sehingga Anda dapat melakukan analisis data eksploratori (EDA) dasar pada kumpulan data besar pengajuan H1B.
Mungkin Anda bisa mempelajari cara memposisikan diri terbaik sebagai kandidat atau menemukan kode R baru!
Minggu lalu, blog DataCamp "Can Data Help Your H-1B Visa Application" menampilkan sebagian hasil analisis data H-1B selama bertahun-tahun. Sekarang, saatnya Anda terjun langsung menganalisis datanya sendiri dan melihat temuan lainnya! Ted Kwartler akan memandu Anda melalui serangkaian tutorial R.
Saya punya teman di firma hukum Texas yang mengurus pengajuan visa H1B. H1B adalah visa non-imigran di Amerika Serikat yang memungkinkan pemberi kerja AS mempekerjakan pekerja asing untuk sementara waktu pada pekerjaan khusus. Ternyata, untuk diterima sangat sulit karena kuota visa terbatas sementara pelamar berjumlah ribuan. Walau itu bersifat anekdotal, saya memutuskan mengeksplorasi datanya sendiri dengan harapan dapat membantu kandidat yang memenuhi syarat mengetahui bahwa AS adalah tempat yang ramah!
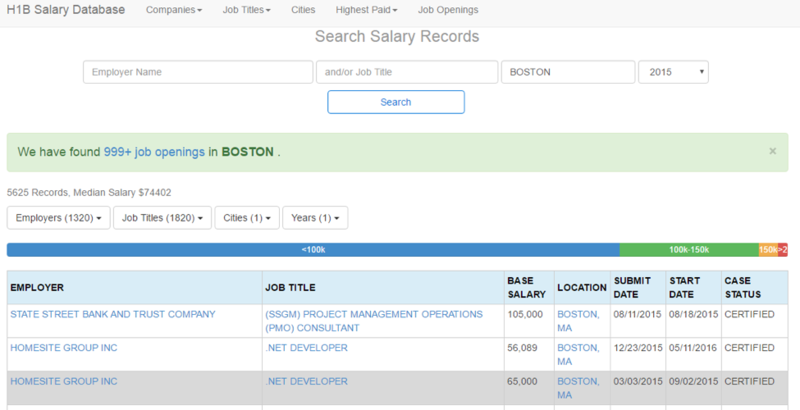
Rekan saya di DataCamp menunjukkan situs ini yang merupakan situs sederhana berisi data H1B dari 2012 hingga 2016. Situs tersebut mengklaim memiliki 2 juta aplikasi H1B yang diorganisasi dalam satu tabel.Saya memutuskan untuk mengumpulkan data ini secara terprogram (baca: web scrape) karena saya tidak akan menyalin/menempel seumur hidup! Seperti yang Anda lihat, gambar di bawah menunjukkan sebagian situs yang menampilkan data H1B Boston:
Pustaka yang akan digunakan dalam tutorial ini meliputi jsonlite untuk mem-parsing objek JSON, rvest yang “memanen” HTML, pbapply yang menjadi favorit saya karena menambahkan bilah progres ke fungsi apply bawaan, dan data.table yang meningkatkan performa R pada data frame besar.
library(jsonlite)
library(rvest)
library(pbapply)
library(data.table)Saat Anda menjelajahi situs, Anda akan menyadari formulir pencarian menyarankan opsi praisi. Misalnya, mengetik “B” pada kolom kota akan memunculkan modal dengan saran seperti di bawah. Gambar di bawah menunjukkan opsi praisi saat saya mengetik “B”:
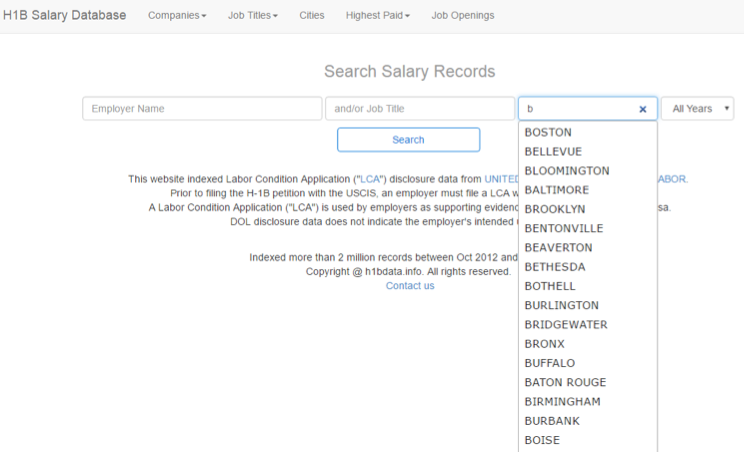
Artinya, Anda dapat menggunakan praisi sebagai cara efisien untuk mengajukan kueri ke situs. Dengan Chrome, Anda bisa memuat ulang lalu klik kanan untuk “Inspect” halaman, lalu buka “Network” di panel pengembang dan akhirnya ketik “B” di halaman untuk memuat modal. Menjelajahi tautan panel network, Anda akan menemukan kueri PHP yang mengembalikan objek JSON berisi kota seperti ini. Tujuannya adalah terlebih dahulu mengumpulkan semua kota yang disarankan dan kemudian menggunakan daftar tersebut untuk melakukan scraping banyak halaman yang memuat data H1B. Saat Anda membuka URL sebelumnya, Anda akan melihat bahwa URL diakhiri dengan sebuah huruf. Jadi, Anda bisa menggunakan paste0() dengan basis URL, http://h1bdata.info/cities.php?term=, dan letters. Basisnya akan digunakan ulang untuk setiap nilai dalam letters. Objek letters adalah vektor bawaan R dari “a” hingga “z”. Objek json.cities adalah vektor URL, a hingga z, yang berisi semua saran praisi dalam bentuk JSON.
json.cities<-paste0('http://h1bdata.info/cities.php?term=', letters)json.cities adalah vektor berisi 26 tautan yang harus dibaca oleh R. Dengan menggunakan lapply() atau pblapply() bersama fromJSON, R akan mem-parsing masing-masing objek JSON untuk membuat all.cities. Anda membungkus hasilnya dalam unlist sehingga keluarannya menjadi vektor string sederhana. Dengan kode ini, Anda memiliki semua kota praisi yang diorganisasi dalam sebuah vektor yang dapat digunakan untuk menyusun halaman web aktual yang berisi data.all.cities<-unlist(pblapply(json.cities,fromJSON))expand.grid(). Pada kode di bawah, Anda melihat bahwa informasi kota diteruskan, all.cities, lalu tahun menggunakan seq() dari 2012 hingga 2016. Fungsi ini membuat lebih dari 5000 kombinasi kota-tahun. expand.grid() secara terprogram membuat Boston 2012, Boston 2013, Boston 2014, dst., karena setiap kota dan setiap tahun merepresentasikan kombinasi faktor yang unik.
city.year<-expand.grid(city=all.cities,yr=seq(2012,2016))url_encode() mengubah “Los Angeles” menjadi Los%20Angeles agar alamatnya valid. Anda meneruskan seluruh vektor dan url_encode() akan bekerja per baris:
city.year$city<-urltools::url_encode(as.character(city.year$city))paste0() lagi untuk menggabungkan URL dasar dengan kombinasi kota dan negara bagian dalam city.year. Lihat contoh tautan di sini.
all.urls<-paste0('http://h1bdata.info/index.php?em=&job=&city=', city.year[,1],'&year=', city.year[,2])Setelah melalui langkah-langkah sebelumnya, Anda dapat membuat fungsi kustom bernama main untuk mengumpulkan data dari setiap halaman. Alurnya sederhana menggunakan fungsi dari rvest. Pertama, sebuah URL diterima dan read_html() mem-parsing konten halaman. Selanjutnya, html_table tunggal halaman dipilih dari seluruh informasi HTML lainnya. Fungsi main mengonversi objek x menjadi data.table agar dapat disimpan secara efisien di memori. Terakhir, sebelum menutup main, Anda dapat menambahkan Sys.sleep agar Anda tidak dianggap sebagai serangan DDOS.
main<-function(url.x){
  x<-read_html(url.x)
  x<-html_table(x)
  x<-data.table(x[[1]])
  return(x)
  Sys.sleep(5)
}
Ayo ambil datanya! Saya suka menggunakan bilah progres pblapply() agar bisa memantau progres scraping.
Anda cukup meneruskan all.urls dan fungsi main ke fungsi pblapply(). R segera bekerja memuat halaman, mengumpulkan tabel, dan menahan sebuah data.table di memori untuk halaman tersebut. Setiap URL dikoleksi secara bergiliran dan ditahan di memori.
all.h1b<-pblapply(all.urls, main)Huh! Itu butuh waktu berjam-jam! Pada titik ini all.h1b adalah daftar data table, satu per halaman. Untuk menyatukan daftar menjadi satu data table, Anda dapat menggunakan rbindlist. Ini mirip dengan do.call(rbind, all.h1b) tetapi jauh lebih cepat.
all.h1b<-rbindlist(all.h1b)
Terakhir, simpan datanya agar Anda tidak perlu melakukannya lagi. Untungnya, saya menyimpan salinannya di sini.
write.csv(all.h1b,'h1b_data.csv', row.names=F)
Meskipun Anda sudah melakukan scraping data, beberapa langkah tambahan diperlukan agar datanya menjadi format yang mudah dikelola.
Anda menggunakan lubridate untuk membantu menata tanggal. Anda juga memanfaatkan stringr, yang menyediakan pembungkus untuk manipulasi string.
library(lubridate)
library(stringr)
Walaupun ini preferensi pribadi, saya suka menggunakan scipen=999. Ini tidak wajib tetapi menghilangkan notasi ilmiah.
options(scipen=999)Ternyata web scrape menangkap 1,8 juta dari 2 juta catatan H1B. Menurut saya, 1,8 juta sudah cukup baik. Jadi mari muat datanya menggunakan fread(): fungsi ini mirip read.csv tetapi lebih efisien sebagai “fast & friendly file finagler”.
h1b.data<-fread('h1b_data.csv')Nama kolom data hasil scraping huruf besar dan mengandung spasi.
Karena itu, merujuknya berdasarkan nama cukup merepotkan sehingga hal pertama yang ingin Anda lakukan adalah menggantinya.
Mengganti nama kolom membutuhkan fungsi di kedua sisi operator penugasan (<-). Di kiri gunakan colnames() dan teruskan data frame-nya. Di sisi kanan operator, Anda dapat meneruskan vektor string.
Pada contoh ini, Anda terlebih dahulu mengambil nama asli dan mengubahnya menjadi huruf kecil menggunakan tolower(). Pada baris kedua Anda menerapkan gsub(), sebuah fungsi substitusi global.
Saat gsub() mengenali pola, dalam hal ini spasi, ia akan mengganti semua kemunculan dengan parameter kedua, yaitu garis bawah. Terakhir, Anda perlu memberi tahu gsub() untuk melakukan penggantian pada names(h1b.data) yang merepresentasikan kolom data frame yang kini huruf kecil.
colnames(h1b.data)<-tolower(names(h1b.data))
colnames(h1b.data)<-gsub(' ', '_', names(h1b.data))
Salah satu fungsi pertama yang saya gunakan saat mengeksplorasi data adalah fungsi tail(). Fungsi ini akan mengembalikan baris terbawah. Di sini, tail() akan mengembalikan 8 baris terakhir.
Ini membantu Anda dengan cepat melihat bentuk data dan seperti apa vektornya.
tail(h1b.data, 8)Selanjutnya, saya selalu memeriksa kelas vektor. Dengan data hasil web scraping, nilai numerik atau faktor bisa menjadi teks. Anda akan melihat bahwa mengoreksi kelas sekarang dapat menghindari frustrasi di kemudian hari!
Menggunakan fungsi apply(), Anda dapat meneruskan h1b.data, lalu 2 dan fungsi class. Karena Anda memilih 2, R akan memeriksa kelas setiap kolom dan mengembalikannya ke konsol Anda. Anda dapat menggunakan apply() dengan 1 untuk menerapkan fungsi per baris tetapi itu tidak membantu dalam kasus ini.
apply(h1b.data,2,class)Aduh!
Semua kolom bertipe “character” dan harus dikoreksi. Saya akan menunjukkan cara mengubah salah satu kolom tanggal dan sisanya Anda lanjutkan. Dengan menggunakan tail(), Anda dapat memeriksa 6 baris terakhir dari tanggal yang salah klasifikasi.
Untuk memperbaiki tanggal, garis miring / perlu diubah menjadi -. Sekali lagi, gunakan gsub() untuk mencari /, dan menggantinya dengan -.
tail(h1b.data$submit_date)
h1b.data$submit_date<-gsub('/', '-', h1b.data$submit_date)
Dengan tanda hubung sudah ditempatkan, Anda menerapkan mdy() yang merupakan singkatan dari "month, day, year". Ini karena tanggal dideklarasikan dalam urutan tersebut. Jika urutannya berbeda, Anda akan menata ulang huruf mdy sesuai urutan.
Untuk memastikan bahwa kolom telah diubah dengan benar, Anda memeriksa kembali tail dan memeriksa kelasnya. tail() seharusnya mencetak tanggal yang mirip “2016-03-11 UTC” dan kelas vektor seharusnya “POSIXct” alih-alih “character”.
h1b.data$submit_date<-mdy(h1b.data$submit_date)
tail(h1b.data$submit_date)
class(h1b.data$submit_date)
Untuk jenis analisis ini, ada baiknya mengekstrak hanya bulan dan tahun dari tanggal ke kolom baru. Pada kode di bawah Anda melihat dua kolom baru $submit_month dan $submit_yr dideklarasikan.
Dalam lubridate fungsi month() dapat diterapkan ke seluruh kolom untuk mengekstrak nilai bulan dari tanggal. Fungsi year() serupa menerima kolom tanggal untuk membuat h1b.data$submit_yr. Saat Anda menggunakan fungsi head(), kini Anda akan melihat dua kolom baru telah dibuat.
h1b.data$submit_month<-month(h1b.data$submit_date, label=T)
h1b.data$submit_yr<-year(h1b.data$submit_date)
head(h1b.data)
Berikutnya, mari periksa kolom $base_salary. Kolom ini memiliki tanda koma pada posisi ribuan dan R menganggapnya sebagai character, jadi harus diubah. Sekali lagi gsub() menjadi penyelamat untuk menghapus koma dan menggantinya dengan karakter kosong. Lalu as.numeric() diterapkan ke h1b.data$base_salary untuk benar-benar mengubah nilainya menjadi angka.
Anda dapat memeriksa sebagian vektor baru dengan head() pada baris ketiga.
h1b.data$base_salary<-gsub(',','',h1b.data$base_salary)
h1b.data$base_salary<-as.numeric(h1b.data$base_salary)
head(h1b.data$base_salary)
Cara lain memotong data ini adalah berdasarkan negara bagian. Saat Anda memeriksa kolom h1b.data$location, Anda melihat bahwa kota dan negara bagian dipisahkan oleh koma. Kode di bawah menggunakan str_split_fixed() untuk memisahkan informasi lokasi pada koma pertama. Cukup teruskan kolomnya, karakter pemisah, dan jumlah kolom yang akan dikembalikan. Objek state yang dihasilkan adalah matriks besar dengan jumlah baris yang sama dengan h1b.data dan 2 kolom.
state<-str_split_fixed(h1b.data$location,', ', 2)Dua baris kode berikutnya menggabungkan vektor negara bagian individual sebagai $city dan $state ke h1b.data. Vektornya tidak sempurna karena ejaan bisa berbeda seperti “Winston Salem” versus “Winston-Salem”. Secara umum, metode ini cukup baik untuk EDA sederhana tetapi ingat penggabungan istilah mungkin dibutuhkan dalam analisis lain.
h1b.data$city<-state[,1]
h1b.data$state<-state[,2] Jika Anda mengajukan visa H1B, Anda ingin tahu negara bagian mana yang memiliki jumlah terbanyak untuk meningkatkan peluang diterima. Fungsi table() digunakan untuk menghitung variabel kategorikal dan mudah diterapkan pada h1b.data$state. Pada baris kedua, Anda dapat membuat data frame kecil untuk menangkap nama negara bagian dan hitungan data H1B.
state.tally<-table(h1b.data$state)
state.tally<-data.frame(state=names(state.tally), h1b=as.vector(state.tally))
Menggunakan state.tally dan barplot() akan membuat plot batang dasar nilai H1B per negara bagian. Parameter kedua names.arg menyatakan label batang dan las=3 memberi tahu R untuk meletakkan label secara vertikal. Anda dapat melihat beberapa lokasi yang kurang rapi akibat pemisahan koma namun pesannya jelas… pelamar H1B kemungkinan besar berada di CA, NJ, NY, atau TX.
barplot(state.tally$h1b,
        names.arg = names(table(h1b.data$state)),
        las=3)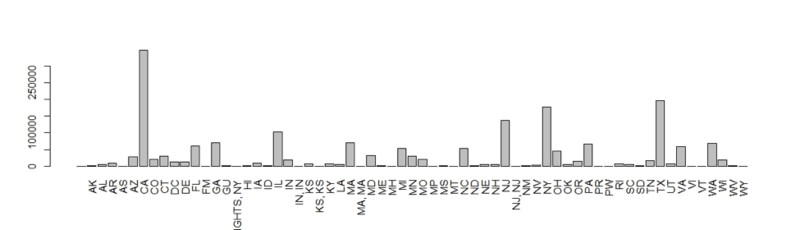
Anda melihat hitungan visa H1B per negara bagian dari 2012 hingga 2016.
Berikutnya, mari coba memahami korelasi antara visa H1B dan fakta eksternal. Untuk kesederhanaan, R memiliki dataset bawaan bernama state.x77. Ini adalah matriks dengan 50 baris, 1 per negara bagian, dan fakta seperti populasi dan harapan hidup pada Sensus AS 1977.
Tip: gunakan sumber data yang lebih baru dalam analisis Anda sendiri.
Untuk saat ini, menggunakan state.x77 adalah contoh yang baik untuk dipelajari. Periksa dataset bawaan ini menggunakan head().
head(state.x77)Mari gabungkan informasi ini dengan data state.tally ke dalam data frame yang lebih besar untuk memahami hubungan. Untuk melakukannya, buat data frame state.data yang berisi singkatan negara bagian, state.abb, dan data Sensus 1977. Lalu panggil merge dengan meneruskan state.tally, dan state.data.
Anda dapat secara eksplisit menyatakan kolom state sebagai vektor untuk join. Periksa sebagian data frame pada baris ketiga dengan mengindeks baris ke-15 hingga ke-20.
state.data<-data.frame(state=state.abb,state.x77)
state.data<-merge(state.tally,
                  state.data,
                  by='state')
state.data[15:20,]
Fungsi EDA dasar adalah cor: ini akan mencetak korelasi antara dua variabel.
Ingat bahwa korelasi berkisar dari -1 hingga 1: 0 berarti variabel tidak berkorelasi dan kemungkinan tidak terkait. Angka yang mendekati 1 berarti nilainya berkorelasi positif (semoga) seperti pemrograman R dan pendapatan. Angka negatif berarti hubungan bergerak berlawanan arah, seperti pemrograman R dan kehidupan sosial!
Kode ini menerapkan cor pada populasi negara bagian tahun 1977 dan hitungan H1B saat ini. Ingat, kodenya dimaksudkan untuk mengilustrasikan cara melakukan analisis meskipun terjadi ketidakcocokan temporal. Anda dapat mengganti $Population untuk merujuk vektor lain dalam data frame.
cor(state.data$Population, state.data$h1b)Cara lain untuk menyelidiki hubungan variabel adalah dengan scatterplot, khususnya matriks scatterplot. Gunakan pairs() untuk dengan cepat membuat matriks scatterplot. Kode di bawah menggunakan sebuah formula untuk mendefinisikan hubungan. Setiap kolom dinyatakan secara individual dengan tanda plus di antaranya. Parameter data menerima data frame dan main sekadar menyatakan judul plot.
pairs(~ h1b + Population + Income,
      data = state.data,
      main='h1b relationships')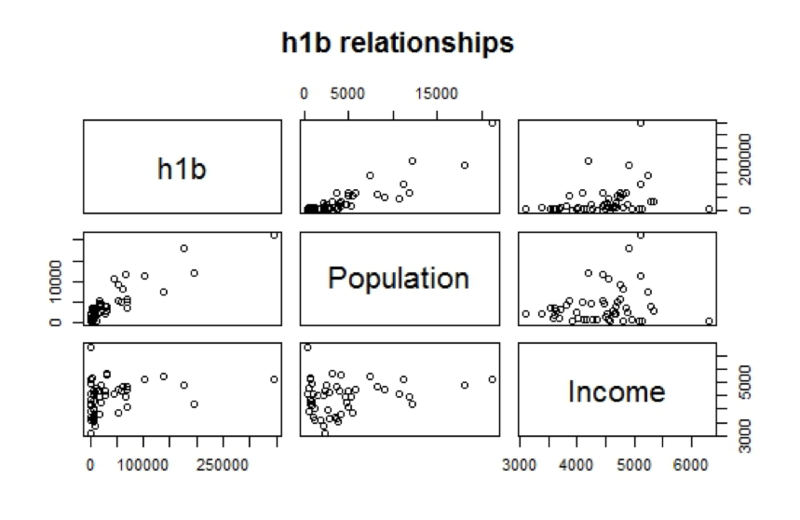
Anda melihat bahwa matriks scatterplot ini memvisualisasikan hitungan H1B terhadap Population dan Income negara bagian.
Anda dapat mengamati adanya hubungan antara Population dan h1b. Ini masuk akal secara intuitif karena negara bagian yang lebih padat penduduk cenderung memiliki lebih banyak peluang kerja yang memerlukan visa H1B.
Untuk “memperbesar” satu plot dari matriks, cukup panggil plot() dan teruskan kedua variabelnya.
plot(state.data$Income,state.data$h1b,
main = 'Income to H1B')Anda baru memulai eksplorasi visa H1B! Kumpulan data ini sangat kaya dan pada pos berikutnya Anda akan mengeksplorasi data gaji, menyingkirkan outlier, dan membuat visual ggplot2 yang lebih meyakinkan.
Anda juga akan membangun konsep EDA ini dengan mengeksplorasi status H1B dari waktu ke waktu dan juga pemberi kerja teratas. Salah satu visual keren yang akan saya tunjukkan kepada Anda adalah box plot yang menampilkan sebaran gaji berdasarkan status visa H1B menggunakan kode ini:
ggplot(h1b.data) +
geom_boxplot(aes(factor(case_status),base_salary,fill=as.factor(case_status))) +
  ylim(0,100000) +
  theme_gdocs() +
  scale_fill_gdocs() +
  theme(axis.text.x=element_blank())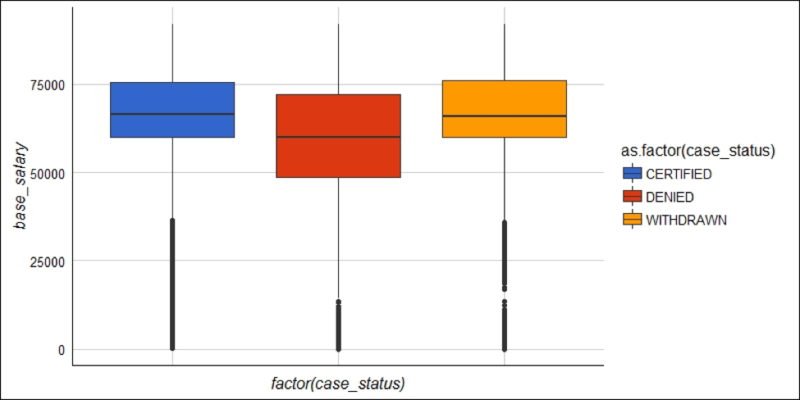
Nantikan bagian selanjutnya dalam seri tutorial "Menjelajahi Data H-1B dengan R"! Sementara itu, pertimbangkan untuk melihat tutorial data frame R kami, kursus Importing Data in R kami, atau kursus Data Manipulation in R dengan dplyr.
Kursus R
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



