
कोर्स
Web Scraping in R
4 घंटा
15.2K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंइस ट्यूटोरियल का उद्देश्य आपको दिखाना है कि आप R के साथ वेब स्क्रैपिंग के जरिए H1B वीज़ा के बारे में डेटा कैसे इकट्ठा कर सकते हैं। अगला, आप यह भी सीखेंगे कि JSON ऑब्जेक्ट्स को कैसे पार्स किया जाए, और बड़े H1B फाइलिंग डेटा सेट पर एक बुनियादी एक्सप्लोरेटरी डेटा एनालिसिस (EDA) करने के लिए डेटा को कैसे स्टोर और मैनीपुलेट किया जाए।
शायद आप यह सीख लें कि खुद को उम्मीदवार के रूप में कैसे बेहतर ढंग से पेश करें—या कुछ नया R कोड!
पिछले हफ्ते, DataCamp के ब्लॉग "क्या डेटा आपकी H-1B वीज़ा एप्लिकेशन में मदद कर सकता है" ने आपको वर्षों के H-1B डेटा के विश्लेषण के कुछ नतीजे दिखाए थे। अब, बारी आपकी है कि आप खुद डेटा का विश्लेषण करें और देखें कि और क्या खोज सकते हैं! टेड क्वार्टलर आपको R ट्यूटोरियल्स की एक सीरीज़ के साथ इस प्रक्रिया में मार्गदर्शन करेंगे।
मेरे एक दोस्त टेक्सास की एक लॉ फर्म में हैं जो H1B वीज़ा फाइल करती है। H1B संयुक्त राज्य अमेरिका का एक नॉन-इमिग्रेंट वीज़ा है जो यू.एस. नियोक्ताओं को विशेष व्यवसायों में विदेशी कर्मचारियों को अस्थायी रूप से नियुक्त करने की अनुमति देता है। जाहिर है, चुना जाना बेहद मुश्किल है क्योंकि सीमित वीज़ा आपूर्ति के मुकाबले आवेदकों की संख्या बहुत अधिक होती है। भले ही यह अनुभवजन्य हो, मैंने खुद डेटा की पड़ताल करने का फैसला किया ताकि योग्य उम्मीदवारों को यह पता चल सके कि अमेरिका स्वागत करने वाला स्थान है!
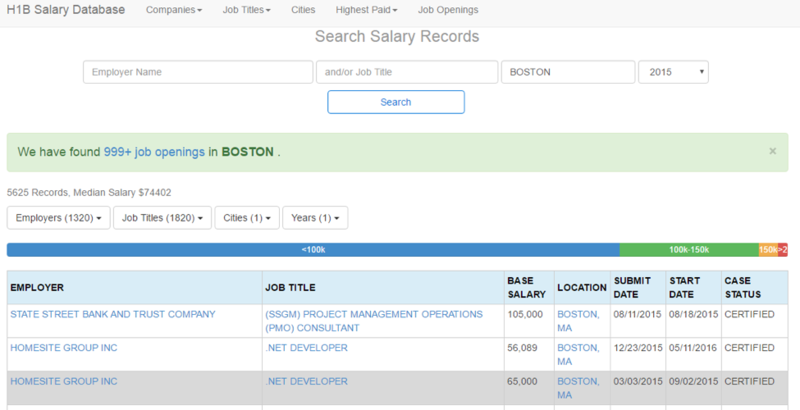
मेरे DataCamp सहयोगी ने मुझे यह साइट बताई, जो 2012 से 2016 तक का H1B डेटा रखने वाली एक सरल वेबसाइट है। साइट का दावा है कि उसके पास 20 लाख H1B एप्लिकेशन हैं जो एक ही टेबल में संगठित हैं।मैंने तय किया कि मैं यह डेटा प्रोग्रामेटिकली एकत्र करूँगा (यानी वेब स्क्रैप करूँगा) क्योंकि मैं अपनी पूरी ज़िंदगी कॉपी/पेस्ट नहीं कर सकता!जैसा कि आप देख सकते हैं, नीचे दी गई तस्वीर साइट का एक हिस्सा दिखाती है जिसमें बॉस्टन का H1B डेटा है:
इस ट्यूटोरियल में जिन लाइब्रेरीज का उपयोग होगा, उनमें JSON ऑब्जेक्ट्स को पार्स करने के लिए jsonlite, HTML को “हार्वेस्ट” करने वाला rvest, pbapply जो मेरा निजी पसंदीदा है क्योंकि यह बेस apply फंक्शंस में प्रोग्रेस बार जोड़ता है, और data.table शामिल हैं, जो बड़े डेटा फ्रेम्स पर R के प्रदर्शन में सुधार करता है।
library(jsonlite)
library(rvest)
library(pbapply)
library(data.table)जैसे-जैसे आप साइट को देखते हैं, आपको महसूस होगा कि सर्च फॉर्म प्रीफिल विकल्प सुझाता है। उदाहरण के लिए, सिटी फ़ील्ड में “B” टाइप करने पर नीचे दिखाए गए सुझावों वाला एक मॉडल खुल जाएगा। नीचे दी गई तस्वीर दिखाती है कि जब मैं “B” टाइप करता हूँ तो प्रीफिल विकल्प कैसे आते हैं:
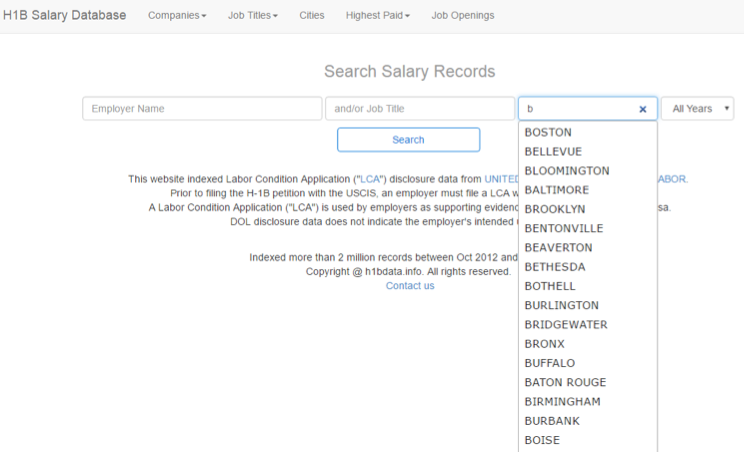
इसका मतलब है कि आप साइट को क्वेरी करने के लिए प्रीफिल को एक कारगर तरीके के रूप में उपयोग कर सकते हैं। क्रोम में, आप पेज को रीलोड कर सकते हैं, फिर राइट-क्लिक करके “Inspect” चुनें, डेवलपर पैनल में “Network” पर जाएँ और अंततः पेज पर “B” टाइप करें ताकि मॉडल लोड हो जाए। नेटवर्क पैनल में लिंक देखते हुए, आपको एक PHP क्वेरी मिलेगी जो शहरों का JSON ऑब्जेक्ट लौटाती है, जैसे यह। लक्ष्य पहले सभी सुझाए गए शहरों को इकट्ठा करना है और फिर उस सूची का उपयोग करके H1B डेटा वाले बहुत से पेज स्क्रैप करना है। जब आप पिछले URL को देखते हैं, तो ध्यान देंगे कि यह एक अक्षर पर खत्म होता है। इसलिए, आप paste0() को URL बेस http://h1bdata.info/cities.php?term= और letters के साथ इस्तेमाल कर सकते हैं। बेस को letters में हर मान के लिए री-सायकल किया जाता है। letters ऑब्जेक्ट R में “a” से “z” तक का बिल्ट-इन वेक्टर है। json.cities ऑब्जेक्ट a से z तक के URL का एक वेक्टर है, जिसमें सभी प्रीफिल सुझाव JSON के रूप में शामिल हैं।
json.cities<-paste0('http://h1bdata.info/cities.php?term=', letters)json.cities ऑब्जेक्ट 26 लिंक्स का एक वेक्टर है जिसे R द्वारा पढ़ा जाना है। lapply() या pblapply() के साथ fromJSON का उपयोग करते हुए, R प्रत्येक JSON ऑब्जेक्ट को पार्स करेगा ताकि all.cities बने। आप परिणाम को unlist में नेस्ट करते हैं ताकि आउटपुट एक साधारण स्ट्रिंग वेक्टर हो। इस कोड के साथ, आपके पास सभी प्रीफिल शहर एक वेक्टर में संगठित हैं, जिसका उपयोग आप वास्तविक डेटा वाले वेबपेज बनाने के लिए कर सकते हैं।all.cities<-unlist(pblapply(json.cities,fromJSON))expand.grid()। नीचे दिए गए कोड में, आप देखते हैं कि सिटी की जानकारी all.cities से पास की गई है, और फिर वर्ष seq() का उपयोग करते हुए 2012 से 2016 तक। यह फ़ंक्शन 5000+ सिटी-वर्ष कॉम्बिनेशंस बनाता है। expand.grid() प्रोग्रामेटिकली बॉस्टन 2012, बॉस्टन 2013, बॉस्टन 2014, आदि बनाता है क्योंकि प्रत्येक शहर और प्रत्येक वर्ष एक अनोखा फ़ैक्टर कॉम्बिनेशन दर्शाते हैं।
city.year<-expand.grid(city=all.cities,yr=seq(2012,2016))url_encode() फ़ंक्शन “Los Angeles” को Los%20Angeles में बदल देता है ताकि पता वैलिड हो जाए। आप पूरे वेक्टर को पास करते हैं और url_encode() रो-वाइज़ काम करेगा:
city.year$city<-urltools::url_encode(as.character(city.year$city))paste0() फ़ंक्शन का फिर इस्तेमाल करते हैं ताकि बेस URL को city.year में सिटी और स्टेट कॉम्बिनेशंस से जोड़ा जा सके। एक उदाहरण लिंक यहाँ देखें।
all.urls<-paste0('http://h1bdata.info/index.php?em=&job=&city=', city.year[,1],'&year=', city.year[,2])एक बार जब आप पिछले चरणों से गुजर लेते हैं, तो आप प्रत्येक पेज से डेटा इकट्ठा करने के लिए main नाम का एक कस्टम फ़ंक्शन बना सकते हैं। यह rvest के फ़ंक्शंस का उपयोग करने वाला एक सरल वर्कफ़्लो है। सबसे पहले, एक URL स्वीकार किया जाता है और read_html() पेज कंटेंट को पार्स करता है। अगला, पेज की एकल html_table को अन्य HTML जानकारी से चुना जाता है। main फ़ंक्शन x ऑब्जेक्ट को data.table में बदल देता है ताकि वह मेमोरी में कुशलतापूर्वक स्टोर हो सके। अंत में, main बंद करने से पहले आप Sys.sleep जोड़ सकते हैं ताकि आपको DDOS अटैक न समझा जाए।
main<-function(url.x){
  x<-read_html(url.x)
  x<-html_table(x)
  x<-data.table(x[[1]])
  return(x)
  Sys.sleep(5)
}
चलिए वह डेटा ले आते हैं! मुझे pblapply() का प्रोग्रेस बार पसंद है ताकि मैं स्क्रैपिंग प्रोग्रेस पर नज़र रख सकूँ।
आप बस all.urls और main फ़ंक्शन को pblapply() में पास कर दें। तुरंत ही, R पेज लोड करने, टेबल इकट्ठा करने और उस पेज के लिए मेमोरी में एक data.table रखने का काम शुरू कर देता है। हर URL बारी-बारी से कलेक्ट किया जाता है और मेमोरी में रखा जाता है।
all.h1b<-pblapply(all.urls, main)उफ़! इसमें घंटे लग गए! इस बिंदु पर all.h1b डेटा टेबल्स की एक सूची है, प्रति पेज एक। सूची को एकल डेटा टेबल में एकीकृत करने के लिए, आप rbindlist का उपयोग कर सकते हैं। यह do.call(rbind, all.h1b) जैसा है, लेकिन बहुत तेज़ है।
all.h1b<-rbindlist(all.h1b)
आखिर में डेटा सेव कर लें ताकि आपको यह दोबारा न करना पड़े। सौभाग्य से, मैंने यहाँ एक कॉपी सेव कर रखी है।
write.csv(all.h1b,'h1b_data.csv', row.names=F)
भले ही आपने डेटा स्क्रैप कर लिया है, उसे प्रबंधनीय फ़ॉर्मेट में लाने के लिए कुछ अतिरिक्त कदमों की ज़रूरत होती है।
आप तारीखों को व्यवस्थित करने में मदद के लिए lubridate का उपयोग करते हैं। आप stringr का भी उपयोग करते हैं, जो स्ट्रिंग मैनीपुलेशन के लिए रैपर्स प्रदान करता है।
library(lubridate)
library(stringr)
हालाँकि यह व्यक्तिगत पसंद है, मुझे scipen=999 इस्तेमाल करना अच्छा लगता है। यह अनिवार्य नहीं है, लेकिन यह वैज्ञानिक संकेतन को हटा देता है।
options(scipen=999)पता चला कि वेब स्क्रैप ने 20 लाख में से 18 लाख H1B रिकॉर्ड्स कैप्चर किए। मेरी राय में, 18 लाख पर्याप्त हैं। तो चलिए fread() का उपयोग करके डेटा लोड करते हैं: यह फ़ंक्शन read.csv जैसा है, लेकिन और अधिक कुशल “fast & friendly file finagler” है।
h1b.data<-fread('h1b_data.csv')स्क्रैप किए गए डेटा के कॉलम नाम अपर केस में हैं और उनमें स्पेस हैं।
इसलिए, उन्हें नाम से संदर्भित करना झंझट है, तो सबसे पहले आप उन्हें रीनेम करना चाहेंगे।
कॉलम नामों का रीनेम करना असाइनमेंट ऑपरेटर (<-) के दोनों ओर फ़ंक्शंस की मांग करता है। बाईं ओर colnames() का उपयोग करें और डेटा फ्रेम पास करें। ऑपरेटर के दाईं ओर, आप स्ट्रिंग्स के वेक्टर को पास कर सकते हैं।
इस उदाहरण में, आप पहले मूल नाम लेते हैं और tolower() का उपयोग करके उन्हें लोअरकेस बनाते हैं। दूसरी लाइन में आप gsub() लगाते हैं, जो एक ग्लोबल सब्स्टीट्यूशन फ़ंक्शन है।
जब gsub() कोई पैटर्न पहचानता है, यहाँ स्पेस, तो वह उसकी सभी मौजूदगी को दूसरे पैरामीटर, यानी अंडरस्कोर, से बदल देता है। आख़िर में, आपको gsub() को यह बताना होता है कि सब्स्टीट्यूशन्स names(h1b.data) में करें, जो अब लोअरकेस डेटा फ्रेम कॉलम्स को दर्शाता है।
colnames(h1b.data)<-tolower(names(h1b.data))
colnames(h1b.data)<-gsub(' ', '_', names(h1b.data))
डेटा की पड़ताल करते समय मैं जिन पहले फ़ंक्शंस का उपयोग करता हूँ, उनमें से एक है tail()। यह फ़ंक्शन नीचे की पंक्तियाँ लौटाता है। यहाँ, tail() आख़िरी 8 पंक्तियाँ लौटाएगा।
यह आपको जल्दी से डेटा के आकार और वेक्टर कैसे दिखते हैं, यह देखने में मदद करता है।
tail(h1b.data, 8)इसके बाद, मैं हमेशा वेक्टर की क्लास चेक करता हूँ। वेब-स्क्रैप किए गए डेटा में, संख्यात्मक मान या फैक्टर्स टेक्स्ट बन सकते हैं। आप देखेंगे कि अभी क्लासेस को ठीक करना बाद में झुंझलाहट से बचा लेगा!
apply() फ़ंक्शन का उपयोग करते हुए, आप h1b.data, फिर 2 और फ़ंक्शन class पास कर सकते हैं। चूँकि आपने 2 चुना है, R हर कॉलम की क्लास चेक करेगा और उसे कंसोल में लौटाएगा। आप apply() को 1 के साथ रो-वाइज़ भी अप्लाई कर सकते हैं, लेकिन यहाँ वह मददगार नहीं होगा।
apply(h1b.data,2,class)ओह हो!
सारे कॉलम “characters” हैं और उन्हें ठीक करना होगा। मैं आपको दिखाऊँगा कि डेट कॉलम्स में से एक को कैसे बदला जाए और बाकी आपके लिए छोड़ता हूँ। tail() का उपयोग करके, आप गलत वर्गीकृत डेट्स की आख़िरी 6 पंक्तियों की जाँच कर सकते हैं।
डेट्स को ठीक करने के लिए, / स्लैशेज को - डैशेज से बदला जाना चाहिए। एक बार फिर, gsub() का उपयोग करें ताकि / को ढूँढकर - से बदला जा सके।
tail(h1b.data$submit_date)
h1b.data$submit_date<-gsub('/', '-', h1b.data$submit_date)
डैश लग जाने के बाद आप mdy() अप्लाई करते हैं, जो "month, day, year" के लिए है। यह इसलिए क्योंकि डेट्स उसी क्रम में लिखी गई हैं। अगर क्रम अलग होता, तो आप mdy अक्षरों को उसी अनुसार बदलते।
यह सुनिश्चित करने के लिए कि कॉलम सही तरह बदला गया है, आप tail फिर देखते हैं और क्लास चेक करते हैं। tail() को “2016-03-11 UTC” जैसी डेट्स प्रिंट करनी चाहिए और वेक्टर क्लास “character” की जगह “POSIXct” होनी चाहिए।
h1b.data$submit_date<-mdy(h1b.data$submit_date)
tail(h1b.data$submit_date)
class(h1b.data$submit_date)
इस प्रकार के विश्लेषण के लिए, यह एक अच्छा विचार है कि डेट्स से सिर्फ़ महीना और वर्ष निकालकर नए कॉलम्स में डाल दें। नीचे दिए गए कोड में आप देखते हैं कि दो नए कॉलम $submit_month और $submit_yr घोषित किए गए हैं।
lubridate में month() फ़ंक्शन को पूरे कॉलम पर अप्लाई करके डेट से महीने के मान निकाले जा सकते हैं। year() फ़ंक्शन भी इसी तरह डेट कॉलम स्वीकार करता है ताकि h1b.data$submit_yr बनाया जा सके। जब आप head() फ़ंक्शन का उपयोग करेंगे, तो अब आपको दो नए कॉलम दिखने चाहिए।
h1b.data$submit_month<-month(h1b.data$submit_date, label=T)
h1b.data$submit_yr<-year(h1b.data$submit_date)
head(h1b.data)
अब, $base_salary कॉलम की जाँच करते हैं। इसमें हजारों के स्थान पर कॉमा है और R इसे character मानता है, इसलिए इसे बदला जाना चाहिए। एक बार फिर gsub() कॉमा हटाने और उसे खाली कैरेक्टर से बदलने में काम आता है। फिर as.numeric() को h1b.data$base_salary पर अप्लाई किया जाता है ताकि मानों को आधिकारिक तौर पर नंबर में बदला जा सके।
आप तीसरी लाइन में head() के साथ नए वेक्टर के एक हिस्से की जाँच कर सकते हैं।
h1b.data$base_salary<-gsub(',','',h1b.data$base_salary)
h1b.data$base_salary<-as.numeric(h1b.data$base_salary)
head(h1b.data$base_salary)
इस डेटा को काटने का एक और तरीक़ा है स्टेट के अनुसार। जब आप h1b.data$location कॉलम देखते हैं, तो पता चलता है कि सिटी और स्टेट को कॉमा से अलग किया गया है। नीचे दिया गया कोड पहले कॉमा पर लोकेशन जानकारी को अलग करने के लिए str_split_fixed() का उपयोग करता है। बस कॉलम, सेपरेटिंग कैरेक्टर और लौटाए जाने वाले कॉलम्स की संख्या पास करें। प्राप्त state ऑब्जेक्ट एक बड़ा मैट्रिक्स है जिसमें h1b.data जितनी पंक्तियाँ और 2 कॉलम हैं।
state<-str_split_fixed(h1b.data$location,', ', 2)अगली दो लाइनों में व्यक्तिगत स्टेट वेक्टर को $city और $state के रूप में h1b.data में कॉलम-बाइंड किया जाता है। वेक्टर परफ़ेक्ट नहीं हैं क्योंकि स्पेलिंग अलग-अलग हो सकती है, जैसे “Winston Salem” बनाम “Winston-Salem”। कुल मिलाकर, यह तरीका साधारण EDA के लिए पर्याप्त है, लेकिन ध्यान रखें कि अन्य विश्लेषणों में कुछ टर्म एग्रीगेशन की ज़रूरत पड़ सकती है।
h1b.data$city<-state[,1]
h1b.data$state<-state[,2] यदि आप H1B वीज़ा के लिए आवेदन कर रहे हों, तो आप जानना चाहेंगे कि किन राज्यों में सबसे अधिक अवसर हैं ताकि स्वीकृति की संभावना बढ़े। table() फ़ंक्शन का उपयोग श्रेणीबद्ध वेरिएबल्स की गिनती के लिए किया जाता है और इसे आसानी से h1b.data$state पर अप्लाई किया जा सकता है। दूसरी लाइन में, आप स्टेट के नाम और गिने गए H1B डेटा को कैप्चर करने के लिए एक छोटा डेटा फ्रेम बना सकते हैं।
state.tally<-table(h1b.data$state)
state.tally<-data.frame(state=names(state.tally), h1b=as.vector(state.tally))
state.tally और barplot() का उपयोग करके आप स्टेट के हिसाब से H1B मानों का एक बेसिक बार प्लॉट बना लेंगे। दूसरा पैरामीटर names.arg बार के लेबल घोषित करता है और las=3 R को लेबल्स को वर्टिकल रखने को कहता है। आप कॉमा स्प्लिट से आए कुछ अस्त-व्यस्त लोकेशन्स देख सकते हैं, लेकिन बात साफ़ है… एक H1B आवेदक संभवतः CA, NJ, NY या TX में होगा।
barplot(state.tally$h1b,
        names.arg = names(table(h1b.data$state)),
        las=3)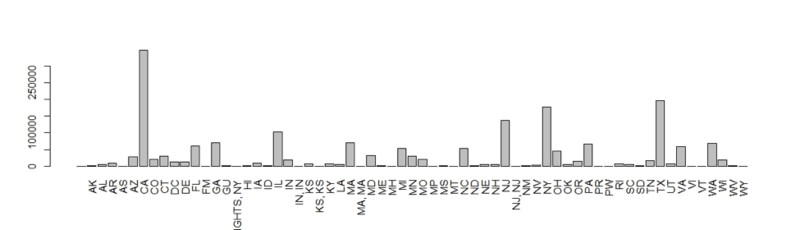
आप 2012 से 2016 तक की स्टेट-वाइज़ H1B वीज़ा टैली देखते हैं।
अब, H1B वीज़ाओं और किसी बाहरी तथ्य के बीच सहसंबंध समझने की कोशिश करते हैं। सरलता के लिए, R में एक बिल्ट-इन डेटासेट state.x77 है। यह 50 पंक्तियों, यानी प्रति स्टेट 1, और 1977 की यूएस जनगणना के तथ्य जैसे जनसंख्या और जीवन प्रत्याशा वाला एक मैट्रिक्स है।
टिप: अपनी खुद की विश्लेषण में अधिक हालिया डेटा स्रोत का उपयोग करें।
फिलहाल, state.x77 का उपयोग सीखने का अच्छा उदाहरण है। इस बिल्ट-इन डेटा सेट को head() से जाँचें।
head(state.x77)आइए इस जानकारी को state.tally डेटा के साथ एक बड़े डेटा फ्रेम में मर्ज करके रिश्तों को समझें। ऐसा करने के लिए, state.abb यानी स्टेट संक्षेप और पुराने 1977 जनगणना डेटा सहित एक state.data डेटा फ्रेम बनाएँ। फिर merge कॉल करें और state.tally तथा state.data पास करें।
आप स्पष्ट रूप से state कॉलम को जॉइन के लिए वेक्टर के रूप में घोषित कर सकते हैं। तीसरी लाइन में 15वीं से 20वीं पंक्तियों को इंडेक्स करके डेटा फ्रेम का एक हिस्सा जाँचें।
state.data<-data.frame(state=state.abb,state.x77)
state.data<-merge(state.tally,
                  state.data,
                  by='state')
state.data[15:20,]
एक बुनियादी EDA फ़ंक्शन है cor: यह दो वेरिएबल्स के बीच सहसंबंध प्रिंट करेगा।
याद रखें कि सहसंबंध -1 से 1 तक होता है: 0 का मतलब है कि वेरिएबल्स में कोई सहसंबंध नहीं है और वे शायद असंबंधित हैं। 1 के करीब संख्या का मतलब है कि मान सकारात्मक रूप से सहसंबद्ध हैं (उम्मीद है) जैसे R प्रोग्रामिंग और आय। नकारात्मक संख्या का मतलब है कि रिश्ता उल्टी दिशा में चलता है, जैसे R प्रोग्रामिंग और सोशल लाइफ!
यह कोड 1977 की स्टेट जनसंख्या और मौजूदा H1B टैलीज़ पर cor अप्लाई करता है। याद रखें, समय के बेमेल के बावजूद यह कोड विश्लेषण करना सिखाने के लिए है। आप डेटा फ्रेम में किसी और वेक्टर को संदर्भित करने के लिए $Population बदल सकते हैं।
cor(state.data$Population, state.data$h1b)वेरिएबल संबंधों की जाँच का एक और तरीका है स्कैटरप्लॉट, खासकर स्कैटरप्लॉट मैट्रिक्स। pairs() का उपयोग करके आप जल्दी से एक स्कैटरप्लॉट मैट्रिक्स प्लॉट कर सकते हैं। नीचे दिए गए कोड में संबंधों को परिभाषित करने के लिए एक फ़ॉर्मूला उपयोग किया गया है। हर कॉलम को अलग-अलग प्लस साइन से जोड़ा गया है। data पैरामीटर डेटा फ्रेम स्वीकार करता है और main बस प्लॉट का शीर्षक बताता है।
pairs(~ h1b + Population + Income,
      data = state.data,
      main='h1b relationships')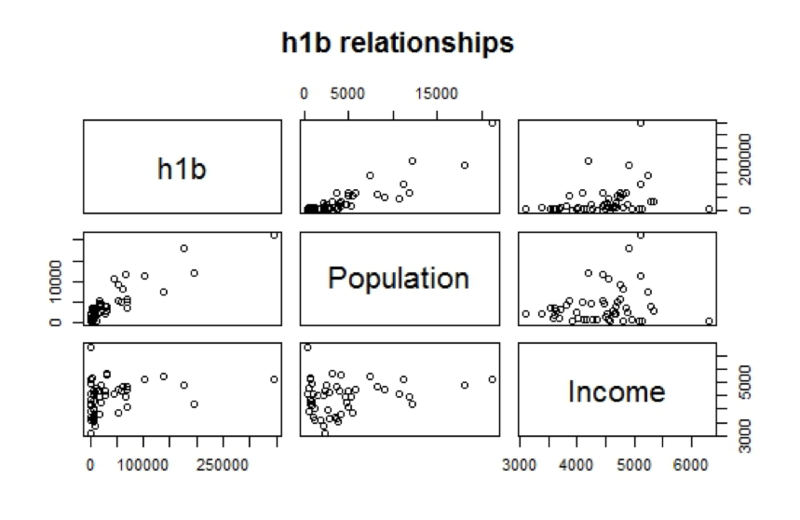
आप देखते हैं कि यह स्कैटरप्लॉट मैट्रिक्स H1B टैलीज़ को स्टेट Population और Income से जोड़कर दिखाता है।
आप Population और h1b के बीच एक संबंध देख सकते हैं। यह सहज रूप से समझ आता है क्योंकि अधिक आबादी वाले राज्यों में H1B वीज़ा की ज़रूरत वाली नौकरी के अवसर अधिक होंगे।
मैट्रिक्स में से किसी एक प्लॉट पर “ज़ूम” करने के लिए बस plot() कॉल करें और दो वेरिएबल्स पास करें।
plot(state.data$Income,state.data$h1b,
main = 'Income to H1B')आपने अभी हमारे H1B वीज़ा एक्सप्लोरेशन की शुरुआत भर की है! यह डेटा सेट काफी समृद्ध है और अगली पोस्ट में आप सैलरी डेटा की पड़ताल करेंगे, आउट्लायर्स हटाएँगे और और भी प्रभावशाली ggplot2 विज़ुअल्स बनाएँगे।
आप समय के साथ H1B स्टेटस और शीर्ष नियोक्ताओं का पता लगाकर इन EDA अवधारणाओं पर भी आगे बढ़ेंगे। एक बढ़िया विज़ुअल जो मैं आपको अभी दिखा देता हूँ, उसे बॉक्स प्लॉट कहते हैं, जो इस कोड का उपयोग करके H1B वीज़ा स्टेटस के अनुसार सैलरी डिस्ट्रीब्यूशंस दिखाता है:
ggplot(h1b.data) +
geom_boxplot(aes(factor(case_status),base_salary,fill=as.factor(case_status))) +
  ylim(0,100000) +
  theme_gdocs() +
  scale_fill_gdocs() +
  theme(axis.text.x=element_blank())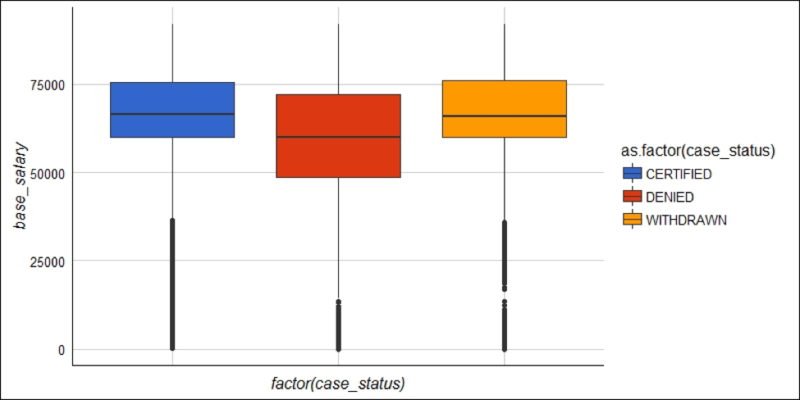
"Exploring H-1B Data with R" ट्यूटोरियल सीरीज़ के एक और भाग के लिए जुड़े रहें! इस बीच, हमारा R डेटा फ्रेम ट्यूटोरियल, हमारा Importing Data in R कोर्स या हमारा Data Manipulation in R with dplyr कोर्स देखने पर विचार करें।
R कोर्सेज़
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें