Curso
Web Scraping con R
4 h
15.2K
El objetivo de este tutorial es mostrarte cómo reunir datos sobre los visados H‑1B mediante web scraping con R. Después, también aprenderás a parsear objetos JSON y a almacenar y manipular los datos para poder hacer un análisis exploratorio de datos (EDA) básico sobre el gran conjunto de solicitudes H‑1B.
Quizá descubras cómo posicionarte mejor como candidato o, al menos, algún truco nuevo de R.
La semana pasada, el blog de DataCamp "Can Data Help Your H-1B Visa Application" te presentó algunos resultados de un análisis de datos H‑1B a lo largo de los años. Ahora toca remangarse y analizar los datos por tu cuenta para ver qué más encuentras. Ted Kwartler te guiará con una serie de tutoriales de R.
Tengo un amigo en un bufete de Texas que tramita visados H‑1B. El H‑1B es un visado de no inmigrante en Estados Unidos que permite a empleadores contratar temporalmente a trabajadores extranjeros en ocupaciones especializadas. Por lo visto, que te lo concedan es complicadísimo porque hay muy pocos visados para miles de solicitantes. Aunque esto es anecdótico, decidí explorar los datos por mi cuenta con la esperanza de ayudar a candidatos cualificados a ver que EE. UU. es un lugar acogedor.
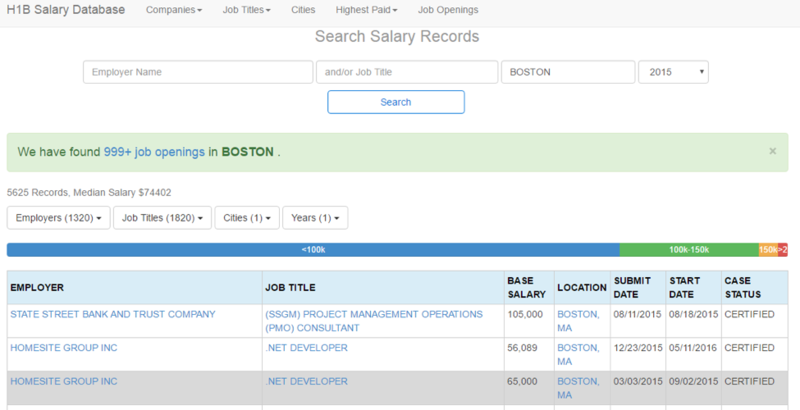
Un colega de DataCamp me señaló este sitio, una web sencilla con datos H‑1B de 2012 a 2016. La web afirma tener 2 millones de solicitudes H‑1B en una única tabla.Decidí recopilar estos datos de forma programática (léase: hacer web scraping) porque no pensaba copiar y pegar el resto de mi vida. Como ves, la imagen muestra una parte del sitio con datos H‑1B de Boston:
En este tutorial usaremos varias librerías: jsonlite para parsear objetos JSON, rvest para "cosechar" HTML, pbapply, que es de mis favoritas porque añade barras de progreso a las funciones apply base, y data.table, que mejora el rendimiento de R con data frames grandes.
library(jsonlite)
library(rvest)
library(pbapply)
library(data.table)Al explorar el sitio, verás que el formulario de búsqueda sugiere opciones de autocompletado. Por ejemplo, al escribir "B" en el campo de ciudad aparece un modal con sugerencias como las de abajo. Esta imagen muestra las opciones al teclear "B":
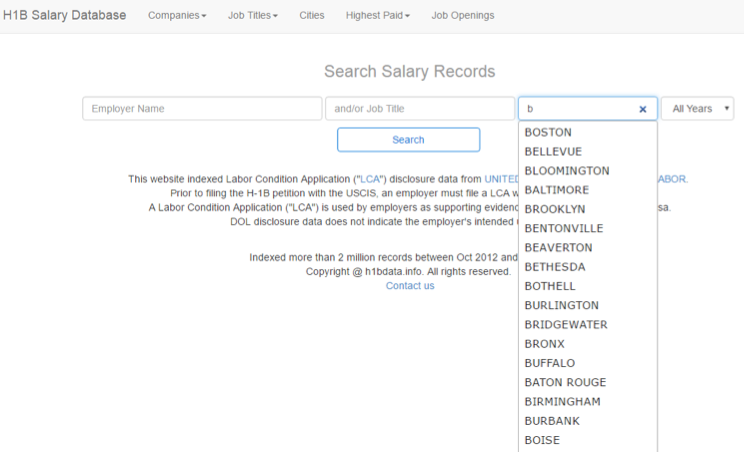
Eso significa que puedes aprovechar el autocompletado como una forma eficiente de consultar la web. En Chrome, recarga y haz clic derecho para "Inspeccionar" la página, ve a "Network" en el panel de desarrollador y escribe "B" en la página para cargar el modal. Si exploras los enlaces del panel de red, verás una consulta PHP que devuelve un objeto JSON de ciudades como este. El objetivo es primero reunir todas las ciudades sugeridas y luego usar esa lista para extraer muchas páginas con datos H‑1B. Si te fijas, la URL anterior acaba en una letra. Así que puedes usar paste0() con la base de la URL, http://h1bdata.info/cities.php?term=, y letters. La base se recicla para cada valor de letters. El objeto letters es un vector incorporado en R de "a" a "z". El objeto json.cities es un vector de URL, de la a a la z, que contiene todas las sugerencias de autocompletado en JSON.
json.cities<-paste0('http://h1bdata.info/cities.php?term=', letters)json.cities es un vector de 26 enlaces que R debe leer. Con lapply() o pblapply() junto con fromJSON, R parseará cada objeto JSON para crear all.cities. Anidas el resultado en unlist para que la salida sea un vector de cadenas sencillo. Con este código tendrás todas las ciudades de autocompletado en un vector que puedes usar para construir las páginas reales con datos.all.cities<-unlist(pblapply(json.cities,fromJSON))expand.grid(). En el código de abajo, ves que se pasa la información de ciudad, all.cities, y el año usando seq() de 2012 a 2016. La función crea más de 5000 combinaciones ciudad‑año. expand.grid() crea programáticamente Boston 2012, Boston 2013, Boston 2014, etc., porque cada ciudad y cada año forman una combinación única de factores.
city.year<-expand.grid(city=all.cities,yr=seq(2012,2016))url_encode() cambia "Los Angeles" a Los%20Angeles para validar la dirección. Pasas el vector completo y url_encode() funcionará fila a fila:
city.year$city<-urltools::url_encode(as.character(city.year$city))paste0() para concatenar la URL base con las combinaciones de ciudad y estado en city.year. Mira un ejemplo aquí.
all.urls<-paste0('http://h1bdata.info/index.php?em=&job=&city=', city.year[,1],'&year=', city.year[,2])Tras estos pasos, puedes crear una función personalizada llamada main para recopilar los datos de cada página. Es un flujo sencillo con funciones de rvest. Primero, se acepta una URL y read_html() parsea el contenido de la página. Después, se selecciona la única html_table de entre el resto del HTML. La función main convierte el objeto x en un data.table para almacenarlo eficientemente en memoria. Por último, antes de cerrar main, puedes añadir un Sys.sleep para que no te tomen por un ataque DDoS.
main<-function(url.x){
  x<-read_html(url.x)
  x<-html_table(x)
  x<-data.table(x[[1]])
  return(x)
  Sys.sleep(5)
}
¡A por los datos! Me gusta la barra de progreso de pblapply() para seguir el scraping.
Simplemente pasas all.urls y la función principal en pblapply(). Enseguida R empieza a cargar una página, recoger la tabla y mantener un data.table en memoria para esa página. Cada URL se procesa y se guarda en memoria.
all.h1b<-pblapply(all.urls, main)¡Uf! ¡Eso llevó horas! En este punto, all.h1b es una lista de data tables, uno por página. Para unificarlos en un único data table, puedes usar rbindlist. Es similar a do.call(rbind, all.h1b) pero mucho más rápido.
all.h1b<-rbindlist(all.h1b)
Por último, guarda los datos para no tener que repetirlo. Por suerte, yo guardé una copia aquí.
write.csv(all.h1b,'h1b_data.csv', row.names=F)
Aunque hayas hecho scraping, necesitas algunos pasos extra para dejarlos en un formato manejable.
Usa lubridate para ordenar fechas. También stringr, que ofrece utilidades para manipular cadenas.
library(lubridate)
library(stringr)
A modo de preferencia personal, me gusta usar scipen=999. No es obligatorio, pero elimina la notación científica.
options(scipen=999)Resulta que el scraping capturó 1,8 millones de los 2 millones de registros H‑1B. En mi opinión, 1,8 millones es suficiente. Así que vamos a cargar los datos con fread(): esta función es como read.csv pero es el "fast & friendly file finagler" más eficiente.
h1b.data<-fread('h1b_data.csv')Los nombres de columnas extraídos están en mayúsculas y con espacios.
Referenciarlas por nombre es un rollo, así que lo primero es renombrarlas.
Para cambiar nombres necesitas funciones a ambos lados del operador de asignación (<-). A la izquierda usa colnames() y pasa el data frame. A la derecha, pasa un vector de cadenas.
En este ejemplo, primero tomas los nombres originales y los pones en minúsculas con tolower(). En la segunda línea aplicas gsub(), una función de sustitución global.
Cuando gsub() reconoce un patrón, en este caso un espacio, reemplaza todas las apariciones por el segundo parámetro, el guion bajo. Por último, indicas a gsub() que haga las sustituciones en names(h1b.data), que representa las columnas ya en minúsculas.
colnames(h1b.data)<-tolower(names(h1b.data))
colnames(h1b.data)<-gsub(' ', '_', names(h1b.data))
Una de las primeras funciones que uso al explorar datos es tail(). Devuelve las últimas filas. Aquí, tail() devolverá las últimas 8.
Esto te ayuda a ver rápidamente la forma de los datos y cómo son los vectores.
tail(h1b.data, 8)Después, siempre compruebo la clase de los vectores. Con datos de scraping, valores numéricos o factores pueden llegar como texto. Verás que corregir clases ahora evita frustraciones después.
Con la función apply(), pasas h1b.data, luego 2 y la función class. Como has elegido 2, R comprobará la clase de cada columna y la devolverá por consola. Puedes usar apply() con 1 para aplicar por filas, pero aquí no ayuda.
apply(h1b.data,2,class)¡Ups!
Todas las columnas son "character" y hay que corregirlas. Te muestro cómo cambiar una de las columnas de fecha y te dejo las demás a ti. Con tail() puedes examinar las 6 últimas filas de las fechas mal clasificadas.
Para corregir fechas, las barras / deben cambiarse por guiones -. De nuevo, usa gsub() para buscar / y reemplazarlo por -.
tail(h1b.data$submit_date)
h1b.data$submit_date<-gsub('/', '-', h1b.data$submit_date)
Con los guiones en su sitio aplicas mdy(), que significa "month, day, year". Es el orden en que están las fechas. Si fuera distinto, reordenarías las letras de mdy en consecuencia.
Para asegurarte de que la columna cambió bien, vuelve a mirar el tail y comprueba la clase. tail() debería imprimir algo como "2016-03-11 UTC" y la clase del vector debería ser "POSIXct" en lugar de "character".
h1b.data$submit_date<-mdy(h1b.data$submit_date)
tail(h1b.data$submit_date)
class(h1b.data$submit_date)
Para este tipo de análisis, conviene extraer solo el mes y el año a columnas nuevas. En el código siguiente se crean dos columnas nuevas, $submit_month y $submit_yr.
Dentro de lubridate, la función month() se puede aplicar a toda una columna para extraer el mes de una fecha. La función year() hace lo mismo para crear h1b.data$submit_yr. Con head() deberías ver ya las dos columnas nuevas.
h1b.data$submit_month<-month(h1b.data$submit_date, label=T)
h1b.data$submit_yr<-year(h1b.data$submit_date)
head(h1b.data)
Ahora, examinemos la columna $base_salary. Tiene una coma en los millares y R la trata como texto, así que hay que cambiarla. De nuevo gsub() al rescate para quitar la coma y sustituirla por vacío. Luego aplica as.numeric() a h1b.data$base_salary para convertirla a números.
Puedes ver una parte del nuevo vector con head() en la tercera línea.
h1b.data$base_salary<-gsub(',','',h1b.data$base_salary)
h1b.data$base_salary<-as.numeric(h1b.data$base_salary)
head(h1b.data$base_salary)
Otra forma de segmentar estos datos es por estado. Si miras la columna h1b.data$location, verás que ciudad y estado están separados por coma. El código siguiente usa str_split_fixed() para separar la ubicación por la primera coma. Solo pasa la columna, el separador y el número de columnas a devolver. El objeto resultante state es una gran matriz con el mismo número de filas que h1b.data y 2 columnas.
state<-str_split_fixed(h1b.data$location,', ', 2)Las dos líneas siguientes hacen el bind de columnas para añadir los vectores individuales como $city y $state a h1b.data. Los vectores no son perfectos porque puede haber variantes como "Winston Salem" frente a "Winston-Salem". En general, este método es suficiente para un EDA sencillo, pero ten en cuenta que quizá necesites agrupar términos en otros análisis.
h1b.data$city<-state[,1]
h1b.data$state<-state[,2] Si fueses a solicitar un H‑1B, querrías saber en qué estados hay más solicitudes para aumentar tus posibilidades de aceptación. La función table() sirve para contar variables categóricas y se aplica fácilmente a h1b.data$state. En la segunda línea, creas un data frame pequeño para capturar los nombres de estado y los recuentos H‑1B.
state.tally<-table(h1b.data$state)
state.tally<-data.frame(state=names(state.tally), h1b=as.vector(state.tally))
Con state.tally y barplot() crearás un gráfico de barras básico de valores H‑1B por estado. El segundo parámetro, names.arg, define las etiquetas de barras y las=3 indica a R que las ponga en vertical. Verás algunas ubicaciones descuidadas por la separación con coma, pero el mensaje está claro… un solicitante H‑1B probablemente estará en CA, NJ, NY o TX.
barplot(state.tally$h1b,
        names.arg = names(table(h1b.data$state)),
        las=3)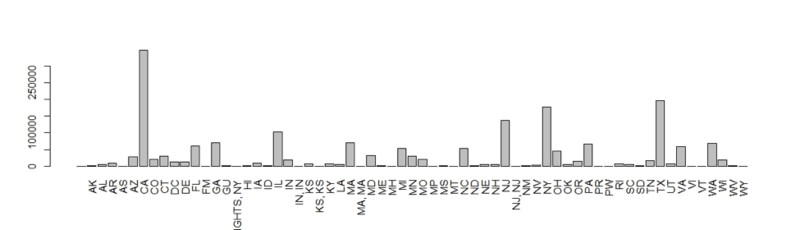
Aquí tienes el recuento estatal de visados H‑1B de 2012 a 2016.
Ahora, intentemos entender la correlación entre visados H‑1B y algún dato externo. Para simplificar, R tiene un conjunto incorporado llamado state.x77. Es una matriz con 50 filas, 1 por estado, con datos como población y esperanza de vida del Censo de EE. UU. de 1977.
Consejo: usa una fuente más reciente en tu propio análisis.
Por ahora, state.x77 es un buen ejemplo para aprender. Examina este dataset incorporado con head().
head(state.x77)Vamos a unir esta información con los datos de state.tally en un data frame mayor para entender relaciones. Para ello, crea un data frame state.data con abreviaturas de estado, state.abb, y los datos del Censo del 77. Luego llama a merge pasando state.tally y state.data.
Puedes declarar explícitamente la columna state como vector de unión. Examina una parte del data frame en la tercera línea indexando de la fila 15 a la 20.
state.data<-data.frame(state=state.abb,state.x77)
state.data<-merge(state.tally,
                  state.data,
                  by='state')
state.data[15:20,]
Una función básica de EDA es cor: imprime la correlación entre dos variables.
Recuerda que la correlación va de -1 a 1: 0 indica que no hay correlación y probablemente no están relacionadas. Un número cercano a 1 indica correlación positiva (ojalá como R y los ingresos). Un número negativo indica relación inversa, como R y tener vida social.
Este código aplica cor a la población de 1977 por estado y a los recuentos actuales H‑1B. Recuerda que el código ilustra el análisis pese al desajuste temporal. Puedes cambiar $Population para referenciar otro vector del data frame.
cor(state.data$Population, state.data$h1b)Otra forma de investigar relaciones es con un diagrama de dispersión, especialmente una matriz de dispersión. Usa pairs() para trazarla rápido. El código de abajo usa una fórmula para definir las relaciones. Cada columna se declara individualmente con un signo más entre medias. El parámetro data acepta el data frame y main define el título.
pairs(~ h1b + Population + Income,
      data = state.data,
      main='h1b relationships')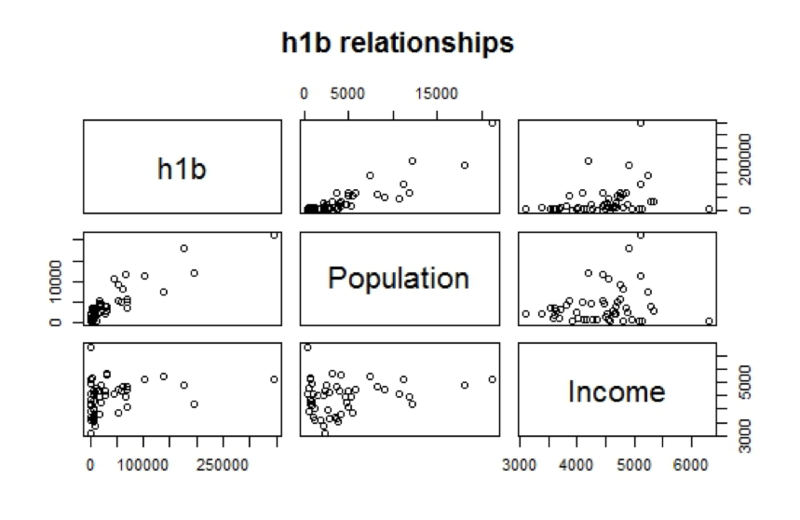
Ves que esta matriz visualiza los recuentos H‑1B frente a Population e Income por estado.
Se observa relación entre Population y h1b. Tiene sentido: en estados más poblados hay más oportunidades laborales que requieren visado H‑1B.
Para "hacer zoom" en un único gráfico de la matriz, simplemente llama a plot() y pasa las dos variables.
plot(state.data$Income,state.data$h1b,
main = 'Income to H1B')¡Acabas de empezar a explorar los visados H‑1B! Este conjunto es muy rico y en el siguiente post explorarás los salarios, eliminarás valores atípicos y crearás visualizaciones más potentes con ggplot2.
También ampliarás estos conceptos de EDA explorando la evolución del estado H‑1B en el tiempo y los principales empleadores. Una visual chula que ya te enseño es el box plot de las distribuciones salariales por estado del visado H‑1B con este código:
ggplot(h1b.data) +
geom_boxplot(aes(factor(case_status),base_salary,fill=as.factor(case_status))) +
  ylim(0,100000) +
  theme_gdocs() +
  scale_fill_gdocs() +
  theme(axis.text.x=element_blank())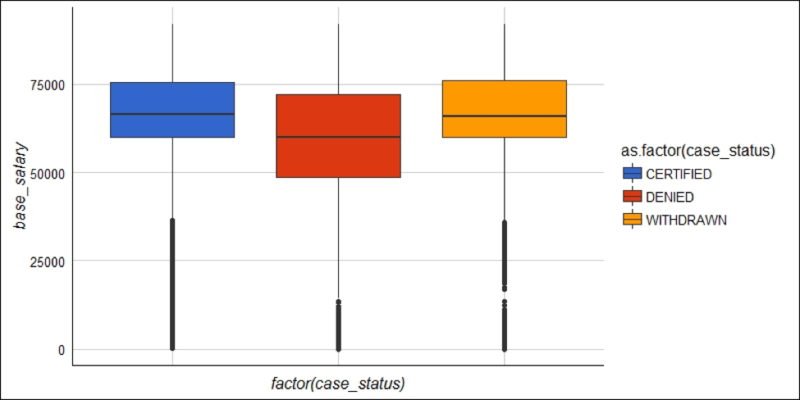
¡Permanece atento a la próxima entrega de la serie "Explorando datos H‑1B con R"! Mientras tanto, echa un vistazo a nuestro tutorial sobre data frames en R, al curso de Importing Data in R o al curso Data Manipulation in R with dplyr.
Cursos de R
Curso
Curso
Curso
blog
Elena Kosourova
14 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Zoumana Keita
15 min
Tutorial
Vidhi Chugh
5 min
Tutorial
Ryan Sheehy
3 min



