Cours
Web scraping en R
4 h
15.2K
L’objectif de ce tutoriel est de vous montrer comment collecter des données sur les visas H‑1B via du web scraping avec R. Ensuite, vous apprendrez à parser des objets JSON, puis à stocker et manipuler les données afin de mener une analyse exploratoire des données (EDA) de base sur le vaste jeu de données des dépôts H‑1B.
Vous y trouverez peut‑être de quoi mieux vous positionner comme candidat… ou quelques nouvelles lignes de code R !
La semaine dernière, l’article du blog de DataCamp « Can Data Help Your H-1B Visa Application » présentait quelques résultats d’une analyse des données H‑1B au fil des ans. À présent, à vous de jouer : analysez les données vous‑même et voyez ce que vous pouvez en tirer ! Ted Kwartler va vous guider à travers une série de tutoriels R.
Un ami travaillant dans un cabinet d’avocats au Texas dépose des visas H‑1B. Le H‑1B est un visa non‑immigrant aux États‑Unis qui autorise temporairement les employeurs américains à recruter des travailleurs étrangers pour des métiers spécialisés. L’acceptation est réputée très difficile : l’offre de visas est limitée face à des milliers de candidats. Partant de ce constat, j’ai décidé d’explorer les données moi‑même, dans l’espoir d’aider des candidats qualifiés à voir que les États‑Unis restent accueillants !
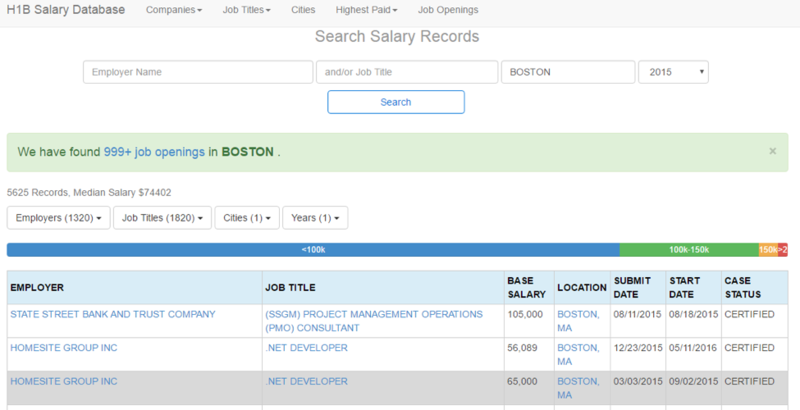
Un collègue chez DataCamp m’a orienté vers ce site, un site simple qui regroupe des données H‑1B de 2012 à 2016. Il affirme contenir 2 millions de demandes H‑1B organisées dans un tableau unique. J’ai choisi de récupérer ces données de façon programmatique (lire : web scraping) — impossible de faire du copier‑coller jusqu’à la fin de mes jours ! Comme vous le voyez, l’image ci‑dessous montre une partie du site avec les données H‑1B de Boston :
Dans ce tutoriel, nous utiliserons notamment les bibliothèques jsonlite pour parser les objets JSON, rvest qui « récolte » le HTML, pbapply, mon chouchou pour ajouter des barres de progression aux fonctions apply de base, et data.table qui accélère R sur les grands data frames.
library(jsonlite)
library(rvest)
library(pbapply)
library(data.table)En parcourant le site, vous remarquerez que le formulaire de recherche propose des suggestions de saisie. Par exemple, taper « B » dans le champ ville ouvre une fenêtre modale avec des propositions comme ci‑dessous. L’image suivante montre les options proposées quand je tape « B » :
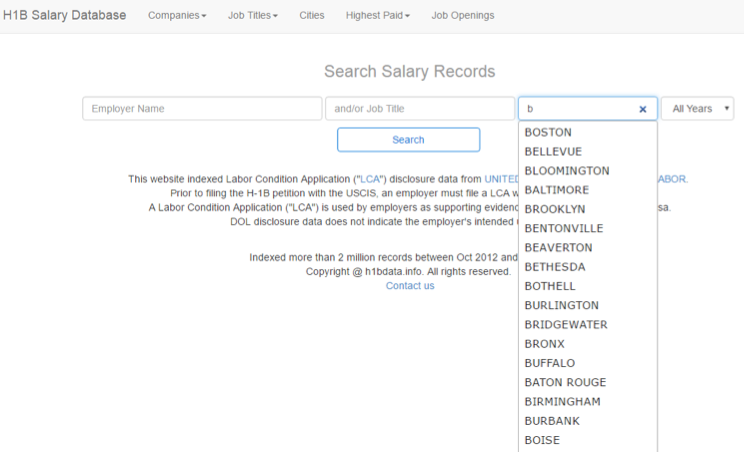
Vous pouvez donc exploiter ces suggestions comme un moyen efficace d’interroger le site. Sous Chrome, rechargez puis faites un clic droit sur « Inspecter » la page, allez dans « Network » (Réseau) du panneau développeur, puis tapez « B » sur la page pour charger la modale. En explorant les liens du panneau réseau, vous trouverez une requête PHP qui renvoie un objet JSON de villes comme ici. L’idée est d’abord de récupérer toutes les villes suggérées, puis d’utiliser cette liste pour scraper un grand nombre de pages contenant des données H‑1B. En regardant l’URL précédente, vous noterez qu’elle se termine par une lettre. Vous pouvez donc utiliser paste0() avec la base d’URL http://h1bdata.info/cities.php?term= et letters. La base est réutilisée pour chaque valeur de letters, un vecteur R intégré allant de « a » à « z ». L’objet json.cities est donc un vecteur d’URLs, de a à z, qui contiennent toutes les suggestions au format JSON.
json.cities<-paste0('http://h1bdata.info/cities.php?term=', letters)json.cities est un vecteur de 26 liens à lire dans R. Avec lapply() ou pblapply() associé à fromJSON, R va parser chaque objet JSON pour créer all.cities. Vous imbriquez le résultat dans unlist afin d’obtenir un simple vecteur de chaînes. Avec ce code, vous avez toutes les villes suggérées, prêtes à servir pour construire les vraies pages contenant les données.all.cities<-unlist(pblapply(json.cities,fromJSON))expand.grid(). Dans le code ci‑dessous, on passe les villes all.cities puis les années via seq() de 2012 à 2016. La fonction crée plus de 5 000 couples ville‑année. expand.grid() génère ainsi automatiquement Boston 2012, Boston 2013, Boston 2014, etc., chaque ville et chaque année formant une combinaison unique.
city.year<-expand.grid(city=all.cities,yr=seq(2012,2016))url_encode() transforme « Los Angeles » en Los%20Angeles pour obtenir une adresse valide. Vous passez tout le vecteur et url_encode() agit ligne par ligne :
city.year$city<-urltools::url_encode(as.character(city.year$city))paste0() pour concaténer l’URL de base avec les combinaisons ville et année de city.year. Voici un exemple de lien ici.
all.urls<-paste0('http://h1bdata.info/index.php?em=&job=&city=', city.year[,1],'&year=', city.year[,2])Une fois ces étapes réalisées, vous pouvez créer une fonction personnalisée nommée main pour collecter les données de chaque page. Le flux est simple avec les fonctions de rvest. D’abord, on passe une URL et read_html() parse le contenu de la page. Ensuite, on sélectionne l’unique html_table parmi le reste du HTML. La fonction main convertit l’objet x en data.table pour un stockage mémoire efficace. Enfin, avant de terminer main, vous pouvez ajouter un Sys.sleep afin de ne pas être pris pour une attaque DDoS.
main<-function(url.x){
  x<-read_html(url.x)
  x<-html_table(x)
  x<-data.table(x[[1]])
  return(x)
  Sys.sleep(5)
}
Allons chercher ces données ! Je préfère la progression avec pblapply() pour suivre l’avancement du scraping.
Il suffit de passer all.urls et la fonction main à pblapply(). Immédiatement, R charge une page, récupère le tableau et garde un data.table en mémoire pour cette page. Chaque URL est traitée à son tour et conservée en mémoire.
all.h1b<-pblapply(all.urls, main)Ouf ! Cela a pris des heures ! À ce stade, all.h1b est une liste de data tables, une par page. Pour unifier la liste en une seule data table, utilisez rbindlist. C’est similaire à do.call(rbind, all.h1b) mais bien plus rapide.
all.h1b<-rbindlist(all.h1b)
Enregistrez enfin les données pour éviter de tout recommencer. Bonne nouvelle : j’en ai sauvegardé une copie ici.
write.csv(all.h1b,'h1b_data.csv', row.names=F)
Même si vous avez scrapé les données, quelques étapes supplémentaires s’imposent pour les mettre dans un format exploitable.
Vous allez utiliser lubridate pour organiser les dates, ainsi que stringr pour des fonctions pratiques de manipulation de chaînes.
library(lubridate)
library(stringr)
C’est une préférence personnelle, mais j’aime définir scipen=999. Ce n’est pas obligatoire, mais cela évite la notation scientifique.
options(scipen=999)Le scraping a permis de capturer 1,8 million des 2 millions d’enregistrements H‑1B. À mon sens, 1,8 million, c’est suffisant. Chargeons donc les données avec fread() : similaire à read.csv, c’est le « fast & friendly file finagler » bien plus efficace.
h1b.data<-fread('h1b_data.csv')Les noms de colonnes scrapés sont en majuscules et contiennent des espaces.
Les référencer devient laborieux ; commencez donc par les renommer.
Renommer des colonnes exige des fonctions de part et d’autre de l’opérateur d’affectation (<-). À gauche, utilisez colnames() en lui passant le data frame. À droite, passez un vecteur de chaînes.
Dans cet exemple, vous mettez d’abord les noms en minuscules avec tolower(). Puis vous appliquez gsub(), une fonction de substitution globale.
Quand gsub() reconnaît un motif, ici l’espace, il le remplace partout par le second paramètre, l’underscore. Enfin, vous indiquez à gsub() d’opérer sur names(h1b.data), qui représente maintenant les noms en minuscules.
colnames(h1b.data)<-tolower(names(h1b.data))
colnames(h1b.data)<-gsub(' ', '_', names(h1b.data))
Une des premières fonctions utiles pour explorer est tail(). Elle renvoie les dernières lignes. Ici, tail() renverra les 8 dernières.
Cela permet de rapidement appréhender la structure et les vecteurs.
tail(h1b.data, 8)Ensuite, je vérifie toujours la classe des vecteurs. Avec des données scrapées, des numériques ou facteurs peuvent devenir du texte. Corriger les classes maintenant évite bien des frustrations plus tard !
Avec apply(), passez h1b.data, puis 2 et la fonction class. Avec 2, R vérifie la classe de chaque colonne et la renvoie dans la console. apply() avec 1 applique une fonction ligne par ligne, mais ce n’est pas utile ici.
apply(h1b.data,2,class)Oups !
Toutes les colonnes sont en « character » et doivent être corrigées. Je vais vous montrer comment changer l’une des colonnes de dates et vous laisser les autres. Avec tail(), examinez les 6 dernières lignes des dates mal classées.
Pour corriger les dates, les barres / doivent être remplacées par des tirets -. Là encore, utilisez gsub() pour chercher / et le remplacer par -.
tail(h1b.data$submit_date)
h1b.data$submit_date<-gsub('/', '-', h1b.data$submit_date)
Avec les tirets en place, appliquez mdy() (« month, day, year ») car les dates sont dans cet ordre. Si l’ordre différait, vous ajusteriez les lettres de mdy en conséquence.
Pour vérifier le changement, ré‑examinez la fin de colonne et sa classe. tail() doit afficher des dates du type « 2016-03-11 UTC » et la classe doit devenir « POSIXct » au lieu de « character ».
h1b.data$submit_date<-mdy(h1b.data$submit_date)
tail(h1b.data$submit_date)
class(h1b.data$submit_date)
Pour ce type d’analyse, extraire simplement le mois et l’année dans de nouvelles colonnes est utile. Ci‑dessous, deux nouvelles colonnes $submit_month et $submit_yr sont créées.
Avec lubridate, la fonction month() s’applique à une colonne entière pour en extraire les mois. La fonction year() crée de même h1b.data$submit_yr. En utilisant head(), vous devriez désormais voir deux nouvelles colonnes.
h1b.data$submit_month<-month(h1b.data$submit_date, label=T)
h1b.data$submit_yr<-year(h1b.data$submit_date)
head(h1b.data)
Regardons ensuite la colonne $base_salary. Elle contient des virgules pour les milliers et R la considère comme du texte ; il faut la convertir. gsub() enlève les virgules (remplacées par un vide). Puis as.numeric() convertit officiellement h1b.data$base_salary en numérique.
Vous pouvez visualiser un extrait du nouveau vecteur avec head() à la troisième ligne.
h1b.data$base_salary<-gsub(',','',h1b.data$base_salary)
h1b.data$base_salary<-as.numeric(h1b.data$base_salary)
head(h1b.data$base_salary)
Autre découpage possible : par État. En examinant h1b.data$location, vous voyez que la ville et l’État sont séparés par une virgule. Le code suivant utilise str_split_fixed() pour scinder l’information au premier séparateur. Il suffit de passer la colonne, le séparateur et le nombre de colonnes à retourner. L’objet state obtenu est une grande matrice avec autant de lignes que h1b.data et 2 colonnes.
state<-str_split_fixed(h1b.data$location,', ', 2)Les deux lignes suivantes ajoutent ces vecteurs séparés comme $city et $state à h1b.data. Les vecteurs ne sont pas parfaits : les orthographes peuvent varier (« Winston Salem » vs « Winston‑Salem »). Globalement, cette méthode suffit pour une EDA simple, mais gardez en tête qu’un regroupement de termes pourra s’imposer.
h1b.data$city<-state[,1]
h1b.data$state<-state[,2] Si vous postuliez à un visa H‑1B, vous voudriez savoir dans quels États vos chances d’acceptation sont les plus élevées. La fonction table() permet de compter les modalités d’une variable catégorielle et s’applique facilement à h1b.data$state. À la deuxième ligne, vous créez un petit data frame qui capture les noms d’État et les comptes H‑1B.
state.tally<-table(h1b.data$state)
state.tally<-data.frame(state=names(state.tally), h1b=as.vector(state.tally))
Avec state.tally et barplot(), vous obtenez un histogramme simple des H‑1B par État. Le second paramètre names.arg définit les étiquettes des barres et las=3 les place verticalement. On aperçoit quelques incohérences dues à la séparation par virgule, mais le message est clair : un candidat H‑1B a de fortes chances d’être en CA, NJ, NY ou TX.
barplot(state.tally$h1b,
        names.arg = names(table(h1b.data$state)),
        las=3)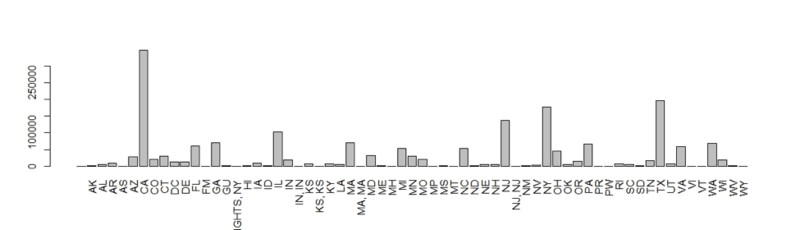
Vous voyez le décompte des visas H‑1B par État de 2012 à 2016.
Essayons maintenant de comprendre la corrélation entre les visas H‑1B et un indicateur externe. Pour simplifier, R inclut un jeu de données intégré, state.x77 : une matrice de 50 lignes (une par État) avec des faits comme la population et l’espérance de vie lors du recensement américain de 1977.
Conseil : pour votre propre analyse, utilisez une source plus récente.
Pour l’instant, state.x77 fait un bon exemple pédagogique. Inspectez ce jeu de données avec head().
head(state.x77)Fusionnons ces informations avec les données state.tally dans un data frame plus large pour analyser les relations. Créez un data frame state.data contenant les abréviations d’État, state.abb, et les données du recensement 1977. Puis utilisez merge avec state.tally et state.data.
Vous pouvez indiquer explicitement la colonne state comme vecteur de jointure. Examinez un extrait aux lignes 15 à 20.
state.data<-data.frame(state=state.abb,state.x77)
state.data<-merge(state.tally,
                  state.data,
                  by='state')
state.data[15:20,]
Une fonction EDA de base est cor : elle renvoie la corrélation entre deux variables.
Rappel : la corrélation varie de -1 à 1. 0 signifie aucune corrélation apparente. Un nombre proche de 1 indique une corrélation positive (espérons‑le comme R et les revenus). Un nombre négatif signifie une relation inverse (comme R et… la vie sociale !).
Ce code applique cor à la population des États (1977) et aux décomptes H‑1B actuels. Le but est d’illustrer la méthode malgré l’écart temporel. Vous pouvez remplacer $Population par une autre variable du data frame.
cor(state.data$Population, state.data$h1b)Autre façon d’examiner les relations : un nuage de points, ou mieux, une matrice de nuages. Utilisez pairs() pour en tracer une rapidement. Le code ci‑dessous utilise une formule : chaque colonne est indiquée séparément avec des « + ». Le paramètre data reçoit le data frame et main fixe le titre.
pairs(~ h1b + Population + Income,
      data = state.data,
      main='h1b relationships')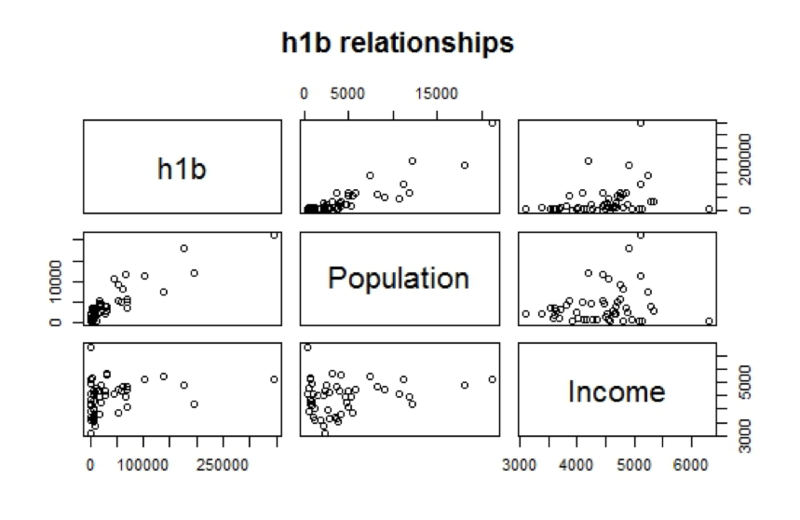
Cette matrice visualise les décomptes H‑1B face à Population et Income des États.
On observe une relation entre Population et h1b, ce qui est intuitif : plus d’habitants, plus d’opportunités nécessitant un visa H‑1B.
Pour « zoomer » sur un seul graphique de la matrice, appelez simplement plot() avec les deux variables.
plot(state.data$Income,state.data$h1b,
main = 'Income to H1B')Nous n’avons fait qu’entamer l’exploration des visas H‑1B ! Ce jeu de données est très riche et, dans le prochain article, vous étudierez les salaires, supprimerez les valeurs aberrantes et créerez des visuels ggplot2 plus percutants.
Vous approfondirez aussi ces concepts d’EDA en explorant l’évolution du statut H‑1B dans le temps et les principaux employeurs. Voici déjà un visuel intéressant : un box plot montrant la distribution des salaires par statut de visa H‑1B avec ce code :
ggplot(h1b.data) +
geom_boxplot(aes(factor(case_status),base_salary,fill=as.factor(case_status))) +
  ylim(0,100000) +
  theme_gdocs() +
  scale_fill_gdocs() +
  theme(axis.text.x=element_blank())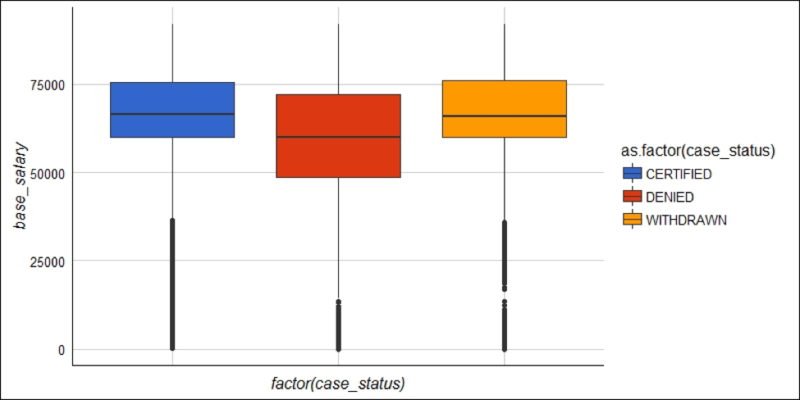
Restez à l’écoute pour la suite de la série « Exploring H‑1B Data with R » ! En attendant, jetez un œil à notre tutoriel sur les data frames en R, à notre cours Importing Data in R ou à notre cours Data Manipulation in R with dplyr.
Cours R
Cours
Cours
Cours