

为何选择 Gemini 2.0 Flash 而非 RAG?
Gemini 2.0 Flash 拥有 1,000,000 个 token 的上下文窗口,可在无需分片或检索机制的情况下对完整数据集进行处理。此外,与 Gemini Ultra 等更大型模型相比,它更具成本效益。
许多应用在结构化数据分析中使用检索增强生成(RAG),但 Gemini 2.0 Flash 使得无需使用 RAG,原因在于:
- 其超大 token 上限允许在单次请求中处理完整数据集。
- 它支持直接进行结构化数据分析,消除检索复杂度。
- 与基于 RAG 的方法相比,它处理速度更快且更具成本效率。
如果您希望使用 Gemini 2.0 Flash Lite 来优化成本,也可以这样做,但请注意,本文发布时它受限于每分钟 60 次的速率限制,且仅在 us-central1 区域可用。
概览:基于 Gemini 2.0 Flash 的 SaaS 销售洞察工具
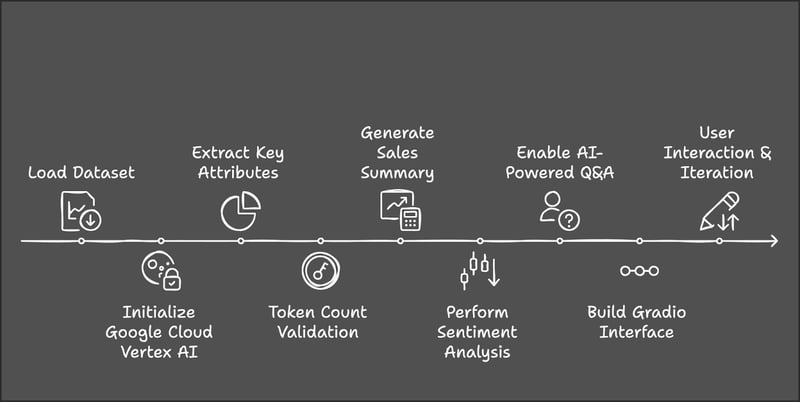
下面概述我们将要进行的主要步骤:
- 首先加载并准备来自 Kaggle 的 AWS SaaS Sales 数据集。
- 然后初始化 Google Cloud Vertex AI 与 Gemini 2.0 Flash 以进行 AI 处理。
- 接着提取唯一的行业与产品,供用户选择。
- 我们将使用 Tiktoken 在 token 限制内管理数据集大小。
- 用户所选筛选条件将触发关键销售指标的计算及 AI 驱动的洞察生成。
- 情感分析将对表现进行分类,并通过问答功能提供与销售相关的洞察。
- 最后,我们将把该工具集成到 Gradio 中,实现动态交互与实时探索。
步骤 1:前置条件
在开始之前,请确保已安装以下工具与库:
- Python 3.8+
- Kaggle
- Google-genai
- Datasets
- Tiktoken
- Gradio
运行以下命令安装所需依赖:
!pip install gradio -q
!pip install --upgrade --quiet google-genai
!pip install datasets -q
!pip install tiktoken -q
!pip install kaggle -q安装完成后,运行以下导入命令:
import sys
import os
import tiktoken
from datasets import load_dataset
import pandas as pd
import gradio as gr
import vertexai
from vertexai.preview.generative_models import GenerativeModel步骤 2:加载数据集
本项目将使用AWS SAAS Sales 数据集(托管于 Kaggle)。首先配置 Kaggle 凭据,并分别传入作者与数据集名称。
# Set Kaggle API credentials
os.environ["KAGGLE_CONFIG_DIR"] = os.path.expanduser("~/.kaggle")
# Download dataset
!kaggle datasets download -d nnthanh101/aws-saas-sales --unzip数据集已下载到当前环境,接下来开始处理。我们将使用 pandas 库从指定路径加载并读取数据集。
dataset_path = "path_to_your_data.csv" # Load dataset from specified path
dataset_df = pd.read_csv(dataset_path) 该数据集包含 9,994 笔交易,包含以下列:
- Industry:公司的行业类别。
- Product:所售 SaaS 产品。
- Sales:该笔交易的营收。
- Quantity:售出的许可证数量。
- Profit:该笔交易的利润。
- Discount:应用的任何折扣。
步骤 3:设置 Google Cloud Vertex AI
要使用 Gemini 2.0 Flash,我们需要在 Google Cloud 上进行身份验证。
if "google.colab" in sys.modules:
from google.colab import auth
auth.authenticate_user()要初始化 Vertex AI,请搜索 Vertex AI API 并启用它(确保您的账号已启用计费)。
保存项目的 ID 和位置以备后用。针对本项目运行 Gemini 2.0 Flash 的成本约为 0.07 美元(大约五次 API 调用)。
# Set up Google Cloud Vertex AI
PROJECT_ID = "Your_project_id"
LOCATION = "Your_location"
vertexai.init(project=PROJECT_ID, location=LOCATION)
model = GenerativeModel("gemini-2.0-flash")如需进一步了解 Vertex AI,请查看这篇Vertex AI 入门教程。
步骤 4:数据预处理
为确保正确处理数据,请规范化列名并提取关键类别。我们将提取唯一的行业与产品,作为演示中 Markdown 的来源。如果您使用的是其他数据集,请据此选择相应类别。
# Normalize column names to prevent key errors
df.columns = df.columns.str.strip().str.lower()
print("Dataset columns:", df.columns) # Debugging
# Extract unique industry names and product categories
unique_industries = sorted(df["industry"].dropna().unique().tolist())
unique_industries.insert(0, "All Industries") # Add "All Industries" option
unique_products = sorted(df["product"].dropna().unique().tolist())
unique_products.insert(0, "All Products") # Add "All Products" option步骤 5:统计数据集中的 Token 数
在完成数据集处理后,我们将统计 token 数量。由于 Gemini 2.0 Flash 的上限为 1,000,000 个 token,在将数据传入模型前计算数据集的 token 数非常重要。本数据集共有 805447 个 token。
# Initialize tokenizer (use "cl100k_base" for Gemini/GPT models)
encoder = tiktoken.get_encoding("cl100k_base")
# Choose relevant text columns
text_columns = ['industry', 'product', 'sales', 'quantity', 'discount', 'profit']
# Create a combined text column for tokenization
df["combined_text"] = df[text_columns].astype(str).agg(" | ".join, axis=1)
# Function to count tokens
def count_tokens(texts):
total_tokens = sum(len(encoder.encode(str(text))) for text in texts)
return total_tokens
# Calculate total tokens
total_tokens = count_tokens(df["combined_text"].dropna().tolist())
print(f"Total tokens in the dataset: {total_tokens}")我们按如下方式使用Tiktoken 进行分词:
- 初始化分词器: 使用 Tiktoken 的
cl100k_base分词器,针对 Gemini 和 GPT 模型优化。 - 选择相关文本列:确定 AI 分析所需的关键列(industry、product、sales、quantity、discount、profit)。
- 将所选列合并为单一文本字段: 将列转换为字符串以避免类型不匹配,并使用 " | " 作为分隔符合并为 combined_text。
- 定义统计 token 的函数: 对
combined_text的每一行进行分词,并计算所有行的 token 总数。 - 计算数据集的 token 总数:去除 NaN 值,应用 token 统计函数,并打印总数以确保符合 Gemini 2.0 Flash 的百万 token 限制。
步骤 6:汇总销售趋势
现在开始完成演示中的分析环节。以下函数会基于所选行业与产品生成销售摘要。
def summarize_sales(industry, product):
filtered_data = df.copy()
if industry != "All Industries":
filtered_data = filtered_data[filtered_data["industry"] == industry]
if product != "All Products":
filtered_data = filtered_data[filtered_data["product"] == product]
if filtered_data.empty:
return "No sales data available for the selected industry and product."
# Create sales report
total_sales = filtered_data["sales"].sum()
total_quantity = filtered_data["quantity"].sum()
total_profit = filtered_data["profit"].sum()
avg_discount = filtered_data["discount"].mean()
sales_text = f"""
Sales Data for {industry} - {product}:
- Total Sales: ${total_sales:,.2f}
- Total Quantity Sold: {total_quantity}
- Total Profit: ${total_profit:,.2f}
- Average Discount: {avg_discount:.2f}%
"""
# Generate summary using Gemini 2.0 Flash
response = model.generate_content(sales_text, stream=True)
response_text = "".join(chunk.text for chunk in response)
return response_textsummarize_sales() 函数会根据所选行业与产品筛选数据集,计算关键销售指标(如总销售额、售出数量、利润及平均折扣),并将数据格式化为结构化提示。随后将该提示传入 Gemini 2.0 Flash 模型,以生成简明的销售摘要。
步骤 7:执行销售情感分析
同样,我们定义另一个函数,基于总利润执行情感分析。
def analyze_sales_sentiment(industry, product):
filtered_data = dataset_df.copy()
if industry != "All Industries":
filtered_data = filtered_data[filtered_data["industry"] == industry]
if product != "All Products":
filtered_data = filtered_data[filtered_data["product"] == product]
if filtered_data.empty:
return "No sales data available for sentiment analysis."
total_sales = filtered_data["sales"].sum()
total_profit = filtered_data["profit"].sum()
# Define sentiment labels based on profit margins
if total_profit > 500000:
sentiment_label = "Positive"
elif total_profit > 100000:
sentiment_label = "Neutral"
else:
sentiment_label = "Negative"
sentiment_text = f"""
The total sales for {industry} - {product} is ${total_sales:,.2f},
with a total profit of ${total_profit:,.2f}.
Based on market trends, this performance is considered {sentiment_label}.
Analyze the sentiment of sales performance for this product.
"""
# Generate sentiment analysis using Gemini Flash 2.0
response = model.generate_content(sentiment_text, stream=True)
# Collect response text
response_text = "".join(chunk.text for chunk in response)
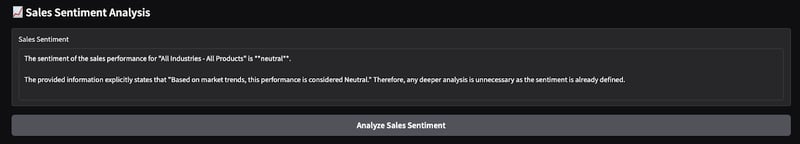
return response_textanalyze_sales_sentiment() 函数通过基于所选行业与产品筛选数据集、计算总销售额与总利润,并调用 Gemini 2.0 Flash 生成 AI 驱动的情感分析来评估销售情绪。模型接收结构化的销售表现摘要作为提示,从而能够以动态方式评估情绪,而不仅仅依赖固定的利润阈值。
步骤 8:构建 Gradio 界面
至此,关键的逻辑函数已就绪。接下来使用 Gradio 构建交互式界面。
with gr.Blocks() as demo:
gr.Markdown("# AI-Powered SaaS Sales Analysis")
industry_dropdown = gr.Dropdown(choices=unique_industries, label="Select an Industry")
product_dropdown = gr.Dropdown(choices=unique_products, label="Select a Product")
summarize_btn = gr.Button("Summarize Sales Trends")
summary_output = gr.Textbox(label="Sales Trend Summary")
summarize_btn.click(summarize_sales, inputs=[industry_dropdown, product_dropdown], outputs=summary_output)
demo.launch(debug=True)这段代码创建了一个用于 AI 驱动的 SaaS 销售分析的交互式 Gradio 界面,用户可以从下拉菜单中选择行业与产品,并点击按钮生成销售摘要。所选输入将传递给 summarize_sales() 函数,由其处理数据并返回洞察,结果显示在文本框中。随后启动 Gradio 应用以进行实时交互。
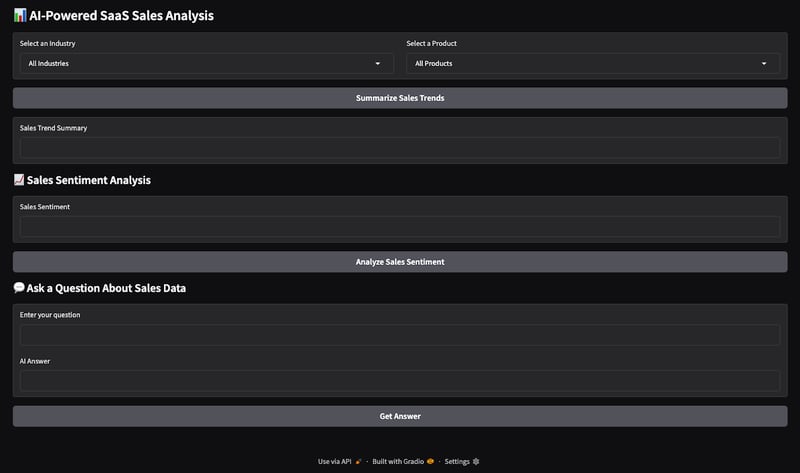
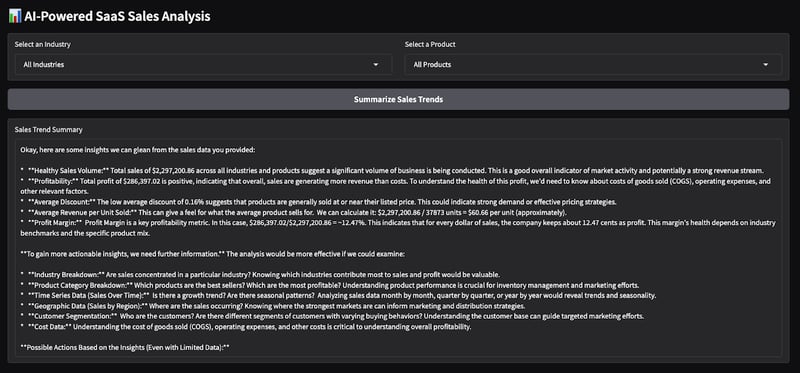
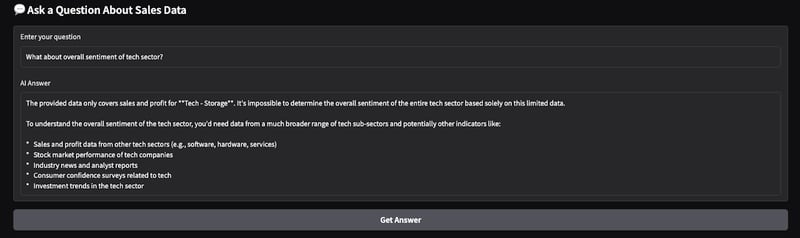
以下是我快速测试得到的输出。我选择了所有行业与产品,然后让模型生成销售摘要并对所选参数进行情感分析。
结语
在本教程中,我们使用 Gemini 2.0 Flash 构建了一款由 AI 驱动的 SaaS 销售洞察工具,实现对 SaaS 销售数据的实时分析。我们利用 Gemini 2.0 Flash 的大上下文窗口,在不依赖 RAG 的情况下处理结构化数据,并集成了基于 Gradio 的交互式界面,便于用户使用。
欢迎您将本教程改造用于自己的场景。若要进一步学习如何使用 Gemini 2.0 构建应用,推荐阅读以下教程:

我是一名 Google Developers 机器学习(生成式 AI)领域的专家、Kaggle 三项专家,以及 Women Techmakers 大使,拥有 3 年以上的技术从业经验。2020 年我共同创办了一家健康科技初创公司,目前在佐治亚理工学院攻读计算机科学硕士,专攻机器学习。
凭借高达一百万个 token 的超大上下文窗口,Gemini 2.0 Flash 专为高速处理大型文档而优化。在本教程中,我将介绍如何使用 Gemini 2.0 Flash 构建一款由 AI 驱动的 SaaS 销售洞察工具,它能够:
虽然我们将专注于构建一款面向 SaaS 的应用,但您也可以在这段视频中探索 Gemini 2.0 的更多用例,在其中您将学习如何构建本地的 YouTube 内容创作工具: