
课程
使用 LangChain 的 Retrieval Augmented Generation (RAG)
3 小时
20.9K
Google DeepMind 刚刚发布了 Gemma 3,这是其开源模型的下一代版本。Gemma 3 专为在手机和笔记本等低资源设备上直接运行而设计。这些模型针对单个 GPU 或 TPU 的快速性能进行了优化,并提供多种大小以适配不同的硬件需求。
在本教程中,我将一步步讲解如何通过 Ollama 在本地设置并运行 Gemma 3。完成之后,我还会展示如何使用 Gemma 3 和 Python 构建一个文件助手。
在本地运行如 Gemma 3 这样的 大语言模型(LLM)有以下几个关键好处:
Ollama 是一个适用于 Windows、Mac 和 Linux 的平台,支持运行与分发 AI 模型,便于开发者将这些模型集成到项目中。我们将使用它在本地下载并运行 Gemma 3。
第一步是从Ollama 官方网站下载并安装。
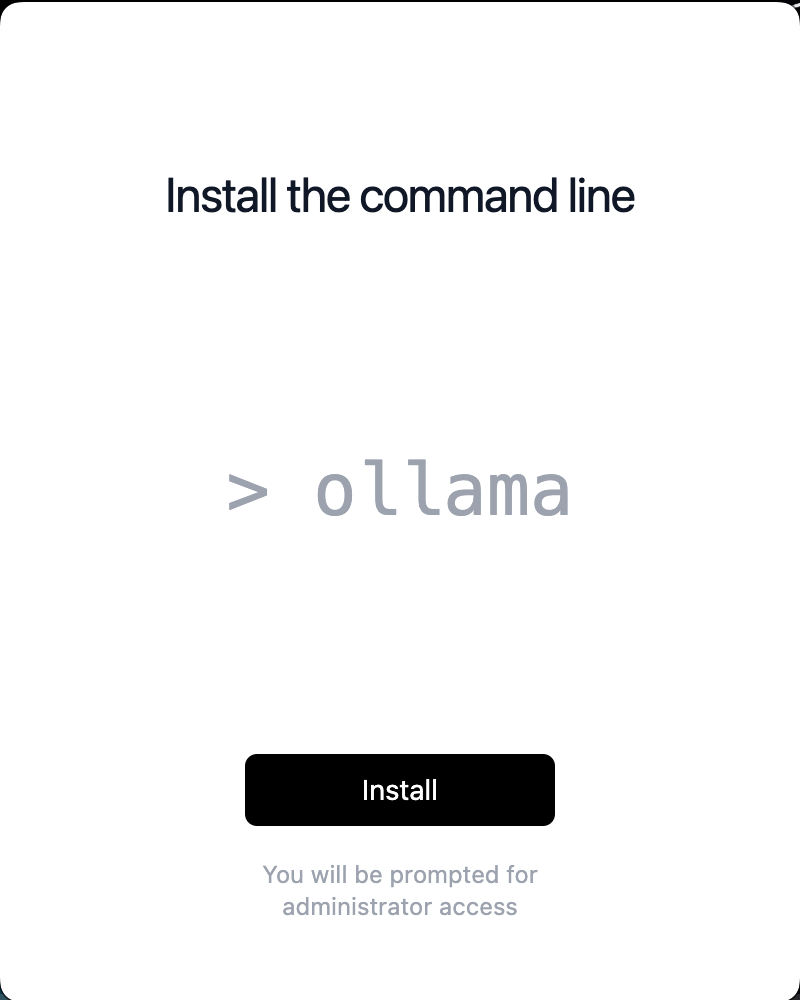
安装时,请确保勾选安装命令行工具:
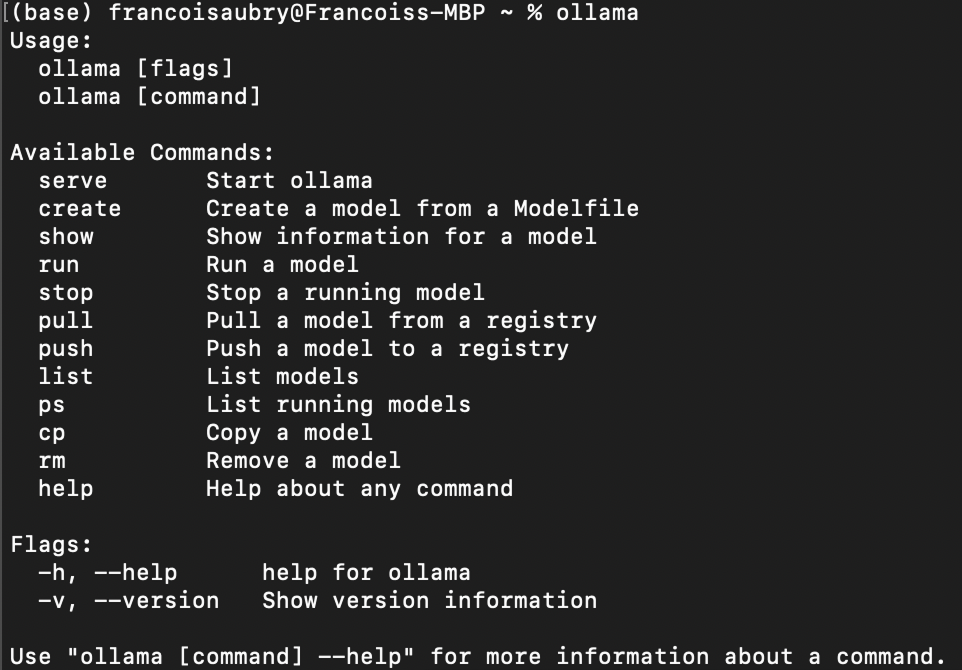
完成安装后,我们可以在终端使用 ollama 命令检查是否正确安装。结果应类似如下:
要通过 Ollama 下载模型,使用 pull 命令:
ollama pull <model_name>:<model_version>可用模型列表见Ollama 的库。
Gemma 3具体提供四个模型:1b、4b、12b 和 27b,其中 b 表示十亿,对应模型的参数数量。
例如,要下载参数为 1b 的 gemma3,使用命令:
ollama pull gemma3:1b如果不指定模型版本,默认会下载 4b 模型:
ollama pull gemma3我们可以使用以下命令列出本地已有的模型:
ollama list就我而言,输出显示我有两个模型:
NAME             ID              SIZE      MODIFIED
gemma3:1b        2d27a774bc62    815 MB    38 seconds ago
gemma3:latest c0494fe00251 3.3 GB 22 minutes ago 我们可以用 Ollama 通过 run 命令与模型聊天:
ollama run gemma3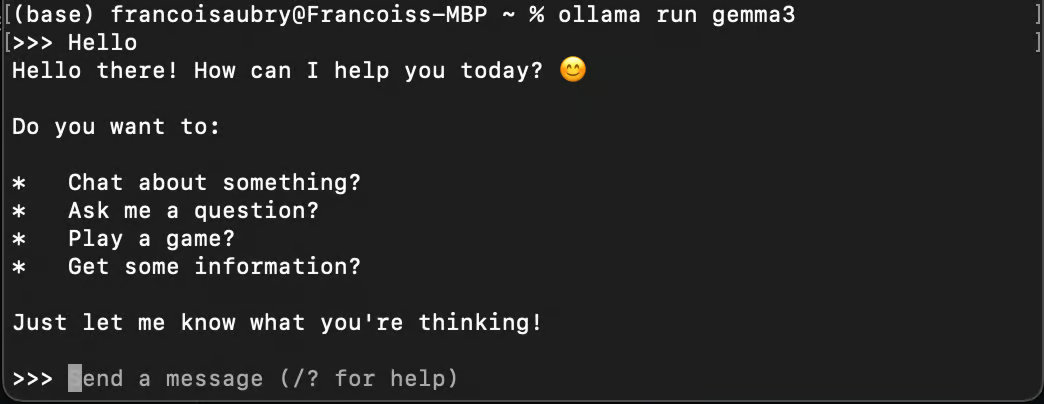
请注意,如果用 run 命令调用尚未下载的模型,它会通过 pull 自动下载。
要在 Python 中使用 Gemma 3,我们需要让它在后台运行。可以使用 serve 命令实现:
ollama serve如果执行该命令时出现以下错误,很可能说明 Ollama 已在运行中:
Error: listen tcp 127.0.0.1:11434: bind: address already in use当 Ollama 一直在后台运行时,可能会出现这个错误。
Ollama 提供了一个 Python 包,可轻松连接到在本机运行的模型。
我们将使用Anaconda来设置一个 Python 环境并添加必要的依赖。这样做有助于避免与我们现有的其他 Python 包发生冲突。
安装好 Anaconda 后,我们可以用如下命令创建环境:
conda create -n gemma3-demo -y python=3.9该命令会创建名为 gemma3-demo 的环境,并使用 Python 版本 3.9。-y 选项可在设置过程中自动对所有询问回答“是”。
接着,使用以下命令激活环境:
conda activate gemma3-demo最后,使用命令安装 ollama 包:
pip install ollama如下所示,我们可以用 Python 给 Gemma 3 发送一条消息:
from ollama import chat
response = chat(
    model="gemma3",
    messages=[
        {
            "role": "user",
            "content": "Why is the sky blue?",
        },
    ],
)
print(response.message.content)
根据您的硬件情况,模型可能需要一些时间来回答,因此执行脚本时请耐心等待。
前文提到,gemma3 默认指向 gemma3:4b。因此当我们将 model="gemma3" 指定为模型时,将会使用该版本。
若要使用其他模型——例如 1B 模型——则需要改为传入参数 model=”gemma3:1b”(前提是我们已通过 ollama pull gemma3:1b 命令拉取)。要列出可用模型,可使用 ollama list 命令。
如果希望按词流式输出答案,可以使用 stream=True 并按块打印响应:
from ollama import chat
stream = chat(
    model="gemma3",
    messages=[{"role": "user", "content": "Why is the sky blue?"}],
    stream=True,
)
for chunk in stream:
    print(chunk["message"]["content"], end="", flush=True)
这样能带来更好的用户体验,因为用户无需等待完整答案生成后再查看。
要进一步了解 ollama 包,请查阅其文档。
本节我们将学习如何构建一个 Python 脚本,使我们可以在终端中就某个文本文件的内容提问。该脚本可用于检查代码文件中的潜在问题,或从任意文档中查询信息。
我们的目标是创建一个 Python 命令行工具,它读取一个文本文件,并利用 Gemma 3 回答与其内容相关的问题。以下是实现步骤:
首先,我们需要设置 Python 脚本所需的导入和基础结构:
import sys
from ollama import chat
def ask_questions_from_file(file_path):
    # Read the content of the text file
    with open(file_path, "r") as file:
        content = file.read()
    # Loop to keep asking questions
    while True:
        question = input("> ")
        print()
        if question.lower() == "exit":
            break
        # Use Gemma 3 to get answers
        stream = chat(
            model="gemma3",
            messages=[
                {"role": "user", "content": content},
                {"role": "user", "content": question},
            ],
            stream=True,
        )
        for chunk in stream:
            print(chunk["message"]["content"], end="", flush=True)

if __name__ == "__main__":
    if len(sys.argv) != 2:
        print("Usage: python ask_file.py <path_to_text_file>")
    else:
        file_path = sys.argv[1]
        ask_questions_from_file(file_path)
核心功能封装在 ask_questions_from_file() 函数中。该函数以文件路径作为参数,首先打开并读取指定文本文件的内容。该内容将作为背景信息用于回答问题。
文件内容加载后,脚本进入循环,持续提示我们输入问题。当我们输入问题时,脚本会将文件内容与问题一并发送给 Gemma 3 模型,由其处理并生成答案。
与模型的交互通过流式机制进行,允许在答案生成的同时实时显示。如果我们输入 exit,循环将结束,脚本停止运行。
脚本末尾会检查运行方式是否正确,即是否提供了一个命令行参数(文本文件路径)。如果未提供,它会显示使用说明,指引我们以正确方式运行脚本。该设置使我们可以在命令行中高效地使用脚本。
将上述代码保存为例如 ask.py。要测试脚本,运行命令:
python ask.py ask.py这将运行脚本来就其自身提问(因此上面命令中 ask.py 出现了两次)。以下是请求它解释脚本工作原理的示例:
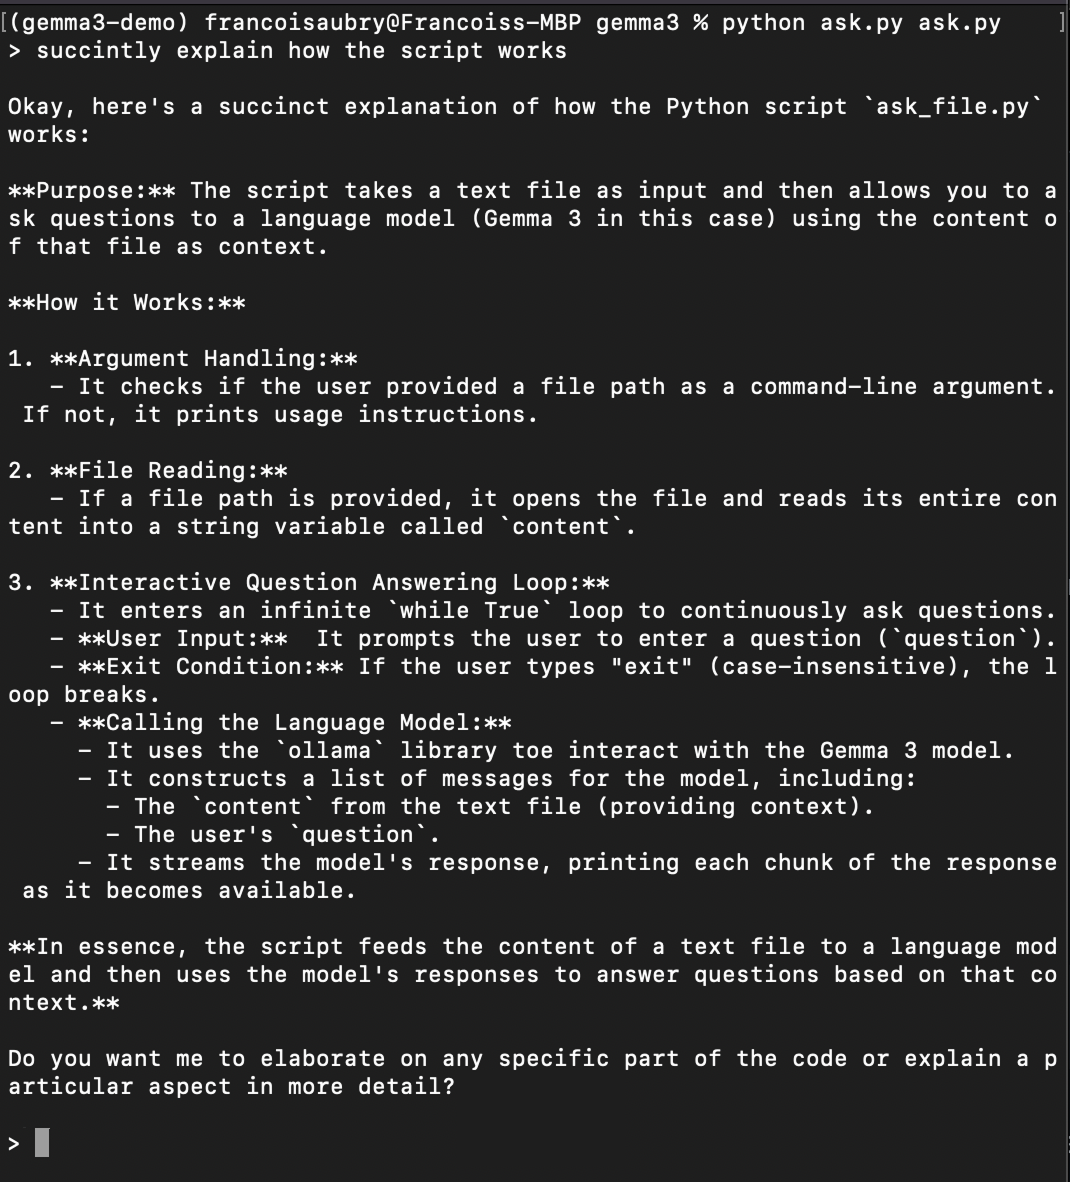
我们已成功通过 Ollama 和 Python 在本地设置并运行 Gemma 3。此方式可确保数据隐私、提供低延迟、具备定制选项,并可能带来成本节省。以上步骤不仅适用于 Gemma 3——也同样适用于托管在 Ollama 上的其他模型。
如果想进一步增强脚本功能,例如让其支持 PDF,最佳方式是使用Mistral OCR API。我们可以将 PDF 转换为文本,使脚本能够就 PDF 提问,从而更通用、更强大。
借助这些工具,我们现在可以在自己的设备上探索并与大型模型交互。
用这些课程学习 AI!
课程
课程
学习路径