{count, plural, other {学习路径}}
AI智能体基础知识
{hours} 小时
GLM-5.3-Flash 在性能、效率与价格之间达成了令人印象深刻的平衡。要了解完整概览,请阅读我们的 GLM-5.3-Flash 指南 以及与 Qwen3.8-Flash-Next 的对比文章。
在 Artificial Analysis Intelligence Index 上,其得分为 57,跻身领先模型之列,并可与数个价格更高的前沿模型竞争。例如:
GPT-5.6 Sol 同样得分 57(high 推理强度),但输入 token 成本高出 25 倍以上、输出 token 成本高出 40 倍以上。
Claude Sonnet 5 在其 max 推理强度下得分略低,为 55。其输入/输出 token 价格分别比 GLM-5.3-Flash 高出约 20 倍/30 倍。
它的总参数量为 320B,但每个 token 仅有约 18B 参数处于激活状态,因此能在保持相对计算效率的同时提供强劲表现。
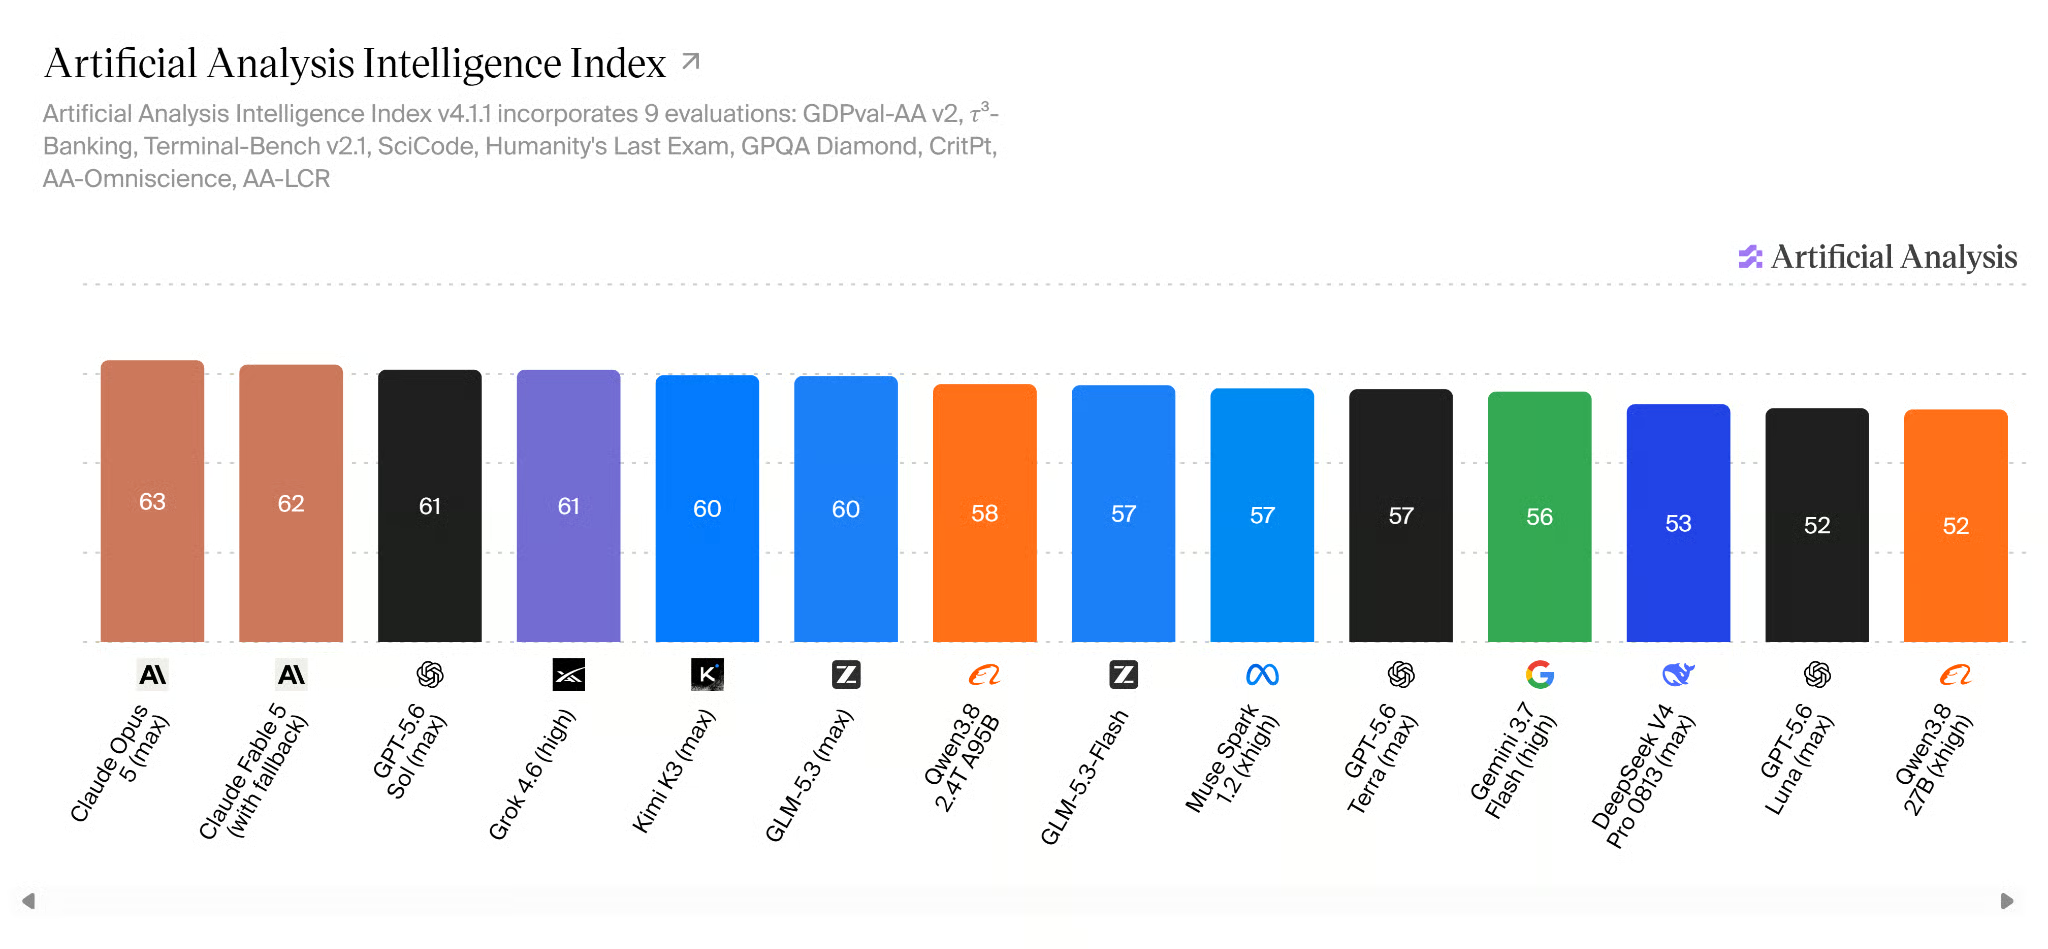
来源:AI Model & API Providers Analysis | Artificial Analysis
正如我已提到的,这样的性能搭配相对较低的 API 定价。截至撰写时,OpenRouter 以五折优惠提供 GLM-5.3-Flash,输入每百万 tokens 为 $0.075,输出每百万 tokens 为 $0.25。
即便在常规价格 $0.15/$0.50 下,它依旧比一些模型更便宜,例如 OpenAI 的 GPT-5.6 Luna,定价为 $0.20/$1.20(在 AA Intelligence Index 的 max 推理下得分 52)。这不仅适合实验,也适用于更大规模、面向生产的智能体应用。
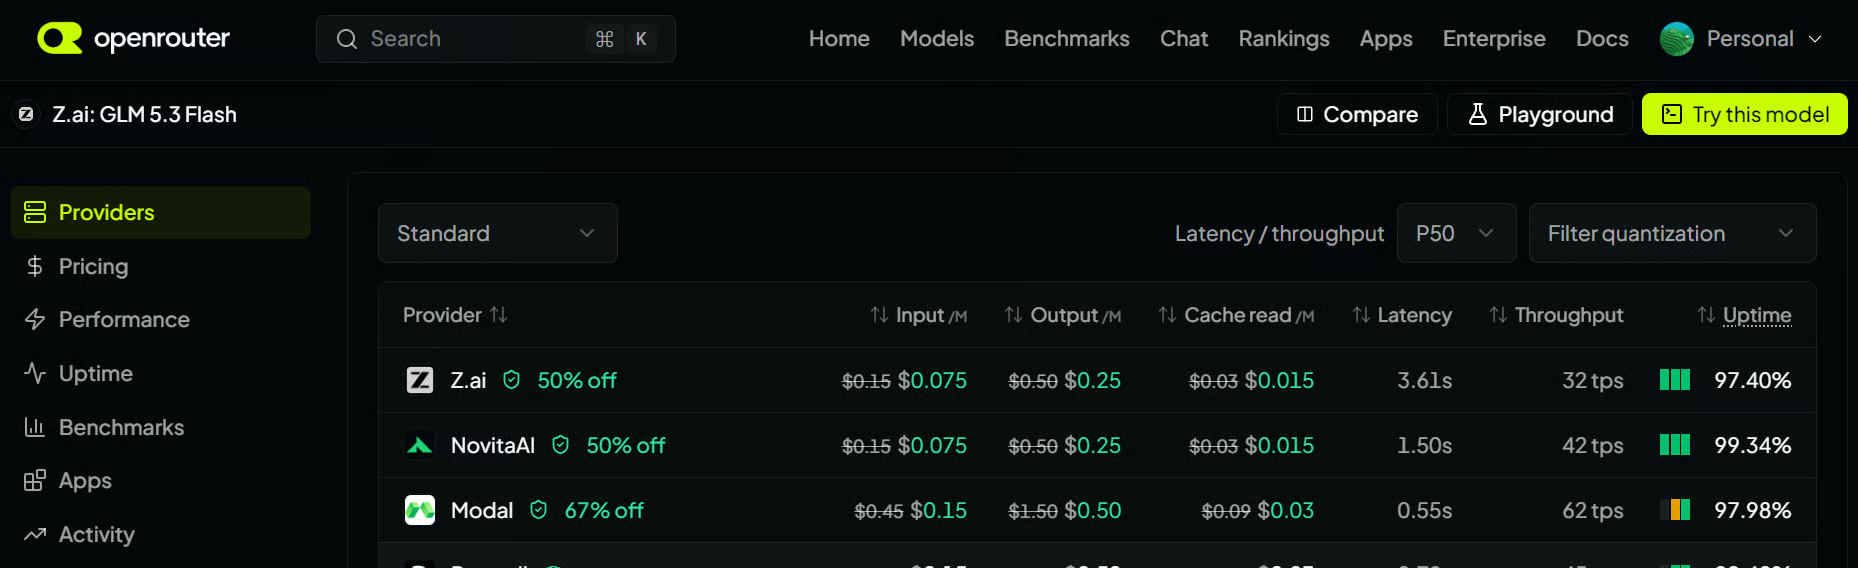
来源:GLM 5.3 Flash - API Pricing & Benchmarks | OpenRouter
在构建多智能体系统时,这一点更为重要,因为一次用户请求可能在后台触发多次 LLM 调用。单个LLM 智能体可能会为推理、工具选择、处理工具输出以及生成最终回复多次调用模型。如果一个智能体大约进行七次 LLM 调用,而您的工作流使用五个智能体,那么一次请求很容易产生 35 次或更多调用。
具体次数取决于系统设计,但道理很简单:智能体工作流的成本会很快上升。使用像 GLM-5.3-Flash 这样能力强且 token 定价低的模型,在从小型演示转向真实生产应用时会带来显著差异。
在构建多智能体工作流之前,为 Z.ai、Finnhub 和 Tavily 创建 API 密钥。
对于 Z.ai,请确保使用常规 API,而不是 GLM Coding Plan。Coding Plan 面向受支持的 AI 编码工具,不应用作您自建多智能体应用的一般用途 API。
生成常规的 Z.ai API 密钥,并为您的账户充值一小笔金额。由于 GLM-5.3-Flash 价格低廉,开始测试只需很少的余额。
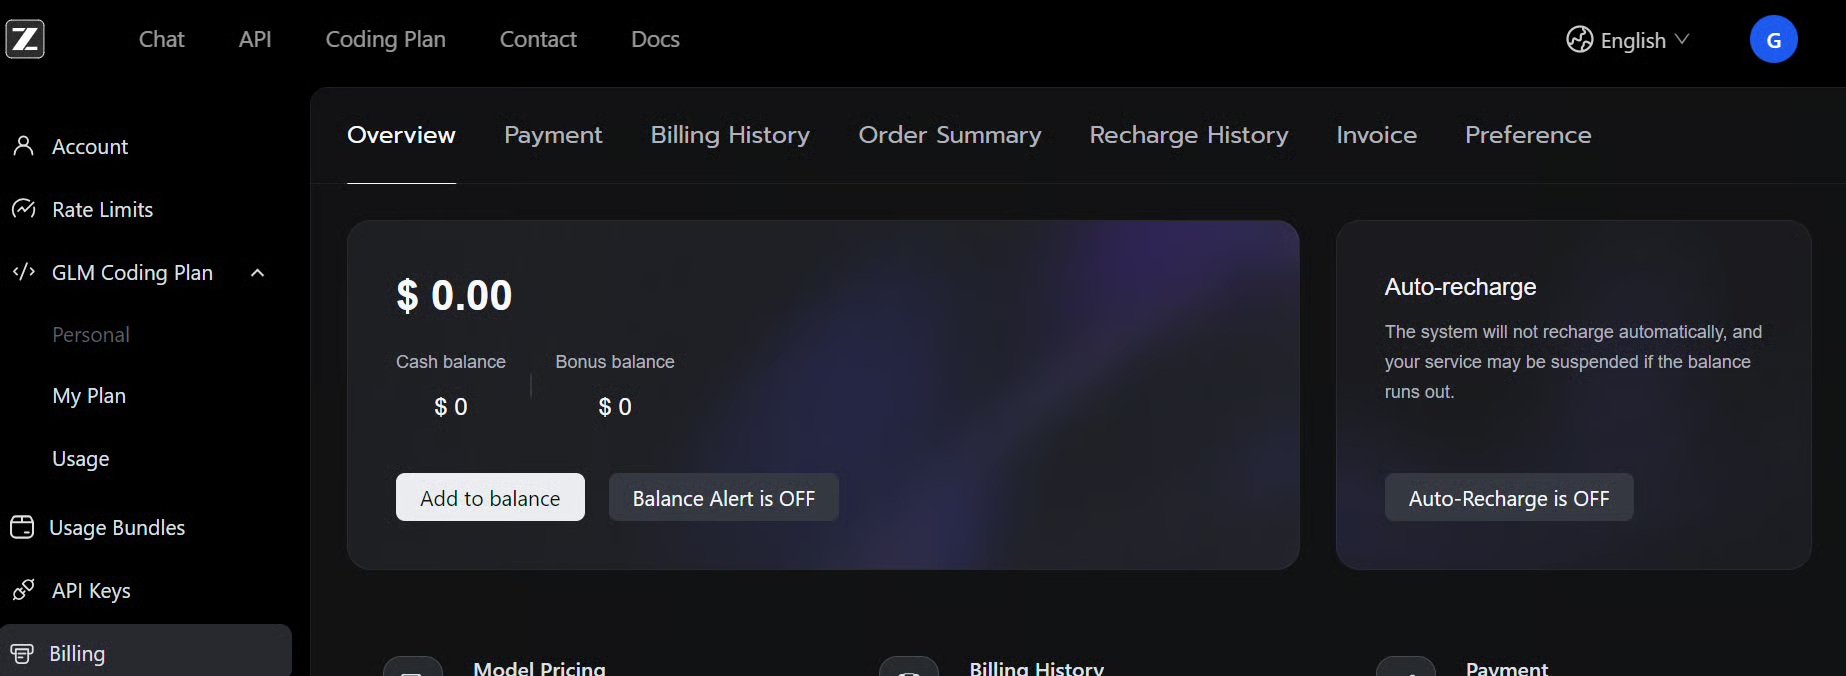
来源:Z.ai API Platform — Start building with GLM-5.3
您也可以在 Finnhub 和 Tavily 创建免费账户并生成 API 密钥。它们的免费层足以测试本项目。
接着,在项目文件夹中创建一个 .env 文件并添加 API 密钥:
ZAI_API_KEY="your_zai_api_key"
FINNHUB_API_KEY="your_finnhub_api_key"
TAVILY_API_KEY="your_tavily_api_key"现在,新建一个Jupyter Notebook。我们将先在这里构建并测试完整的多智能体工作流,检查每个智能体的输出,修复问题后再将其变成一个正式应用。
我们将使用 CrewAI 创建与协调智能体,使用 Finnhub 获取股票市场数据,并用 Tavily 进行实时网页搜索。安装以下 Python 包:
!pip install -q crewai crewai-tools finnhub-python tavily-python pandas numpy requests python-dotenv openai接下来导入所需库并加载 API 密钥:
import os
import re
import time

import finnhub
import numpy as np
import pandas as pd
import requests

from dotenv import load_dotenv
from openai import OpenAI
from tavily import TavilyClient

from crewai import Agent, Crew, LLM, Process, Task
from crewai.tools import tool
from crewai_tools import TavilySearchTool

# Load environment variables
load_dotenv()

# Disable CrewAI tracing
os.environ.setdefault("CREWAI_TRACING_ENABLED", "false")
os.environ.setdefault("OTEL_SDK_DISABLED", "true")
最后,选择您希望智能体分析的股票:
TICKER = "NVDA"我将在整个 Notebook 中使用 NVIDIA(NVDA),但您也可以替换为其他感兴趣的代码,例如 AAPL、MSFT 或 TSLA。
现在 API 密钥已就绪,我们可以连接项目中所有智能体将使用的服务。
首先初始化 Finnhub(股票市场数据)与 Tavily(网页搜索):
finnhub_client = finnhub.Client(
    api_key=os.environ["FINNHUB_API_KEY"]
)

tavily_client = TavilyClient(
    api_key=os.environ["TAVILY_API_KEY"]
)如果您想构建金融智能体但不确定该用哪个数据源,建议阅读我们的股票市场数据 API 选型指南。
接着,将 GLM-5.3-Flash 配置为我们 CrewAI 智能体的主 LLM。Z.ai 提供与 OpenAI 兼容的 API,因此我们可以直接通过 CrewAI 的 LLM 类连接:
llm = LLM(
    model="openai/glm-5.3-flash",
    api_key=os.environ["ZAI_API_KEY"],
    base_url="https://api.z.ai/api/paas/v4/",
    temperature=0.1,
)
我们将温度设为较低值,因为本应用侧重金融研究与分析,我们希望智能体的输出更一致、更聚焦。
模型、市场数据与网页搜索 API 都已连接,接下来我们开始构建智能体将使用的工具。
接下来我们需要历史价格数据,以便智能体了解该股票的长期表现。
为此,我们将调用 Yahoo Finance 的公共图表端点,收集每日开、高、低、收与成交量数据。
HTTP = requests.Session()
HTTP.headers.update({"User-Agent": "glm-stock-swarm/1.0"})


def _yahoo_history(ticker: str, days: int) -> pd.DataFrame:
    end = int(time.time())
    start = end - days * 24 * 60 * 60

    response = HTTP.get(
        f"https://query1.finance.yahoo.com/v8/finance/chart/{ticker}",
        params={
            "period1": start,
            "period2": end,
            "interval": "1d",
            "events": "history",
        },
        timeout=30,
    )
    response.raise_for_status()

    result = response.json()["chart"]["result"][0]
    values = result["indicators"]["quote"][0]

    frame = pd.DataFrame({
        "date": pd.to_datetime(
            result["timestamp"], unit="s", utc=True
        ).tz_localize(None),
        "open": values["open"],
        "high": values["high"],
        "low": values["low"],
        "close": values["close"],
        "volume": values["volume"],
    })

    frame = (
        frame.dropna(subset=["close"])
        .sort_values("date")
        .reset_index(drop=True)
    )

    frame.attrs["source"] = "Yahoo public chart"
    return frame


def get_price_history(ticker: str, days: int = 450) -> pd.DataFrame:
    return _yahoo_history(ticker.strip().upper(), days)
我们将收集约 450 天的历史数据,这足以计算如 200 日均线等长期指标。
接下来计算一些常用指标:
def add_indicators(frame: pd.DataFrame) -> pd.DataFrame:
    if frame.empty:
        return frame.copy()

    result = frame.copy()
    result.attrs.update(frame.attrs)

    # Moving averages
    result["SMA20"] = result["close"].rolling(20).mean()
    result["SMA50"] = result["close"].rolling(50).mean()
    result["SMA200"] = result["close"].rolling(200).mean()

    # RSI
    delta = result["close"].diff()
    gain = delta.clip(lower=0)
    loss = -delta.clip(upper=0)

    avg_gain = gain.ewm(
        alpha=1 / 14, min_periods=14, adjust=False
    ).mean()

    avg_loss = loss.ewm(
        alpha=1 / 14, min_periods=14, adjust=False
    ).mean()

    result["RSI14"] = 100 - (
        100 / (1 + avg_gain / avg_loss.replace(0, np.nan))
    )

    # MACD
    result["EMA12"] = result["close"].ewm(
        span=12, adjust=False
    ).mean()

    result["EMA26"] = result["close"].ewm(
        span=26, adjust=False
    ).mean()

    result["MACD"] = result["EMA12"] - result["EMA26"]

    return result
这些指标能让技术分析智能体快速把握趋势与动量,而无需让 LLM 自行计算所有内容。
现在收集数据、计算指标,并显示最新行:
history = add_indicators(
    get_price_history(TICKER)
)

if len(history) < 200:
    raise RuntimeError(
        f"Need at least 200 daily observations; received {len(history)}."
    )

print(
    f"Loaded {len(history)} rows "
    f"from {history.attrs['source']}."
)

history.tail(3)[
    [
        "date",
        "close",
        "SMA20",
        "SMA50",
        "SMA200",
        "RSI14",
        "MACD",
    ]
]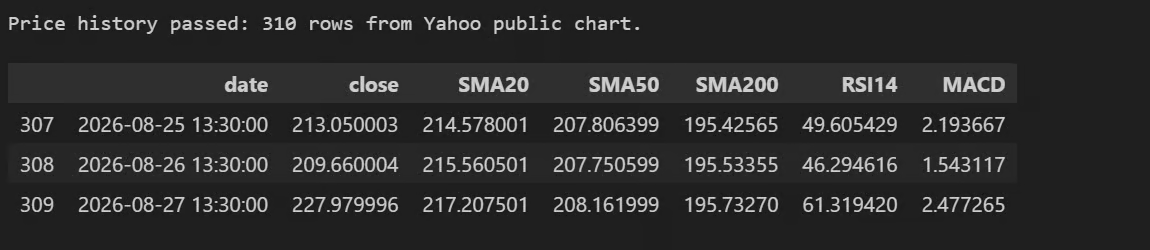
您应能看到最新股价及其移动平均、RSI 与 MACD,类似上图输出。
稍后我们会将这些数据传给技术分析智能体,以识别价格趋势、动量以及多空信号。
既然数据源已可用,我们需要把它们封装为 CrewAI 工具。这样智能体在需要金融、技术或新闻信息时就能直接调用。
首先创建一个小工具函数,以保持数值输出的整洁与一致:
def _number(value, decimals: int = 2) -> str:
    if value is None or pd.isna(value):
        return "N/A"

    return f"{float(value):,.{decimals}f}"
接着创建基本面工具。它使用 Finnhub 获取最新股价、估值指标、增长、盈利能力及其他公司基本面数据。
@tool("Get Stock Fundamentals")
def get_fundamentals(ticker: str) -> str:
    """Get current price and company fundamentals from Finnhub for one ticker."""

    ticker = ticker.strip().upper()

    quote = finnhub_client.quote(ticker)
    metrics = finnhub_client.company_basic_financials(ticker, "all")
    m = metrics.get("metric", {})

    return f"""Ticker: {ticker}
Source: Finnhub
Current price: {_number(quote.get('c'))}
Previous close: {_number(quote.get('pc'))}
Daily change %: {_number(quote.get('dp'))}
Day high / low: {_number(quote.get('h'))} / {_number(quote.get('l'))}
Market cap (USD millions): {_number(m.get('marketCapitalization'))}
52-week high / low: {_number(m.get('52WeekHigh'))} / {_number(m.get('52WeekLow'))}
Normalized annual P/E: {_number(m.get('peNormalizedAnnual'))}
Annual P/B: {_number(m.get('pbAnnual'))}
Annual P/S: {_number(m.get('psAnnual'))}
ROE TTM: {_number(m.get('roeTTM'))}
Net margin TTM: {_number(m.get('netProfitMarginTTM'))}
Revenue growth TTM YoY: {_number(m.get('revenueGrowthTTMYoy'))}
EPS growth TTM YoY: {_number(m.get('epsGrowthTTMYoy'))}
Annual debt/equity: {_number(m.get('totalDebt/totalEquityAnnual'))}"""
我们还将用上一节的历史数据与指标创建一个技术分析工具。
@tool("Analyze Stock Technicals")
def get_technicals(ticker: str) -> str:
    """Calculate price trends, returns, moving averages, RSI, and MACD."""

    ticker = ticker.strip().upper()
    frame = add_indicators(get_price_history(ticker))

    if len(frame) < 200:
        return (
            f"Technical data unavailable for {ticker}: "
            "fewer than 200 observations."
        )

    latest = frame.iloc[-1]

    return f"""Ticker: {ticker}
Source: {frame.attrs.get('source', 'unknown')}
Last market date: {latest['date'].date()}
Close: {_number(latest['close'])}
SMA20 / SMA50 / SMA200: {_number(latest['SMA20'])} / {_number(latest['SMA50'])} / {_number(latest['SMA200'])}
RSI14: {_number(latest['RSI14'])}
MACD: {_number(latest['MACD'])}
20-day return: {_number((latest['close'] / frame['close'].iloc[-21] - 1) * 100)}%
50-day return: {_number((latest['close'] / frame['close'].iloc[-51] - 1) * 100)}%
Price vs SMA20: {_number((latest['close'] / latest['SMA20'] - 1) * 100)}%
Price vs SMA50: {_number((latest['close'] / latest['SMA50'] - 1) * 100)}%
Price vs SMA200: {_number((latest['close'] / latest['SMA200'] - 1) * 100)}%"""
这里的关键是 @tool 装饰器。它将普通 Python 函数变成 CrewAI 智能体在任务中可决定调用的工具。
对于公司新闻与近期动态,我们将使用 CrewAI 的 Tavily 搜索工具:
web_search = TavilySearchTool(
    api_key=os.environ["TAVILY_API_KEY"],
    topic="news",
    search_depth="advanced",
    days=30,
    max_results=5,
)
我们将搜索范围限制在最近 30 天,并返回最多五条结果,这应能为研究智能体提供足够的近期信息,同时避免被不必要的内容淹没。
在创建智能体前,先直接运行这两个自定义工具:
print(get_fundamentals.run(ticker=TICKER))
print()
print(get_technicals.run(ticker=TICKER))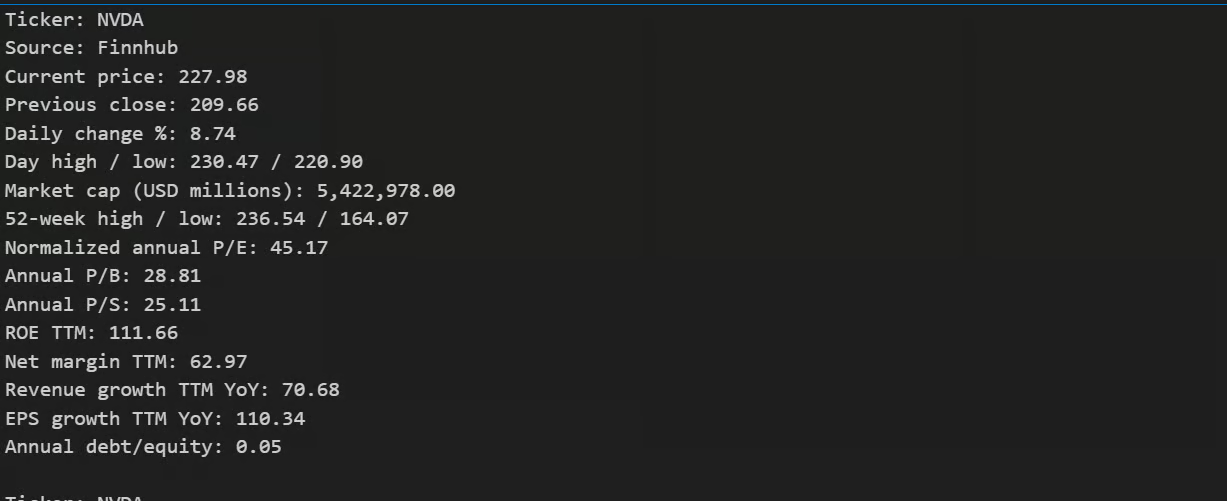
现在您应能看到所选股票的最新基本面指标,随后是其技术指标。
工具就绪后,我们可以创建多智能体研究团队。
我们将使用三位专业智能体:基本面分析、技术面分析与新闻分析;再加上一位投资组合经理,将它们的结论合并为最终评估。
首先,创建基本面分析师:
fundamental_agent = Agent(
    role="Fundamental Analyst",
    goal=(
        "Evaluate financial health, growth, profitability, "
        "valuation, and balance-sheet risk."
    ),
    backstory=(
        "You are a careful long-term equity analyst. "
        "Use the fundamentals tool and never invent a figure. "
        "Treat N/A as missing, not as zero."
    ),
    tools=[get_fundamentals],
    llm=llm,
    allow_delegation=False,
    max_iter=4,
    verbose=False,
)
接着,创建技术分析师:
technical_agent = Agent(
    role="Technical Analyst",
    goal=(
        "Determine whether the current price setup is "
        "bullish, bearish, or neutral."
    ),
    backstory=(
        "You interpret indicators calculated by Python. "
        "Never guess market prices or indicator values."
    ),
    tools=[get_technicals],
    llm=llm,
    allow_delegation=False,
    max_iter=4,
    verbose=False,
)
然后,创建财经新闻分析师:
news_agent = Agent(
    role="Financial News Analyst",
    goal=(
        "Find material recent developments and distinguish "
        "confirmed reporting from speculation."
    ),
    backstory=(
        "You are a skeptical financial-news researcher. "
        "Prioritize primary and reputable sources, dates, and links."
    ),
    tools=[web_search],
    llm=llm,
    allow_delegation=False,
    max_iter=5,
    verbose=False,
)
每位专家只获得其所需的工具。这使工作流更聚焦,并防止智能体调用无关工具。
最后,创建将审阅三份专家报告的管理智能体:
manager_agent = Agent(
    role="Portfolio Manager",
    goal=(
        "Combine the specialist reports into a balanced, "
        "evidence-based research signal."
    ),
    backstory=(
        "You lead an equity research team. "
        "Weigh bullish and bearish evidence, use HOLD when evidence "
        "is mixed, and never add unsupported facts."
    ),
    llm=llm,
    allow_delegation=False,
    max_iter=4,
    verbose=False,
)
投资组合经理无需直接访问数据工具;其将基于三位专家产出的报告进行工作。
将 allow_delegation=False 能让工作流更可预测,而 max_iter 则限制每个智能体的推理与工具使用循环次数。
创建智能体定义了它们是谁。现在我们需要明确告诉每个智能体它应该做什么,以及最终输出应包含什么。
从基本面分析任务开始:
fundamental_task = Task(
    description=(
        f"Analyze {TICKER}'s growth, profitability, valuation, "
        "balance sheet, and business quality. "
        "Use Get Stock Fundamentals. "
        "Return a Fundamental Score from 0-100, strongest positive, "
        "biggest risk, and note all material missing data."
    ),
    expected_output=(
        "A concise fundamental assessment with a 0-100 score, "
        "evidence, strongest positive, biggest risk, "
        "and missing-data note."
    ),
    agent=fundamental_agent,
)
接着定义技术分析任务:
technical_task = Task(
    description=(
        f"Analyze {TICKER}'s technical setup. "
        "Use Analyze Stock Technicals. "
        "Consider SMA20/50/200, RSI14, MACD, recent returns, and trend. "
        "Return Technical Score 0-100, Bullish/Neutral/Bearish signal, "
        "trend, momentum, and main technical risk."
    ),
    expected_output=(
        "A concise technical assessment with score, signal, trend, "
        "momentum, data source, and main risk."
    ),
    agent=technical_agent,
)
对于近期动态,创建新闻研究任务:
news_task = Task(
    description=(
        f"Research the most important recent news for {TICKER}, "
        "focusing on the last 30 days: earnings, guidance, analyst "
        "revisions, products, partnerships, M&A, regulation, lawsuits, "
        "management, and industry developments. "
        "Use Tavily Search. "
        "Return News Score 0-100, sentiment, positive and negative "
        "catalysts, publication dates, and source URLs. "
        "Ignore low-quality speculation."
    ),
    expected_output=(
        "A sourced recent-news assessment with score, sentiment, "
        "catalysts, dates, and clickable URLs."
    ),
    agent=news_agent,
)
为每个智能体设定清晰任务与输出格式非常重要。这能让投资组合经理更易对比报告,而不是每位智能体返回风格完全不同的回应。
最终任务将三份报告汇总:
decision_task = Task(
    description=(
        f"Review all three specialist reports and make the final "
        f"educational research assessment for {TICKER}. "
        "Return exactly one signal: BUY, HOLD, or SELL. "
        "Use HOLD when evidence is mixed or confidence is insufficient. "
        "Base every claim only on the supplied reports."
    ),
    expected_output=(
        "Ticker; Signal; Overall Score /100; Confidence %; "
        "Fundamental, Technical, and News scores; Bull Case; "
        "Bear Case; Main Catalyst; Main Risk; Final Explanation; "
        "Sources; and an educational-not-financial-advice disclaimer."
    ),
    agent=manager_agent,
    context=[
        fundamental_task,
        technical_task,
        news_task,
    ],
)
关键在于 context。它让投资组合经理能访问三项专家任务的输出,从而在生成最终 BUY、HOLD 或 SELL 评估前对比基本面、技术面与新闻信号。
至此,我们的智能体、工具与任务均已就绪。接下来将它们连接为 CrewAI 工作流并运行完整研究团队。
现在我们可以将一切整合并运行完整的股票研究工作流。
创建包含三位专家与投资组合经理的 CrewAI 团队:
crew = Crew(
    agents=[
        fundamental_agent,
        technical_agent,
        news_agent,
        manager_agent,
    ],
    tasks=[
        fundamental_task,
        technical_task,
        news_task,
        decision_task,
    ],
    process=Process.sequential,
    verbose=False,
    tracing=False,
)
我们使用 Process.sequential,因此研究任务按顺序运行。基本面、技术面与新闻分析师先完成各自分析,然后投资组合经理接收这些报告并产出最终评估。
以异步方式启动工作流:
result = await crew.kickoff_async()此步骤可能需要一些时间,因为智能体会进行多次 LLM 与工具调用。我的测试中,完整研究工作流大约耗时 4 到 5 分钟。
完成后,显示投资组合经理的最终报告:
print(result.raw)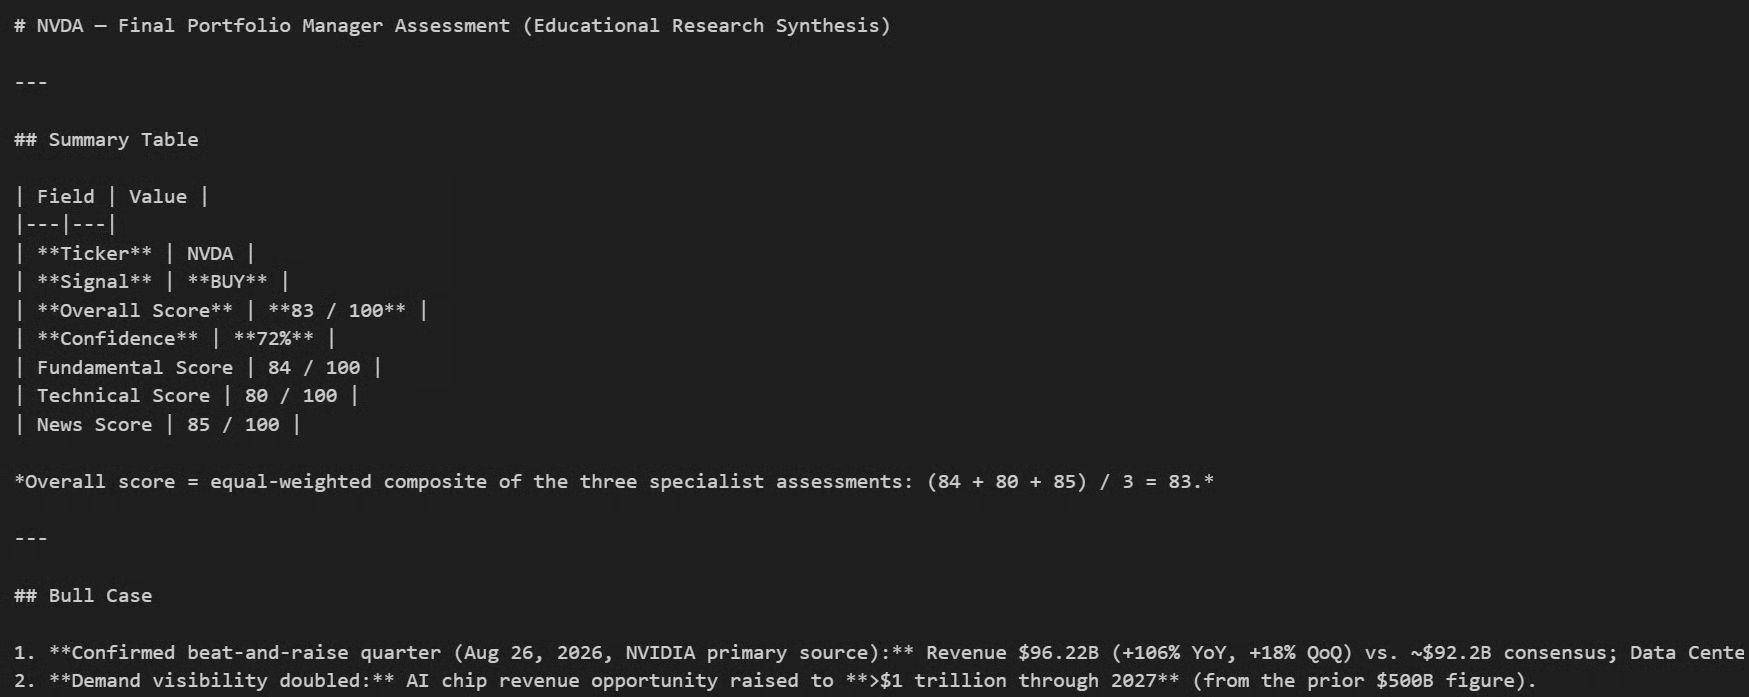
您应会获得类似上图的详细报告,包括:
在该示例中,智能体分别独立分析英伟达,并将其发现合并为一份基于证据的研究报告。这正是多智能体方法的优势所在:与其让一个模型一次性完成所有工作,不如先让每个智能体专注各自领域,再由投资组合经理整合所有研究。
如果您在运行上述代码时遇到问题,我还提供了包含全部代码与输出的完整 Jupyter Notebook,您可以自行查看或运行:glm-stock-swarm/stock_analyst_crew.ipynb
在 Jupyter Notebook 内完成测试后,我将完整工作流转换成了一个终端用户界面(TUI)。无需手动逐个运行单元格,您现在可以用一条命令启动整套多智能体股票分析流程。
完整项目(含代码与搭建说明)已发布在 GitHub:glm-stock-swarm GitHub 仓库。
首先克隆仓库:
git clone https://github.com/kingabzpro/glm-stock-swarm.git
cd glm-stock-swarm
将您的 Z.ai、Finnhub 与 Tavily API 密钥添加到 .env 文件中,然后使用 uv 安装所有依赖:
uv sync最后,启动 TUI:
uv run glm-stock-swarm该界面提供一个简单的输入框,您可以输入任意受支持的股票代码以启动分析。
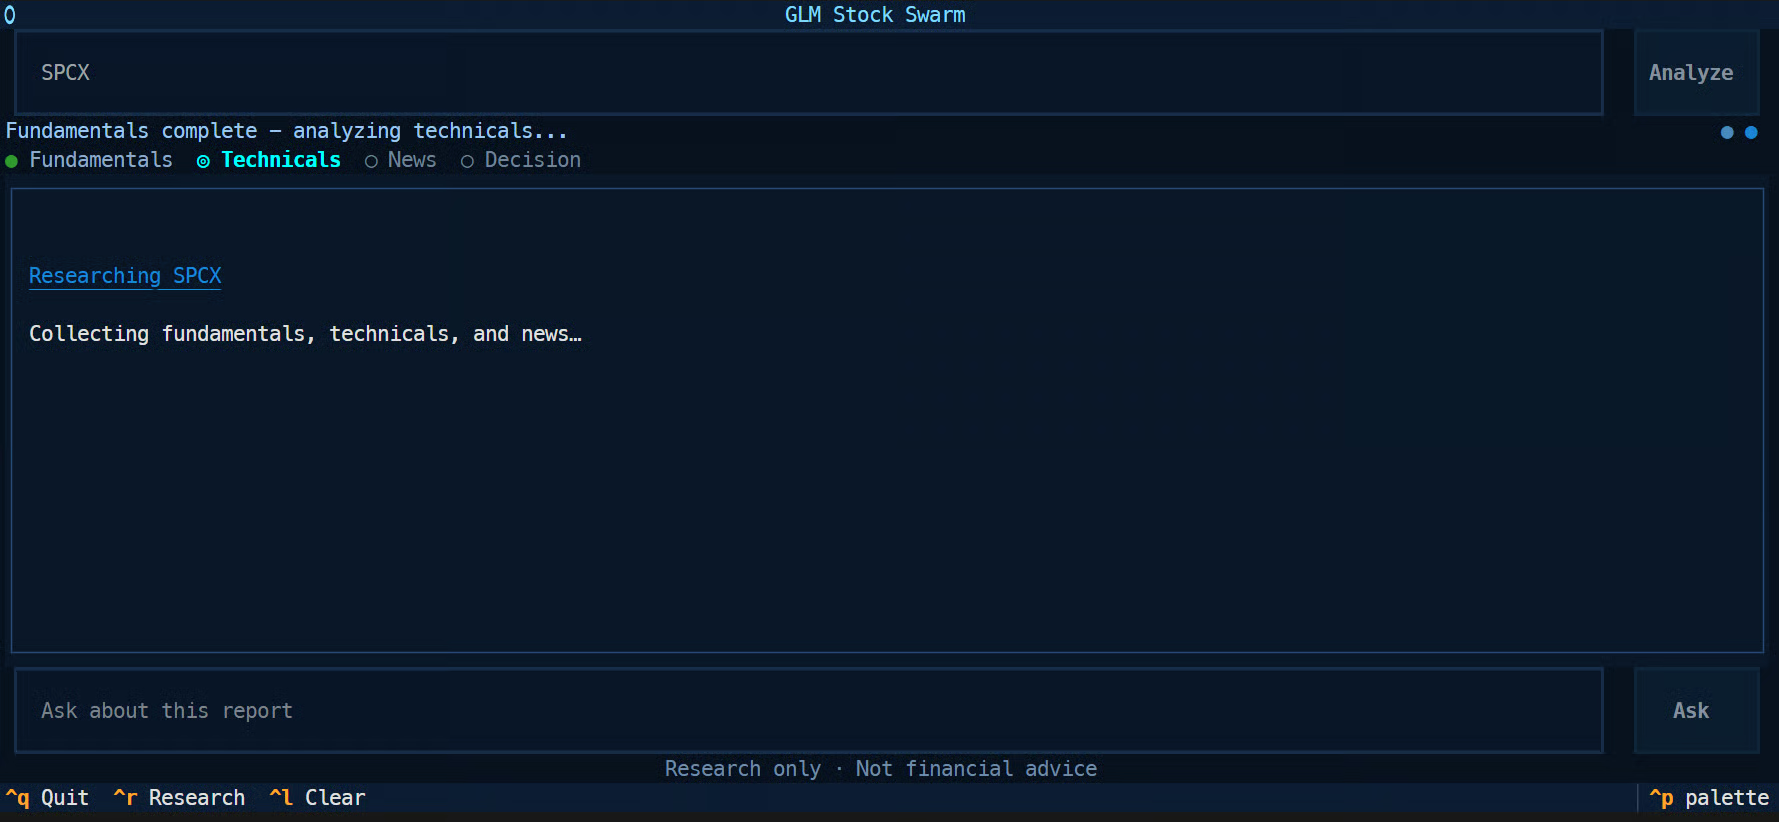
提交代码后,您可以看到智能体依次工作。基本面分析师先开始,接着是技术分析师、新闻分析师,最后由投资组合经理将一切整合为最终决策。
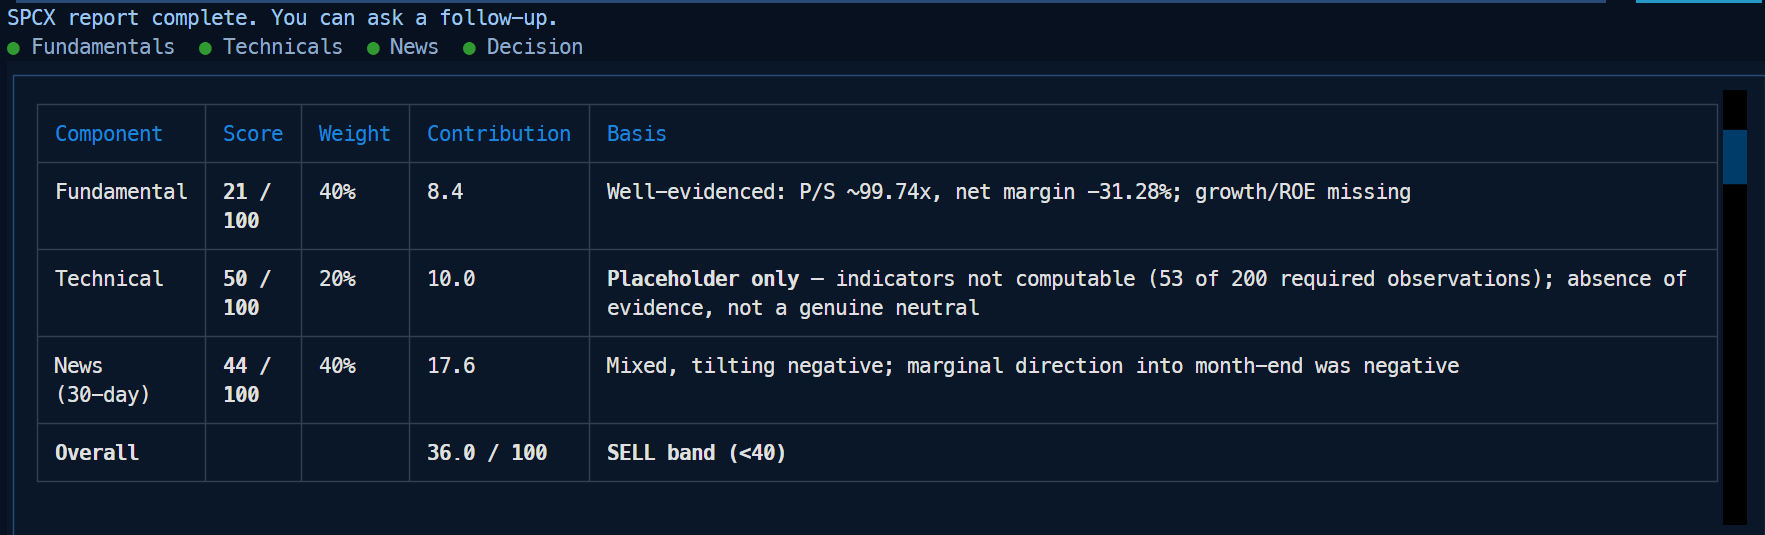
最终,TUI 会直接在终端生成完整报告,包括基本面评分、技术面评分、新闻评分、总体评分、置信度、多头与空头论据、风险、催化因素,以及最终的 BUY、HOLD 或 SELL 信号。
我还加入了后续聊天功能,这样您不必在每次提出新问题时都重跑整个多智能体流水线。
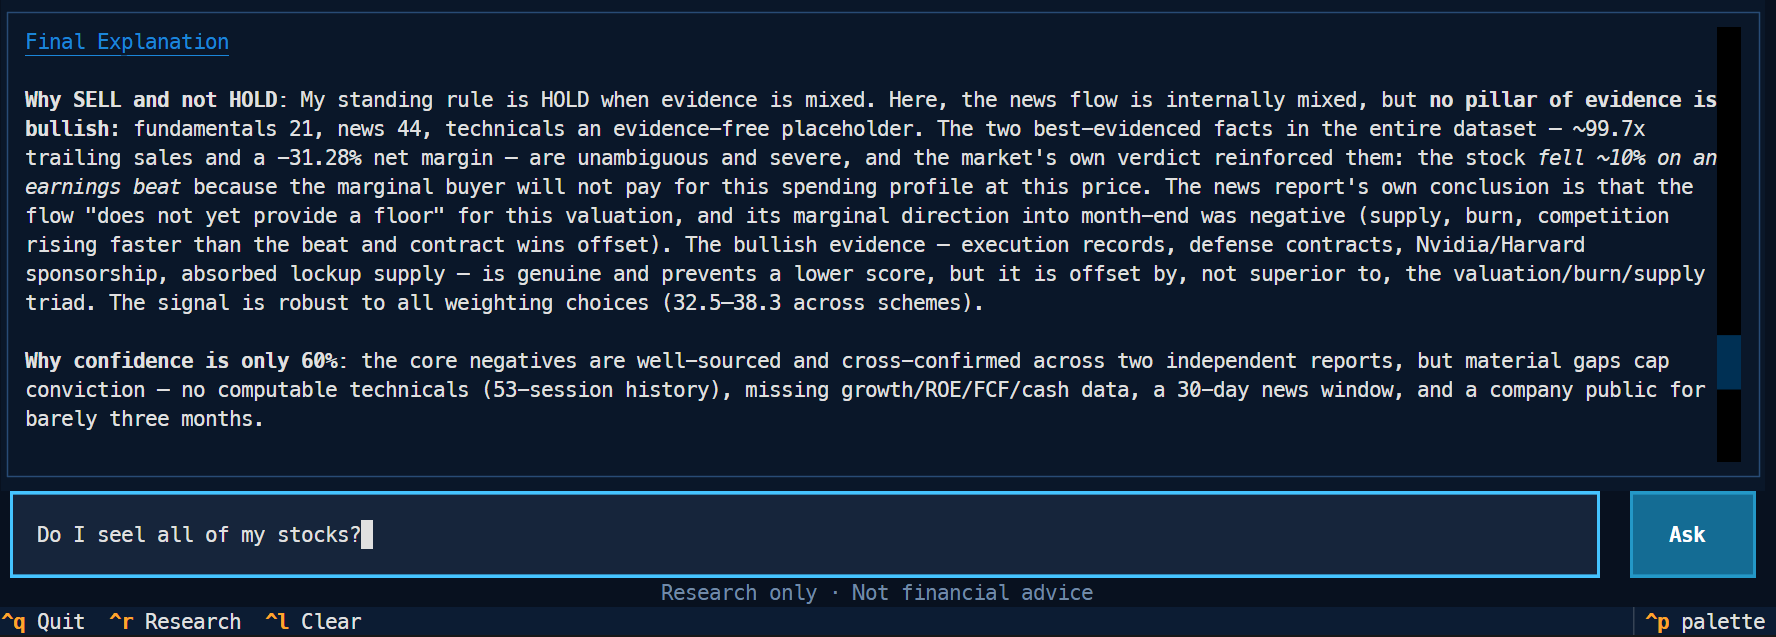
例如,在收到 SELL 建议后,我询问是应当全部卖出还是部分卖出。
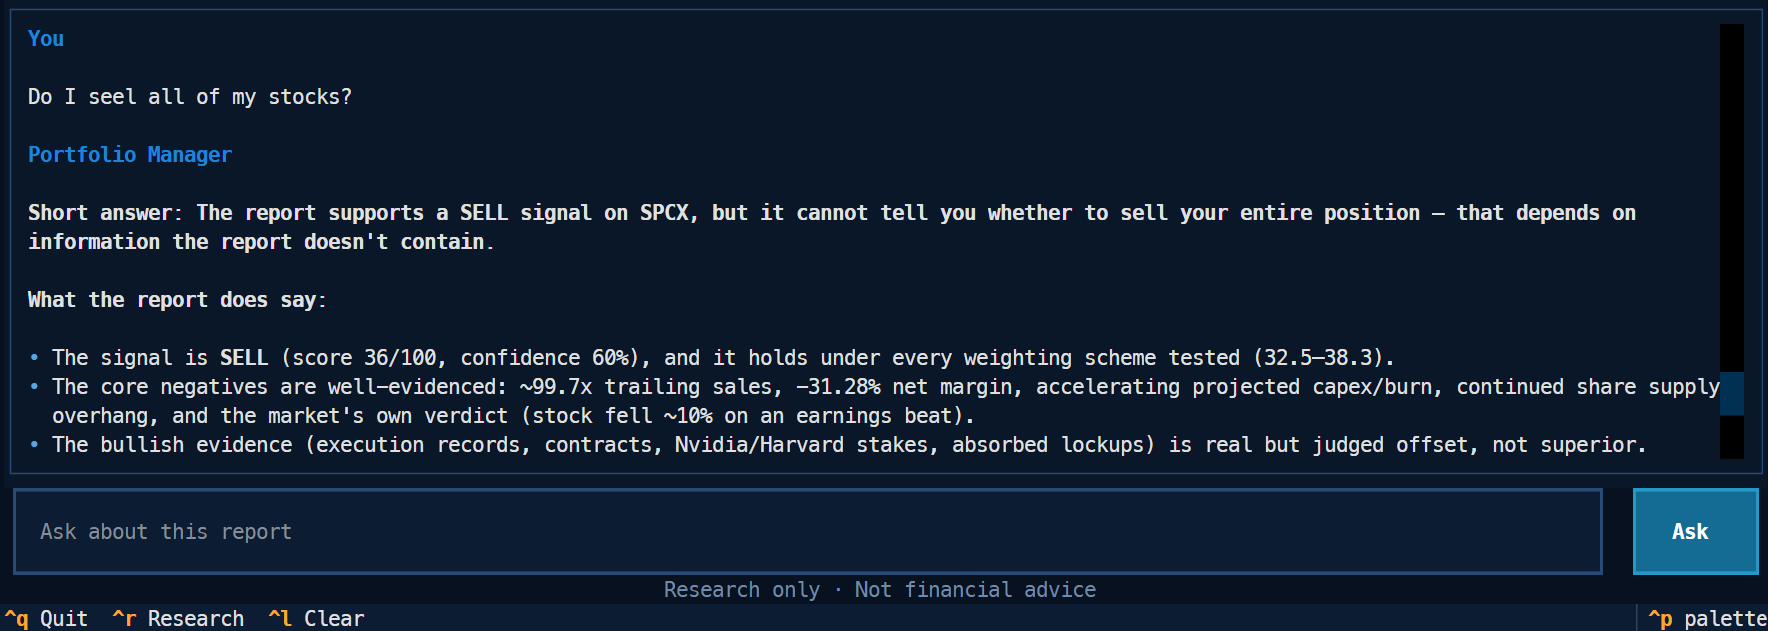
应用不会再次启动四个智能体,而是使用已生成研究报告的上下文,快速返回后续答复。
这使应用更实用:昂贵的多智能体研究只需运行一次,而后续问题可以复用既有分析。
我在测试中值得一提的是工具调用的可靠性。三位专家都正确选择了工具,遵守了 N/A 约定(将缺失数据视为缺失而非零),并按投资组合经理所需的“评分+证据”格式返回结果。这通常是廉价模型容易翻车的地方。
代价是速度。Artificial Analysis 测得 GLM-5.3-Flash 在 Z.ai API 上的输出速率约为每秒 45 个 token,对于同量级的开放权重模型而言偏低,您会在整队运行需 4—5 分钟中感受到。同时它在智能指数上得分 57,对比 GLM-5.3 的 60,您牺牲了一点推理质量,但考虑到价格仅约十分之一,这是不错的权衡。
这些选择并不构成锁定。切换到 OpenRouter、Hugging Face Inference 或通过 Ollama 使用本地模型,通常只需要改三处:API 密钥、模型名称与 base URL。工具方面也类似,yfinance 完全可以替代此处由 Finnhub 与 Yahoo 分担的工作。
我下一步会把它接入纸上交易 API,并安排在早间定时运行。不过请务必使用模拟账户。本项目旨在讲解智能体设计,而非用于交易。
若您希望从零系统掌握智能体式 AI,推荐我们的 AI Agent Fundamentals 技能路径作为良好起点。
在 DataCamp 学习 Agentic AI!
{count, plural, other {学习路径}}
{count, plural, other {课程}}
{count, plural, other {课程}}