
{count, plural, other {课程}}
Claude 模型入门
{hours} 小时
14.8K
Anthropic 于 2026 年 6 月 30 日发布了 Claude Sonnet 5,主打卖点直截了当:这是公司迄今最具“智能体”能力的 Sonnet 模型。它可以制定计划、驱动浏览器与终端等工具,并以接近完全自主的方式运行——这一水平直到最近还只有更大的 Opus 级模型才能达到。
核心结论是,Sonnet 5 在推理、工具使用、编码和知识型工作方面的表现接近 Opus 4.8,且价格更低。在 Anthropic 发布的智能体编码基准上,Sonnet 5 得分为 63.2%,而 Opus 4.8 为 69.2%,Sonnet 4.6 为 58.1%。在某项知识型工作基准上,Sonnet 5 甚至略微领先于 Opus 4.8。
本文将全面介绍 Claude Sonnet 5 的变化,涵盖新功能、基准测试,并看看它的价格。如果您想了解更多 Anthropic 背景,请参阅我们近期的 Claude Code 斜杠命令 指南,以及我们对 Claude Tag 的解读。
Claude Sonnet 5 是 Anthropic 的中端模型,定位于 Opus 系列之下,旨在处理过去需要更昂贵的 Opus 模型才能胜任的智能体型工作。它取代了 2026 年 2 月发布的 Sonnet 4.6,并采用了更新的分词器,改变了模型处理文本的方式。
对许多开发者而言,智能体时代始于 Sonnet 系列模型,如 Claude Sonnet 3.5、3.6 和 3.7——它们是首批在编码与工具使用方面展现出真正实力的 Claude 版本。最近,最明显的智能体进步出现在 Opus 级模型上,而 Sonnet 5 则是 Anthropic 尝试将中端档重新拉近前沿水平的一次发力。
来源:Anthropic
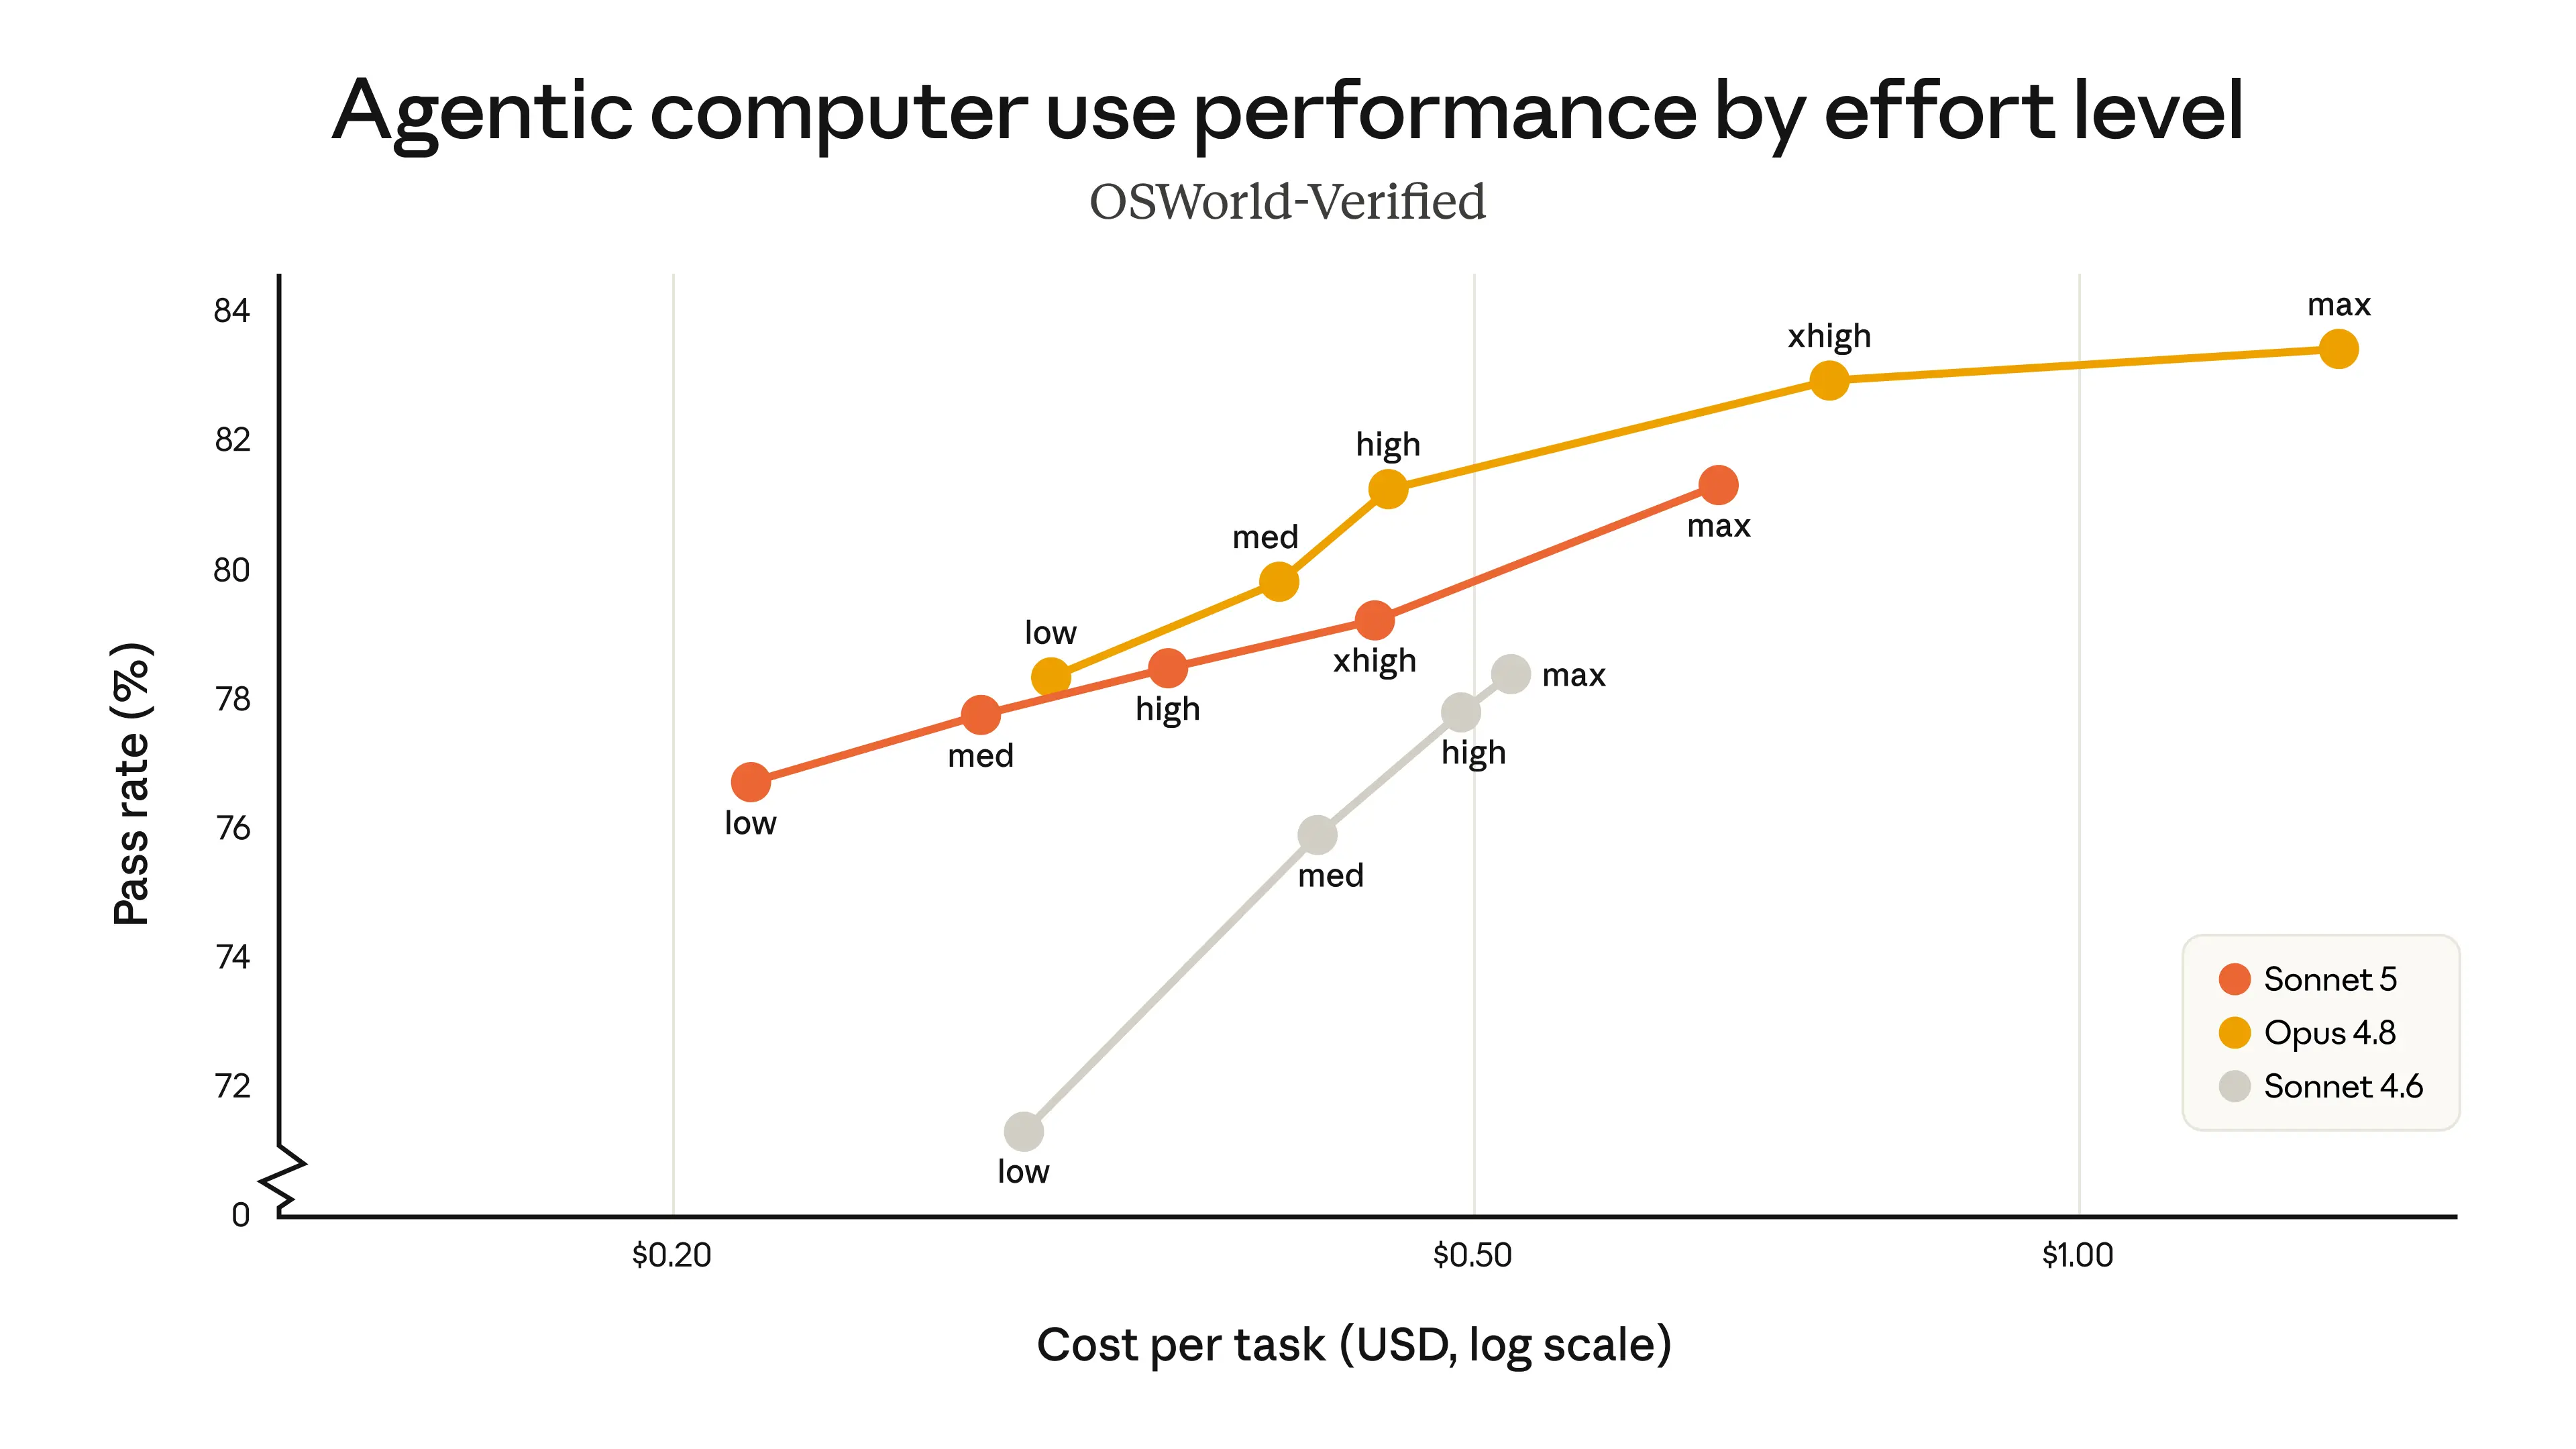
最能说明问题的数字是性价比。Anthropic 自家的图表显示,Sonnet 4.6 在 BrowseComp 智能体搜索与 OSWorld-Verified 电脑使用评测上明显落后于 Opus 4.8。如今 Sonnet 5 与 Opus 4.8 覆盖在同一范围内,Sonnet 5 成本更低,Opus 4.8 则以更高价格提供更高准确度。
Sonnet 5 的改进围绕一个主题聚焦:把智能体任务从头到尾完成,而不是半途而废。以下能力尤为突出。
Sonnet 5 最大的实际变化是任务“跟进到底”。Anthropic 的早期测试者反馈称,该模型能够完成复杂任务,而此前的 Sonnet 版本往往会在中途停下,并且它会自主检查自己的输出,无需提醒。
把它代入您的工作场景:比如交给模型一个跨两个系统的任务——先从 CI 运行中提取失败的测试结果,然后提交带修复的 Pull Request。早期的 Sonnet 模型通常会在第一步后停下。Anthropic 自身的示例是一次性完成 Salesforce 账户分级更新并向企业联系人发送发布通知——Zapier 的一位工程师表示这种流程过去会在半程卡住。
对于任何在构建智能体的人而言,这就是“会起草计划”的模型与“会执行计划”的模型之间的差别。它减少了人类需要介入、推动智能体继续前进的次数。
Sonnet 5 支持可调节的投入强度,您可以根据任务与预算上下调节推理深度。Anthropic 将其定位为在 Sonnet 5 与 Opus 4.8 之间寻找合适落点的方式,而不是选定一个模型后将就使用。
在最高的 Extra High 推理级别下,Sonnet 5 在 OSWorld-Verified 与 BrowseComp 上的大致表现与 Opus 4.8 的中高设置相当。需要注意的是,将 Sonnet 5 运行在该级别的成本可能高于以相近推理设置运行 Opus 4.8,因此在某些高准确度任务中,Opus 4.8 仍是更优之选。
如果您已经在使用 Claude Code,那么投入强度并不陌生。我们在 Claude Code 斜杠命令教程 中介绍了 /effort 命令及其各级别。
与 Sonnet 4.6 相比,Sonnet 5 在安全性方面有可量化的提升,这对于智能体接触真实系统时尤为重要。Anthropic 在部署前的评估发现,它更善于拒绝恶意请求,并在提示注入攻击中更能抵抗劫持。
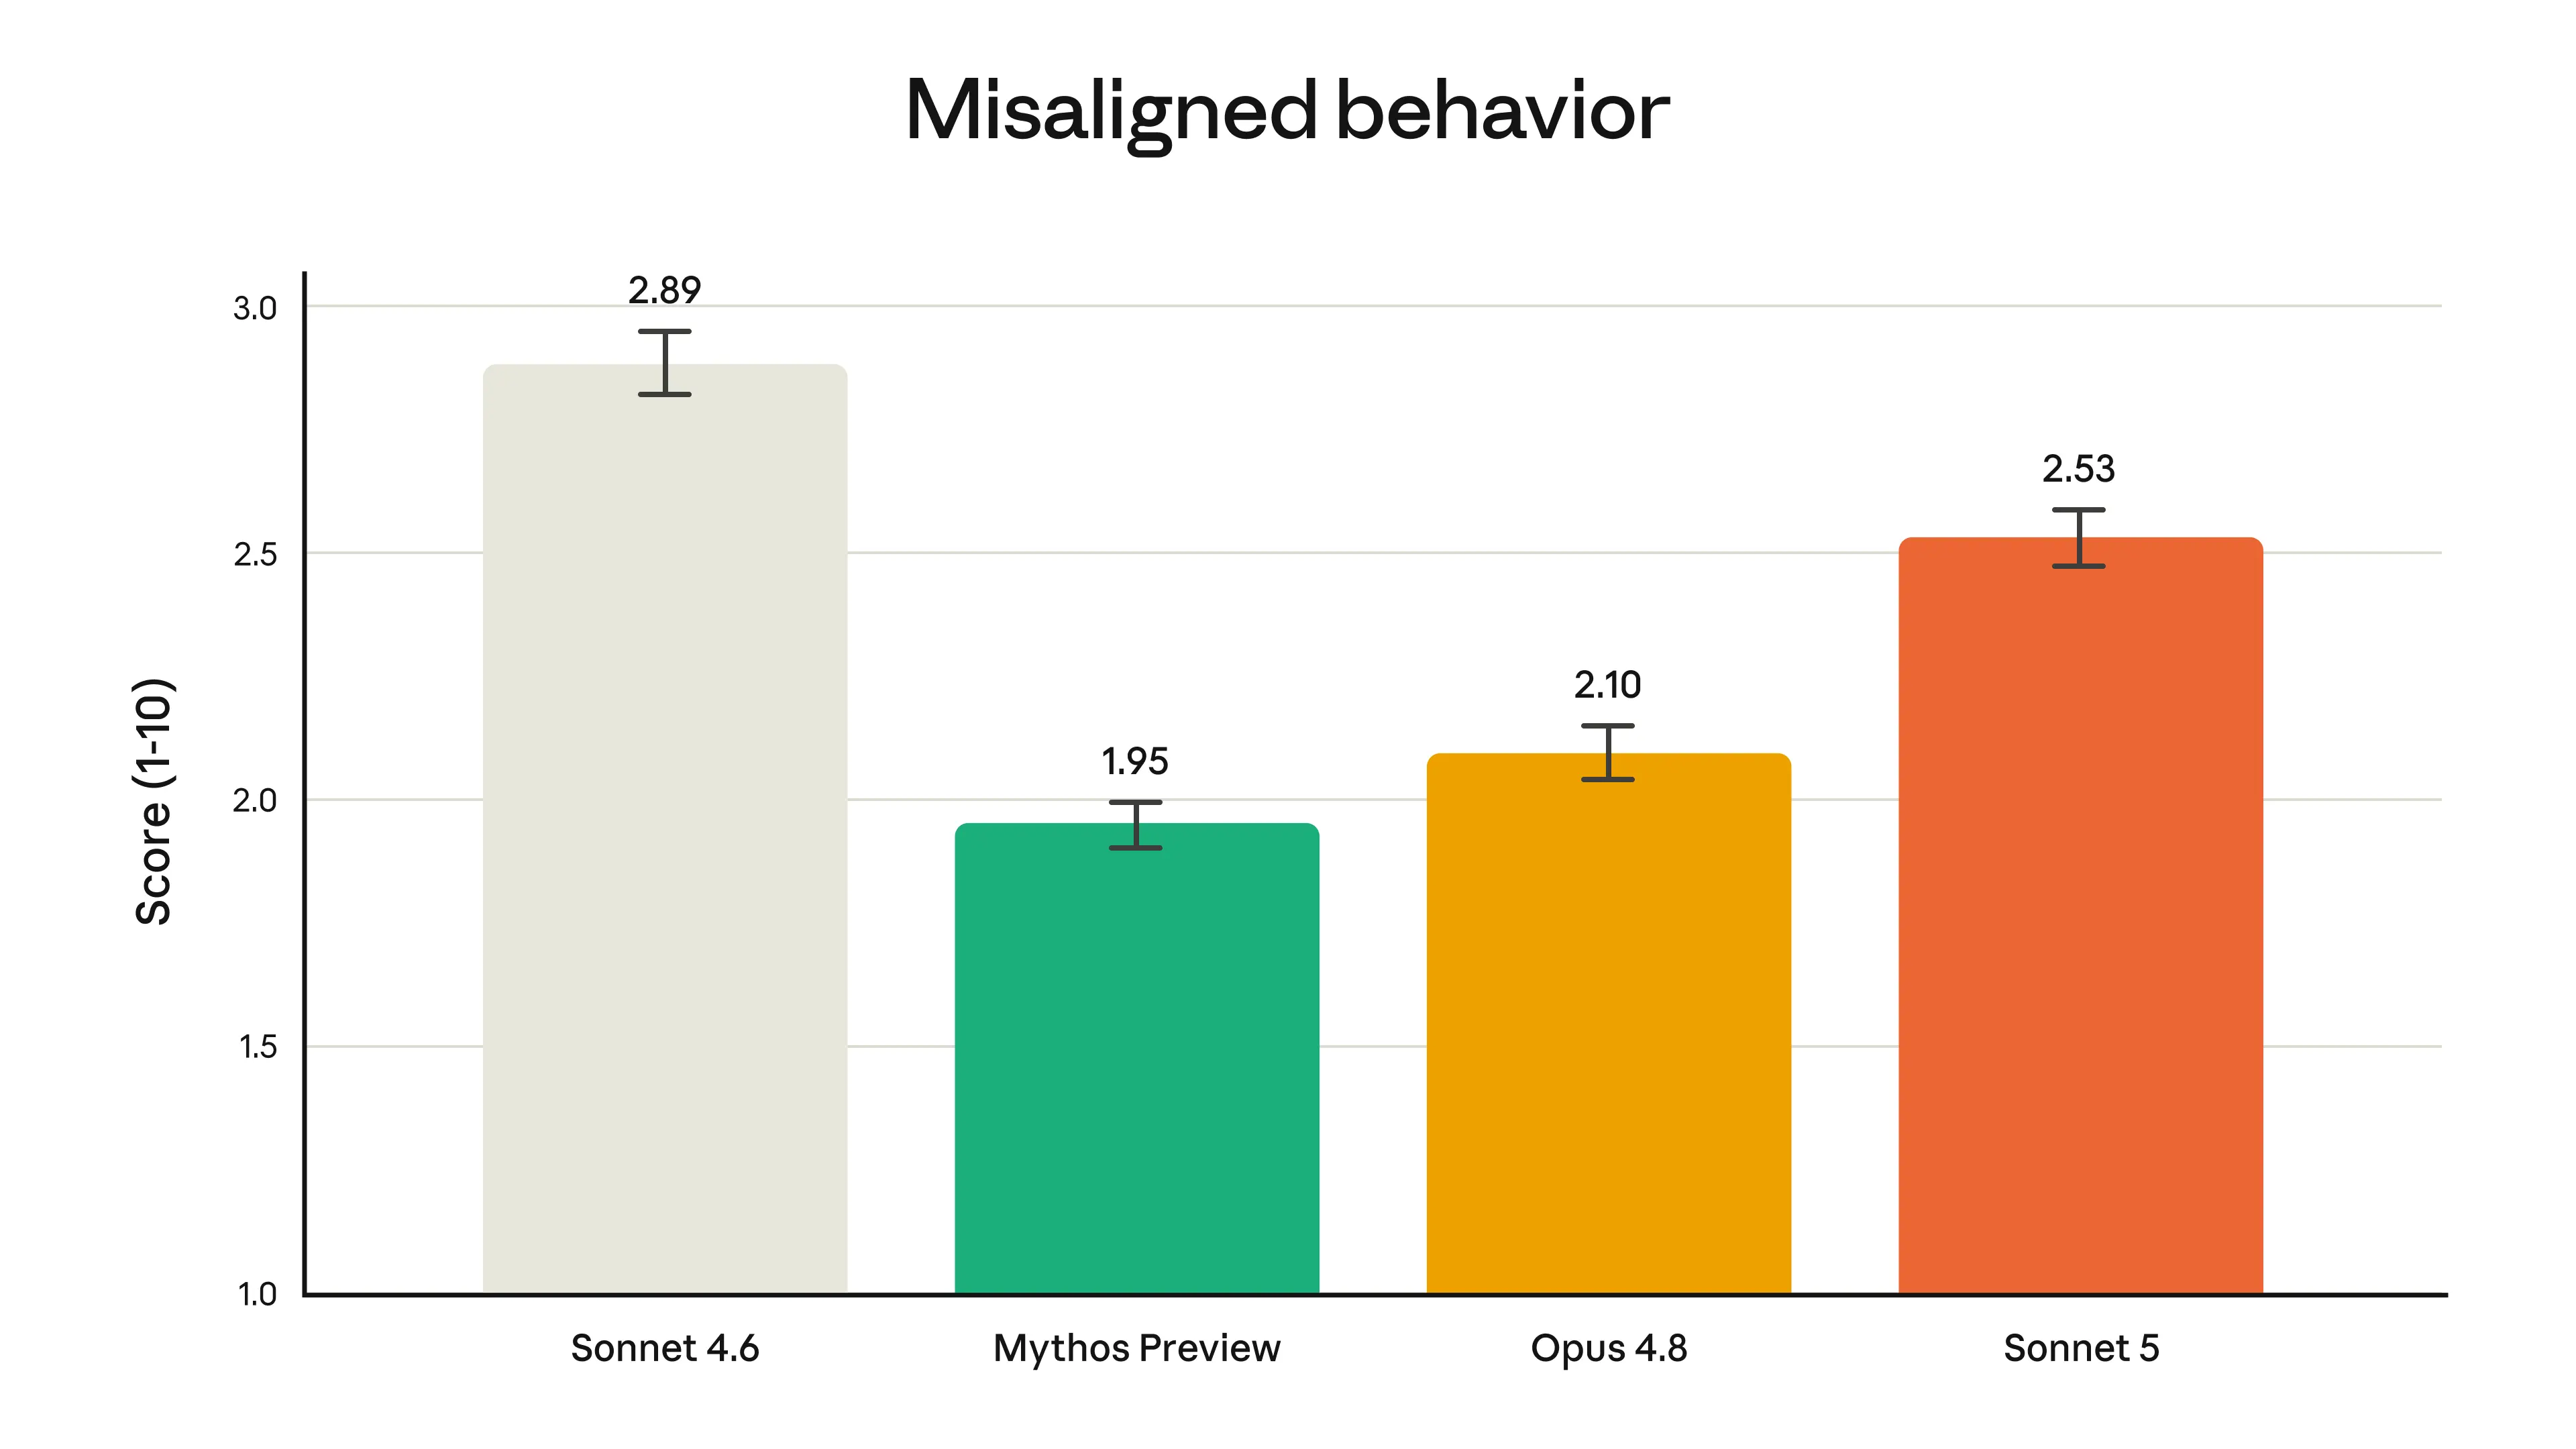
该模型的幻觉与迎合倾向也低于 Sonnet 4.6,并在 Anthropic 的自动化行为审计中拿到更低(更安全)的分数,该审计涵盖与误用协作、欺骗等不对齐行为。Lovable 的联合创始人给出的评价很直白:一个“知道何时说不”的模型,与一个“知道如何构建”的模型同样重要。
但需要说明的是,与更强大的 Opus 4.8 和 Claude Mythos 预览版相比,Sonnet 5 的不对齐行为仍更高一些,因此它比前代更安全,但并非 Anthropic 产品线中最安全的模型。
来源:Anthropic
Sonnet 5 上线时默认开启实时网络安全防护,与 Claude Opus 4.7 和 4.8 所采用的相同机制。这些防护可在危险的网络安全使用发生时实时检测并阻断。
在 Anthropic 的评估中,Sonnet 5 的危险网络攻防能力显著弱于 Opus 4.8 和 Mythos 5。在与 Mozilla 合作的测试中,目标是在 Firefox 147 的漏洞上开发利用程序;Sonnet 5 和 Sonnet 4.6 都未曾生成可用的利用(两者得分均为 0.0%),尽管 Sonnet 5 的部分成功率略高。Anthropic 将其归因于通用智能提升而非网络攻防训练。
对于需要降低护栏的安全研究者,Anthropic 建议改用 Opus 4.8。Sonnet 5 的防护不像 Fable 5 那样严格,后者会阻断更广泛的网络安全任务。
Anthropic 对 Sonnet 5 的基准叙述前后一致:与 Sonnet 4.6 相比是严格提升,并在目前发布的评测中略低于 Opus 4.8。以下数据来自 Anthropic 的发布资料。需谨慎的是:第三方评测者在相同基准上报告了不同数字,可能源于数据集、上下文设置或智能体脚手架的差异,因此请将这些“标题数字”视为依赖配置的结果。
| Sonnet 5 | Sonnet 4.6 | Opus 4.8 参考 |
|
|---|---|---|---|
| 智能体编码 SWE-bench Pro |
63.2% | 58.1% | 69.2% |
| 智能体编码 Terminal-Bench 2.1 |
80.4% | 67.0% | 82.7% |
| 跨学科推理 Humanity's Last Exam |
43.2% 无工具 57.4% 有工具 |
34.6% 无工具 46.8% 有工具 |
49.8% 无工具 57.9% 有工具 |
| 电脑使用 OSWorld-Verified |
81.2% | 78.5% | 83.4% |
| 知识型工作 GDPval-AA v2 |
1618 | 1395 | 1615 |
在 Anthropic 发布的智能体编码基准上,Sonnet 5 得分 63.2%,而 Opus 4.8 为 69.2%,Sonnet 4.6 为 58.1%。该基准衡量的是模型能否跨多个步骤编写、运行并修复代码,而非只产出单段代码。
与 Opus 4.8 的差距约 6 分,超越 Sonnet 4.6 约 5 分。对开发者而言,这意味着 Sonnet 5 明显优于上一代中端模型,但仍未完全追平旗舰。
来源:Anthropic
OSWorld-Verified 衡量电脑使用能力,即控制桌面完成真实任务;BrowseComp 衡量智能体式的网页搜索。Anthropic 更新了 OSWorld-Verified 的方法,并在修订后的设置下将 Sonnet 4.6 报告为 78.5%。
在两项评测中,Sonnet 5 在各投入强度下都较 Sonnet 4.6 有明确提升,而 Opus 4.8 仍是准确度更高的选择。在 Extra High 投入下,Sonnet 5 大致达到 Opus 4.8 的中高性能;但此时成本优势收窄,这也是 Anthropic 将两款模型定位为一个“成本—准确度”区间而非线性升级的原因。
据 TechCrunch 报道,在一项知识型工作基准上,Sonnet 5 略微优于 Opus 4.8。这一点值得注意,因为 Opus 4.8 通常与最难的判断与深度研究相关联。
Anthropic 还更新了对 Humanity's Last Exam 的评分器,并将 Sonnet 4.6 报告为 34.6%(无工具)与 46.8%(有工具),这也是为何这些数字与 Sonnet 4.6 最初发布时不同。对从业者而言,知识型工作的结果表明,Sonnet 5 适用于此前更像是 Opus 领域的分析与研究任务。
若想更广泛了解 Sonnet 阶梯所在位置,我们对 Sakana Fugu vs Claude Fable 5 的报道很有参考价值。在那次对比中,更高阶的 Claude Fable 5 在 SWE-Bench Pro 上得分 80.3%,在 Humanity's Last Exam(无工具)上得分 59.0%,明显高于本文中的中端数据。
这种差距正是产品线设计的要点。Anthropic 的阵列从具备智能体能力、成本更低的 Sonnet 5,一直到 Opus 4.8、以及 Mythos 和 Fable 系列,每一阶都以更高成本换取在最难问题上的更高准确度。
Claude Sonnet 5 自发布日起即在全球可用。它是免费版与专业版的默认模型,并向 Max、团队版与企业版用户,以及 Claude Code 与 Claude Platform 提供。
开发者可通过 Claude API 使用模型 ID claude-sonnet-5 调用。定价分两个阶段:
预算需留意的一点:Sonnet 5 采用了更新的分词器,相同输入可能会映射为更多 Token,具体约为 1.0 至 1.35 倍,取决于内容类型。Anthropic 设置的优惠期定价,旨在让从 Sonnet 4.6 过渡时总体成本大致持平。公司还提高了 Chat、Cowork、Claude Code 与 Claude Platform 的速率限制,以应对更高投入强度带来的 Token 使用增幅。
如果您想快速对比,以下是三款模型在 Anthropic 发布数据上的对齐情况。
| 模型 | 智能体编码 | OSWorld-Verified | 输入 / 输出价格(每 100 万 Token) |
|---|---|---|---|
| Sonnet 5 | 63.2% | 在各投入强度下均优于 4.6 | $2 / $10(优惠期),之后 $3 / $15 |
| Sonnet 4.6 | 58.1% | 78.5%(修订) | $3 / $15 |
| Opus 4.8 | 69.2% | 更高准确度的选择 | $5 / $25 |
Sonnet 5 明确传递了一个信号:在所有价位层级,智能体能力已成为基线,不再是旗舰独享。差异化不再是“谁能把智能体做得最好”,而是“谁能在无需人工监管的前提下,以更低成本、更高可靠性完成智能体工作”。
我觉得最有意思的是优惠期定价。Anthropic 似乎希望客户在迁移窗口以尽可能低的成本,用真实负载测试 Sonnet 5——这看起来像是一种有意推动,把常规智能体工作从 Opus 4.8 上迁走、腾出产能。同时,它在价格上也压过了 OpenAI 的 GPT-5.5 和 Google 的 Gemini 3.1 Pro,尽管 Gemini 3.5 Flash 依然更便宜。
如果您在构建可持续运行的多步智能体任务,Sonnet 5 看起来是新的默认首选;只有在任务确实需要更高准确度时,才上探到 Opus 4.8。需要坦率说明的是,一些第三方评测认为,Sonnet 5 在推理深度与编码速度之间做了取舍,因此对于博士级科学推理或重度浏览类任务,Opus 4.8 可能仍更稳妥。
如果您想亲手体验 Sonnet 5 所针对的自动化场景,推荐我们的 Claude Code Routines 教程,带您在云端按计划运行一个编码智能体。
Top DataCamp Courses
{count, plural, other {课程}}
{count, plural, other {课程}}
{count, plural, other {课程}}