{count, plural, other {课程}}
Python 金融入门
{hours} 小时
107.9K
多数股票 API 对比从一开始就跑偏了。
它们比较的是价格层级、端点数量、文档页数和免费套餐限制。这些细节固然重要,但并不能告诉您该 API 能否支撑您正在构建的系统。
回测失败,并不是因为某家供应商的端点比竞争对手少;失败的原因在于历史价格未正确调整、数据历史过短,或公司行为处理不当。
仪表盘的失败模式则不同。当行情响应变慢、字段意外变化,或当用户开始频繁刷新页面时限流成为问题,仪表盘就会崩。
这就是我将通用“最佳股票 API”榜单仅视作起点而非答案的原因。真正的问题是:“当我的项目不再是原型时,这个 API 还能正常工作吗?”
一旦 API 驱动真实的工作流,它就变成了数据基础设施:
后期切换会很痛苦,因为您不只是更改一个请求 URL。您可能需要重写流水线、刷新作业、更新存储逻辑、调整模型输入,甚至修改部分用户界面。
2024 年的 IEX Cloud 停运是一个有益的提醒。许多开发者和公司围绕其 API 构建了仪表盘、应用和内部工具。一旦服务终止,迁移就意味着重思端点、字段、定价、许可与数据假设。
在比较供应商之前,先明确 API 将支撑哪种工作流。回测器与仪表盘可能都使用股价,但它们所依赖的数据要求并不相同。
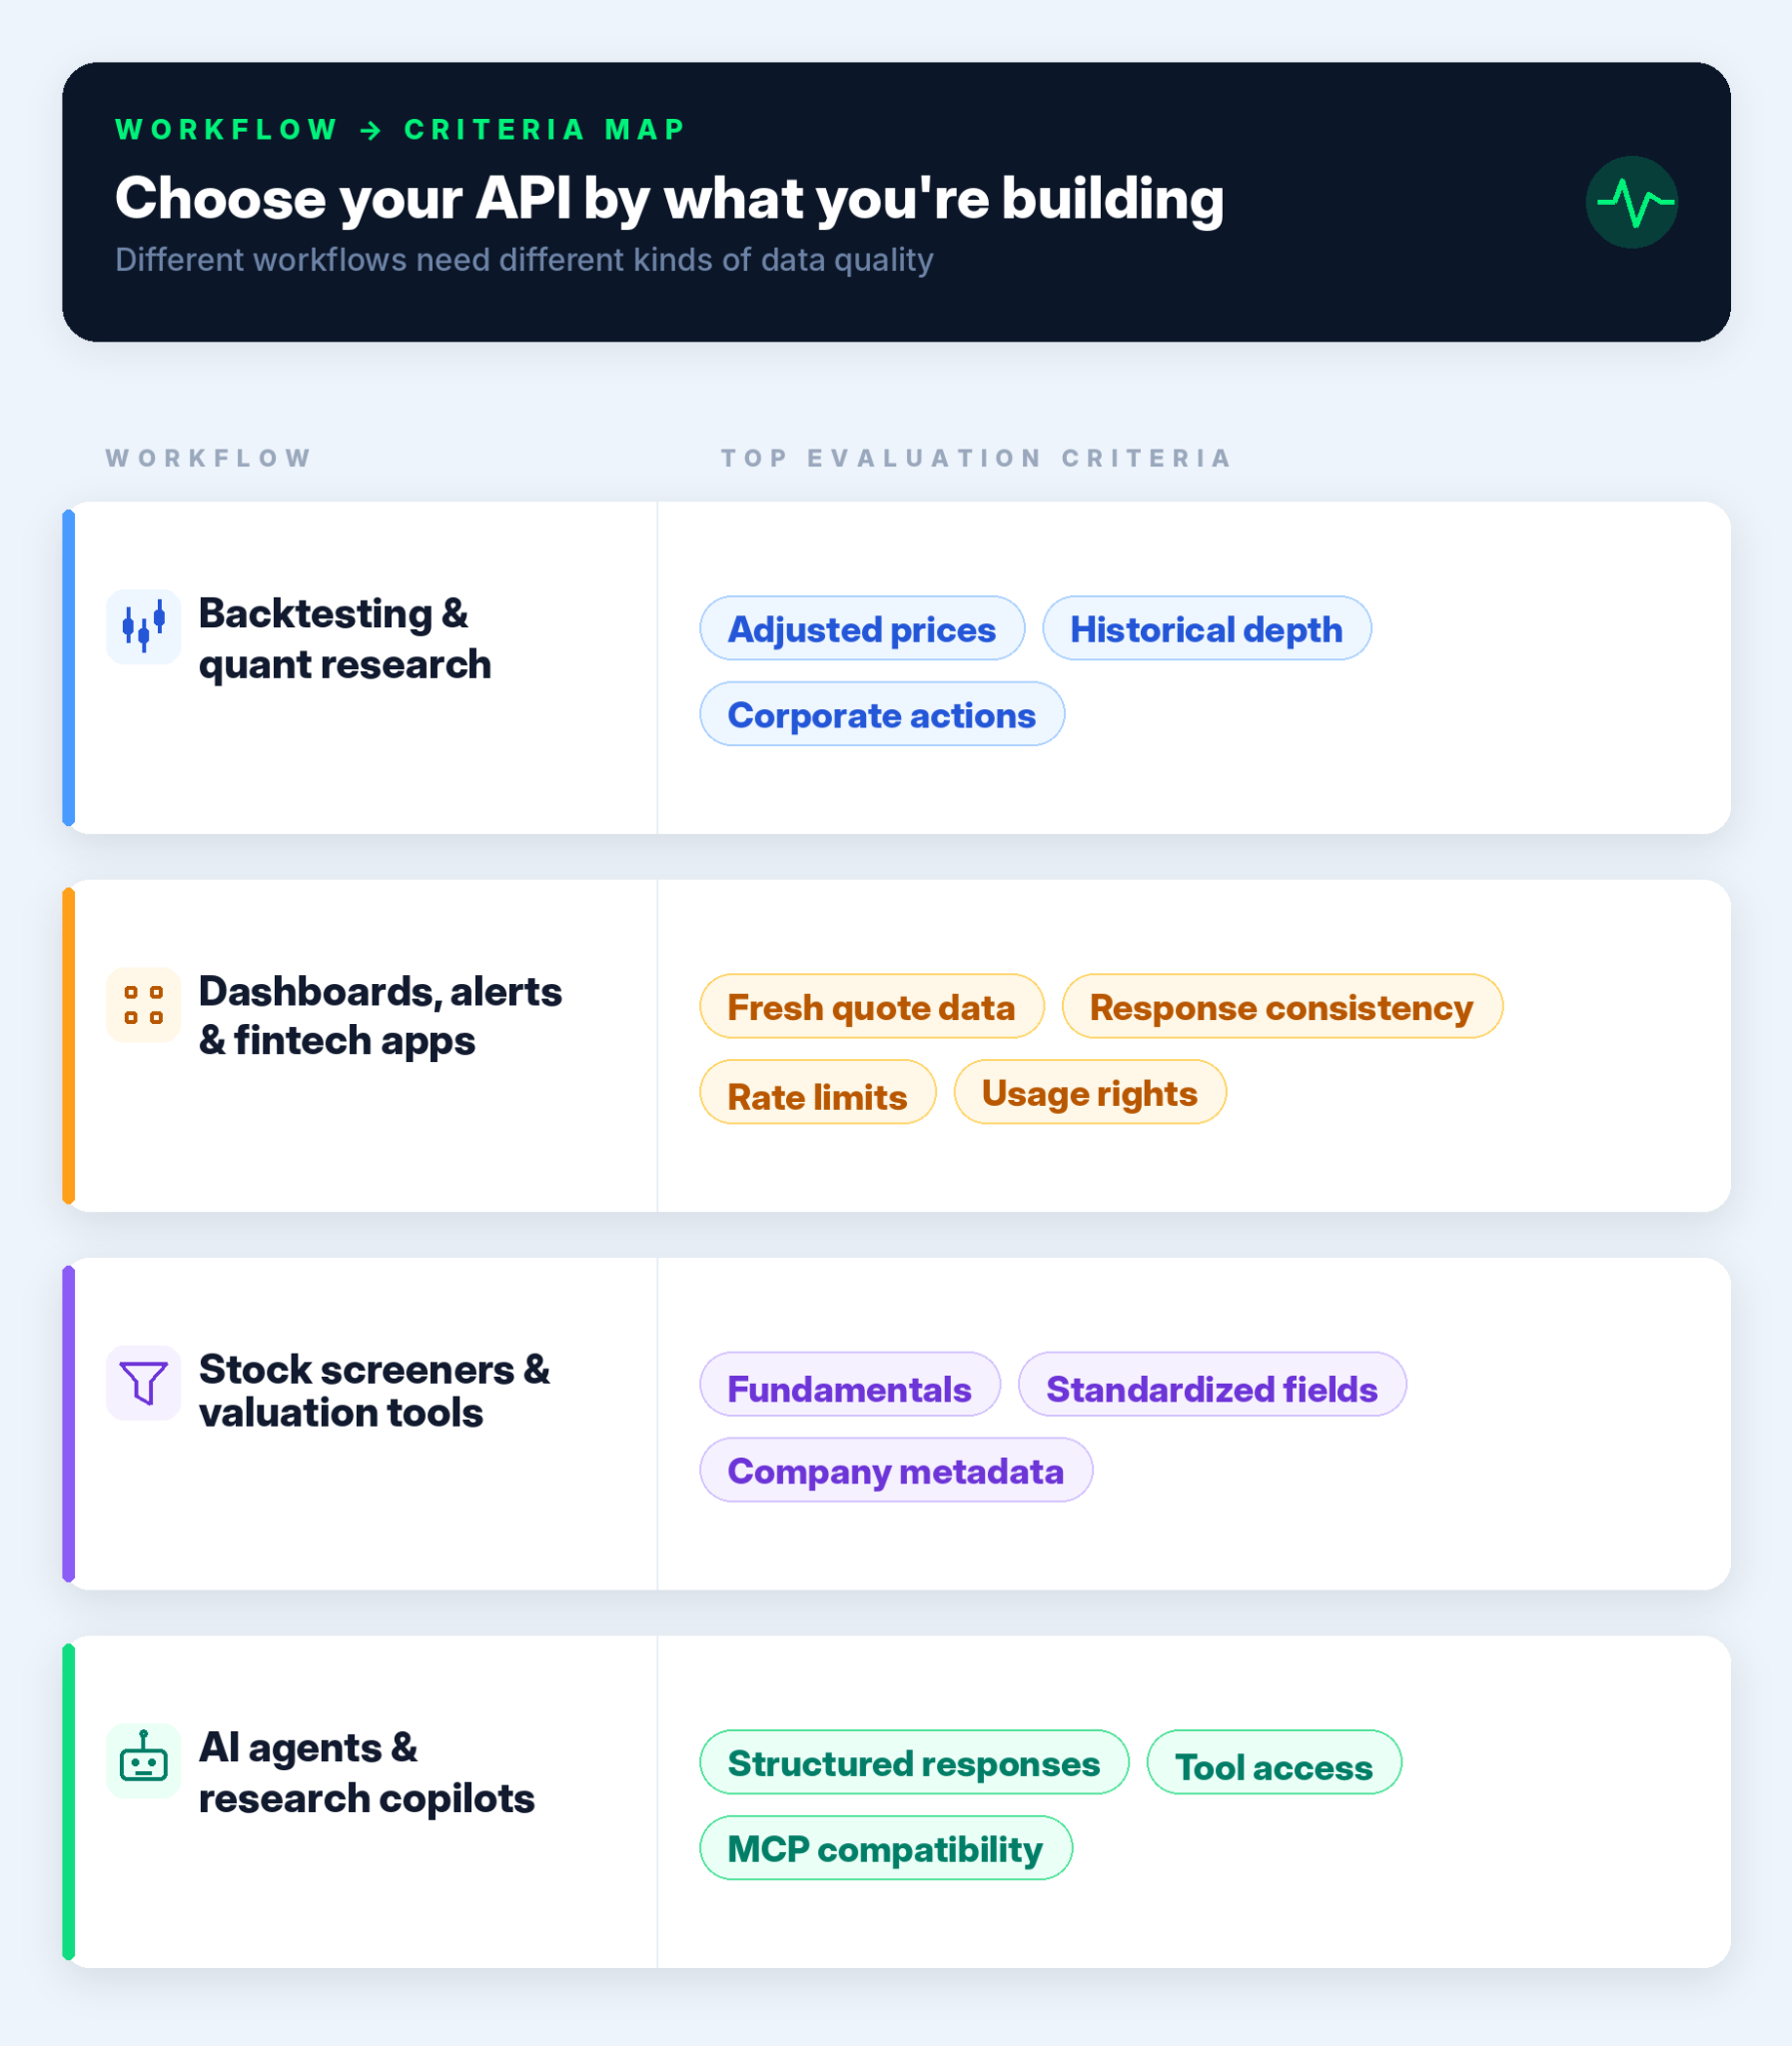
对回测而言,干净的历史数据通常比实时数据更重要。
需要检查的关键标准:
想更深入了解在 Python 中实现和测试交易策略,请参阅我们的Python 量化交易教程,里面更详尽地介绍了回测概念与陷阱。
仪表盘和告警系统更重视新鲜度、可靠性与一致性。私有笔记本可以容忍一次失败的请求或不规范的字段名,但面向用户的产品不行。
需要检查的关键标准:
筛选器与估值工具需要商业数据,而不仅是价格。主要挑战在于比较,因为您通常需要同时筛选或排序许多公司。
需要检查的关键标准:
AI 工作流需要返回结构化、可预测数据的 API。LLM 可以总结文本,但不应猜测金融数据。
需要检查的关键标准:
要把 API 数据变成可用的代理,我们的模型上下文协议(MCP)指南介绍了 MCP 如何把 AI 模型连接到外部工具;而构建 LangChain 代理与OpenAI Agents SDK教程展示了如何在 Python 中将其落地。
一旦明确工作流,比较 API 就容易多了。您不再问“哪家功能最多?”,而是问,“哪家能支撑这个项目所需的数据层?”
|
评估项 |
检查要点 |
重要原因 |
|
数据覆盖 |
资产类别、市场、标的与地域 |
API 应覆盖项目实际需要的范围 |
|
历史深度 |
历史长度、是否可取全量历史、经调整与未调整数据 |
回测与研究工具需要的不只是近期数据 |
|
数据质量与公司行为 |
拆股、分红、代码变更、缺失行与失效标的 |
错误的调整会扭曲图表、收益与模型输出 |
|
基本面支持 |
财务报表、财报、比率、公司概况与元数据 |
筛选器与估值工具需要商业语境,而非仅有价格 |
|
许可与再分发 |
展示权、存储权、商业用途与交易所规则 |
笔记本用例不同于公开或付费产品 |
|
开发者体验 |
文档、响应格式、错误、限流与 Python 可用性 |
干净的 API 在首个请求之后更省时 |
|
AI 与代理就绪度 |
结构化响应、工具访问、MCP 支持与可预测的模式 |
AI 助手需要能检索、解析并推理的数据 |
覆盖应匹配项目,而非营销页面。
检查:
常见错误是选择覆盖宣称最大的供应商,而不是能覆盖您实际查询范围的那一家。
当项目需要跨不同市场环境测试想法时,历史深度就很重要。
检查:
“我们提供历史价格”与“这份数据足以做严肃的测试”之间有本质区别。
这正是股票数据令人头疼的地方。
检查:
要处理金融数据更“糟糕”的一面(如缺失值、字段不一致与格式问题),Python 中的数据导入与清洗学习路径涵盖了 API 调用打通后所需的核心技术。
当项目需要商业语境而非仅仅价格波动时,基本面就很关键。
检查:
关键词是“一致性”。如果您在比较公司,字段应可在整个股票池中通用,而无需为每个代码写自定义逻辑。
许可在阻碍产品之前看起来都很无聊。
检查:
我宁可在写流水线之前就发现这些限制,而不是在前端都搭好之后。
干净的 API 在首个请求之后更省时。
检查:
第一次调用成功不是真正的考验。真正的考验是:当您加入刷新任务、错误处理并与其他数据集合并之后,这个 API 仍然是否够干净。
AI 工作流需要可预测的数据访问。
检查:
API 不必对每个用例都“AI 原生”。但如果您在构建金融研究助手,数据层应同时便于 Python 代码与 AI 工具使用。
我们的Codex CLI MCP 教程在金融语境中展示了一个具体例子:通过 MCP 工作流,使用 Alpha Vantage 数据构建实时投资组合仪表盘代理。
上述标准很有用,但我不会仅凭清单来选供应商。我会针对项目相关的失败模式来测试 API。
在下面的示例中,我将使用Alpha Vantage,因为它在一个地方就提供了历史价格、实时行情、基本面、技术指标与 AI 工作流选项。目标是检查 API 能否在不制造过度清洗工作的情况下满足真实项目需求。
对回测器而言,这是我会首先运行的检查之一。如果价格序列无法干净地处理拆股,那么基于它的每一项收益计算都值得怀疑。
下面的代码抓取特斯拉在 2022 年拆股前后的日度经调整价格,并比较原始收益与调整后收益。
import requests
import pandas as pd
import time
api_key = 'YOUR ALPHA VANTAGE API KEY'
url = f'https://www.alphavantage.co/query?function=TIME_SERIES_DAILY_ADJUSTED&symbol=TSLA&outputsize=full&apikey={api_key}'
response = requests.get(url)
data = response.json()
tsla = pd.DataFrame(data['Time Series (Daily)']).T
tsla.index = pd.to_datetime(tsla.index)
tsla = tsla.sort_index()
tsla = tsla.rename(columns={
    '4. close': 'close',
    '5. adjusted close': 'adjusted_close',
    '7. dividend amount': 'dividend',
    '8. split coefficient': 'split'
})
cols = ['close', 'adjusted_close', 'dividend', 'split']
tsla[cols] = tsla[cols].astype(float)
tsla['raw_return'] = tsla['close'].pct_change()
tsla['adjusted_return'] = tsla['adjusted_close'].pct_change()
tsla.loc['2022-08-22':'2022-08-31', ['close', 'adjusted_close', 'split', 'raw_return', 'adjusted_return']]
输出如下:
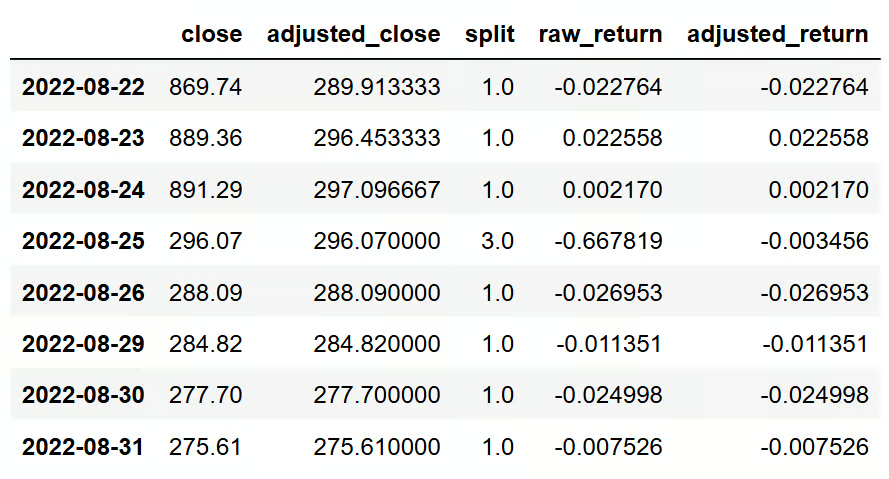
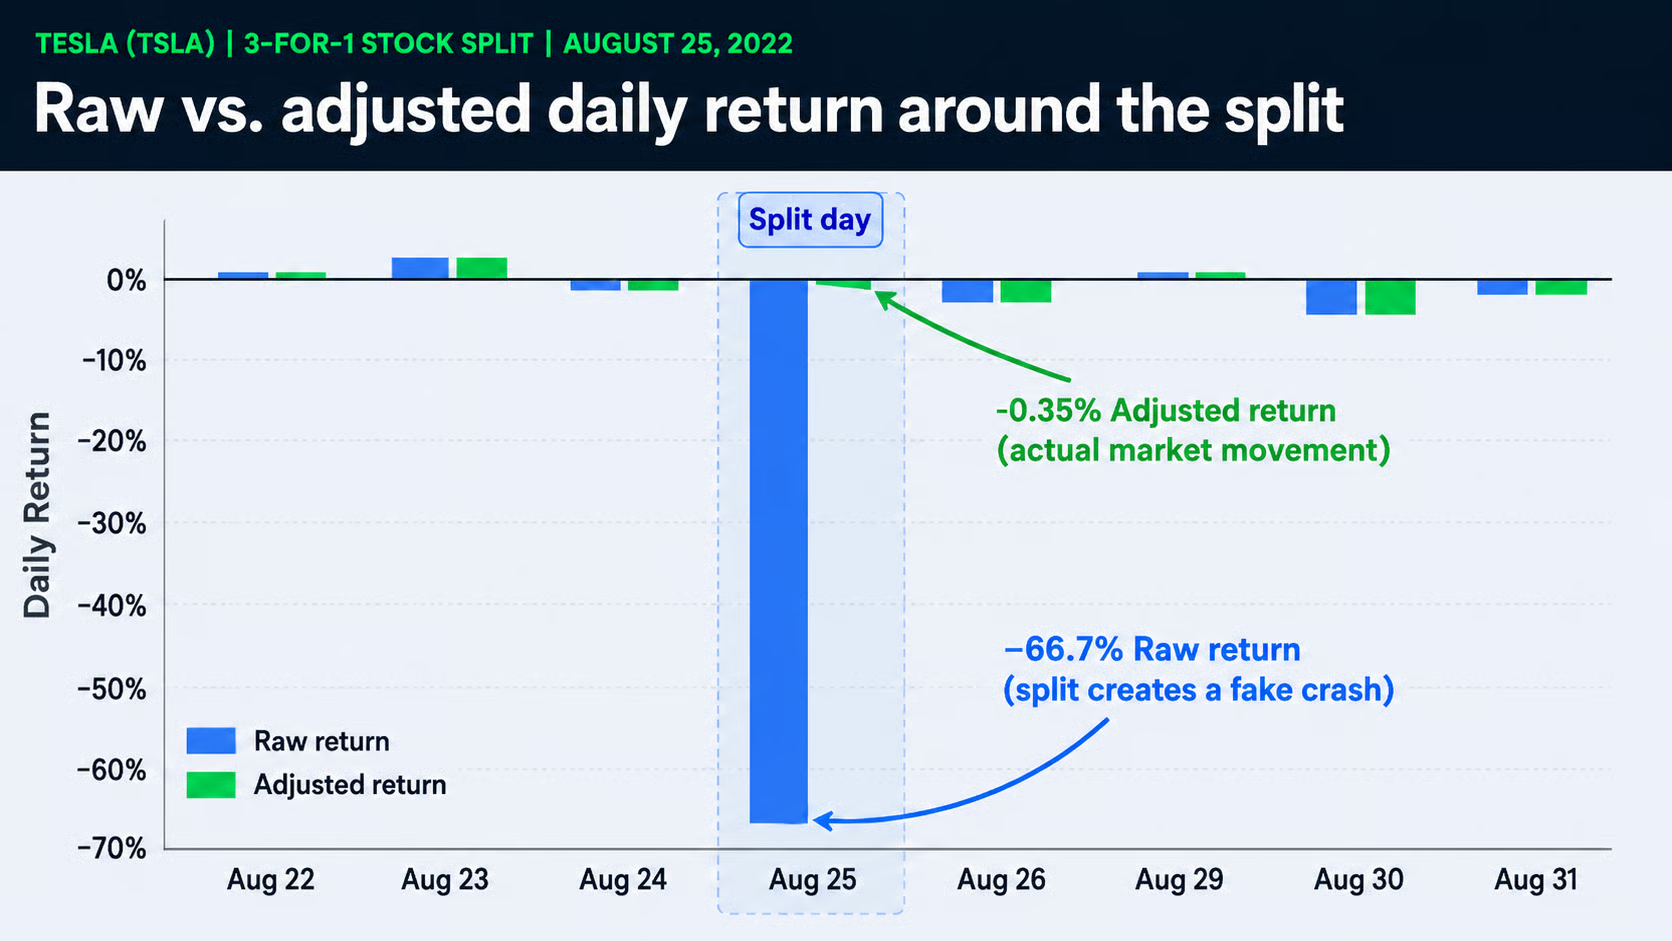
这正是经调整数据重要的原因。
原始收盘价显示 2022 年 8 月 25 日出现了66.7%的暴跌。那并不是真实的崩盘,而是特斯拉 3 拆 1 的拆股在原始价格序列中的体现。
同一天的调整后收益仅约-0.35%,在考虑拆股后更接近实际市场波动。
这个小检查能告诉您 API 是否提供了捕捉常见回测问题所需的字段。长长的功能清单无法告诉您这一点。
仪表盘或告警系统不仅需要数据,更需要能明确失败的请求。
下面的辅助函数加入了简单的重试模式,并检查常见的 API 响应问题。它不是生产级基础设施,但足以测试当问题发生时 API 是否表现可预测。
def get_json(url, retries=3, wait=10):
    for i in range(retries):
        try:
            response = requests.get(url, timeout=20)
            data = response.json()
            if 'Error Message' in data:
                raise ValueError(data['Error Message'])
            if 'Note' in data:
                print('API note:', data['Note'])
                time.sleep(wait)
                continue
            if not data:
                raise ValueError('Empty response')
            return data
        except Exception as e:
            print(f'Attempt {i + 1} failed:', e)
            time.sleep(wait)
    return None
这是我在信任一个 API 用于仪表盘或定时任务之前会加入的那类检查。
重要的不是重试次数,而是您的代码能否区分坏代码、空响应、限流提示与临时性失败。如果所有失败看起来都一样,一旦项目拥有用户,调试就会非常痛苦。
对于筛选器、估值工具和 AI 助手,我会测试 API 是否能从多个端点产出一个干净的研究对象。
下面的示例获取苹果的行情与公司概览,并将结果整理为一个紧凑的字典。这更接近仪表盘卡片、筛选器行或 AI 工具响应所需的形态。
def get_research_snapshot(symbol):
    quote_url = f'https://www.alphavantage.co/query?function=GLOBAL_QUOTE&symbol={symbol}&apikey={api_key}'
    overview_url = f'https://www.alphavantage.co/query?function=OVERVIEW&symbol={symbol}&apikey={api_key}'
    quote_data = get_json(quote_url)
    overview = get_json(overview_url)
    quote = quote_data.get('Global Quote', {}) if quote_data else {}
    price = quote.get('05. price')
    eps = overview.get('EPS') if overview else None
    pe_check = None
    if price and eps:
        pe_check = float(price) / float(eps)
    return {
        'symbol': symbol,
        'price': price,
        'latest_trading_day': quote.get('07. latest trading day'),
        'volume': quote.get('06. volume'),
        'sector': overview.get('Sector') if overview else None,
        'market_cap': overview.get('MarketCapitalization') if overview else None,
        'pe_ratio_api': overview.get('PERatio') if overview else None,
        'pe_ratio_check': pe_check,
        'profit_margin': overview.get('ProfitMargin') if overview else None
    }
snapshot = get_research_snapshot('AAPL')
snapshot
输出类似如下:
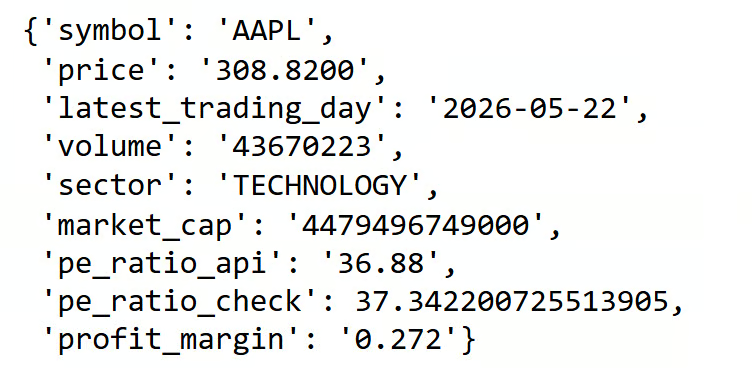
API 提供的市盈率与我们用价格/EPS 的简单计算并不完全一致,这很正常,因为供应商可能采用不同的时间口径或调整输入。但这种对比仍然有用,因为它告诉我们这些字段在方向上是否可用。
此测试不仅对回测有用:
最后一点很重要。MCP 或工具调用并不能魔法般修复脏数据。API 仍需返回可转化为可预测对象的字段。如果每个端点都需要自定义清洗,代理工作流会很快变得脆弱。
实用测试很简单:您能否拉取数据、完成校验、计算一个基础指标,并返回可被系统其他部分直接使用的内容?如果可以,说明该 API 已更接近于超越首个笔记本阶段的可用性。
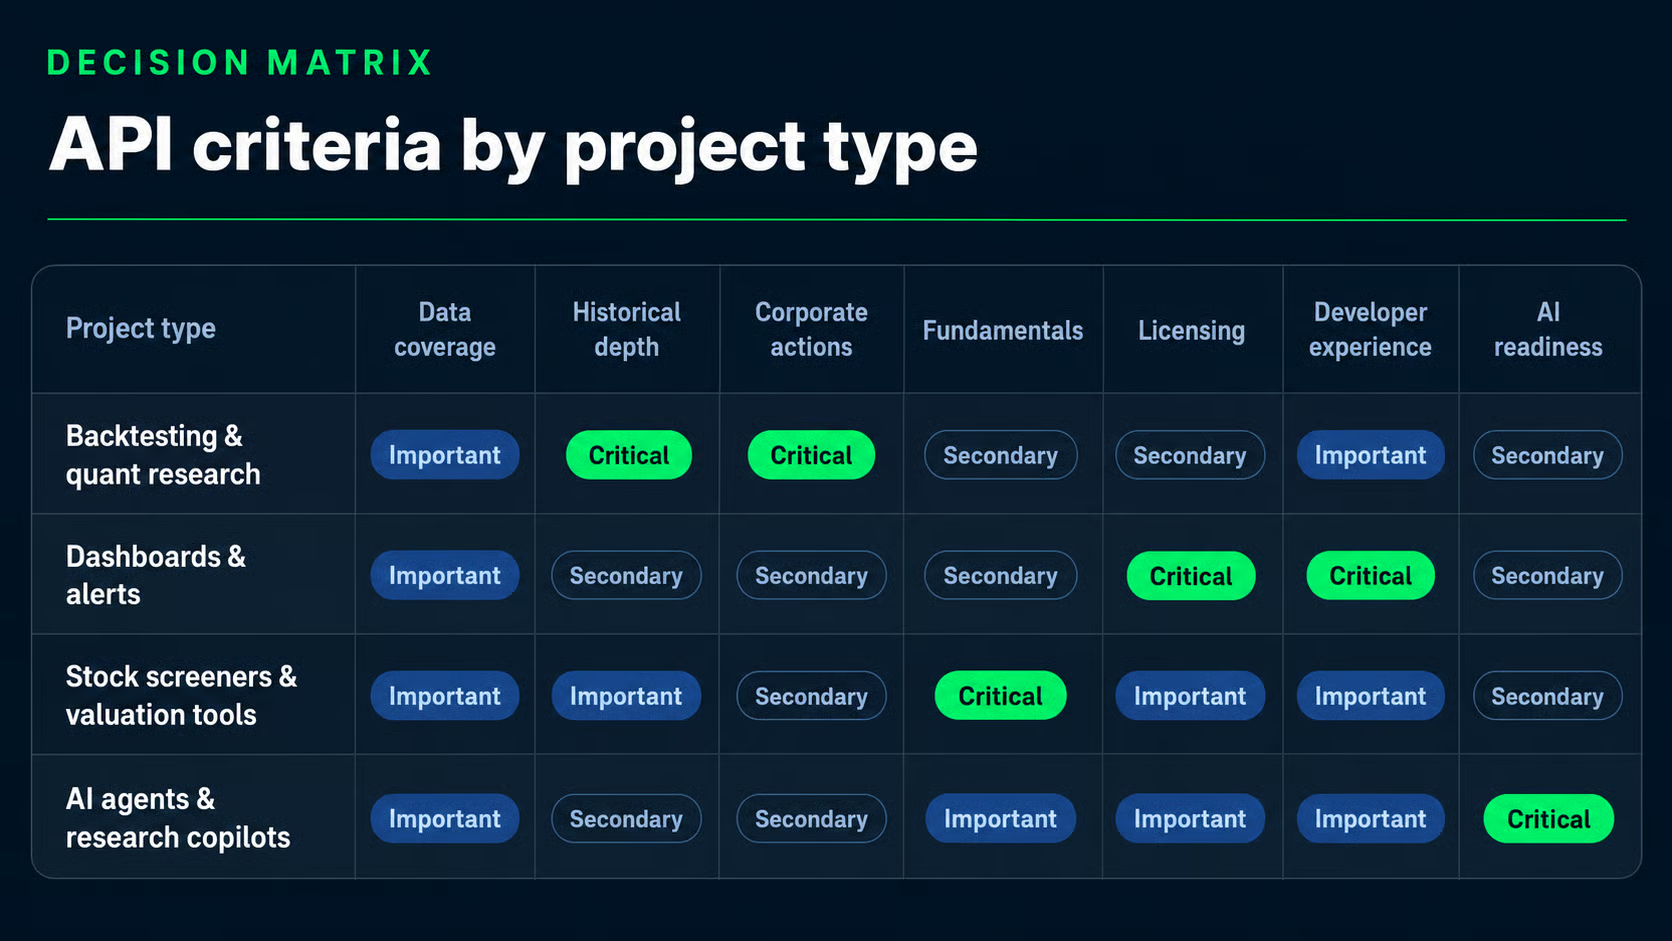
现在我们可以把工作流与评估标准结合起来。
此矩阵的目的不是给供应商排名,而是帮助您决定在当前项目中哪些标准应得到
最多的关注。|
项目类型 |
最重要标准 |
次要标准 |
可考虑的供应商匹配 |
|
回测与量化研究 |
历史深度、调整后价格与公司行为 |
AI 就绪度、许可 |
Alpha Vantage:适合广泛的历史与指标工作流;EODHD:适合全球收盘价研究 |
|
仪表盘与告警 |
许可、响应的开发者体验、限流 |
历史深度、基本面 |
QuoteMedia:开发者友好的仪表盘;Xignite:企业级金融应用 |
|
股票筛选器与估值工具 |
基本面、公司元数据、比率与财务报表 |
历史深度、标的覆盖 |
Alpha Vantage:适合广泛基本面与价格工作流;Intrinio:适合偏重美国基本面的工具 |
|
AI 代理与研究副驾 |
结构化响应、工具访问与 MCP 就绪 |
基本面、指标、许可 |
Alpha Vantage:适合 MCP 与广覆盖的 API |
这张表是有意不完美的。真实项目很少只落在某一行上,多数严肃的产品会结合不止一种工作流。
对回测器而言,我会先看历史深度与公司行为,而不是担心实时行情。
关键问题不是“我能否拉取价格历史?”,而是“我能否信任这段价格历史,跨越拆股、分红、缺失日期与漫长市场周期?”
针对该工作流,检查:
如果您转向实盘监控或执行,实时数据可能在后续变得重要。但对历史研究而言,它不应是首要优先级。
对 AI 助手而言,API 必须便于代码与模型共用。
人类开发者可以检查杂乱的 JSON 响应并修正解析逻辑。代理工作流的容错性更低。如果模式不可预测,模型也许能调用对的工具,却难以正确使用结果。
针对该工作流,检查:
更广泛的观点很简单:根据您最无法承受的失败模式来选 API。回测器在历史错时失败;仪表盘在无法向用户提供新鲜响应时失败;AI 助手在数据访问层过于杂乱难用时失败。
不存在适用于所有项目的“最佳”股票 API。正确的选择取决于您的系统需要做什么:回测要历史深度;仪表盘要新鲜度;筛选器要基本面;AI 工作流要结构化响应。
这也是为何 Alpha Vantage 在本文示例中显得多面手。它覆盖了我们讨论的多个层面,包括市场数据、基本面、技术指标与基于 MCP 的 AI 工作流,因此无需更换供应商就能测试多个决策因素。
我建议将股票 API 视为项目数据基础设施的一部分,而不是一组端点集合。它会影响您的代码、数据库、刷新作业、模型输入、用户体验,甚至最终产品中能展示什么。
如果您希望在 Python 中构建更强的金融工作流,建议从我们的Python 金融入门课程开始。
在 DataCamp 学习用 Python 做财务分析!
{count, plural, other {课程}}
{count, plural, other {课程}}
{count, plural, other {课程}}