注:OpenAI 已于 2026 年 9 月 3 日发布 GPT-6 Astra,并于 2026 年 9 月 23 日发布 GPT-6 Sol 和 Luna。
GPT-5.6 是一组包含三个模型的系列,今日以与美国政府协调的方式开启有限预览。
它尚未向大众开放,但已经有不少值得关注的能力更新,尤其是在编码、生物学与网络安全方面,下面我们将展开介绍。
如果您想回顾 OpenAI 模型的过往动态,我们为每次发布都留下了记录:GPT-5.5 Instant、GPT-5.3 Instant 和 GPT-5.2。
如果您想将 GPT-5.6 与目前最新的可用模型进行对比,我们也有相应文章:Gemini 3.1 Pro、Claude Opus 5、Claude Mythos 5、Claude Fable 5。
什么是 GPT-5.6?
GPT-5.6 是 OpenAI 最新一代的模型。它实际上是一个由三个模型组成的家族,并且(终于)采用了新的命名规则。
在新体系中,数字代表代际(5.6),名称代表能力档位(Sol、Terra、Luna)。我认为这种命名的一个好处是各档位可以按各自节奏迭代,也更不易混淆。“Instant”并不是一个能准确表达“使用最新底层模型”的好名字。
什么是 GPT-5.6 Sol?
Sol 是该系列的旗舰,也是最强大、能力最全面的模型。在本次发布的每项基准测试中,OpenAI 都以该档位领衔。此外,它还是唯一支持全新 max 推理力度和 ultra 模式的模型(下文详述)。
在网络安全和生物学方面的提升也最为显著。如果您追求在复杂、多步骤问题上的最高上限,并且不介意更高的每 token 成本,Sol 是首选。
我们将它与 Anthropic 和 SpaceXAI 的新旗舰模型进行了比较:Claude Opus 5 和 Grok 4.6。
什么是 GPT-5.6 Terra?
Terra 是平衡型、日常工作用的模型。您可以把它视为默认选项。Terra 的性能可与 GPT-5.5 相竞争,但价格约便宜一半。未来我们可能会持续看到这种趋势:以中档价位提供大致上一代旗舰水准的质量。
什么是 GPT-5.6 Luna?
Luna 是快速且经济的档位,面向高吞吐、低时延或预算敏感的工作负载。正如下方的基准测试表所示,“最便宜”并不一定意味着在每项任务上都是“最弱”。值得一提,以免您忽视它。
总的来说:
- Sol 是最强的模型,并配有最完善的安全堆栈
- Terra 与 GPT‑5.5 类似,但更便宜
- Luna 成本最低。
GPT-5.6 还有哪些新变化?
此次更新还带来了两种提升推理力度的新方式,并在若干特定领域实现了广泛的能力提升。
两种更强“施压”模型的方法
GPT-5.6 引入了两种新控制项:
查看下方的基准测试,您会看到 ultra 以单独一行出现(“GPT-5.6 Sol Ultra”),并拿下了最高分。
更强的编码能力
GPT-5.6 Sol 在 Terminal-Bench 2.1 上创下了新的 SOTA。该版本于大约六周前发布,测试需要迭代与工具协同的命令行工作流。具体数据我们会在基准测试部分展开。
更强的生物学能力
这是一个相对小众的基准测试:GeneBench v1。它评估长周期的基因组学与定量生物学分析。根据发布信息,GPT-5.6 Sol 在使用更少 token 的情况下,获得了优于 GPT-5.5 的结果。
更强(且更谨慎处理!)的网络安全
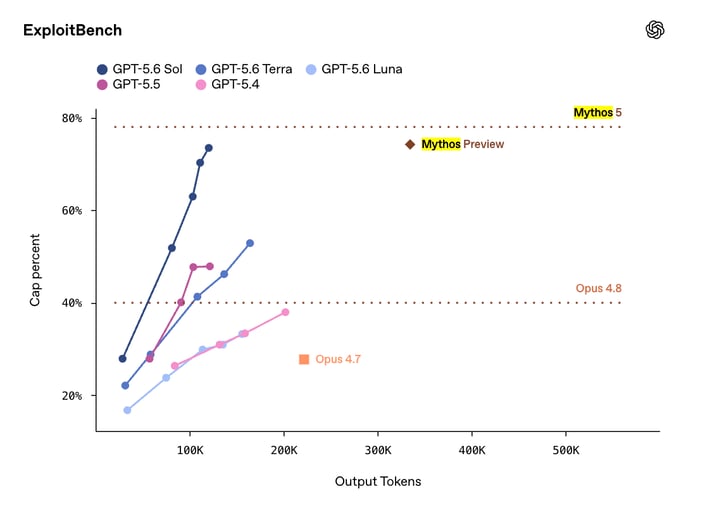
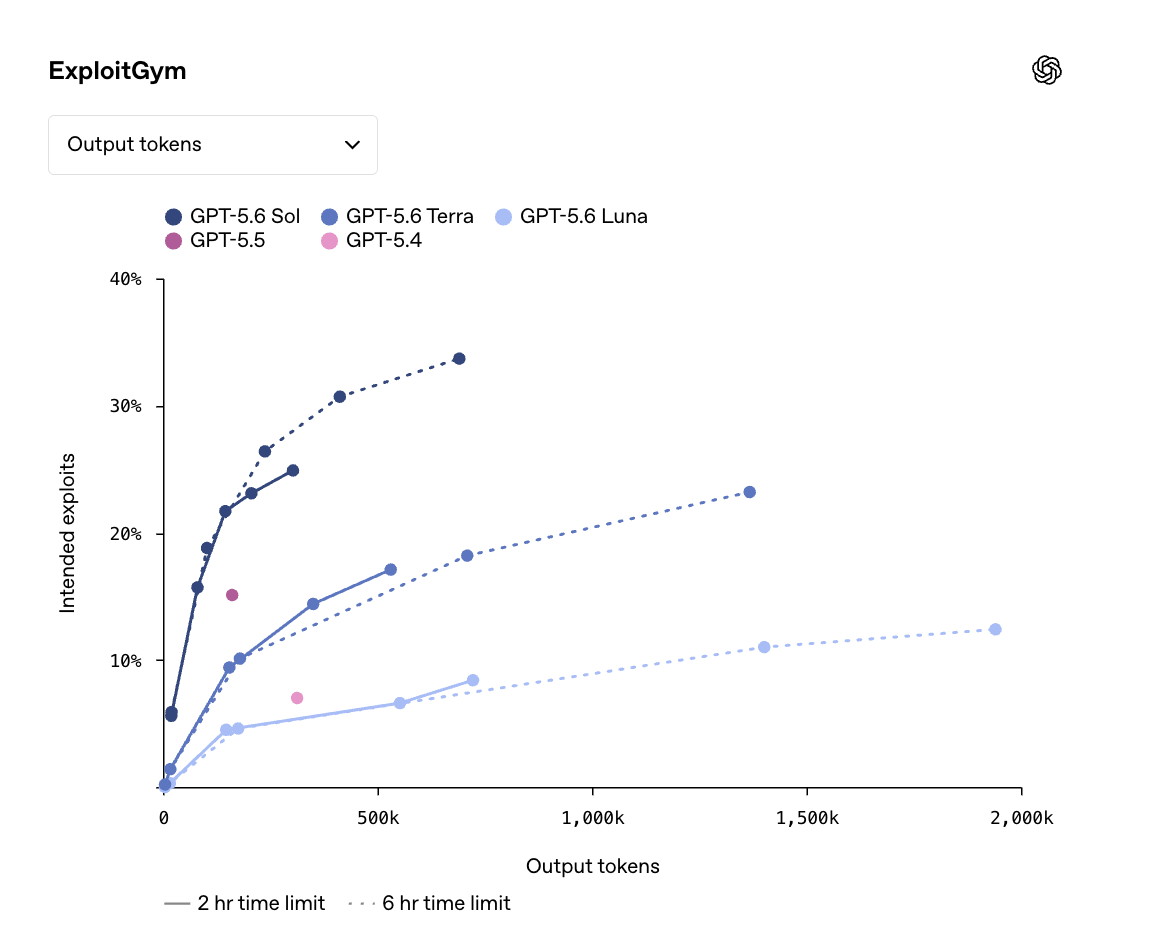
OpenAI 称 GPT-5.6 Sol 是其迄今在网络安全方面能力最强的模型,并为此在发布中投入了大量篇幅。Sol 在长周期安全任务(包括漏洞研究与利用)上的性能-效率前沿得到推进。发布还提到了在一些相对小众的基准测试上的更多成功:
- 在 ExploitBench 上,OpenAI 表示 GPT-5.6 Sol 与(尚未发布的)Mythos Preview 模型旗鼓相当,但只使用了约三分之一的输出 token。
- 在由加州大学伯克利分校研究人员构建的 ExploitGym 基准上,随着推理力度增加,三款模型都在网络安全方面表现出显著提升。
GPT-5.6 基准测试结果
最值得关注的基准成绩来自我们前面提到的 Terminal-Bench 2.1。以下是各模型从高到低的得分:
| 模型 | Terminal-Bench 2.1 |
|---|
| GPT-5.6 Sol Ultra | 91.9% |
| GPT-5.6 Sol | 88.8% |
| GPT-5.5 | 88.0% |
| GPT-5.6 Luna | 84.3% |
| Claude Mythos 5 | 84.3% |
| Claude Fable 5 | 83.4% |
| GPT-5.6 Terra | 82.5% |
| Claude Opus 4.8 | 78.9% |
| Gemini 3.1 Pro Preview | 70.7% |
有几点值得注意:
-
ultra 模式确实带来差异。GPT-5.6 Sol Ultra(91.9%)明显高于普通 Sol(88.8%),这为子智能体方法奏效提供了最直接的证据,至少在此测试中如此。
-
档位排序与这项单一基准并非完全一致。请注意,GPT-5.6 Luna 实际上高于 GPT-5.6 Terra,尽管 Terra 被定位为更高档位。而且在这项测试中,Terra 低于 GPT-5.5(88.0%),尽管 OpenAI 将 Terra 描述为“整体上与 GPT-5.5 有竞争力”。我的体会是:档位体现的是在众多任务上对智能/速度/成本的综合平衡,并不保证在任何单项基准上都占优。
安全堆栈与有限预览
这是 GPT-5.6 与常规模型发布最不同之处。相较于我们亲自测试模型(下文说明为何目前无法这样做),此次发布最值得关注的是其交付“方式”。
分层的防护堆栈
OpenAI 的观点是,面对有意图或可适应的滥用,任何单一防护都难以长久奏效,因此采用多层叠加。在 GPT-5.6 预览期,这些层包括:
- 模型层训练,用于拒绝被禁止的网络安全协助,包括试图伪装意图或越狱模型的行为。
- 实时分类器,用于检测网络安全与生物学滥用,并在生成过程中评估输出。对于更高风险的情形,生成可被暂停,由更强的推理模型审阅完整对话,并可在输出到达您之前将其拦截。
- 账户层审查,可跨用户对话与风险信号进行观察,以区分持续的恶意行为与正当的双重用途安全工作。
- 差异化的访问、监测、执法与持续测试。
OpenAI 开诚布公地表示,尤其在预览期间,这意味着有些请求可能被拦截或拒绝,另一些则可能因为生成被暂停以供审查而耗时更长。同时也承认,防护措施偶尔可能会误触发在表面上与进攻行为相似的正当双重用途工作。
规模化红队测试
为强化上述机制,OpenAI 表示在安全方面投入了不同寻常的算力:超过 70 万 A100 等效 GPU 小时的自动化红队测试,旨在寻找通用型越狱方式——即能跨多种提示与语境泛化的攻击,而非只在狭窄情境中奏效。除此之外,还有第三方人类专家红队测试,贯穿整个预览期,并配合快速响应流程,复现并修补新发现的越狱手法,并将其纳入后续测试。
为何如此谨慎地推出
OpenAI 表示,其在发布前已将 GPT-5.6 的规划与能力通报给美国政府,并应政府要求,先以有限预览的形式面向一小部分可信合作伙伴开放。
这也是一个月内美国政府第二次介入前沿模型的发布。就在两周前,美国的一项出口管制指令迫使 Anthropic 将 Claude Fable 5 与 Mythos 5 在全球范围对所有客户下线。
我的看法:OpenAI 看到 Anthropic 遭遇的情况,选择在一开始就将“钥匙”交给对方,而不是在模型发布后被叫停。
关于测试的说明
在我们惯常的模型评测中,这里通常会加入上手测试,包括推理、网页搜索以及一两个高难度提示。但这次我们暂时做不到。GPT-5.6 处于仅向少量可信合作伙伴开放的有限预览阶段,尚未面向大众测试。
我如何获得 GPT-5.6 的使用权限?
在预览期间,GPT-5.6 模型可通过 API 和 Codex 向部分受信任的合作伙伴与机构提供。OpenAI 表示,计划很快在 ChatGPT、Codex 与 API 中更广泛开放。
定价
GPT-5.6 在三个档位均按每 100 万 token 计费:
| 模型 | 输入(每 100 万 token) | 输出(每 100 万 token) |
|---|
| GPT-5.6 Sol | $5.00 | $30.00 |
| GPT-5.6 Terra | $2.50 | $15.00 |
| GPT-5.6 Luna | $1.00 | $6.00 |
有几条定价细节值得了解:
- 更可预测的提示缓存,包括支持显式缓存断点与至少 30 分钟的缓存有效期。
- 对 GPT-5.6 及后续模型,缓存写入按模型未缓存输入费率的 1.25 倍计费,缓存读取仍享受 90% 的输入缓存折扣。
通过 Cerebras 提速
OpenAI 还表示,将于 7 月在 Cerebras 上推出 GPT-5.6 Sol,速度最高可达每秒 750 个 token,初期仅向部分客户开放,随后随产能扩大而扩展。这直指对时延敏感的工作场景——等待前沿模型成为瓶颈的地方。
结语
GPT-5.6 带来了不少亮点:更清晰的三档家族、两种推动推理的新方式(max 与 ultra),以及在编码、生物学与网络安全方面的提升。
不过,目前模型仍处于封闭预览阶段,因此尚无独立方可加以验证。OpenAI 所讲述的故事——“GPT-5.6 的能力如此强大,以至于我们不得不与政府协调”——听起来颇有市场宣传的意味。但与此同时,这并不代表其为虚言,我们也应对一切围绕网络安全的谨慎表示认可。
就目前而言,坦率的总结是:数据看起来很强,访问范围很窄,而真正的考验(字面意义上)将在模型广泛开放时到来。订阅我们的新闻通讯,我们会持续为您更新进展。


注:OpenAI 已于 2026 年 9 月 3 日发布 GPT-6 Astra,并于 2026 年 9 月 23 日发布 GPT-6 Sol 和 Luna。
GPT-5.6 是一组包含三个模型的系列,今日以与美国政府协调的方式开启有限预览。
它尚未向大众开放,但已经有不少值得关注的能力更新,尤其是在编码、生物学与网络安全方面,下面我们将展开介绍。
如果您想回顾 OpenAI 模型的过往动态,我们为每次发布都留下了记录:GPT-5.5 Instant、GPT-5.3 Instant 和 GPT-5.2。
如果您想将 GPT-5.6 与目前最新的可用模型进行对比,我们也有相应文章:Gemini 3.1 Pro、Claude Opus 5、Claude Mythos 5、Claude Fable 5。
什么是 GPT-5.6?
GPT-5.6 是 OpenAI 最新一代的模型。它实际上是一个由三个模型组成的家族,并且(终于)采用了新的命名规则。
在新体系中,数字代表代际(5.6),名称代表能力档位(Sol、Terra、Luna)。我认为这种命名的一个好处是各档位可以按各自节奏迭代,也更不易混淆。“Instant”并不是一个能准确表达“使用最新底层模型”的好名字。
什么是 GPT-5.6 Sol?
Sol 是该系列的旗舰,也是最强大、能力最全面的模型。在本次发布的每项基准测试中,OpenAI 都以该档位领衔。此外,它还是唯一支持全新
max推理力度和ultra模式的模型(下文详述)。在网络安全和生物学方面的提升也最为显著。如果您追求在复杂、多步骤问题上的最高上限,并且不介意更高的每 token 成本,Sol 是首选。
我们将它与 Anthropic 和 SpaceXAI 的新旗舰模型进行了比较:Claude Opus 5 和 Grok 4.6。
什么是 GPT-5.6 Terra?
Terra 是平衡型、日常工作用的模型。您可以把它视为默认选项。Terra 的性能可与 GPT-5.5 相竞争,但价格约便宜一半。未来我们可能会持续看到这种趋势:以中档价位提供大致上一代旗舰水准的质量。
什么是 GPT-5.6 Luna?
Luna 是快速且经济的档位,面向高吞吐、低时延或预算敏感的工作负载。正如下方的基准测试表所示,“最便宜”并不一定意味着在每项任务上都是“最弱”。值得一提,以免您忽视它。
总的来说:
GPT-5.6 还有哪些新变化?
此次更新还带来了两种提升推理力度的新方式,并在若干特定领域实现了广泛的能力提升。
两种更强“施压”模型的方法
GPT-5.6 引入了两种新控制项:
max推理力度:一种新的推理力度设置,使 Sol 在处理问题时获得最多的思考时间。ultra模式:这个更有意思。它不是让单一智能体处理任务,而是使用子智能体(subagents)。查看下方的基准测试,您会看到
ultra以单独一行出现(“GPT-5.6 Sol Ultra”),并拿下了最高分。更强的编码能力
GPT-5.6 Sol 在 Terminal-Bench 2.1 上创下了新的 SOTA。该版本于大约六周前发布,测试需要迭代与工具协同的命令行工作流。具体数据我们会在基准测试部分展开。
更强的生物学能力
这是一个相对小众的基准测试:GeneBench v1。它评估长周期的基因组学与定量生物学分析。根据发布信息,GPT-5.6 Sol 在使用更少 token 的情况下,获得了优于 GPT-5.5 的结果。
更强(且更谨慎处理!)的网络安全
OpenAI 称 GPT-5.6 Sol 是其迄今在网络安全方面能力最强的模型,并为此在发布中投入了大量篇幅。Sol 在长周期安全任务(包括漏洞研究与利用)上的性能-效率前沿得到推进。发布还提到了在一些相对小众的基准测试上的更多成功:
GPT-5.6 基准测试结果
最值得关注的基准成绩来自我们前面提到的 Terminal-Bench 2.1。以下是各模型从高到低的得分:
有几点值得注意:
ultra模式确实带来差异。GPT-5.6 Sol Ultra(91.9%)明显高于普通 Sol(88.8%),这为子智能体方法奏效提供了最直接的证据,至少在此测试中如此。档位排序与这项单一基准并非完全一致。请注意,GPT-5.6 Luna 实际上高于 GPT-5.6 Terra,尽管 Terra 被定位为更高档位。而且在这项测试中,Terra 低于 GPT-5.5(88.0%),尽管 OpenAI 将 Terra 描述为“整体上与 GPT-5.5 有竞争力”。我的体会是:档位体现的是在众多任务上对智能/速度/成本的综合平衡,并不保证在任何单项基准上都占优。
安全堆栈与有限预览
这是 GPT-5.6 与常规模型发布最不同之处。相较于我们亲自测试模型(下文说明为何目前无法这样做),此次发布最值得关注的是其交付“方式”。
分层的防护堆栈
OpenAI 的观点是,面对有意图或可适应的滥用,任何单一防护都难以长久奏效,因此采用多层叠加。在 GPT-5.6 预览期,这些层包括:
OpenAI 开诚布公地表示,尤其在预览期间,这意味着有些请求可能被拦截或拒绝,另一些则可能因为生成被暂停以供审查而耗时更长。同时也承认,防护措施偶尔可能会误触发在表面上与进攻行为相似的正当双重用途工作。
规模化红队测试
为强化上述机制,OpenAI 表示在安全方面投入了不同寻常的算力:超过 70 万 A100 等效 GPU 小时的自动化红队测试,旨在寻找通用型越狱方式——即能跨多种提示与语境泛化的攻击,而非只在狭窄情境中奏效。除此之外,还有第三方人类专家红队测试,贯穿整个预览期,并配合快速响应流程,复现并修补新发现的越狱手法,并将其纳入后续测试。
为何如此谨慎地推出
OpenAI 表示,其在发布前已将 GPT-5.6 的规划与能力通报给美国政府,并应政府要求,先以有限预览的形式面向一小部分可信合作伙伴开放。
这也是一个月内美国政府第二次介入前沿模型的发布。就在两周前,美国的一项出口管制指令迫使 Anthropic 将 Claude Fable 5 与 Mythos 5 在全球范围对所有客户下线。
我的看法:OpenAI 看到 Anthropic 遭遇的情况,选择在一开始就将“钥匙”交给对方,而不是在模型发布后被叫停。
关于测试的说明
在我们惯常的模型评测中,这里通常会加入上手测试,包括推理、网页搜索以及一两个高难度提示。但这次我们暂时做不到。GPT-5.6 处于仅向少量可信合作伙伴开放的有限预览阶段,尚未面向大众测试。
我如何获得 GPT-5.6 的使用权限?
在预览期间,GPT-5.6 模型可通过 API 和 Codex 向部分受信任的合作伙伴与机构提供。OpenAI 表示,计划很快在 ChatGPT、Codex 与 API 中更广泛开放。
定价
GPT-5.6 在三个档位均按每 100 万 token 计费:
有几条定价细节值得了解:
通过 Cerebras 提速
OpenAI 还表示,将于 7 月在 Cerebras 上推出 GPT-5.6 Sol,速度最高可达每秒 750 个 token,初期仅向部分客户开放,随后随产能扩大而扩展。这直指对时延敏感的工作场景——等待前沿模型成为瓶颈的地方。
结语
GPT-5.6 带来了不少亮点:更清晰的三档家族、两种推动推理的新方式(
max与ultra),以及在编码、生物学与网络安全方面的提升。不过,目前模型仍处于封闭预览阶段,因此尚无独立方可加以验证。OpenAI 所讲述的故事——“GPT-5.6 的能力如此强大,以至于我们不得不与政府协调”——听起来颇有市场宣传的意味。但与此同时,这并不代表其为虚言,我们也应对一切围绕网络安全的谨慎表示认可。
就目前而言,坦率的总结是:数据看起来很强,访问范围很窄,而真正的考验(字面意义上)将在模型广泛开放时到来。订阅我们的新闻通讯,我们会持续为您更新进展。