Andrej Karpathy 的 AutoResearch 是一个开源工具,以循环方式运行机器学习实验,只保留击败当前最佳结果的改动。您在一个 markdown 文件里描述研究方向,把 AI 编码代理指向代码库,然后就可以离开。到早上,您会得到一份包含已验证改进的 git 历史,以及代理尝试过的一切操作日志。
该项目于 2026 年 3 月 7 日发布,数日内便收获 21,000+ GitHub Star,Karpathy 的公告获得 860 万次浏览。本文介绍三文件架构的工作方式、夜间运行中棘轮循环做了什么、AutoResearch 目前取得了哪些结果,以及这种方法的边界所在。
什么是 AutoResearch?
AutoResearch 是一个开源 Python 工具,让 AI 代理在单块 GPU 上无人干预地运行机器学习实验。它循环执行“提出—训练—评估”的周期,只保留能降低验证损失的改动。项目以 MIT 许可发布。
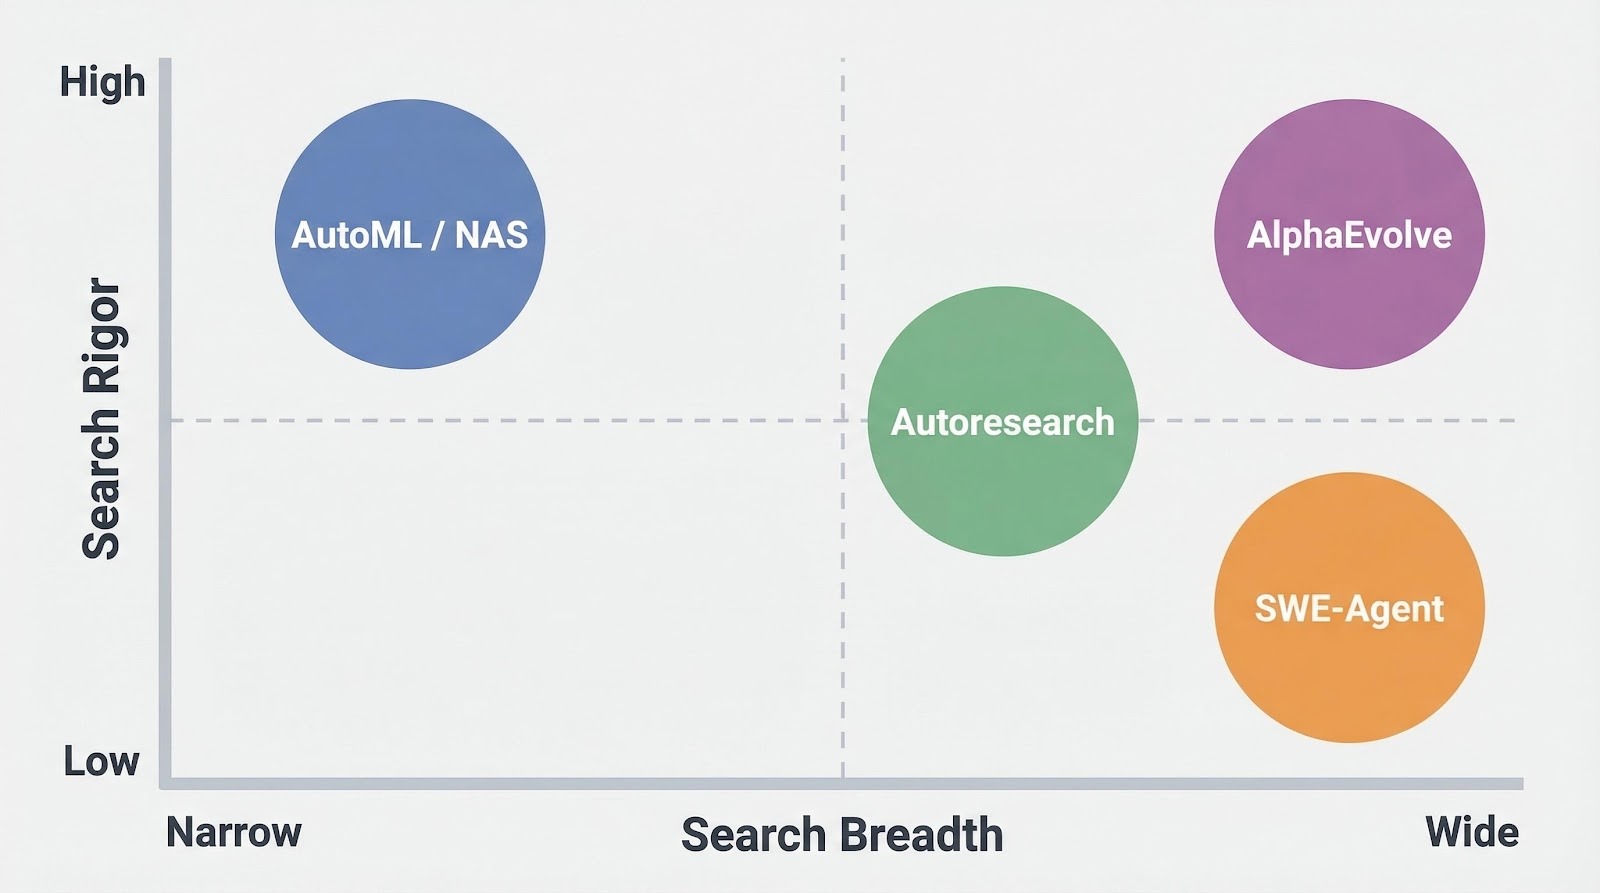
这不是超参数调优。像 Optuna 或 Ray Tune 这样的工具在预定义的参数空间中搜索。AutoResearch 则允许代理修改任意代码。搜索空间就是 LLM 能想到的一切,这使它与当前可用的任何工具都属于不同的类别。
AutoML 和 NAS(神经架构搜索)框架使用结构化算法在架构或超参数上搜索,精确但受限于其定义的搜索空间。
AlphaEvolve(Google DeepMind)进一步采用进化式方法并使用 Gemini 模型进行算法发现,但它是闭源的,大多数团队无法使用。通用型编码代理如 SWE-Agent、OpenHands 和 Aider 能编写任意代码,但它们并非为机器学习研究所需的“实验—评估—保留/回退”循环而构建。
AutoResearch 押注于 LLM 的通识来提出优质实验,而不是通过收紧搜索空间来获取数学保证。
从“vibe coding”到研究顾问
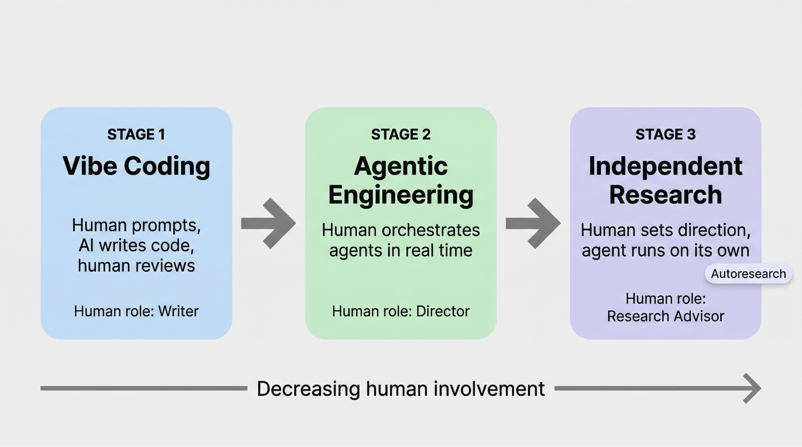
Karpathy 将此视为工程师与 AI 协作方式的自然演进。2026 年 2 月,他提出了“agentic engineering(代理式工程)”这一术语:“99% 的时间里,您并不直接写代码。您在编排执行任务的代理,并承担监督角色。”AutoResearch 则更进一步。人类甚至不再编排。他们在一个 markdown 文件里描述好的研究应是什么样,然后离开。
这种演进路径是:vibe coding(人类提示、AI 写码、人类审阅)→ 代理式工程(人类实时编排代理)→ 完全独立研究(人类设定方向,代理自主运行)。
每一步都在削弱人类的角色:从作者到导演,再到(借用 Karpathy 的表述)研究顾问。
在后续文章中,他描述了下一步:“目标不是模拟一个博士生,而是模拟一个由他们组成的研究共同体”,指的是一种类似 SETI@home 的分布式代理协作。
系统如何将这一愿景落地,归结到三个文件。
AutoResearch 的三文件架构
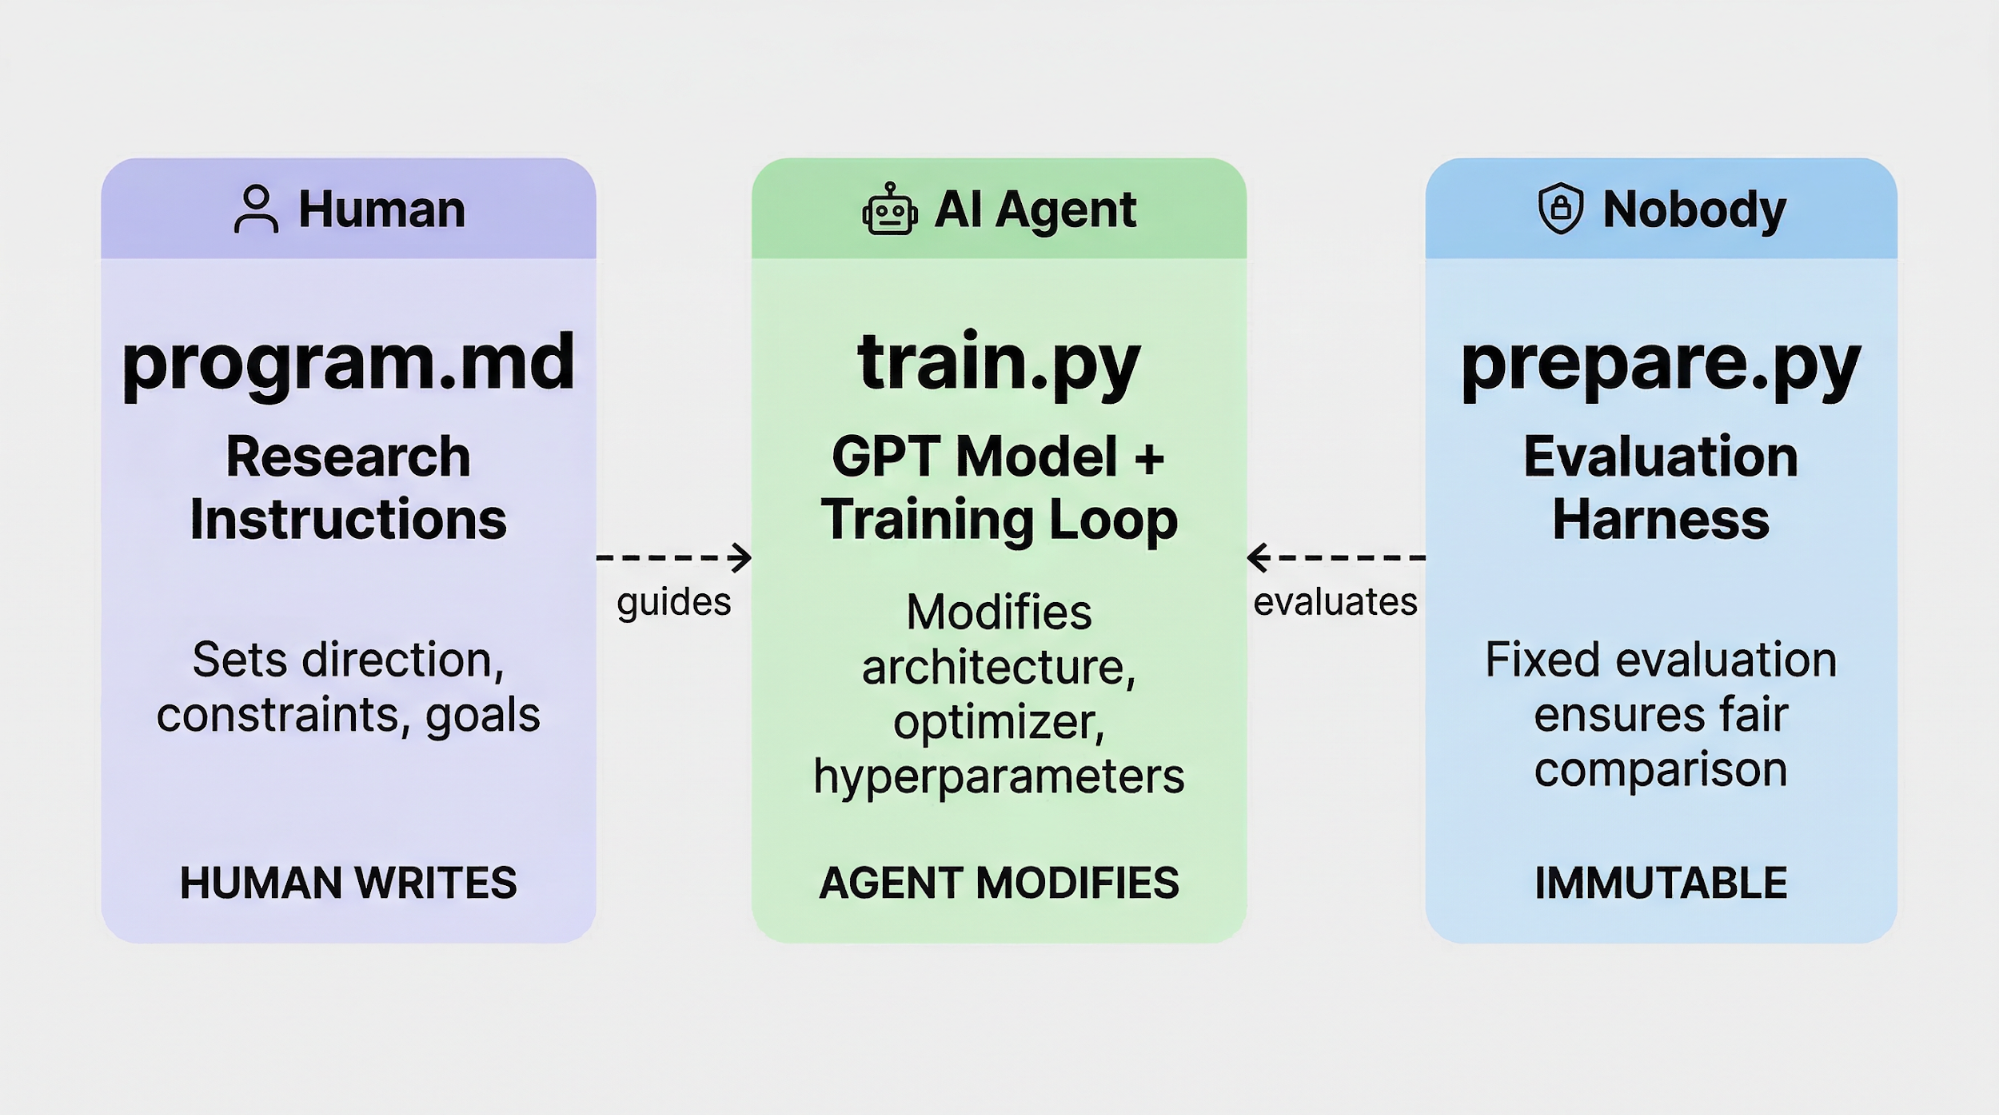
AutoResearch 的设计归结为三个文件之间的契约,每个文件都有严格的“谁可以触碰”的规则。
prepare.py
prepare.py 负责数据准备与评估。它构建一个 8,192 词表的 BPE(Byte Pair Encoding,字节对编码)分词器,处理训练语料,并定义验证指标:val_bpb(验证 bits-per-byte)。
此文件不可变:无论人类还是代理都不能修改它,从而保证每次实验都以相同的标尺来衡量。
train.py
train.py 是代理的沙盒:共 630 行,包含 GPT 模型架构、Muon+AdamW 优化器,以及完整训练循环。只要修改后的代码仍能训练并产出val_bpb 分数,代理便可以在此处重写任何内容(更换激活函数、重构注意力头、调整学习率调度、修改权重初始化等)。
program.md
program.md 用纯 markdown 编写,是人类作者唯一会触碰的文件。它告诉代理要追求哪些研究方向、避免哪些路径,以及如何开展实验。
program.md 控制什么
该文件比大多数人预期的更具体。它硬编码了基线指标,让代理知道需要超越什么(val_bpb:0.997900,显存峰值:45 GB)。
它明确给出运行实验和提取结果的具体命令。它告诉代理如何处理失败:修正拼写错误并重跑;从根上有问题的想法跳过;任何运行超过 10 分钟的进程一律终止。
而让整个系统运转的关键指令也包含其中:“永远不要停止。一旦实验循环开始,切勿暂停向人类询问是否继续。”
还有一个影响每个实验的设计约束:“在其他条件相同的情况下,越简单越好。哪怕是小幅改进,如果带来丑陋的复杂度,也不值得。”这会引导代理远离过度工程的解决方案,转向人类审阅者会认可的干净改动。
分工非常清晰。人类通过program.md 设定研究方向,代理通过修改train.py 来执行,prepare.py 则作为双方都不能触碰的中立评判者。有了这份契约,代理就能不间断地运行实验循环。
AutoResearch 棘轮循环
AutoResearch 的核心是无需人工参与的实验循环。基于program.md 中定义的 9 步循环,单次迭代如下:
- 代理阅读
program.md,理解当前研究优先级与约束。
- 它检查当前的
train.py 和 results.tsv 中的近期结果。
- 它提出一个假设:如架构变更、优化器调整或训练修改。
- 它修改
train.py 以实现所提变更。
- 它将更改提交到一个 git 分支。
- 它精确运行 5 分钟训练(固定挂钟时间预算)。
- 若训练崩溃,它会记录失败、回退提交,并重试。
- 它通过
val_bpb 评估结果,并将结果记录到 results.tsv。
- 如果
val_bpb 变好:保留提交。否则:git reset HEAD~1 回退到上一版本。
然后从第 1 步重新开始。
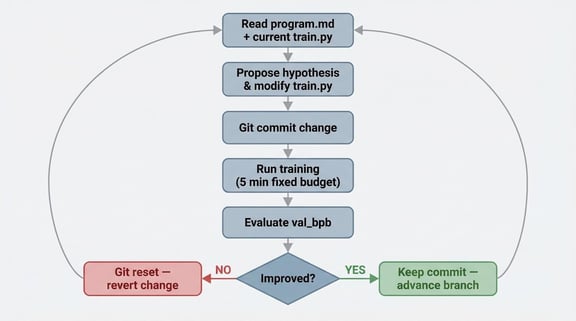
每个实验都获得相同的 5 分钟挂钟时间预算,使得结果可直接比较。训练更快的改动与收敛更低的改动在同一起跑线被评估。
按每个实验 5 分钟计算,系统每小时可运行约 12 个实验。
“棘轮”之名来自 git 历史。每个成功实验都会新增一次提交;每个失败都会被回退。代码库只能前进,不能后退,一次只积累一个经过验证的改进。
将 Git 作为研究记忆
其结构类似进化算法,但 AutoResearch 只保留单一谱系,而非种群。没有候选之间的交叉与变异,LLM 同时扮演变异算子(提出更改)和选择压力(基于过往结果选择要尝试的方向)。
它会读取自己的 git 历史和 results.tsv,在有希望的尝试上继续深入。
该 results.tsv 文件跟踪每个实验:提交哈希、val_bpb 分数、GPU 显存占用、通过/失败状态,以及代理尝试内容的描述。
您可以在早上查看一条清晰的审计轨迹;代理也用同一日志来校准下一步要尝试的内容。早期实验往往更宽泛(测试不同优化器配置),而后期会聚焦于数据已验证的方向。
开始使用 AutoResearch
运行 AutoResearch 需要一台带 NVIDIA GPU 的机器(默认配置面向显存 20GB+ 的现代 GPU)、Python 3.10+、uv,以及一个编码代理(Claude Code、Cursor 或类似工具)。
克隆仓库、安装依赖并准备数据集:
git clone https://github.com/karpathy/autoresearch.git
cd autoresearch
uv sync
uv run prepare.py技术支持
没有编排脚本。没有 run.py、没有流水线、也没有框架。
README 的说法是“就直接在这个仓库里启动您的 Claude/Codex 或任何您想用的工具”。
您在项目目录中打开一个编码代理,提示它阅读 program.md,之后代理就会自行运行实验循环。
LLM 本身就是自动化层。通过实时查看 results.tsv 或检查 git 日志中新提交的方式来观察进展。
默认配置会在 FineWeb-Edu 数据集上训练一个 GPT 模型,这需要一块不错的 GPU,并耗时数小时才能看到结果。若首次在较小硬件上测试,Karpathy 建议切换到 TinyStories 数据集,并通过将词表大小降至 256、深度降至 4 来缩小模型规模。
这些改动会降低显存需求,并缩短每次实验的耗时,使您能在数小时内看到棘轮效应的实际表现。
配置您的首次运行
在启动通宵运行之前,先阅读默认的 program.md。它定义了代理所遵循的研究议程,您通过编辑它来引导实验。
如果您希望代理聚焦注意力机制,请在 program.md 中说明。
如果您希望它避免触碰优化器,也请添加该约束。代理不会偏离文件中写明的内容。
首次的通宵运行,可预期 80–100 个实验,可能保留 15–20 个改进。还有一些实用提示:
- API 成本随实验数量增长。一次通宵运行对个人研究者而言尚可承受,但多日运行需要预算。
- 有些实验会崩溃。循环会自动恢复,因此不会打断通宵运行。
- 早上查看
results.tsv,而不是盯着终端。逐步改善的 val_bpb“阶梯”形态,比单条日志更能讲述全貌。
AutoResearch 的结果与创造力天花板
AutoResearch 已在多次运行中得到验证,包括 Karpathy 自身实验、社区复现以及生产落地。
|
运行
|
实验数
|
保留的改进
|
结果
|
|
初次通宵(单 GPU)
|
83
|
15
|
val_bpb: 1.000 → 0.975
|
|
扩展 2 天运行(深度 12)
|
~700
|
~20
|
均为可叠加;迁移至深度 24 模型
|
|
生产影响
|
-
|
-
|
达到 GPT-2 基准所需时间:2.02h → 1.80h(快 11%)
|
|
社区会话
|
126
|
-
|
val_bpb: 0.9979 → 0.9697
|
代理找到了一个有条理的人类最终也会找到的东西。QKnorm 缺少用于锐化注意力的缩放乘子;Value Embeddings 受益于正则化;在带状注意力调参、AdamW beta 参数以及权重衰减调度上也有提升。
这些是结构性代码改动,而非随机的超参数扫掠;手动测试每一项会耗费数天。
Shopify CEO Tobi Lutke 将 AutoResearch 改造用于内部的查询扩展模型,在一个 8 亿参数模型上通过 37 次实验获得了 19% 的验证分数提升,并在启动后的第二天就报告了结果。
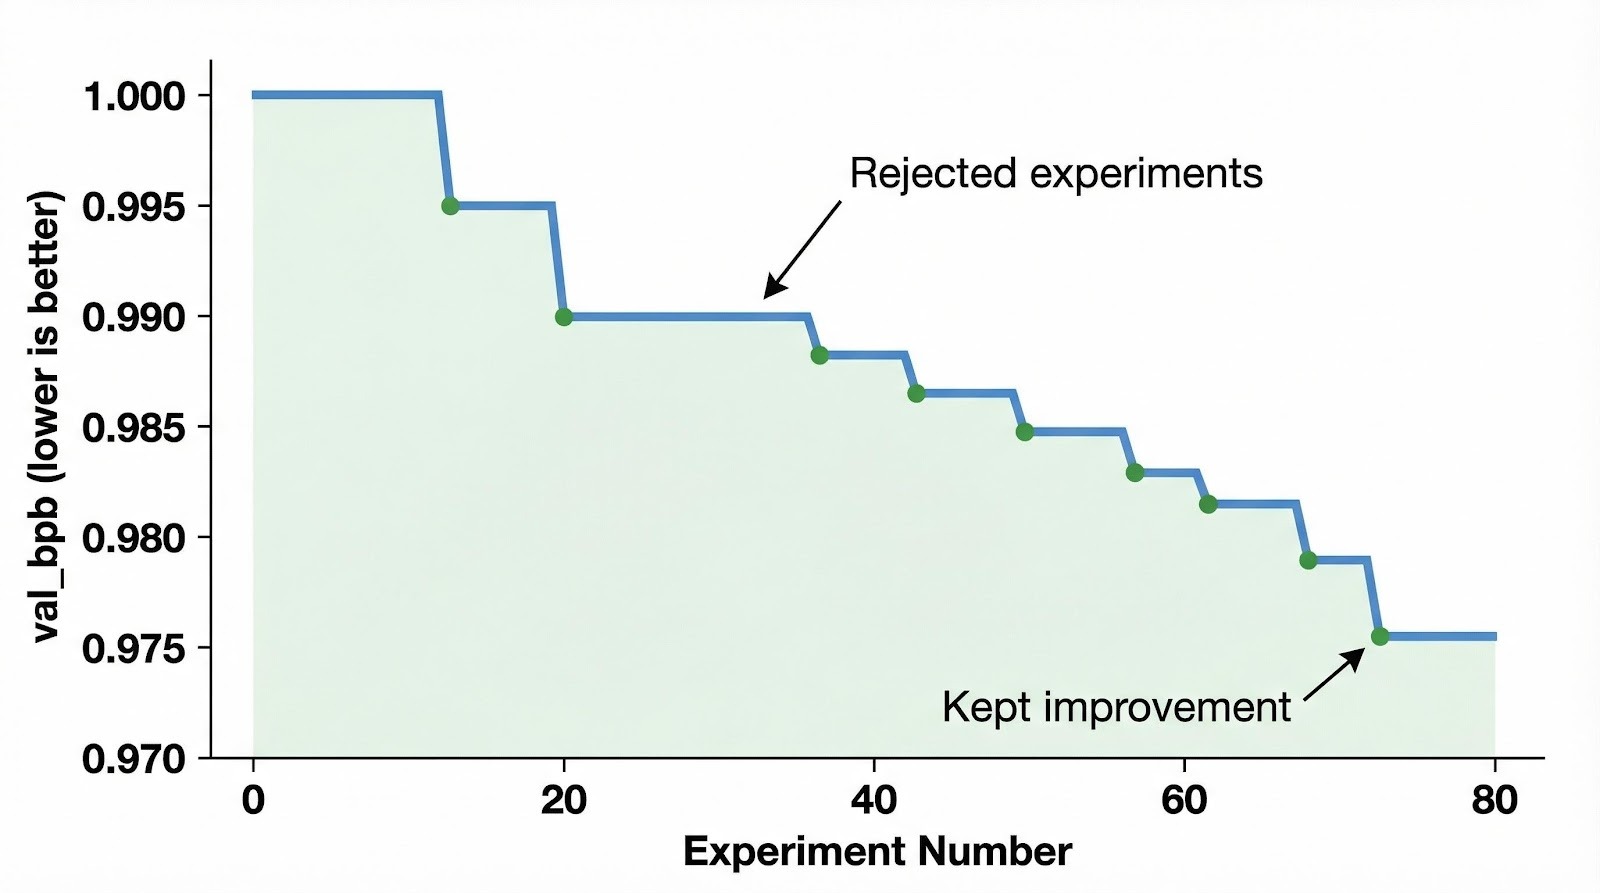
“阶梯图”是真实的,但每一步都不大。代理确实能找到改进:这里调整一个 beta 参数,那里加一点正则化。尚无人报告它发明了新颖的注意力机制,或提出了人类研究者最终也想不到的架构性创意。
创造力天花板
GitHub Issue #22 揭示了结构性问题。一位用户观察到,代理会在“上次有效”的附近做小幅变体循环,被困在局部搜索模式中。
棘轮只接受能立刻提升 val_bpb 的变更,因此代理永远无法先退一步,为更大的收益做铺垫。
而人类研究者常常会这样推理:“会先变差,然后变好。”棘轮没有留给这种策略的空间。
Karpathy 在Hacker News 上也承认了相关问题:代理在开放性问题上显得“谨小慎微、畏首畏尾”。
他将其归因于RLHF(基于人类反馈的强化学习)训练,它会奖励安全、保守的输出,而非大胆试验。代理具备提出有创意变更的能力,但其天性倾向于求稳。
固定的 5 分钟训练窗口也是一层约束。
能很快显露价值的改动会被发现;只有长时间训练才能证明价值的改动则会“隐形”。此外,在同一验证集上运行 100 次实验也有过拟合风险:某些改进也许只针对该评测集有效,而非真正的泛化提升。作为系统公平性保证的 prepare.py 不可变性,也成为它的盲点。
社区正在讨论天花板来自框架,还是来自底层模型。提案包括元提示优化(由第二个代理根据结果改写 program.md)、多样性指令(在奖励改进的同时奖励新颖性)、以及周期性“重置”实验(从更早的检查点重新开始)以逃离局部最优。
目前,AutoResearch 是一个自动化机器学习研究中“有条不紊部分”的工具:批量运行并评估数百个小实验。它并不替代“创造性部分”——制定新的研究方向——这仍然是人类的工作。这样的分工也清楚地表明了该工具是否适合纳入您的工作流。
何时使用 AutoResearch
三文件契约(不可变评测器、代理可改的实现、人类撰写的方向)不仅适用于LLM 训练,也适用于任何能定义自动打分函数的领域。
搜索排序优化、商品分类、临床命名实体识别、欺诈评分、意图分类:这些任务具备合适的特征。模型较小、可在数分钟内训练完成;打分函数清晰;且在放大规模时改进可迁移。
当实验运行速度比人类管理快 100 倍时,评测流水线就会变成瓶颈。静态基准很快会“打穿”。采用这种模式的团队需要与生产数据同步演进的评测集,以及更难的边缘案例。
Karpathy 本人用他的生产框架 nanochat 在 8x H100 GPU 上运行了 AutoResearch 的“更大近亲”,这说明该模式不止于玩具实验。社区已将其分叉到macOS/Apple Silicon,并提出了对旧 GPU 的集成建议。CPU 与 GPU 指南 解释了为何这类迭代训练离不开 GPU 硬件。
如果您的目标是在一条已充分理解的训练流水线上挤出增量改进,AutoResearch 很合适。由于创造力天花板的存在,对于需要真正新意的问题,您仍需要人类研究者;而该工具最适用于占多数的、以方法性迭代为主的研究。
结语
写好 program.md 的前提,是您自己做过这项研究。您需要知道哪些方向值得尝试、对您的问题而言“更好”意味着什么、以及何时增量收益已到尽头。代理负责执行,但研究议程背后的判断仍是人类的。如果下一代工程师因为代理能接手而跳过了这段奠基性的修炼,这个领域将会拥有充沛的算力,却缺少能为其指明方向的经验。


Andrej Karpathy 的 AutoResearch 是一个开源工具,以循环方式运行机器学习实验,只保留击败当前最佳结果的改动。您在一个 markdown 文件里描述研究方向,把 AI 编码代理指向代码库,然后就可以离开。到早上,您会得到一份包含已验证改进的 git 历史,以及代理尝试过的一切操作日志。
该项目于 2026 年 3 月 7 日发布,数日内便收获 21,000+ GitHub Star,Karpathy 的公告获得 860 万次浏览。本文介绍三文件架构的工作方式、夜间运行中棘轮循环做了什么、AutoResearch 目前取得了哪些结果,以及这种方法的边界所在。
什么是 AutoResearch?
AutoResearch 是一个开源 Python 工具,让 AI 代理在单块 GPU 上无人干预地运行机器学习实验。它循环执行“提出—训练—评估”的周期,只保留能降低验证损失的改动。项目以 MIT 许可发布。
这不是超参数调优。像 Optuna 或 Ray Tune 这样的工具在预定义的参数空间中搜索。AutoResearch 则允许代理修改任意代码。搜索空间就是 LLM 能想到的一切,这使它与当前可用的任何工具都属于不同的类别。
AutoML 和 NAS(神经架构搜索)框架使用结构化算法在架构或超参数上搜索,精确但受限于其定义的搜索空间。
AlphaEvolve(Google DeepMind)进一步采用进化式方法并使用 Gemini 模型进行算法发现,但它是闭源的,大多数团队无法使用。通用型编码代理如 SWE-Agent、OpenHands 和 Aider 能编写任意代码,但它们并非为机器学习研究所需的“实验—评估—保留/回退”循环而构建。
AutoResearch 押注于 LLM 的通识来提出优质实验,而不是通过收紧搜索空间来获取数学保证。
从“vibe coding”到研究顾问
Karpathy 将此视为工程师与 AI 协作方式的自然演进。2026 年 2 月,他提出了“agentic engineering(代理式工程)”这一术语:“99% 的时间里,您并不直接写代码。您在编排执行任务的代理,并承担监督角色。”AutoResearch 则更进一步。人类甚至不再编排。他们在一个 markdown 文件里描述好的研究应是什么样,然后离开。
这种演进路径是:vibe coding(人类提示、AI 写码、人类审阅)→ 代理式工程(人类实时编排代理)→ 完全独立研究(人类设定方向,代理自主运行)。
每一步都在削弱人类的角色:从作者到导演,再到(借用 Karpathy 的表述)研究顾问。
在后续文章中,他描述了下一步:“目标不是模拟一个博士生,而是模拟一个由他们组成的研究共同体”,指的是一种类似 SETI@home 的分布式代理协作。
系统如何将这一愿景落地,归结到三个文件。
AutoResearch 的三文件架构
AutoResearch 的设计归结为三个文件之间的契约,每个文件都有严格的“谁可以触碰”的规则。
prepare.py
prepare.py负责数据准备与评估。它构建一个 8,192 词表的 BPE(Byte Pair Encoding,字节对编码)分词器,处理训练语料,并定义验证指标:val_bpb(验证 bits-per-byte)。此文件不可变:无论人类还是代理都不能修改它,从而保证每次实验都以相同的标尺来衡量。
train.py
train.py是代理的沙盒:共 630 行,包含 GPT 模型架构、Muon+AdamW优化器,以及完整训练循环。只要修改后的代码仍能训练并产出val_bpb分数,代理便可以在此处重写任何内容(更换激活函数、重构注意力头、调整学习率调度、修改权重初始化等)。program.md
program.md用纯 markdown 编写,是人类作者唯一会触碰的文件。它告诉代理要追求哪些研究方向、避免哪些路径,以及如何开展实验。program.md控制什么该文件比大多数人预期的更具体。它硬编码了基线指标,让代理知道需要超越什么(
val_bpb:0.997900,显存峰值:45 GB)。它明确给出运行实验和提取结果的具体命令。它告诉代理如何处理失败:修正拼写错误并重跑;从根上有问题的想法跳过;任何运行超过 10 分钟的进程一律终止。
而让整个系统运转的关键指令也包含其中:“永远不要停止。一旦实验循环开始,切勿暂停向人类询问是否继续。”
还有一个影响每个实验的设计约束:“在其他条件相同的情况下,越简单越好。哪怕是小幅改进,如果带来丑陋的复杂度,也不值得。”这会引导代理远离过度工程的解决方案,转向人类审阅者会认可的干净改动。
分工非常清晰。人类通过
program.md设定研究方向,代理通过修改train.py来执行,prepare.py则作为双方都不能触碰的中立评判者。有了这份契约,代理就能不间断地运行实验循环。AutoResearch 棘轮循环
AutoResearch 的核心是无需人工参与的实验循环。基于
program.md中定义的 9 步循环,单次迭代如下:program.md,理解当前研究优先级与约束。train.py和results.tsv中的近期结果。train.py以实现所提变更。val_bpb评估结果,并将结果记录到results.tsv。val_bpb变好:保留提交。否则:git reset HEAD~1回退到上一版本。然后从第 1 步重新开始。
每个实验都获得相同的 5 分钟挂钟时间预算,使得结果可直接比较。训练更快的改动与收敛更低的改动在同一起跑线被评估。
按每个实验 5 分钟计算,系统每小时可运行约 12 个实验。
“棘轮”之名来自 git 历史。每个成功实验都会新增一次提交;每个失败都会被回退。代码库只能前进,不能后退,一次只积累一个经过验证的改进。
将 Git 作为研究记忆
其结构类似进化算法,但 AutoResearch 只保留单一谱系,而非种群。没有候选之间的交叉与变异,LLM 同时扮演变异算子(提出更改)和选择压力(基于过往结果选择要尝试的方向)。
它会读取自己的 git 历史和
results.tsv,在有希望的尝试上继续深入。该
results.tsv文件跟踪每个实验:提交哈希、val_bpb分数、GPU 显存占用、通过/失败状态,以及代理尝试内容的描述。您可以在早上查看一条清晰的审计轨迹;代理也用同一日志来校准下一步要尝试的内容。早期实验往往更宽泛(测试不同优化器配置),而后期会聚焦于数据已验证的方向。
开始使用 AutoResearch
运行 AutoResearch 需要一台带 NVIDIA GPU 的机器(默认配置面向显存 20GB+ 的现代 GPU)、Python 3.10+、
uv,以及一个编码代理(Claude Code、Cursor 或类似工具)。克隆仓库、安装依赖并准备数据集:
没有编排脚本。没有
run.py、没有流水线、也没有框架。README 的说法是“就直接在这个仓库里启动您的 Claude/Codex 或任何您想用的工具”。
您在项目目录中打开一个编码代理,提示它阅读
program.md,之后代理就会自行运行实验循环。LLM 本身就是自动化层。通过实时查看
results.tsv或检查 git 日志中新提交的方式来观察进展。默认配置会在 FineWeb-Edu 数据集上训练一个 GPT 模型,这需要一块不错的 GPU,并耗时数小时才能看到结果。若首次在较小硬件上测试,Karpathy 建议切换到 TinyStories 数据集,并通过将词表大小降至 256、深度降至 4 来缩小模型规模。
这些改动会降低显存需求,并缩短每次实验的耗时,使您能在数小时内看到棘轮效应的实际表现。
配置您的首次运行
在启动通宵运行之前,先阅读默认的
program.md。它定义了代理所遵循的研究议程,您通过编辑它来引导实验。如果您希望代理聚焦注意力机制,请在
program.md中说明。如果您希望它避免触碰优化器,也请添加该约束。代理不会偏离文件中写明的内容。
首次的通宵运行,可预期 80–100 个实验,可能保留 15–20 个改进。还有一些实用提示:
results.tsv,而不是盯着终端。逐步改善的val_bpb“阶梯”形态,比单条日志更能讲述全貌。AutoResearch 的结果与创造力天花板
AutoResearch 已在多次运行中得到验证,包括 Karpathy 自身实验、社区复现以及生产落地。
运行
实验数
保留的改进
结果
初次通宵(单 GPU)
83
15
val_bpb: 1.000 → 0.975
扩展 2 天运行(深度 12)
~700
~20
均为可叠加;迁移至深度 24 模型
生产影响
-
-
达到 GPT-2 基准所需时间:2.02h → 1.80h(快 11%)
社区会话
126
-
val_bpb: 0.9979 → 0.9697
代理找到了一个有条理的人类最终也会找到的东西。
QKnorm缺少用于锐化注意力的缩放乘子;Value Embeddings 受益于正则化;在带状注意力调参、AdamWbeta 参数以及权重衰减调度上也有提升。这些是结构性代码改动,而非随机的超参数扫掠;手动测试每一项会耗费数天。
Shopify CEO Tobi Lutke 将 AutoResearch 改造用于内部的查询扩展模型,在一个 8 亿参数模型上通过 37 次实验获得了 19% 的验证分数提升,并在启动后的第二天就报告了结果。
“阶梯图”是真实的,但每一步都不大。代理确实能找到改进:这里调整一个 beta 参数,那里加一点正则化。尚无人报告它发明了新颖的注意力机制,或提出了人类研究者最终也想不到的架构性创意。
创造力天花板
GitHub Issue #22 揭示了结构性问题。一位用户观察到,代理会在“上次有效”的附近做小幅变体循环,被困在局部搜索模式中。
棘轮只接受能立刻提升
val_bpb的变更,因此代理永远无法先退一步,为更大的收益做铺垫。而人类研究者常常会这样推理:“会先变差,然后变好。”棘轮没有留给这种策略的空间。
Karpathy 在Hacker News 上也承认了相关问题:代理在开放性问题上显得“谨小慎微、畏首畏尾”。
他将其归因于RLHF(基于人类反馈的强化学习)训练,它会奖励安全、保守的输出,而非大胆试验。代理具备提出有创意变更的能力,但其天性倾向于求稳。
固定的 5 分钟训练窗口也是一层约束。
能很快显露价值的改动会被发现;只有长时间训练才能证明价值的改动则会“隐形”。此外,在同一验证集上运行 100 次实验也有过拟合风险:某些改进也许只针对该评测集有效,而非真正的泛化提升。作为系统公平性保证的
prepare.py不可变性,也成为它的盲点。社区正在讨论天花板来自框架,还是来自底层模型。提案包括元提示优化(由第二个代理根据结果改写
program.md)、多样性指令(在奖励改进的同时奖励新颖性)、以及周期性“重置”实验(从更早的检查点重新开始)以逃离局部最优。目前,AutoResearch 是一个自动化机器学习研究中“有条不紊部分”的工具:批量运行并评估数百个小实验。它并不替代“创造性部分”——制定新的研究方向——这仍然是人类的工作。这样的分工也清楚地表明了该工具是否适合纳入您的工作流。
何时使用 AutoResearch
三文件契约(不可变评测器、代理可改的实现、人类撰写的方向)不仅适用于LLM 训练,也适用于任何能定义自动打分函数的领域。
搜索排序优化、商品分类、临床命名实体识别、欺诈评分、意图分类:这些任务具备合适的特征。模型较小、可在数分钟内训练完成;打分函数清晰;且在放大规模时改进可迁移。
当实验运行速度比人类管理快 100 倍时,评测流水线就会变成瓶颈。静态基准很快会“打穿”。采用这种模式的团队需要与生产数据同步演进的评测集,以及更难的边缘案例。
Karpathy 本人用他的生产框架
nanochat在 8x H100 GPU 上运行了 AutoResearch 的“更大近亲”,这说明该模式不止于玩具实验。社区已将其分叉到macOS/Apple Silicon,并提出了对旧 GPU 的集成建议。CPU 与 GPU 指南 解释了为何这类迭代训练离不开 GPU 硬件。如果您的目标是在一条已充分理解的训练流水线上挤出增量改进,AutoResearch 很合适。由于创造力天花板的存在,对于需要真正新意的问题,您仍需要人类研究者;而该工具最适用于占多数的、以方法性迭代为主的研究。
结语
写好
program.md的前提,是您自己做过这项研究。您需要知道哪些方向值得尝试、对您的问题而言“更好”意味着什么、以及何时增量收益已到尽头。代理负责执行,但研究议程背后的判断仍是人类的。如果下一代工程师因为代理能接手而跳过了这段奠基性的修炼,这个领域将会拥有充沛的算力,却缺少能为其指明方向的经验。