
Cours
Concevoir des systèmes agentiques évolutifs
1 h 30 min
20.4K
AutoResearch d’Andrej Karpathy est un outil open source qui exécute en boucle des expériences de ML et ne conserve que les changements qui battent le meilleur résultat courant. Vous décrivez les pistes de recherche dans un fichier markdown, vous connectez un agent IA de codage au dépôt, puis vous laissez tourner. Au matin, vous disposez d’un historique git d’améliorations validées et d’un journal complet de tout ce que l’agent a tenté.
Publié le 7 mars 2026, le projet a engrangé plus de 21 000 étoiles GitHub et 8,6 millions de vues sur l’annonce de Karpathy en quelques jours. Cet article explique le fonctionnement de l’architecture en trois fichiers, détaille ce que fait la boucle à cliquet pendant les runs de nuit, présente les résultats obtenus par AutoResearch à ce jour et pointe les limites de l’approche.
AutoResearch est un outil Python open source qui permet à un agent IA d’exécuter des expériences de ML sur un seul GPU sans intervention humaine. Il enchaîne des cycles proposer–entraîner–évaluer et ne conserve que les changements qui améliorent la perte de validation. Le projet est publié sous licence MIT.
Ce n’est pas de l’optimisation d’hyperparamètres. Des outils comme Optuna ou Ray Tune explorent un espace de paramètres prédéfini. AutoResearch laisse la liberté à l’agent de modifier n’importe quel code. L’espace de recherche est ce que le LLM est capable d’imaginer : c’est une autre catégorie d’outil que ce qui existe aujourd’hui.
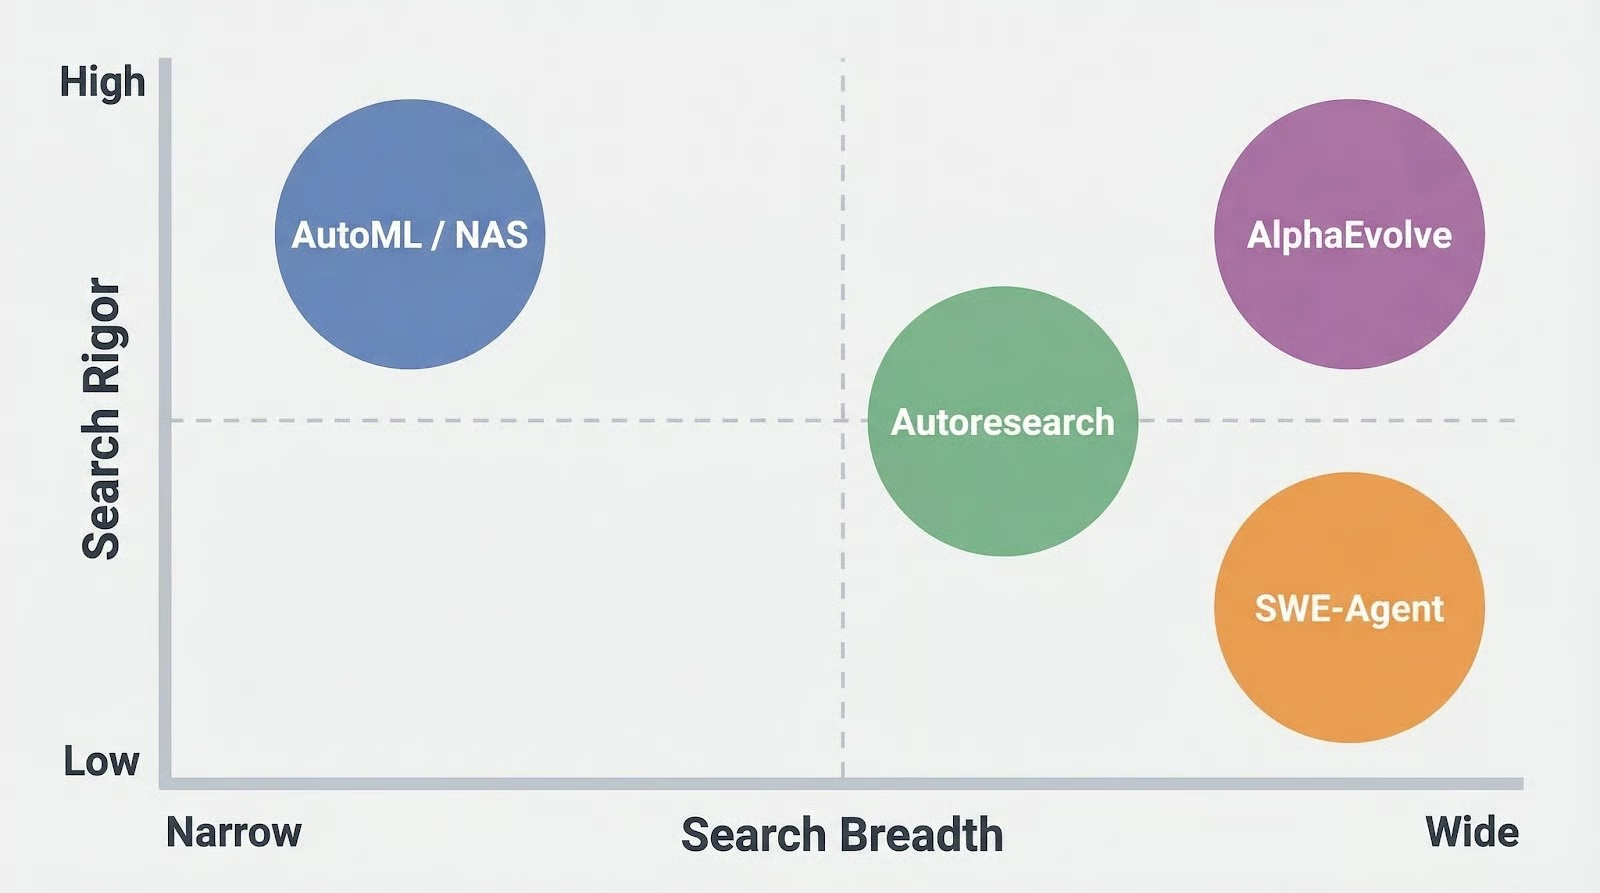
Les frameworks AutoML et NAS (Neural Architecture Search) explorent des architectures ou hyperparamètres via des algorithmes structurés : précis, mais limités à leur espace de recherche défini.
AlphaEvolve (Google DeepMind) va plus loin avec une approche évolutionnaire et des modèles Gemini pour la découverte d’algorithmes, mais c’est fermé et inaccessible à la plupart des équipes. Les agents de codage généralistes comme SWE-Agent, OpenHands et Aider peuvent écrire du code arbitraire, mais ne sont pas conçus pour le cycle expérimenter–évaluer–garder/rétablir qu’exige réellement la recherche en ML.
AutoResearch parie sur la connaissance générale du LLM pour proposer de bonnes expériences, plutôt que de restreindre l’espace de recherche pour des garanties mathématiques.
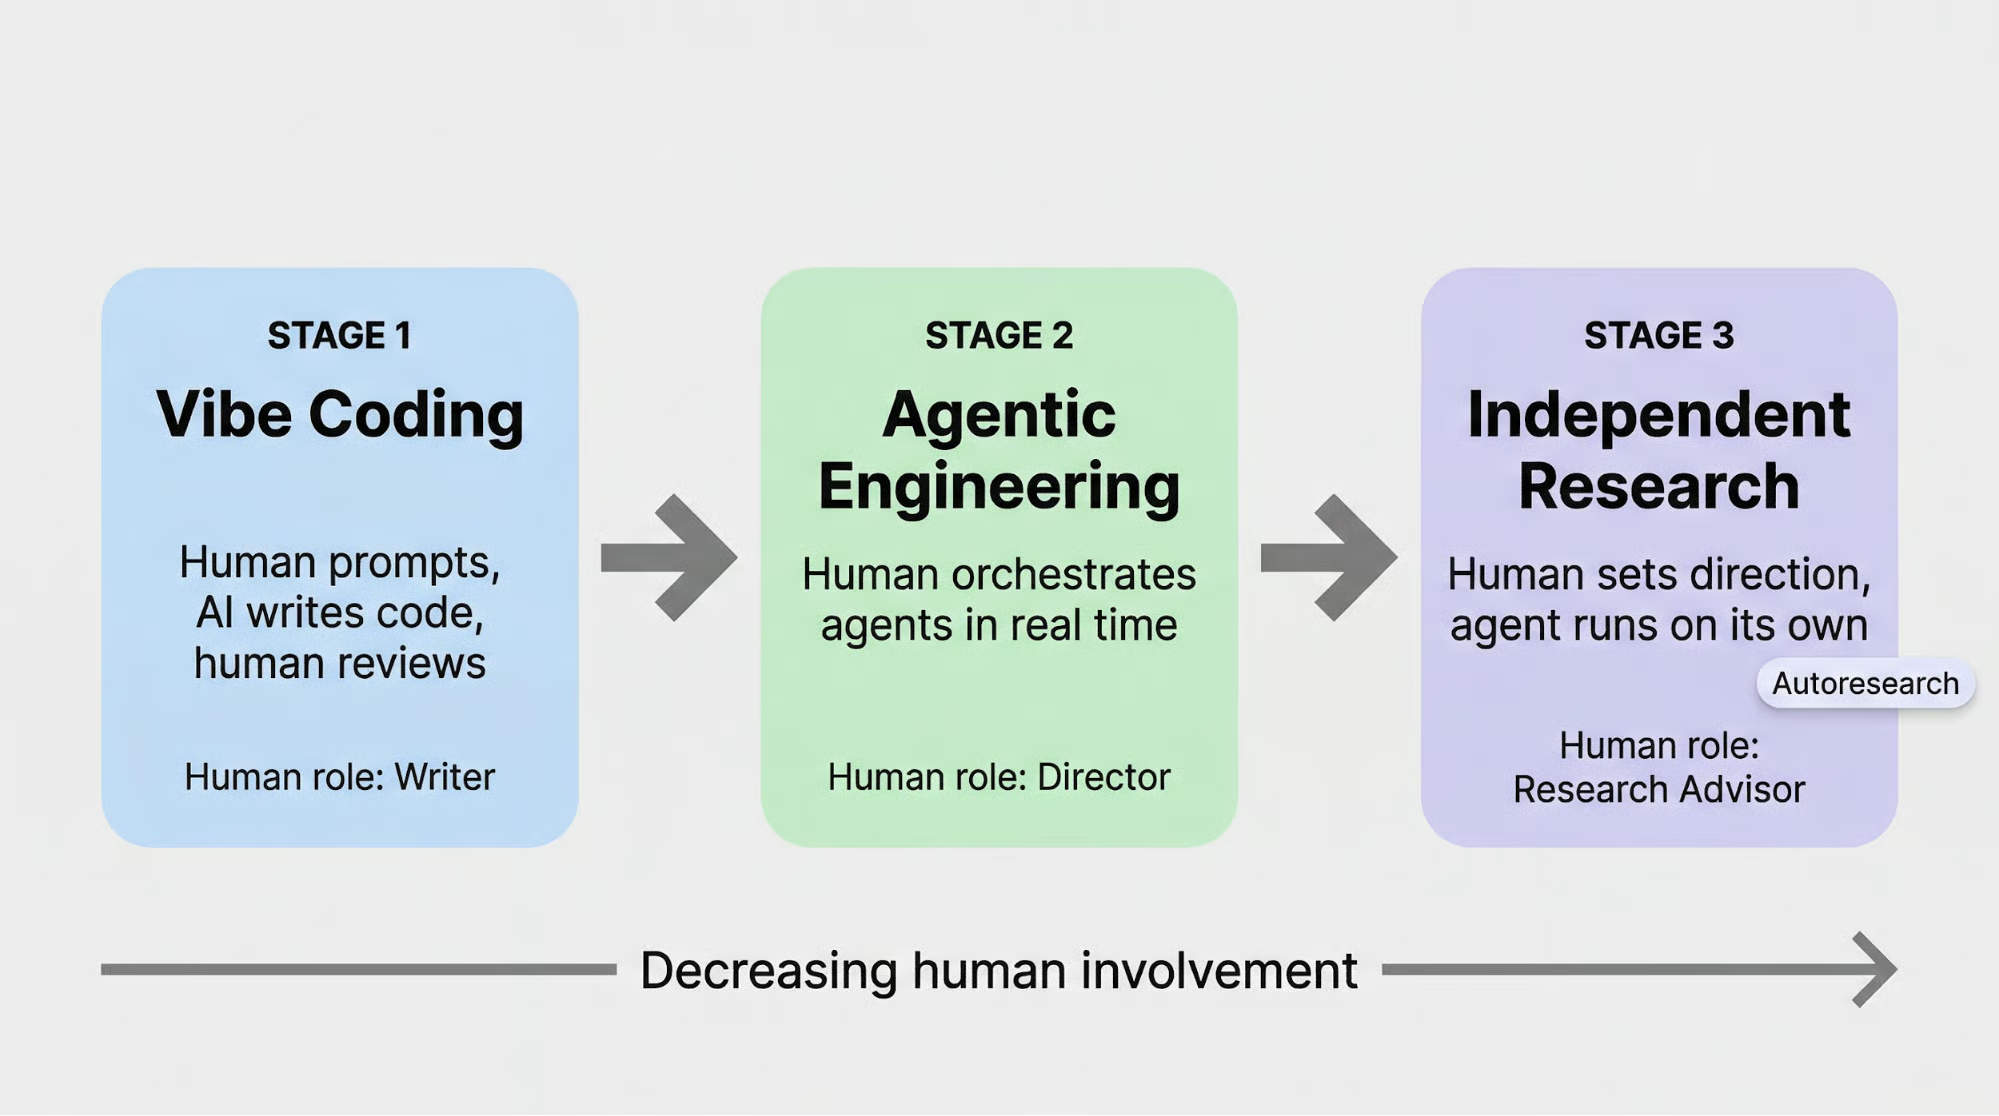
Karpathy présente cela comme une évolution naturelle de la collaboration entre ingénieurs et IA. En février 2026, il a forgé le terme « agentic engineering » : « Vous n’écrivez pas le code directement 99 % du temps. Vous orchestrez des agents qui le font et vous assurez la supervision. » AutoResearch pousse l’étape suivante : l’humain n’orchestre même plus. Il décrit ce qu’est une bonne recherche dans un fichier markdown et s’éloigne.
La progression va du « vibe coding » (l’humain propose, l’IA code, l’humain relit) à l’agentic engineering (l’humain orchestre des agents en temps réel) jusqu’à la recherche entièrement autonome (l’humain fixe la direction, l’agent exécute seul).
À chaque étape, le rôle de l’humain se réduit, passant de rédacteur à metteur en scène puis, dans le cadre proposé par Karpathy, à conseiller scientifique.
Dans un billet suivant, il décrit l’étape d’après : « Le but n’est pas d’émuler un doctorant isolé, mais une communauté de recherche », en référence à une collaboration distribuée d’agents façon SETI@home.
La mise en œuvre de cette vision tient en trois fichiers.
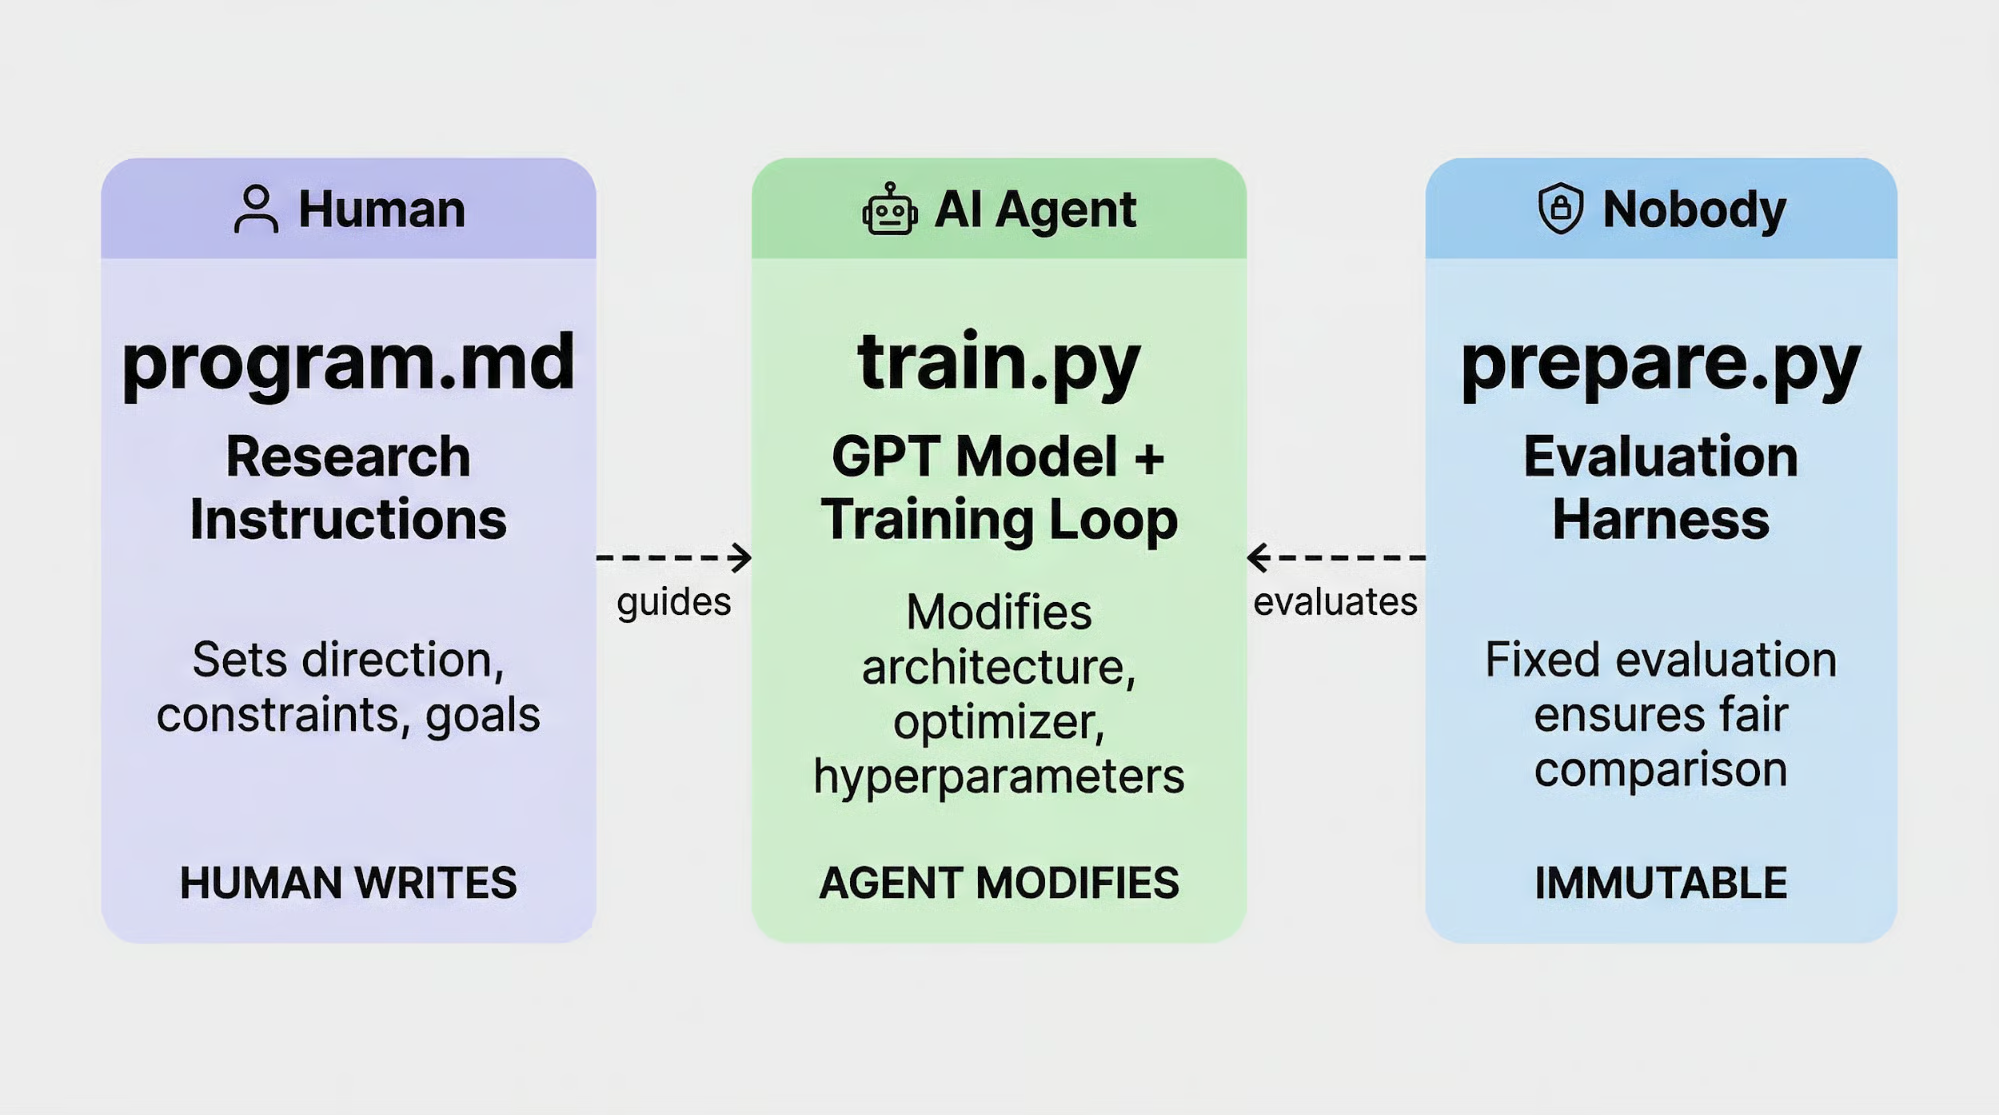
La conception d’AutoResearch repose sur un contrat entre trois fichiers, chacun avec des règles strictes sur qui peut y toucher.
prepare.py gère la préparation des données et l’évaluation. Il construit un tokenizer BPE (Byte Pair Encoding) avec un vocabulaire de 8 192 tokens, traite le corpus d’entraînement et définit la métrique de validation : val_bpb (bits par octet en validation).
Ce fichier est immuable : ni l’humain ni l’agent ne le modifient, ce qui garantit que chaque expérience est mesurée avec le même étalon.
train.py est le bac à sable de l’agent : 630 lignes qui contiennent l’architecture du modèle GPT, l’optimiseur Muon+AdamW et la boucle d’entraînement complète. L’agent peut tout réécrire ici (changer les fonctions d’activation, restructurer les têtes d’attention, modifier les plannings de taux d’apprentissage, ajuster l’initialisation des poids) tant que le code modifié s’entraîne et produit un score val_bpb.
program.md est un simple fichier markdown et le seul que l’auteur humain édite. Il indique à l’agent quelles pistes de recherche poursuivre, quoi éviter et comment aborder les expériences.
program.mdLe fichier est plus précis qu’on ne l’imagine. Il inscrit en dur des métriques de référence pour que l’agent sache quoi dépasser (val_bpb : 0,997900, VRAM (mémoire vidéo) crête : 45 Go).
Il précise les commandes exactes pour lancer les expériences et extraire les résultats. Il indique comment gérer les échecs : corriger les fautes de frappe et relancer, ignorer les idées cassées à la racine, tuer toute exécution qui dépasse 10 minutes.
Et il inclut la directive qui fait fonctionner l’ensemble : « NE VOUS ARRÊTEZ JAMAIS. Une fois la boucle d’expérimentation lancée, ne faites PAS de pause pour demander à l’humain si vous devez continuer. »
Une contrainte de conception guide également chaque expérience : « Toutes choses égales par ailleurs, la simplicité prime. Un petit gain qui ajoute de la complexité disgracieuse n’en vaut pas la peine. » Cela détourne l’agent des usines à gaz et l’oriente vers des modifications nettes qu’un relecteur humain approuverait.
La répartition des rôles est claire. L’humain fixe la direction via program.md, l’agent exécute en modifiant train.py, et prepare.py est l’arbitre neutre que personne ne peut toucher. Avec ce contrat, l’agent enchaîne la boucle d’expériences sans s’arrêter.
Le cœur d’AutoResearch est un cycle d’expériences sans intervention humaine. Voici une itération, selon la boucle en 9 étapes définie dans program.md :
program.md pour comprendre les priorités et contraintes de recherche.train.py courant et les résultats récents dans results.tsv.train.py pour mettre en œuvre le changement proposé.val_bpb et consigne l’issue dans results.tsv.val_bpb s’améliore : le commit reste. Sinon : git reset HEAD~1 rétablit la version précédente.Puis il recommence à l’étape 1.
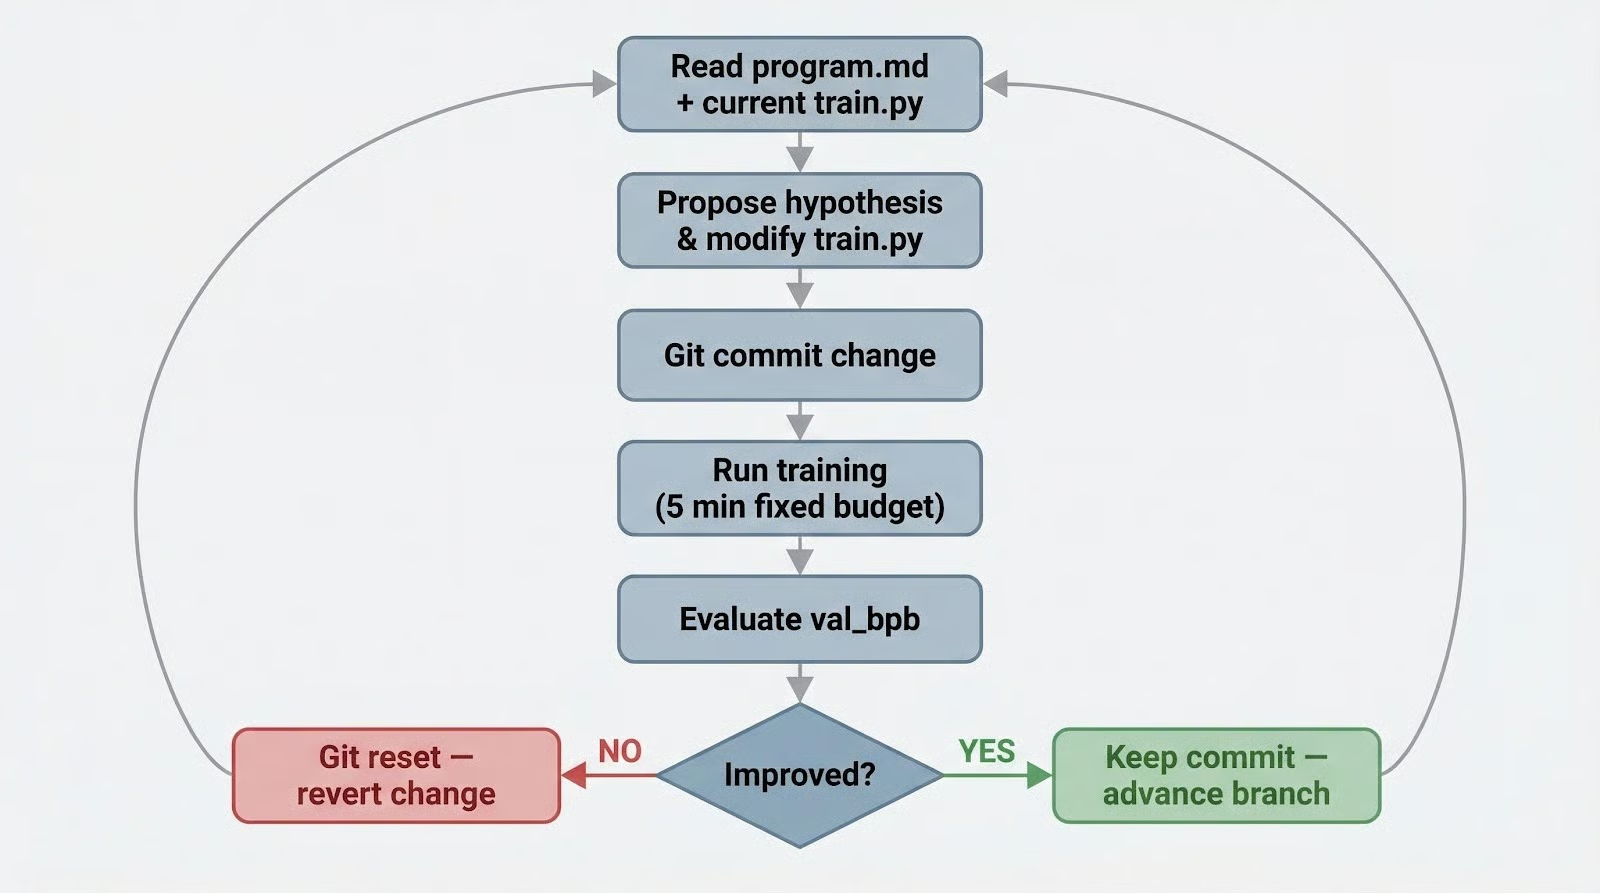
Chaque expérience reçoit le même budget de 5 minutes, rendant les résultats directement comparables. Une modification qui entraîne plus vite et une autre qui converge plus bas sont évaluées à armes égales.
À 5 minutes par expérience, le système en exécute environ 12 par heure.
Le terme « cliquet » vient de l’historique git. Chaque expérience réussie ajoute un commit ; chaque échec est annulé. La base de code ne peut qu’avancer, jamais reculer, en accumulant des améliorations validées une par une.
La structure rappelle les algorithmes évolutionnaires, mais AutoResearch conserve une lignée unique plutôt qu’une population. Au lieu de croisements et mutations entre candidats, le LLM joue à la fois l’opérateur de mutation (proposer des changements) et la pression de sélection (choisir quoi essayer selon les résultats passés).
Il lit son propre historique git et results.tsv pour capitaliser sur ce qui a montré du potentiel.
Le fichier results.tsv trace chaque expérience : hash de commit, score val_bpb, mémoire GPU utilisée, statut succès/échec et description de ce qu’a tenté l’agent.
Vous obtenez une piste d’audit claire à consulter le matin, et l’agent s’appuie sur le même journal pour calibrer la suite. Les premières expériences sont souvent larges (tester différentes configurations d’optimiseur), puis se recentrent sur la direction que les données ont validée.
Pour exécuter AutoResearch, il vous faut une machine avec GPU NVIDIA (la configuration par défaut vise des GPU modernes avec plus de 20 Go de VRAM), Python 3.10+, uv et un agent de codage (Claude Code, Cursor ou équivalent).
Clonez le dépôt, installez les dépendances et préparez le jeu de données :
git clone https://github.com/karpathy/autoresearch.git
cd autoresearch
uv sync
uv run prepare.py
Il n’y a pas de script d’orchestration. Pas de run.py, pas de pipeline, pas de framework.
Le README indique de « simplement lancer votre Claude/Codex ou autre dans ce dépôt ».
Vous ouvrez un agent de codage dans le répertoire du projet, lui demandez de lire program.md, et l’agent exécute la boucle d’expériences en autonomie.
Le LLM fait office de couche d’automatisation. Suivez l’avancement en « taillant » results.tsv ou en consultant le journal git pour de nouveaux commits.
La configuration par défaut entraîne un modèle GPT sur le jeu de données FineWeb-Edu, qui requiert un GPU correct et plusieurs heures pour voir des résultats. Pour un premier test sur un matériel plus modeste, Karpathy recommande de passer à TinyStories et de réduire l’échelle du modèle en limitant le vocabulaire à 256 et la profondeur à 4.
Ces changements réduisent la VRAM nécessaire et raccourcissent chaque expérience, ce qui permet d’observer le cliquet en action en quelques heures.
Lisez le program.md par défaut avant de lancer un run de nuit. Il définit l’agenda de recherche suivi par l’agent, et c’est en l’éditant que vous orientez les expériences.
Si vous voulez que l’agent se concentre sur les mécanismes d’attention, dites-le dans program.md.
Si vous voulez éviter toute modification de l’optimiseur, ajoutez cette contrainte. L’agent ne déviera pas de ce qui y est écrit.
Pour une première nuit, comptez 80 à 100 expériences, dont peut-être 15 à 20 améliorations conservées. Quelques points pratiques :
results.tsv le matin plutôt que de surveiller le terminal. Le motif en escalier des scores val_bpb raconte mieux l’histoire que les logs individuels.AutoResearch a été testé sur plusieurs runs, des expériences de Karpathy aux reproductions par la communauté, jusqu’à l’adoption en production.
|
Run |
Expériences |
Améliorations conservées |
Résultat |
|
Nuit initiale (un seul GPU) |
83 |
15 |
val_bpb : 1,000 → 0,975 |
|
Run étendu 2 jours (profondeur 12) |
~700 |
~20 |
Tous additifs ; transférés vers des modèles profondeur 24 |
|
Impact en production |
- |
- |
Temps vers le benchmark GPT-2 : 2,02 h → 1,80 h (11 % plus rapide) |
|
Session communauté |
126 |
- |
val_bpb : 0,9979 → 0,9697 |
L’agent a trouvé des éléments qu’un humain méthodique aurait finis par découvrir. QKnorm manquait d’un multiplicateur d’échelle pour affûter l’attention, les Value Embeddings bénéficient d’une régularisation, et des gains sont apparus dans le réglage de l’attention « banded », les paramètres bêta d’AdamW et la planification du weight decay.
Ce sont des changements structurels de code, pas des balayages aléatoires d’hyperparamètres, et tester chacun manuellement aurait pris des jours.
Le PDG de Shopify, Tobi Lütke, a adapté AutoResearch pour un modèle interne d’expansion de requêtes et a obtenu +19 % sur le score de validation après 37 expériences sur un modèle de 0,8 milliard de paramètres, avec des résultats publiés dès le lendemain.
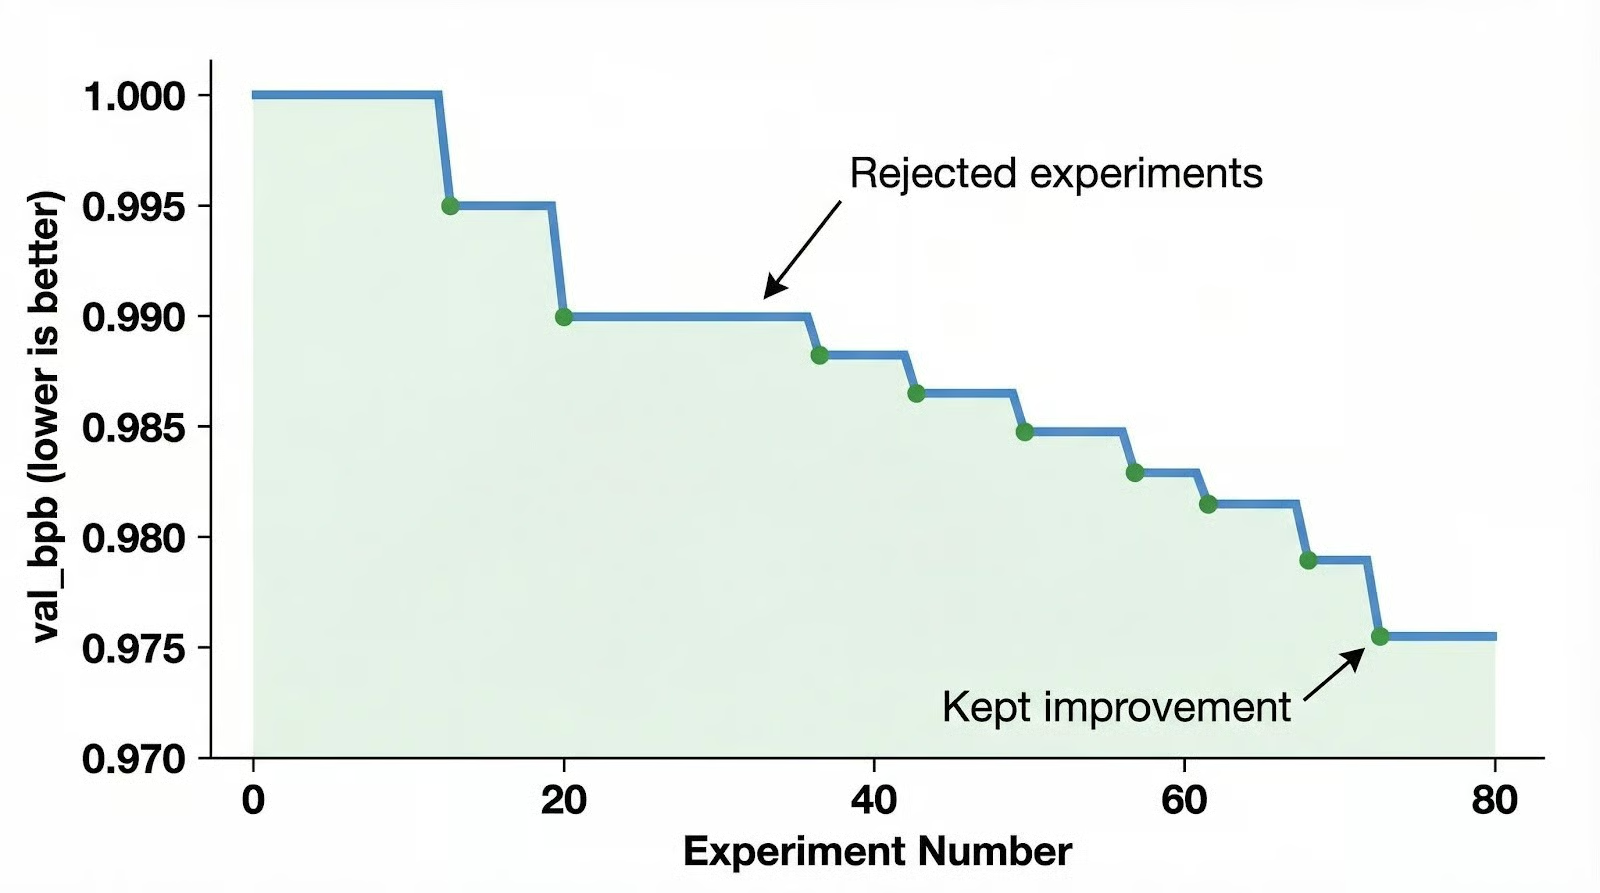
Le graphique en escalier est bien réel, mais chaque marche est modeste. L’agent trouve de vraies améliorations, en ajustant ici un paramètre bêta, là une régularisation. Personne n’a rapporté l’invention d’un mécanisme d’attention inédit ni d’une idée d’architecture qu’un·e chercheur·se n’aurait pas fini par envisager.
Le ticket GitHub n° 22 illustre le problème structurel. Un utilisateur a observé que l’agent enchaîne de petites variantes de ce qui a récemment marché, coincé dans une recherche locale.
Le cliquet n’accepte que les changements qui améliorent immédiatement le val_bpb, l’agent ne peut donc jamais reculer pour préparer un gain plus grand.
Les chercheurs humains raisonnent souvent : « ça empirera avant de s’améliorer. » Le cliquet n’a pas d’espace pour cela.
Karpathy a reconnu un problème lié sur Hacker News : l’agent paraît « prudent et craintif » sur des problèmes ouverts.
Il l’attribue à la RLHF (Reinforcement Learning from Human Feedback), qui récompense des sorties sûres et conservatrices plutôt que l’audace expérimentale. L’agent peut proposer des changements créatifs, mais il est conçu pour jouer la sécurité.
La fenêtre d’entraînement fixe de 5 minutes ajoute une autre contrainte.
Les changements dont la valeur se voit vite sont détectés ; ceux qui ne se prouvent qu’à plus long terme restent invisibles. Et exécuter 100 expériences sur le même jeu de validation comporte un risque de surapprentissage : certaines « améliorations » peuvent être spécifiques à cet eval plutôt que de vrais gains. L’immutabilité de prepare.py, garantie d’équité du système, est aussi son angle mort.
La communauté débat pour savoir si le plafond vient du cadre ou du modèle sous-jacent. Les pistes incluent l’optimisation du méta-prompt (un second agent réécrit program.md selon les résultats), des directives de diversité qui récompensent la nouveauté en plus du gain, et des expériences de « reset » périodiques repartant d’un état antérieur pour échapper aux optima locaux.
À ce stade, AutoResearch automatise la partie méthodique de la recherche en ML : lancer et évaluer des centaines de petites expériences. Il ne remplace pas la partie créative, qui consiste à formuler de nouvelles directions de recherche : cela reste l’affaire des humains. Cette répartition est aussi le meilleur indicateur pour savoir si l’outil a sa place dans votre flux de travail.
Le contrat en trois fichiers (évaluateur immuable, implémentation modifiable par l’agent, direction rédigée par l’humain) s’étend au-delà de l’entraînement de LLM à tout domaine où l’on peut définir une fonction de scoring automatique.
Optimisation du classement de recherche, catégorisation produit, reconnaissance d’entités cliniques nommées, scoring de fraude, classification d’intention : ces tâches ont les bons attributs. De petits modèles qui s’entraînent en minutes, des fonctions de score claires, et des gains qui se transfèrent à l’échelle.
Quand les expériences tournent 100 fois plus vite que ce qu’un humain peut gérer, le pipeline d’évaluation devient la contrainte. Les benchmarks statiques se saturent rapidement. Les équipes qui adoptent ce schéma ont besoin d’ensembles d’évaluation qui évoluent avec les données de production et des cas limites plus difficiles.
Karpathy lui-même fait tourner un « grand cousin » d’AutoResearch sur 8× H100 avec son framework de production nanochat, ce qui suggère que le schéma passe l’échelle au-delà des jouets. La communauté l’a déjà forké pour macOS/Apple Silicon et propose des intégrations pour des GPU plus anciens. Le guide CPU vs GPU explique pourquoi le GPU est incontournable pour ce type d’entraînement itératif.
Si votre objectif est de grappiller des points de performance sur une chaîne d’entraînement bien comprise, AutoResearch est indiqué. Le plafond de créativité implique que vous aurez toujours besoin de chercheurs humains pour les problèmes qui exigent de la vraie nouveauté, et l’outil est optimal pour la majorité des travaux de recherche qui relèvent de l’itération méthodique.
Rédiger un bon program.md suppose d’avoir mené la recherche vous-même. Vous devez savoir quelles pistes valent la peine, ce que « mieux » signifie pour votre problème et quand les gains incrémentaux ont fait le tour. L’agent gère l’exécution, mais le discernement derrière l’agenda de recherche reste humain. Si la prochaine génération d’ingénieurs saute cette étape formatrice parce que des agents la prennent en charge, le domaine aura beaucoup de compute, mais personne avec l’expérience pour l’orienter dans la bonne direction.
Top DataCamp Courses
Cours
Cours
Cours