Curso
Construindo Sistemas Agentic Escaláveis
1 h 30 min
20.4K
O AutoResearch de Andrej Karpathy é uma ferramenta open source que executa experimentos de ML em loop, mantendo apenas as mudanças que superam o melhor resultado atual. Você descreve as direções de pesquisa em um arquivo markdown, aponta um agente de IA para o repositório e deixa rodando. De manhã, você tem um histórico do git com melhorias validadas e um log de tudo que o agente tentou.
Lançado em 7 de março de 2026, o projeto conquistou mais de 21.000 estrelas no GitHub e 8,6 milhões de visualizações no anúncio de Karpathy em poucos dias. Este artigo explica como funciona a arquitetura de três arquivos, o que o loop ratchet faz durante as execuções noturnas, quais resultados o AutoResearch já produziu e onde essa abordagem encontra seus limites.
AutoResearch é uma ferramenta Python open source que permite a um agente de IA executar experimentos de ML em uma única GPU, sem intervenção humana. Ela passa por ciclos de propor-treinar-avaliar, mantendo apenas mudanças que melhoram a loss de validação. O projeto é distribuído sob licença MIT.
Isto não é ajuste de hiperparâmetros. Ferramentas como Optuna ou Ray Tune procuram em um espaço de parâmetros pré-definido. O AutoResearch dá ao agente liberdade para modificar qualquer parte do código. O espaço de busca é tudo o que o LLM conseguir imaginar, o que coloca a ferramenta em uma categoria diferente de qualquer coisa disponível hoje.
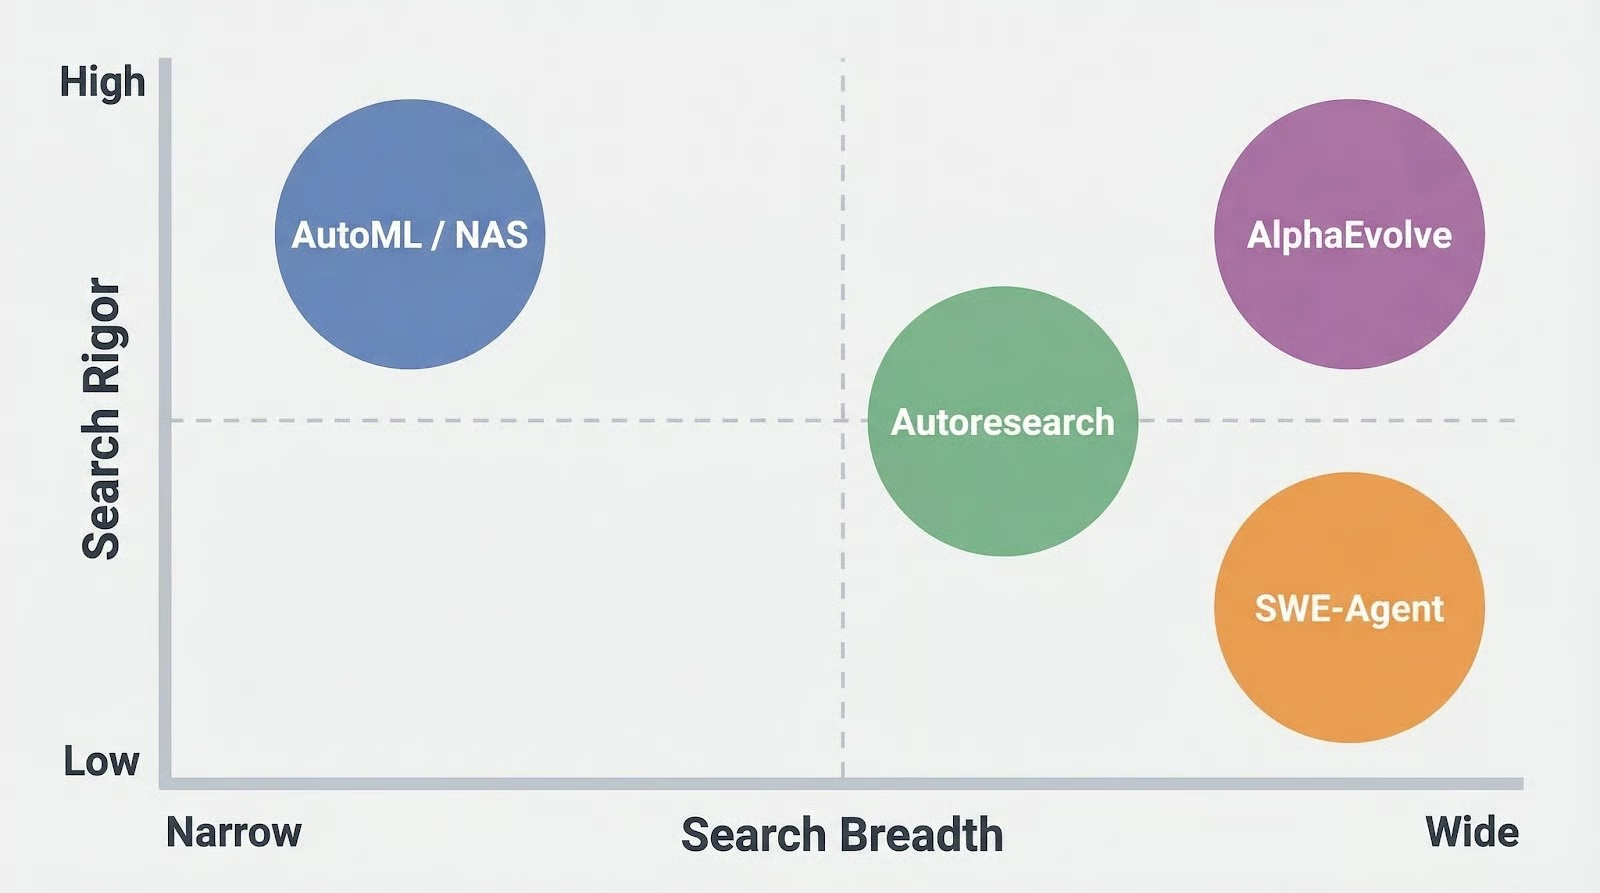
Frameworks de AutoML e NAS (Neural Architecture Search) fazem buscas sobre arquiteturas ou hiperparâmetros usando algoritmos estruturados, precisos, porém limitados ao espaço de busca definido.
O AlphaEvolve (Google DeepMind) vai além com uma abordagem evolutiva e modelos Gemini para descoberta de algoritmos, mas é fechado e inacessível para a maioria dos times. Agentes de código de propósito geral como SWE-Agent, OpenHands e Aider conseguem escrever código arbitrário, mas não foram feitos para o ciclo experimentar-avaliar-manter/reverter que a pesquisa em ML exige de fato.
O AutoResearch aposta no conhecimento geral do LLM para propor bons experimentos, em vez de restringir o espaço de busca para obter garantias matemáticas.
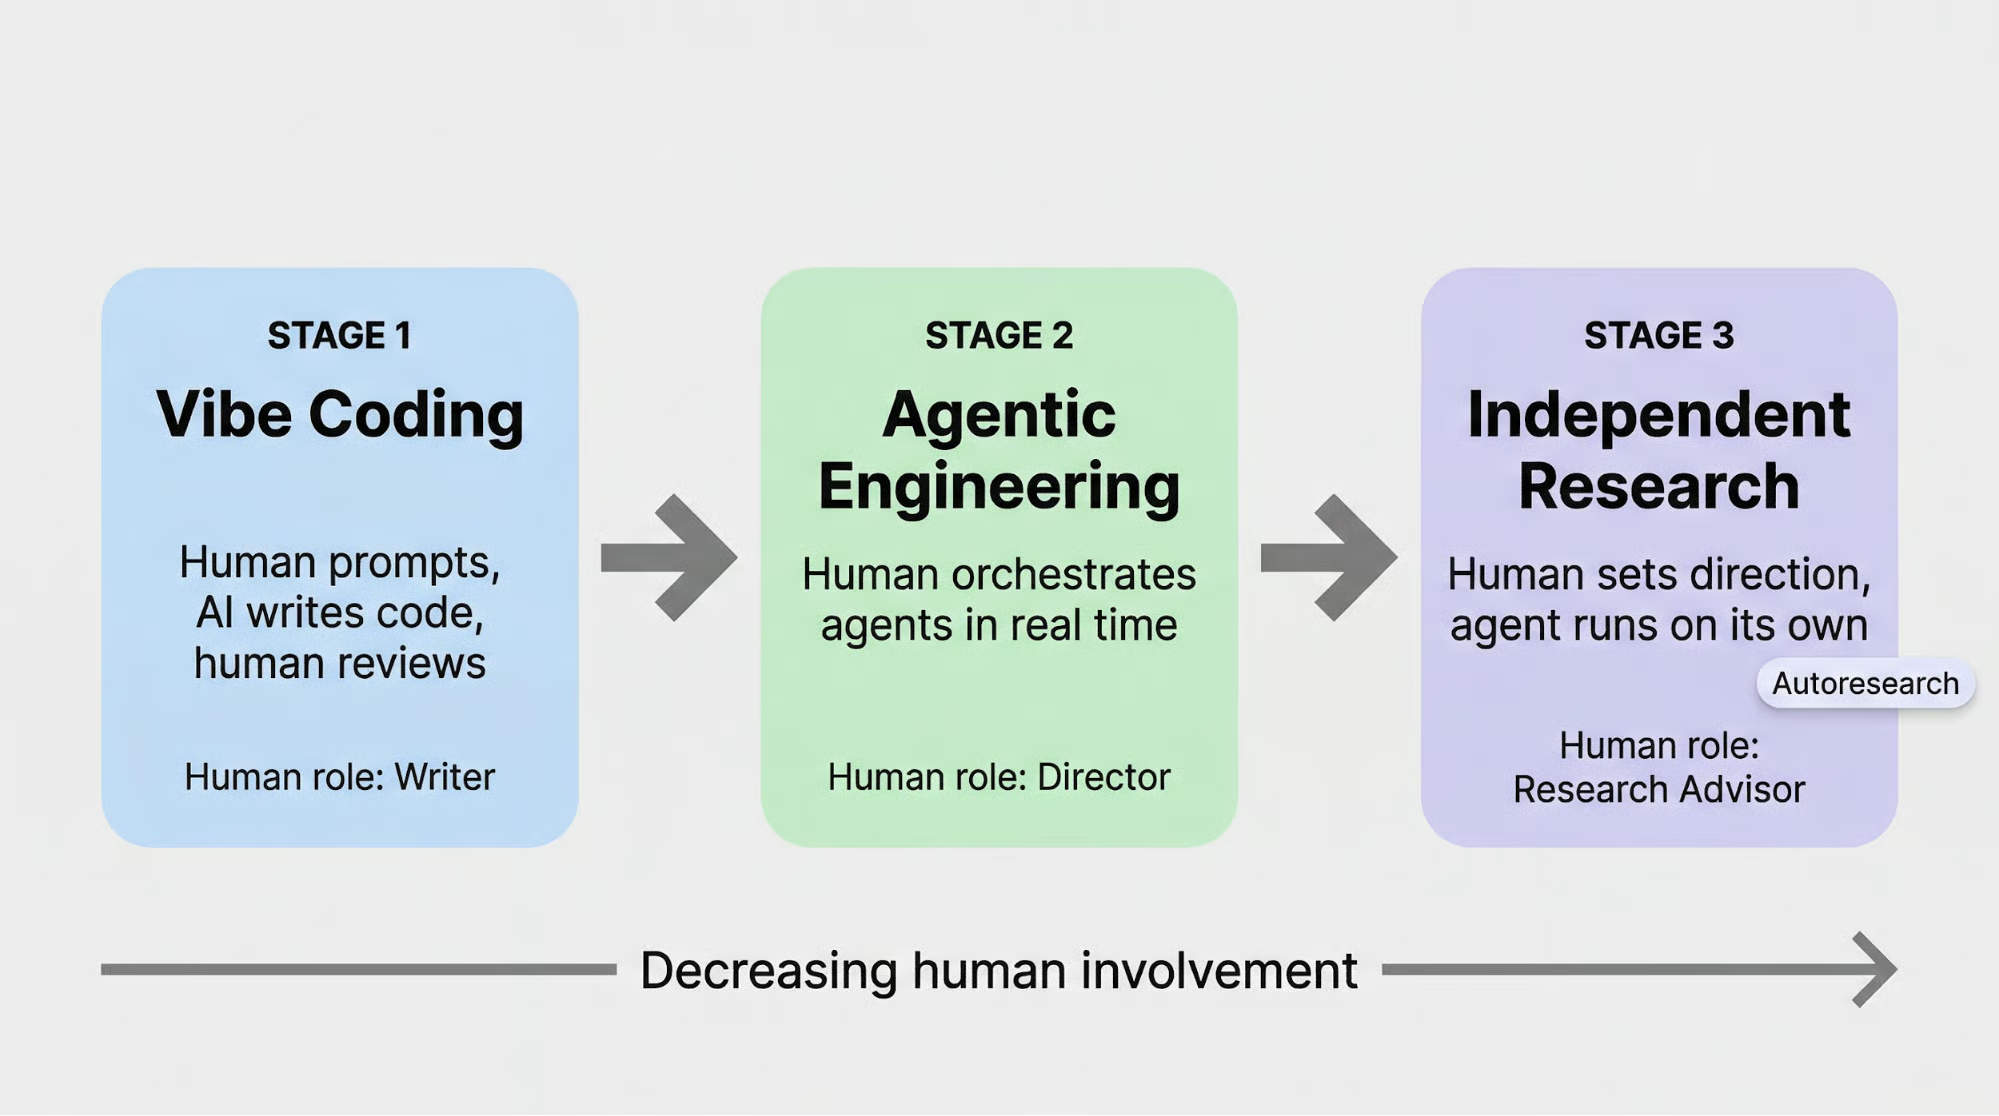
Karpathy apresenta isso como uma evolução natural de como engenheiros trabalham com IA. Em fevereiro de 2026, ele cunhou o termo "agentic engineering": "Você não escreve o código diretamente 99% do tempo. Você orquestra agentes que escrevem e atua como supervisão." O AutoResearch dá o próximo passo. O humano nem orquestra. Ele descreve o que é uma boa pesquisa em um arquivo markdown e vai embora.
A evolução é: vibe coding (humano faz prompts, IA escreve código, humano revisa) para agentic engineering (humano orquestra agentes em tempo real) até pesquisa totalmente independente (humano define a direção, agente roda sozinho).
A cada etapa o papel humano diminui: de redator a diretor e, na visão de Karpathy, a conselheiro de pesquisa.
Em um post seguinte, ele descreveu o próximo passo: "A meta não é emular um único estudante de PhD, é emular uma comunidade de pesquisa deles", fazendo referência a uma colaboração distribuída de agentes no estilo SETI@home.
Como o sistema implementa essa visão se resume a três arquivos.
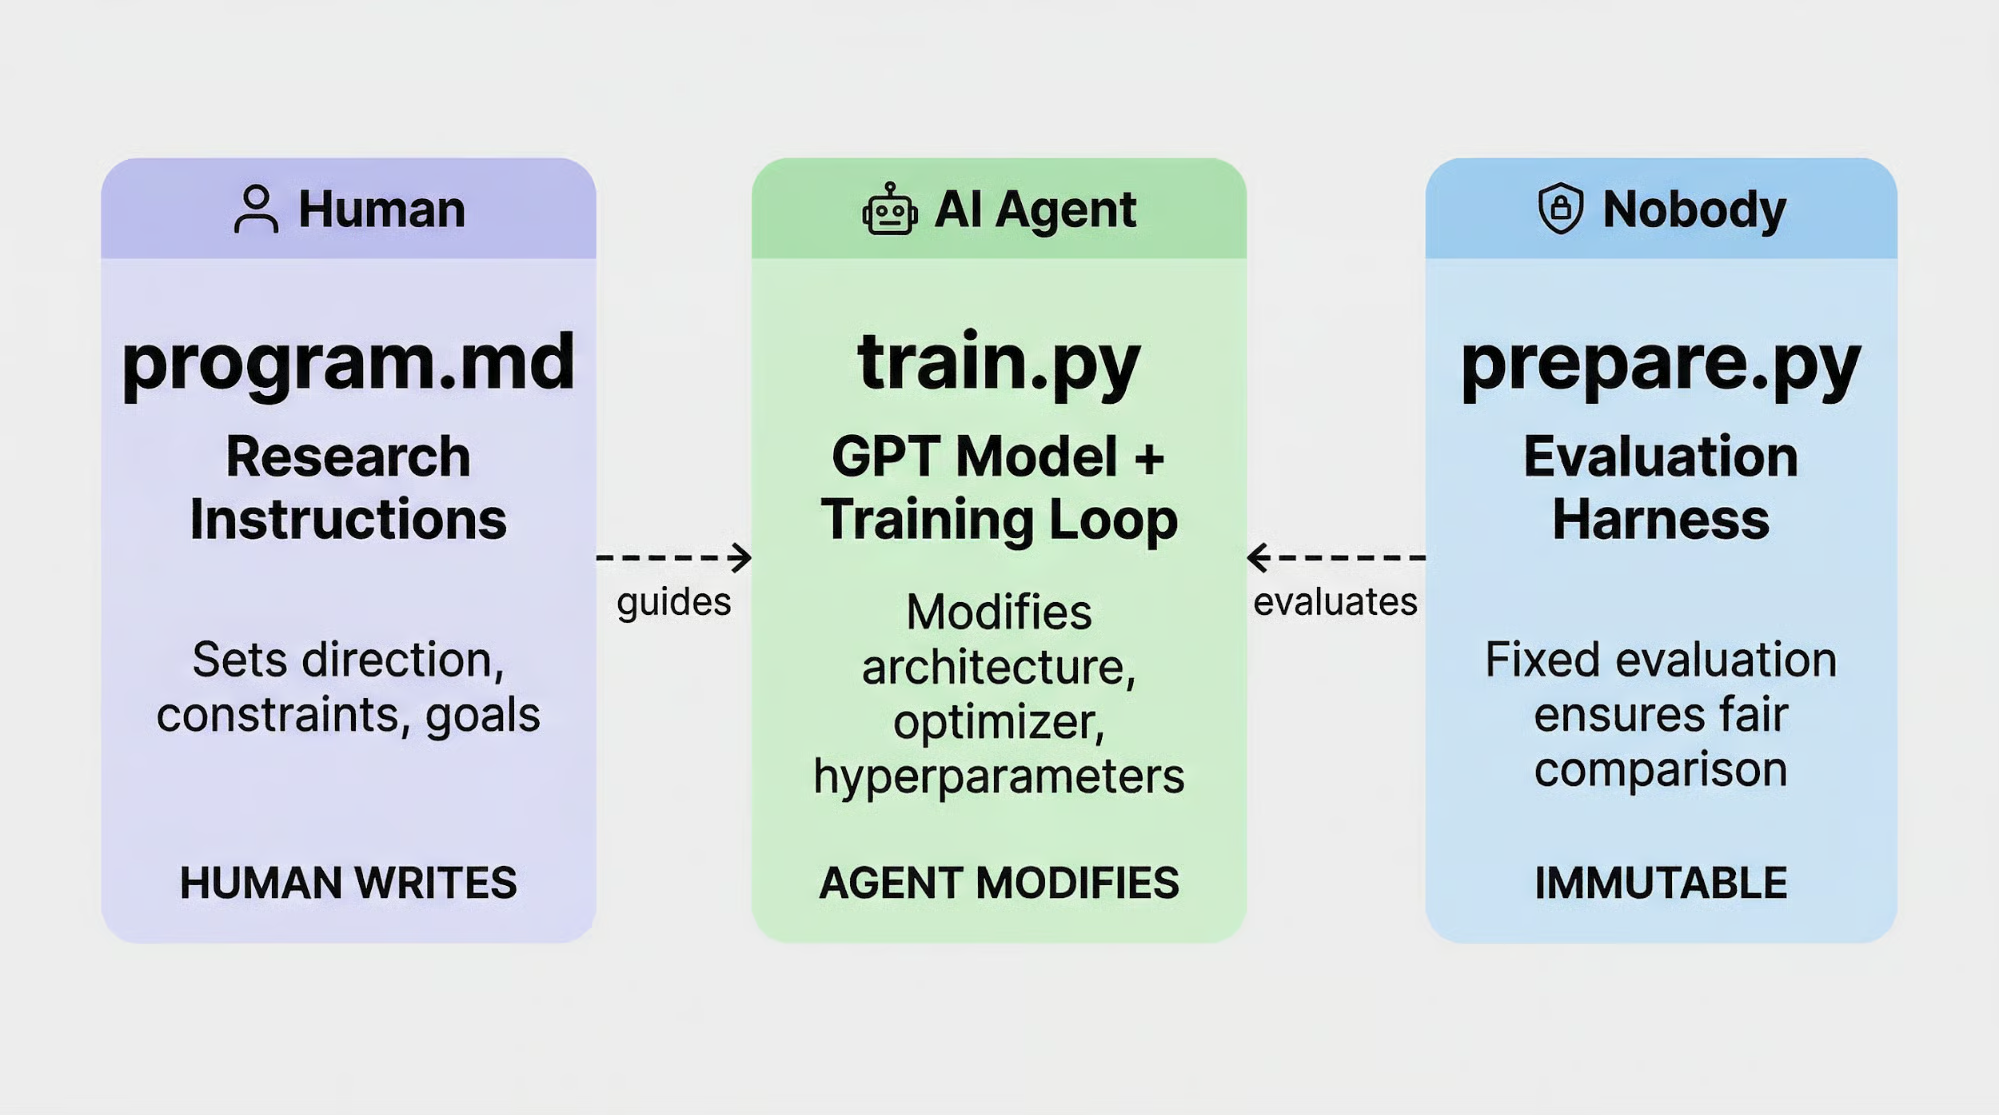
O design do AutoResearch se baseia em um contrato entre três arquivos, cada um com regras rígidas sobre quem pode mexer nele.
prepare.py cuida da preparação dos dados e da avaliação. Ele constrói um tokenizador BPE (Byte Pair Encoding) com vocabulário de 8.192 tokens, processa o corpus de treino e define a métrica de validação: val_bpb (bits por byte na validação).
Este arquivo é imutável: nem o humano nem o agente o modificam, o que garante que todo experimento é medido com a mesma régua.
train.py é o sandbox do agente: 630 linhas contendo a arquitetura do modelo GPT, o otimizador Muon+AdamW e todo o loop de treino. O agente pode reescrever qualquer coisa aqui (trocar funções de ativação, reestruturar heads de atenção, mudar cronogramas de learning rate, modificar inicialização de pesos) desde que o código modificado ainda treine e produza um score val_bpb.
program.md é escrito em markdown puro e é o único arquivo que o humano edita. Ele diz ao agente quais direções de pesquisa seguir, o que evitar e como conduzir os experimentos.
program.md controlaO arquivo é mais específico do que a maioria espera. Ele fixa métricas de baseline para o agente saber o que superar (val_bpb: 0,997900, pico de VRAM (memória de vídeo): 45 GB).
Ele especifica comandos exatos para rodar experimentos e extrair resultados. Diz ao agente como lidar com falhas: corrigir typos e rodar de novo, pular ideias quebradas na raiz, matar tudo que passar de 10 minutos.
E inclui a diretriz que faz todo o sistema funcionar: "NUNCA PARE. Depois que o loop de experimentos começar, NÃO pause para perguntar ao humano se deve continuar."
Há também uma restrição de design que molda cada experimento: "Mantidas as demais condições, o simples é melhor. Uma pequena melhora que adiciona complexidade feia não vale a pena." Isso afasta o agente de soluções overengineered e orienta para mudanças limpas que um revisor humano aprovaria.
A divisão de responsabilidades é clara. O humano define a direção da pesquisa via program.md, o agente executa modificando o train.py, e o prepare.py atua como juiz neutro que nenhum dos lados pode tocar. Com esse contrato, o agente roda o loop de experimentos continuamente, sem parar.
O núcleo do AutoResearch é um ciclo de experimentos que roda sem intervenção humana. Veja como funciona uma única iteração, seguindo o loop de 9 etapas definido no program.md:
program.md para entender prioridades e restrições de pesquisa atuais.train.py atual e os resultados recentes em results.tsv.train.py para implementar a mudança proposta.val_bpb e registra o desfecho em results.tsv.val_bpb melhorou: o commit fica. Se não: git reset HEAD~1 reverte para a versão anterior.Depois, começa de novo a partir do passo 1.
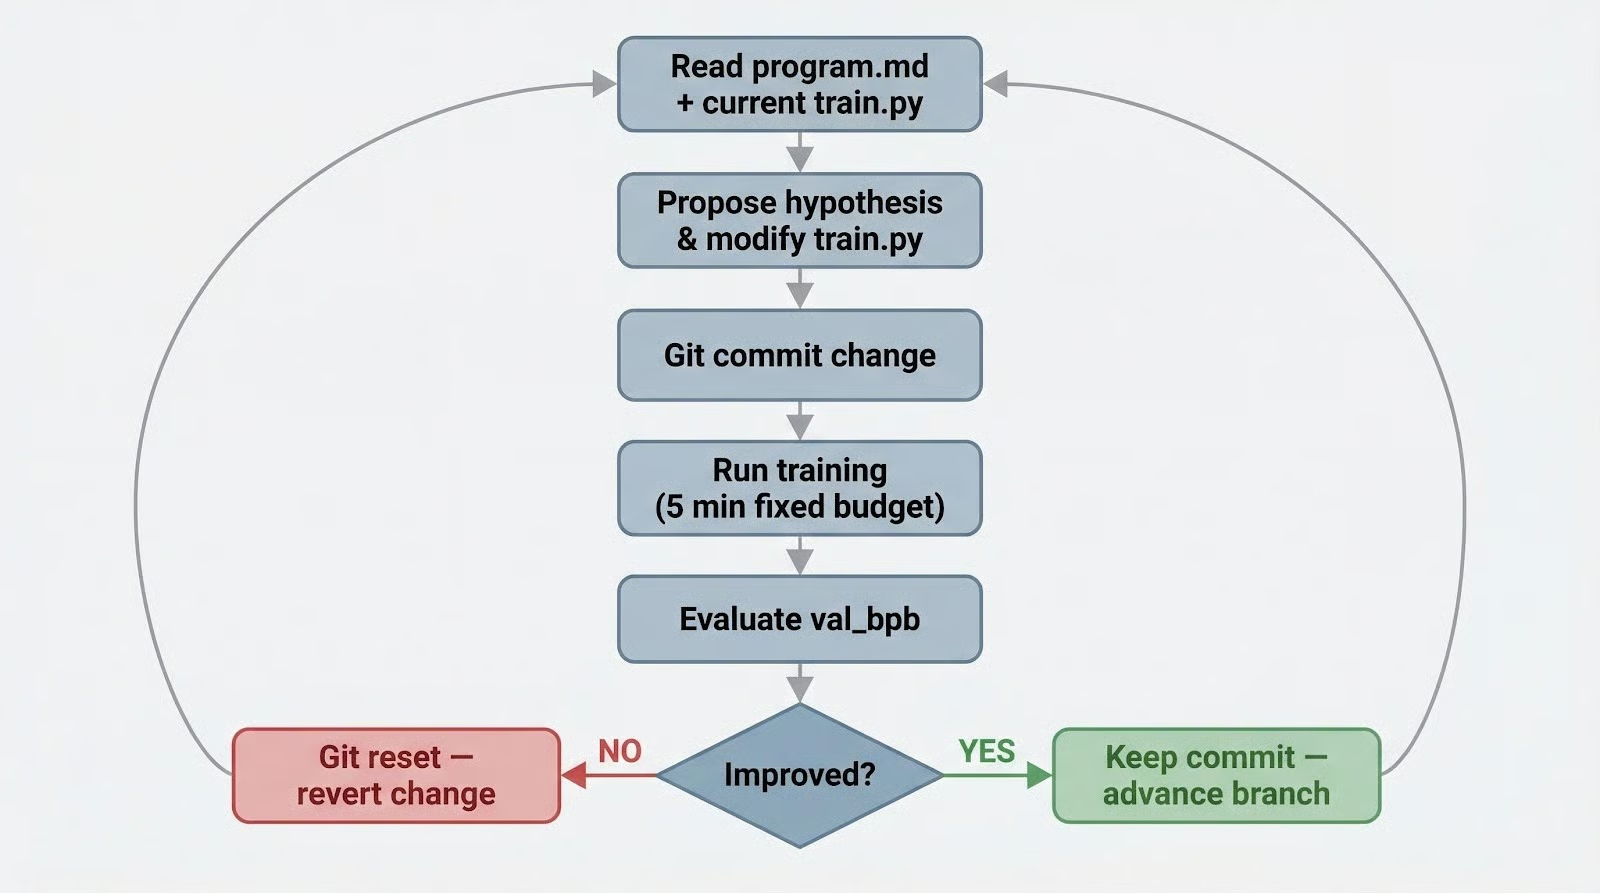
Todo experimento recebe o mesmo orçamento de 5 minutos de clock, tornando os resultados diretamente comparáveis. Uma mudança que treina mais rápido e uma que converge mais baixo são avaliadas em condições iguais.
A 5 minutos por experimento, o sistema roda cerca de 12 experimentos por hora.
O nome "ratchet" vem do histórico do git. Cada experimento bem-sucedido adiciona um commit; cada falha é revertida. A base de código só anda para frente, nunca para trás, acumulando melhorias validadas uma a uma.
A estrutura lembra algoritmos evolutivos, mas o AutoResearch mantém uma única linhagem em vez de uma população. Em vez de crossover e mutação entre candidatos, o LLM age como operador de mutação (propondo mudanças) e como pressão de seleção (escolhendo o que tentar com base nos resultados anteriores).
Ele lê seu próprio histórico do git e o results.tsv para construir em cima do que mostrou potencial.
O arquivo results.tsv rastreia cada experimento: hash do commit, score val_bpb, uso de memória da GPU, status de sucesso/falha e uma descrição do que o agente tentou.
Você ganha uma trilha de auditoria clara para revisar de manhã, e o agente usa o mesmo log para calibrar o que tentar em seguida. Os primeiros experimentos tendem a ser amplos (testando diferentes configurações de otimizador), enquanto os posteriores se concentram na direção que os dados validaram.
Para rodar o AutoResearch, você precisa de uma máquina com GPU NVIDIA (a configuração padrão mira GPUs modernas com 20+ GB de VRAM), Python 3.10+, uv e um agente de código (Claude Code, Cursor ou similar).
Clone o repositório, instale as dependências e prepare o dataset:
git clone https://github.com/karpathy/autoresearch.git
cd autoresearch
uv sync
uv run prepare.py
Não há script de orquestração. Nada de run.py, nem pipeline, nem framework.
O README diz para "simplesmente iniciar seu Claude/Codex ou o que preferir neste repositório."
Você abre um agente de código no diretório do projeto, pede para ele ler o program.md e o agente roda o loop de experimentos sozinho.
O LLM é a camada de automação. Acompanhe o progresso dando tail no results.tsv ou checando o log do git para novos commits.
A configuração padrão treina um modelo GPT no dataset FineWeb-Edu, o que exige uma GPU decente e várias horas para mostrar resultados. Para um primeiro teste em hardware menor, Karpathy recomenda trocar para o dataset TinyStories e reduzir o modelo diminuindo o vocabulário para 256 e a profundidade para 4.
Essas mudanças reduzem a necessidade de VRAM e encurtam cada experimento o suficiente para você ver o ratchet em ação em poucas horas.
Leia o program.md padrão antes de iniciar uma execução noturna. Ele define a agenda de pesquisa que o agente segue, e editá-lo é como você direciona os experimentos.
Se você quer que o agente foque em mecanismos de atenção, diga isso no program.md.
Se quiser que ele não mexa no otimizador, adicione essa restrição. O agente não se desviará do que está escrito ali.
Para uma primeira execução noturna, espere 80–100 experimentos com talvez 15–20 melhorias mantidas. Alguns pontos práticos:
results.tsv de manhã em vez de ficar vendo o terminal. O padrão de "escada" dos scores de val_bpb conta a história melhor do que logs individuais.O AutoResearch foi testado em várias execuções, desde experimentos do próprio Karpathy até reproduções da comunidade e adoção em produção.
|
Execução |
Experimentos |
Melhorias mantidas |
Resultado |
|
Noite inicial (GPU única) |
83 |
15 |
val_bpb: 1,000 → 0,975 |
|
Execução estendida de 2 dias (profundidade-12) |
~700 |
~20 |
Todas aditivas; transferidas para modelos profundidade-24 |
|
Impacto em produção |
- |
- |
Tempo até benchmark GPT-2: 2,02 h → 1,80 h (11% mais rápido) |
|
Sessão da comunidade |
126 |
- |
val_bpb: 0,9979 → 0,9697 |
O agente encontrou coisas que um humano metódico eventualmente acharia. QKnorm estava sem um multiplicador de escala para acentuar a atenção, Value Embeddings se beneficiam de regularização, e houve ganhos em ajuste de atenção em bandas, parâmetros beta do AdamW e agendamento de weight decay.
São mudanças estruturais de código, não varreduras aleatórias de hiperparâmetros, e testar cada uma manualmente levaria dias.
O CEO da Shopify, Tobi Lutke, adaptou o AutoResearch para um modelo interno de expansão de consultas e obteve melhoria de 19% na validação a partir de 37 experimentos em um modelo de 0,8B de parâmetros, relatando resultados no dia seguinte ao início.
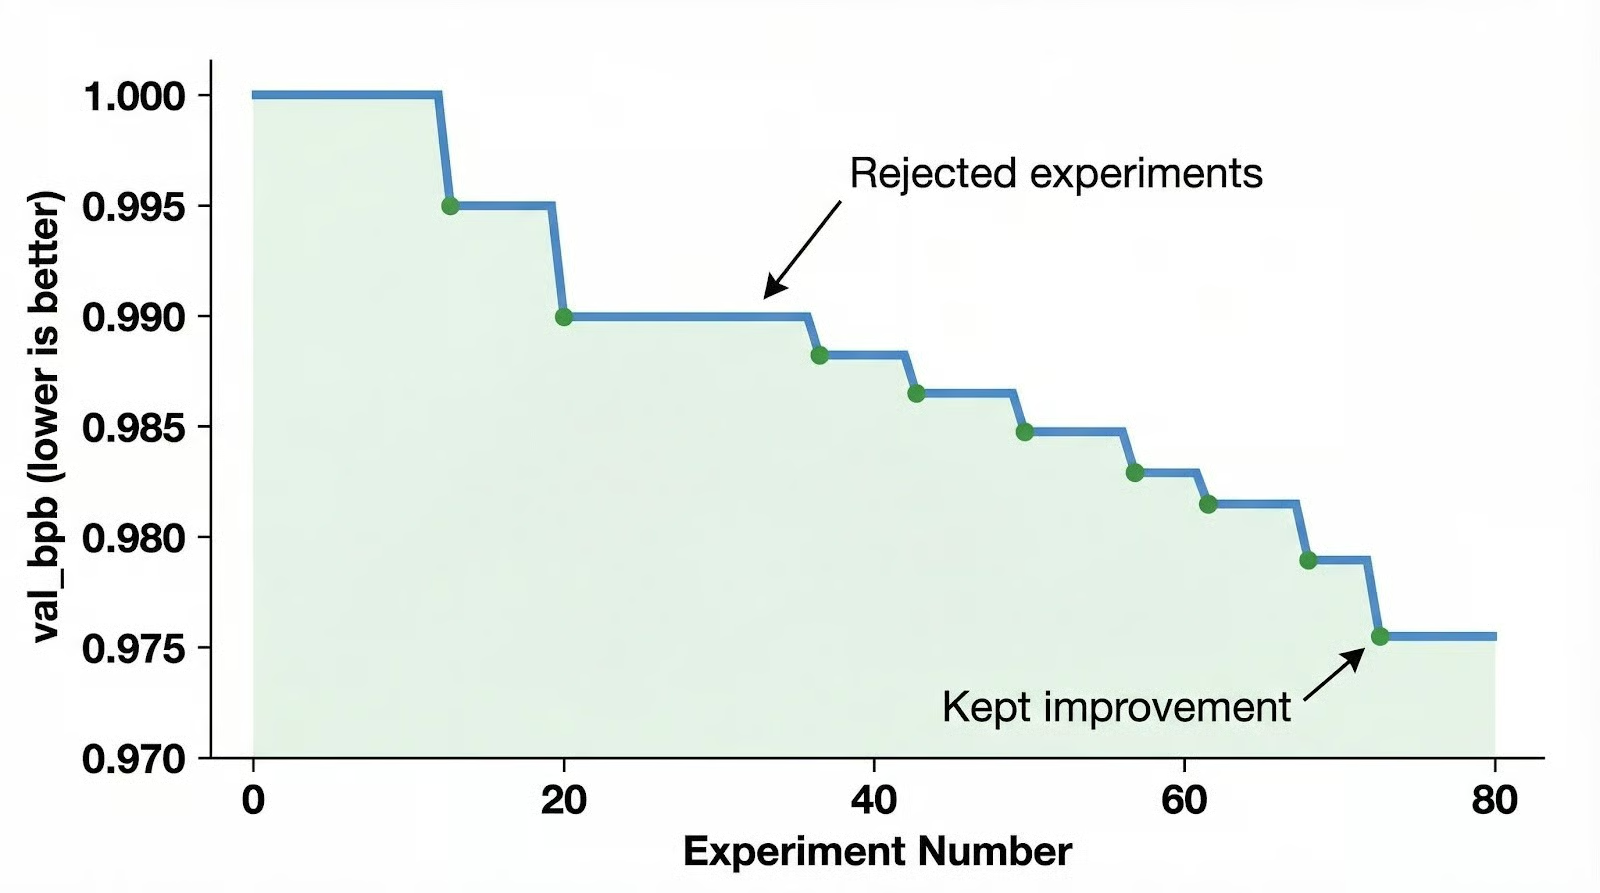
O gráfico em "escada" é real, mas cada degrau é pequeno. O agente encontra melhorias genuínas, ajustando um parâmetro beta aqui, adicionando regularização ali. Ninguém relatou que ele inventou um mecanismo de atenção inédito ou propôs uma ideia de arquitetura que um pesquisador humano não chegaria eventualmente.
GitHub Issue #22 captura o problema estrutural. Um usuário observou que o agente gira em variações menores do que funcionou por último, preso em um padrão de busca local.
O ratchet só aceita mudanças que melhoram imediatamente o val_bpb, então o agente nunca pode dar um passo para trás para preparar um ganho maior.
Pesquisadores humanos raciocinam com frequência: "vai piorar antes de melhorar". O ratchet não tem espaço para isso.
Karpathy reconheceu um problema relacionado no Hacker News: o agente parece "cauteloso e com medo" em problemas abertos.
Ele atribui isso ao RLHF (Reinforcement Learning from Human Feedback), que recompensa saídas seguras e conservadoras em detrimento de experimentação arrojada. O agente é capaz de propor mudanças criativas, mas foi treinado para jogar seguro.
A janela fixa de 5 minutos de treino adiciona outra restrição.
Mudanças cujo valor aparece rapidamente são encontradas; mudanças que só se provariam em execuções mais longas ficam invisíveis. E rodar 100 experimentos contra o mesmo conjunto de validação traz risco de overfitting: algumas "melhorias" podem ser específicas daquele eval, não ganhos reais. A imutabilidade do prepare.py, a garantia de justiça do sistema, também é seu ponto cego.
A comunidade debate se o teto vem do framework ou do modelo subjacente. Propostas incluem otimização de meta-prompt (um segundo agente reescreve o program.md com base nos resultados), diretrizes de diversidade que recompensam novidade junto com melhoria e experimentos periódicos de "reset" partindo de um checkpoint anterior para escapar de ótimos locais.
Hoje, o AutoResearch automatiza a parte metódica da pesquisa em ML: rodar e avaliar centenas de pequenos experimentos. Ele não substitui a parte criativa — formular novas direções de pesquisa — que continua sendo trabalho humano. Essa divisão de tarefas também é o melhor indicativo de quando a ferramenta cabe no seu fluxo.
O contrato de três arquivos (avaliador imutável, implementação modificável pelo agente, direção escrita por humano) se aplica além do treino de LLMs para qualquer domínio onde você consiga definir uma função de pontuação automática.
Otimização de ranking de busca, categorização de produtos, reconhecimento de entidades clínicas, pontuação de fraude, classificação de intenção: essas tarefas têm o perfil certo. Modelos pequenos que treinam em minutos, funções de avaliação claras e melhorias que transferem quando você escala.
Quando os experimentos rodam 100x mais rápido do que um humano daria conta, o gargalo passa a ser o pipeline de avaliação. Benchmarks estáticos saturam rápido. Times que adotam esse padrão precisam de conjuntos de avaliação que evoluam junto com os dados de produção e casos de borda mais difíceis.
O próprio Karpathy roda um "primo maior" do AutoResearch em 8x GPUs H100 com seu framework de produção nanochat, o que sugere que o padrão escala além de experimentos de brinquedo. A comunidade já criou forks para macOS/Apple Silicon e propôs integrações para GPUs mais antigas. O guia CPU vs GPU explica por que hardware de GPU é inegociável para esse tipo de treino iterativo.
Se seu objetivo é extrair melhorias incrementais de um pipeline de treino já bem entendido, o AutoResearch é uma boa escolha. O teto de criatividade significa que você ainda vai precisar de pesquisadores humanos para problemas que exigem novidade real, e a ferramenta brilha na maior parte da pesquisa que é iteração metódica.
Escrever um bom program.md exige ter feito a pesquisa você mesmo. Você precisa saber quais direções valem a pena, o que "melhor" significa para o seu problema e quando os ganhos incrementais se esgotaram. O agente cuida da execução, mas o julgamento por trás da agenda de pesquisa continua humano. Se a próxima geração de engenheiros pular essa base porque os agentes fazem isso agora, teremos muito compute e pouca gente com experiência para apontá-lo na direção certa.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Adel Nehme
15 min
blog
Abid Ali Awan
15 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Tutorial
Zoumana Keita
14 min
Tutorial
Zoumana Keita
14 min