

机器学习模型中正确超参数取值集的重要性
理解超参数的最佳方式,是把它们看作算法的“设置项”,可以像调谐 AM 收音机的旋钮那样进行调整以优化性能。创建机器学习模型时,您需要在模型架构上做出一系列设计选择。通常,您并不能立刻知道某个问题的最优模型架构为何,因此希望探索一系列可能性。理想情况下,延续机器学习的思路,您会让机器自动完成这类探索并选择最优的模型架构。
您将在案例研究部分看到,合适的超参数取值如何影响机器学习模型的表现。在此语境下,选择合适的取值集合通常被称为“超参数优化”或“超参数调优”。
优化/调优超参数的两种简单策略:
模型可能包含许多超参数,寻找最佳组合可以被视为一个搜索问题。
尽管如今已有许多超参数优化/调优算法,本文讨论两种简单策略:1. 网格搜索;2. 随机搜索。
超参数的网格搜索:
网格搜索是一种超参数调优方法,它会依据您在网格中指定的算法参数组合,系统化地构建并评估模型。
来看一个示例:
假设某个机器学习模型 X 接受超参数 a1、a2 和 a3。在网格搜索中,您首先为 a1、a2 和 a3 各自定义一组取值范围。您可以把它理解为每个超参数的一组取值数组。随后,网格搜索会用您定义的所有可能超参数组合(a1、a2、a3)来构建模型 X 的多个版本。这个超参数取值范围称为网格。
假设您定义的网格为:
a1 = [0,1,2,3,4,5]
a2 = [10,20,30,40,5,60]
a3 = [105,105,110,115,120,125]
请注意,您为超参数定义的取值数组必须合法。例如,如果某个超参数只接受整数取值,就不能提供浮点数。
现在,网格搜索将基于您刚刚定义的网格开始构建模型 X 的多个版本。
它会从组合 [0,10,105] 开始,到 [5,60,125] 结束,并遍历二者之间的所有中间组合,这使得网格搜索的计算代价非常高。
接着看看另一种搜索技术——随机搜索:
超参数的随机搜索:
随机搜索的理念由 James Bergstra 和 Yoshua Bengio 提出。您可以在这里查看原始论文。
随机搜索不同于网格搜索。您不再为每个超参数提供离散的备选取值集合,而是为每个超参数提供一个统计分布,并从中随机采样取值。
在继续之前,先理解“分布”和“采样”的含义:
在统计学中,分布本质上指某个变量取值的排列方式,显示其观测或理论出现频率。
另一方面,采样是统计学中的术语,指从目标总体中选取具有代表性的样本,并从样本收集数据,以便了解整体的特征。
现在我们回到随机搜索的概念。
您将为每个超参数定义一个采样分布。您也可以定义在搜索最优模型时希望构建的迭代次数。每次迭代中,模型的超参数取值都将通过从所定义分布中采样而得。用随机搜索替代网格搜索的一个理论依据在于:在大多数情况下,超参数的重要性并不相同。根据原始论文:
“……对大多数据集而言,只有少数超参数真正重要,但在不同数据集上重要的超参数并不相同。这一现象使网格搜索不太适合为新数据集配置算法。”
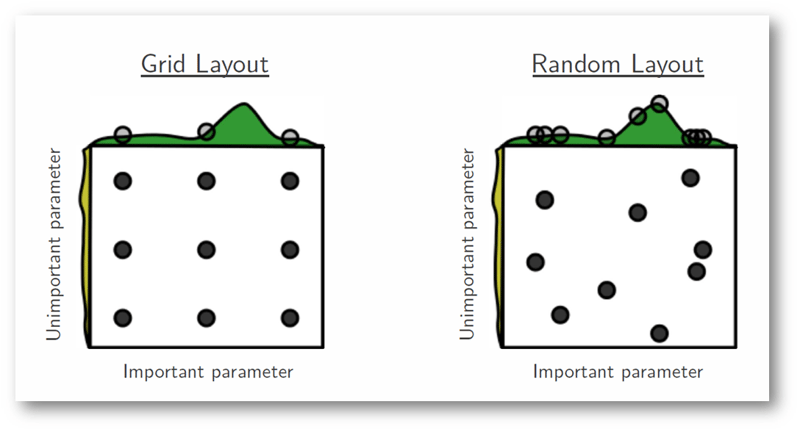
在下图中,我们在一个超参数空间中进行搜索,其中某个超参数对模型评分优化的影响远大于另一个——各轴上显示的分布代表模型评分。两种情况下我们都评估了 9 个不同的模型。网格搜索明显错过了最优模型,并在不重要的参数上花费了冗余的探索时间。在这次网格搜索中,我们将每个超参数单独拿出来,在保持其他超参数不变的前提下寻找最优值。对于那些对最终模型评分影响很小的超参数,这会造成时间浪费。相反,随机搜索具有更强的探索能力,能更专注于为关键超参数找到最优值。
接下来的部分,您将使用 Python 实操网格搜索与随机搜索。您也将能够从有效性与效率方面判断哪种更合适。
Python 案例研究
在报告结果之前,超参数调优是应用型机器学习流程中的最后一步。
本例将使用 Pima 印第安人糖尿病数据集。该数据集对应一个分类问题,您需要依据数据集中的 8 个特征来预测某人是否会患上糖尿病。您可以在此处查看数据集的完整说明。
数据集共有 768 条观测。您的第一步是加载数据集,以便继续后续步骤。但在此之前,先导入将要用到的依赖。
# Dependencies
import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
依赖已导入,接下来用著名的 Pandas 库将 Pima Indians 数据集加载到一个 DataFrame 对象中。
data = pd.read_csv("diabetes.csv") # Make sure the .csv file and the notebook are residing on the same directory otherwise supply an absolute path of the .csv file
数据集已成功加载到 DataFrame 对象 data 中。现在来看一下数据。
data.head()

您可以看到 8 个不同特征以及被标注为 1 和 0 的结果,其中 1 表示该观测患有糖尿病,0 表示未患糖尿病。该数据集已知存在缺失值。具体而言,某些列的缺失值被记作 0。根据这些列的定义及领域知识可知,某些度量为 0 是不合理的,例如体重指数或血压不可能为 0。
(缺失值在构建机器学习模型时会带来诸多问题。本例中,您将使用逻辑回归分类器来预测患者是否患有糖尿病。而逻辑回归无法直接处理缺失值问题。)
(如果您需要快速回顾逻辑回归,可参考这里。)
使用 Pandas 的 describe() 工具获取一些数据统计信息。
data.describe()

这很有用。
我们可以看到,有些列的最小值为 0(零)。在一些列上,0 没有意义,表示该值无效或缺失。
具体而言,下列列的最小值为 0 是不合理的:
- 血浆葡萄糖浓度
- 舒张压
- 三头肌皮褶厚度
- 2 小时血清胰岛素
- 体重指数
现在需要识别并标记这些值为缺失。我们通过查看原始数据来验证,下面的示例打印前 20 行。
data.head(20)

您能在多列中看到 0,对吧?
您可以统计这些列中缺失值的数量。方法是:将 DataFrame 中关注的列里所有为 0 的值标记为 True,然后统计每列中 True 的数量。为此,您需要在不带列名的情况下重新导入数据。
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print((data[[1,2,3,4,5]] == 0).sum())
1 5
2 35
3 227
4 374
5 11
dtype: int64
您可以看到,第 1、2 和 5 列只有少量 0,而第 3 和 4 列更多,接近一半的行。第 0 列也有一些缺失值,不过这是正常的。第 8 列是目标变量,因此其中的“0”是自然存在的。
这表明不同的“缺失值”策略可能需要针对不同列分别制定,例如要确保仍有足够的记录可用于训练预测模型。
在 Python(尤其是 Pandas、NumPy 和 Scikit-Learn)中,缺失值用 NaN 表示。
NaN 在求和、计数等运算中会被忽略。
您可以在 Pandas DataFrame 的列子集上使用 replace() 函数,轻松将这些值标记为 NaN。
在标记缺失值后,您可以使用 isnull() 函数将数据集中的 NaN 标记为 True,并统计每列的缺失值数量。
# Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)
# Count the number of NaN values in each column
print(data.isnull().sum())
0 0
1 5
2 35
3 227
4 374
5 11
6 0
7 0
8 0
dtype: int64
您可以看到第 1 到 5 列的缺失值数量与之前识别的 0 的数量一致。这说明您已正确标记了缺失值。
这是一个有用的摘要。不过您可能还想看看实际数据,以确认没有被“假象”误导。
下面是相同示例,但打印前 5 行数据。
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
从原始数据可以清楚看到,标记缺失值达到了预期效果。接下来进行缺失值填补。填补(impute)指用某种模型来替换缺失值。虽然填补方式有多种,这里我们使用均值填补,即用该列的均值替换缺失值。使用 Pandas 的 fillna() 工具来完成。
# Fill missing values with mean column values
data.fillna(data.mean(), inplace=True)
# Count the number of NaN values in each column
print(data.isnull().sum())
0 0
1 0
2 0
3 0
4 0
5 0
6 0
7 0
8 0
dtype: int64
太好了!您已经处理了缺失值问题。现在用这些数据,通过 scikit-learn 构建一个逻辑回归模型。
首先,先用一些随机的超参数取值来构建模型。然后再用两种不同策略——网格搜索与随机搜索——构建另外两个逻辑回归模型。
# Split dataset into inputs and outputs
values = data.values
X = values[:,0:8]
y = values[:,8]
# Initiate the LR model with random hyperparameters
lr = LogisticRegression(penalty='l1',dual=False,max_iter=110)
您已使用一些随机超参数创建了逻辑回归模型。所用超参数如下:
- penalty:用于指定正则化所使用的范数。
- dual:对偶或原始形式。liblinear 求解器仅对 l2 惩罚实现了对偶形式。当 n_samples > n_features 时,建议使用 dual=False。
- max_iter:为收敛所允许的最大迭代次数。
在后续案例中,您会对这些超参数进行优化/调优,以观察结果的变化。
# Pass data to the LR model
lr.fit(X,y)
LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
intercept_scaling=1, max_iter=110, multi_class='ovr', n_jobs=1,
penalty='l1', random_state=None, solver='liblinear', tol=0.0001,
verbose=0, warm_start=False)
该检查一下准确率了。
lr.score(X,y)
0.7747395833333334
在上一步中,您将 LR 模型应用到同一份数据并评估了评分。但我们总是需要验证机器学习模型的稳定性。您不能只把模型拟合到训练数据上,就指望它能在从未见过的真实数据上准确工作。您需要某种保证,确保模型抓住了数据中的大部分模式。
交叉验证正是为此而来。我不会展开细节,因为这超出了本文范围。但这篇文章讲解得非常好。
# You will need the following dependencies for applying Cross-validation and evaluating the cross-validated score
from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
# Build the k-fold cross-validator
kfold = KFold(n_splits=3, random_state=7)
您将 n_splits 设为 3,也就是 3 折交叉验证。random_state 设为 7 仅用于结果复现,您也可以设为任意整数。下面应用它。
result = cross_val_score(lr, X, y, cv=kfold, scoring='accuracy')
print(result.mean())
0.765625
您会发现分数略有下降。没关系,通过超参数调优/优化可以做得更好。
我们再构建一个 LR 模型,这次对其超参数进行调优。先从网格搜索开始。
先导入所需依赖。Scikit-learn 提供了名为 GridSearchCV 的工具。
from sklearn.model_selection import GridSearchCV
定义上文使用过的超参数的网格取值。
dual=[True,False]
max_iter=[100,110,120,130,140]
param_grid = dict(dual=dual,max_iter=max_iter)
网格已定义。运行网格搜索并查看结果与执行时间。
import time
lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)
start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.752604 using {'dual': False, 'max_iter': 100}
Execution time: 0.3954019546508789 ms
您也可以定义更大的超参数网格并应用网格搜索。
dual=[True,False]
max_iter=[100,110,120,130,140]
C = [1.0,1.5,2.0,2.5]
param_grid = dict(dual=dual,max_iter=max_iter,C=C)
lr = LogisticRegression(penalty='l2')
grid = GridSearchCV(estimator=lr, param_grid=param_grid, cv = 3, n_jobs=-1)
start_time = time.time()
grid_result = grid.fit(X, y)
# Summarize results
print("Best: %f using %s" % (grid_result.best_score_, grid_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'C': 2.0, 'dual': False, 'max_iter': 100}
Execution time: 0.793781042098999 ms
您可以看到准确率有所提高,但执行时间也明显增长。网格越大,执行时间越长。
下面用随机搜索重跑一遍。Scikit-learn 提供了 RandomSearchCV。像往常一样,先导入必要依赖。
from sklearn.model_selection import RandomizedSearchCV
random = RandomizedSearchCV(estimator=lr, param_distributions=param_grid, cv = 3, n_jobs=-1)
start_time = time.time()
random_result = random.fit(X, y)
# Summarize results
print("Best: %f using %s" % (random_result.best_score_, random_result.best_params_))
print("Execution time: " + str((time.time() - start_time)) + ' ms')
Best: 0.763021 using {'max_iter': 100, 'dual': False, 'C': 2.0}
Execution time: 0.28888916969299316 ms
哇!随机搜索得到相同的准确率,但用时少得多。
案例研究部分到此结束。下面做个总结!
结论与延伸阅读
在本教程中,您了解了机器学习模型的参数与超参数及其差异。您也明白了超参数优化在构建高效机器学习模型中的作用。您使用 scikit-learn 在 Python 中构建了一个简单的逻辑回归分类器。
您通过网格搜索与随机搜索对超参数进行了调优,并比较了二者的表现。
此外,您还了解了在将数据送入机器学习模型前所需的一些小型数据预处理步骤(如处理缺失值),并涉及了交叉验证。
信息量不少,但这些内容在您的数据科学之旅中同等重要。以下是一些可继续阅读的资料。
延伸阅读:
对于更进阶的读者,我强烈推荐这篇关于高效优化神经网络超参数的论文。链接
如果您想进一步学习机器学习,欢迎参加 DataCamp 的以下课程:
机器学习涉及对数据进行预测与分类。为此,您需要根据数据集选择并使用不同的机器学习模型。机器学习模型是参数化的,也就是说,它们的行为可以通过参数来针对特定问题进行调整。模型往往包含大量参数,寻找最优参数组合本质上是一个搜索问题。如果您刚接触应用型机器学习,“参数”这个词可能会有些陌生。但别担心!在这篇博客的一开始,您就会了解它,同时还会知道机器学习模型中的“参数”和“超参数”有何不同。本文包含以下部分:
我们直接进入第一部分!
什么是机器学习模型中的参数?
模型参数是模型内部的配置变量,其取值可由给定数据进行估计。
因此,以上要点的核心结论是:参数对机器学习算法至关重要。同时,它们是模型从历史训练数据中学习得到的部分。我们再深入一点。想想您在编程中使用的函数参数:您可能会向函数传入一个参数,参数可在一定范围内取值。在机器学习中,您所使用的具体模型就好比一个函数,它需要参数才能对新数据进行预测。一个模型拥有固定还是可变数量的参数,决定了它被称为“参数化(parametric)”还是“非参数化(nonparametric)”。
模型参数示例包括:
什么是机器学习模型中的超参数?
模型超参数是模型外部的配置,其取值无法从数据中估计。
对于给定问题,您不可能事先知道某个超参数的最佳取值。您可以使用经验法则、借鉴其他问题中的取值,或通过试错搜索最佳值。当您将机器学习算法针对某个具体问题进行调优时,本质上就是在调优模型的超参数,以找到能带来最优预测性能的模型参数。
根据一本广受欢迎的书《Applied Predictive Modelling》的说法——“许多模型都有一些无法直接从数据中估计的重要参数。例如,在 K 近邻分类模型中……这类模型参数被称为调优参数,因为没有解析公式可以计算出合适的取值。”
模型超参数常被称作模型参数,这可能引发混淆。一个应对混淆的经验法则是:“如果某个模型参数需要您手动指定,那么它很可能就是模型的超参数。” 模型超参数的示例包括:
下一部分,您将了解在机器学习模型中选择合适的超参数取值集有多重要。