
Kurs
Skalierbare agentische Systeme entwickeln
1 Std. 30 Min.
20.4K
Andrej Karpathys AutoResearch ist ein Open-Source-Tool, das ML-Experimente in einer Schleife ausführt und nur die Änderungen behält, die das aktuelle Bestresultat übertreffen. Du beschreibst Forschungsrichtungen in einer Markdown-Datei, richtest einen KI-Coding-Agenten auf das Repo und lässt ihn laufen. Am Morgen hast du eine Git-Historie validierter Verbesserungen und ein Log aller Versuche des Agenten.
Veröffentlicht am 7. März 2026, sammelte das Projekt innerhalb weniger Tage über 21.000 GitHub-Sterne und 8,6 Millionen Aufrufe für Karpathys Ankündigung. Dieser Artikel erklärt, wie die Drei-Dateien-Architektur funktioniert, was der Ratschen-Loop in den Nachläufen tut, welche Ergebnisse AutoResearch bisher geliefert hat und wo der Ansatz an Grenzen stößt.
AutoResearch ist ein Open-Source-Python-Tool, mit dem ein KI-Agent ML-Experimente auf einer einzelnen GPU ohne menschliches Eingreifen ausführt. Es durchläuft Zyklen aus Vorschlagen-Trainieren-Evaluieren und behält nur Änderungen, die den Validierungsverlust verbessern. Das Projekt steht unter der MIT-Lizenz.
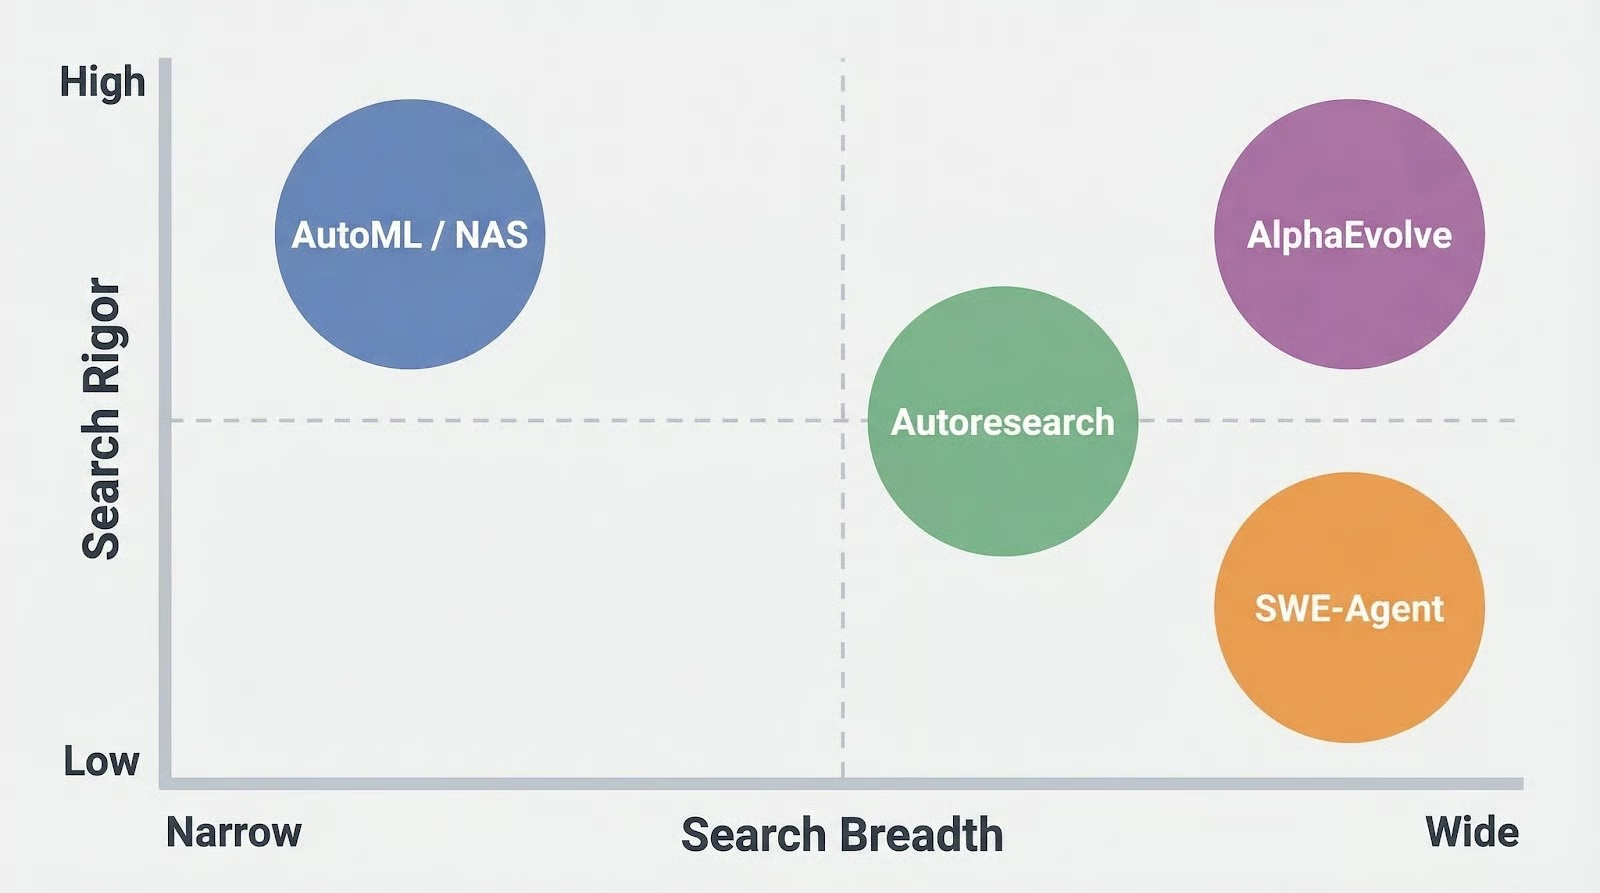
Das ist nicht Hyperparameter-Tuning. Tools wie Optuna oder Ray Tune durchsuchen einen vorab definierten Parameterraum. AutoResearch gibt dem Agenten die Freiheit, beliebigen Code zu ändern. Der Suchraum ist alles, worauf das LLM kommt – und das macht es zu einer anderen Tool-Kategorie als alles, was es derzeit gibt.
AutoML- und NAS-Frameworks (Neural Architecture Search) suchen mit strukturierten Algorithmen über Architekturen oder Hyperparameter – präzise, aber an ihren definierten Suchraum gebunden.
AlphaEvolve (Google DeepMind) geht mit einem evolutionären Ansatz und Gemini-Modellen zur Algorithmusentdeckung weiter, ist aber Closed Source und für die meisten Teams nicht zugänglich. Allgemeine Coding-Agenten wie SWE-Agent, OpenHands und Aider können beliebigen Code schreiben, sind aber nicht für den Zyklus aus Experimentieren–Evaluieren–Behalten/Zurücksetzen gemacht, den ML-Forschung tatsächlich braucht.
AutoResearch setzt darauf, dass das LLM dank seines Allgemeinwissens gute Experimente vorschlägt, anstatt den Suchraum für mathematische Garantien einzuengen.
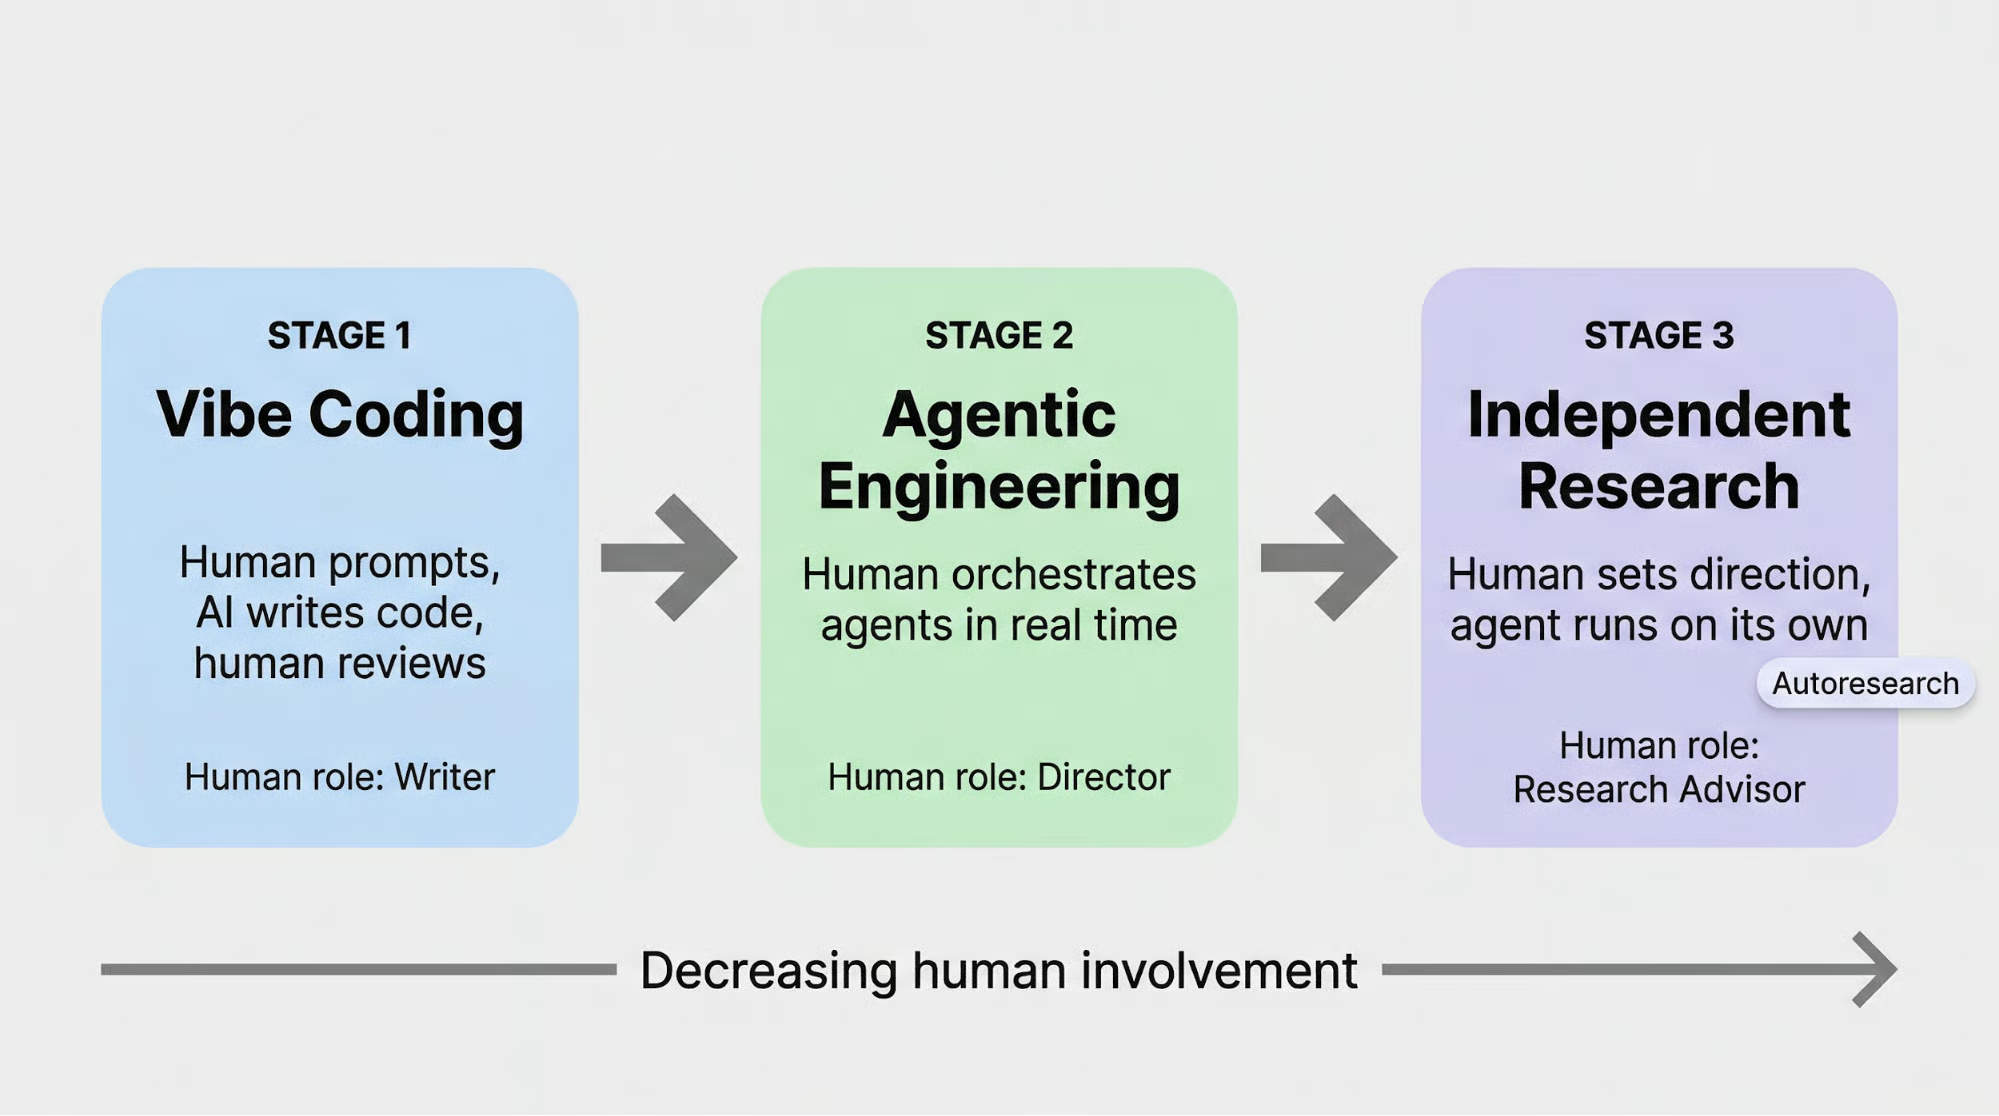
Karpathy ordnet das als natürliche Entwicklung der Zusammenarbeit von Ingenieurinnen und Ingenieuren mit KI ein. Im Februar 2026 prägte er den Begriff „agentic engineering“: „Du schreibst 99% der Zeit nicht mehr selbst den Code. Du orchestrierst Agenten, die es tun, und übernimmst die Aufsicht.“ AutoResearch geht den nächsten Schritt. Der Mensch orchestriert nicht einmal mehr. Er oder sie beschreibt in einer Markdown-Datei, wie gute Forschung aussieht – und lässt den Agenten laufen.
Die Abfolge lautet: Vibe Coding (Mensch promptet, KI schreibt Code, Mensch prüft) → agentic engineering (Mensch orchestriert Agenten in Echtzeit) → vollständig unabhängige Forschung (Mensch setzt die Richtung, Agent läuft eigenständig).
Jeder Schritt reduziert die menschliche Rolle – vom Schreiber zum Regisseur und, in Karpathys Bild, zum Forschungsberater.
In einem Folgebeitrag beschrieb er den nächsten Schritt: „Das Ziel ist nicht, eine einzelne Doktorandin oder einen einzelnen Doktoranden zu emulieren, sondern eine Forschungsgemeinschaft von ihnen“ – in Anlehnung an eine SETI@home-artige, verteilte Agenten-Kollaboration.
Wie das System diese Vision umsetzt, hängt an drei Dateien.
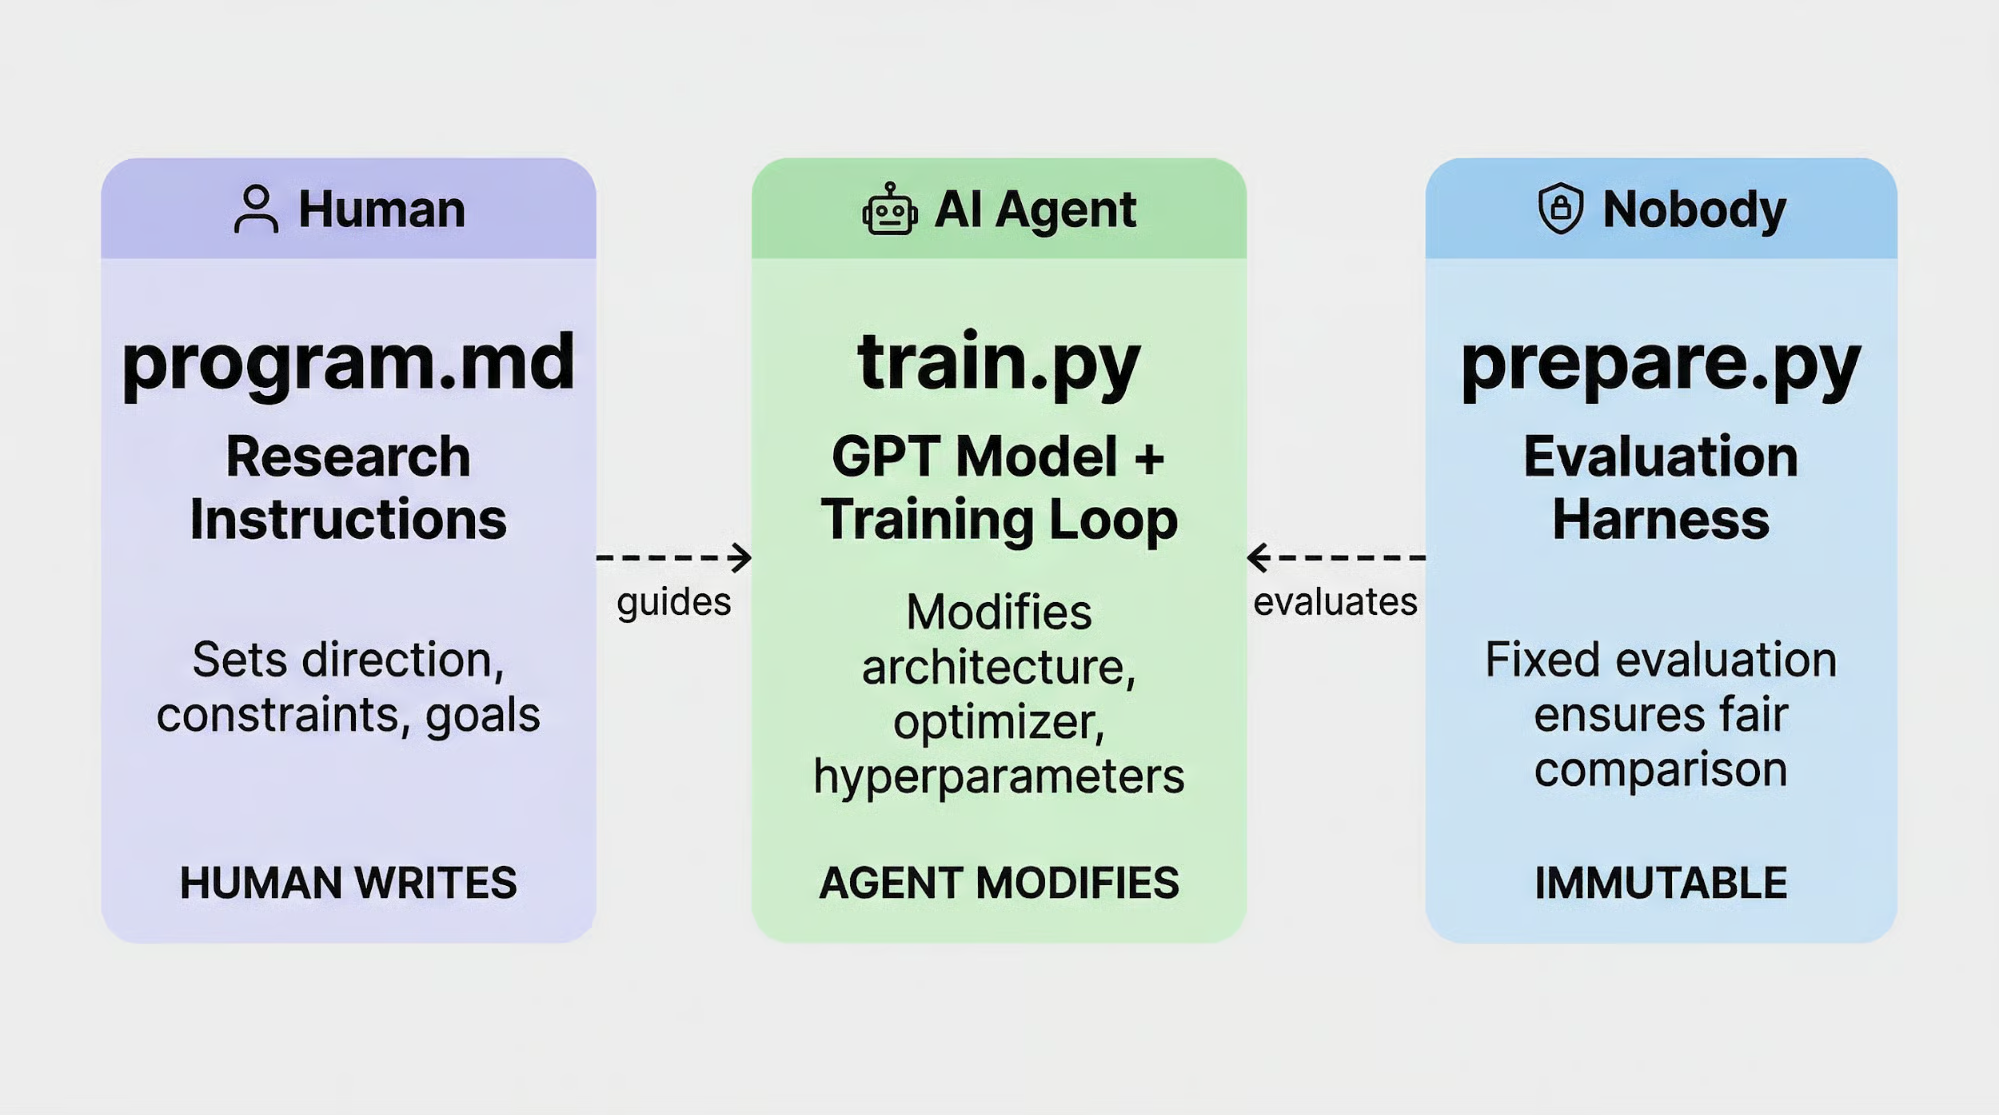
Das Design von AutoResearch basiert auf einem Vertrag zwischen drei Dateien – jede mit strengen Regeln, wer sie ändern darf.
prepare.py kümmert sich um Datenaufbereitung und Evaluation. Es baut einen BPE-Tokenizer (Byte Pair Encoding) mit einem Vokabular von 8.192 Tokens, verarbeitet das Trainingskorpus und definiert die Validierungsmetrik: val_bpb (validation bits-per-byte).
Diese Datei ist unveränderlich: Weder Mensch noch Agent modifizieren sie – das garantiert, dass jedes Experiment am gleichen Maßstab gemessen wird.
train.py ist der Spielplatz des Agenten: 630 Zeilen mit der GPT-Architektur, dem Muon+AdamW-Optimizer und der kompletten Trainingsschleife. Der Agent darf hier alles umschreiben (Aktivierungsfunktionen tauschen, Attention-Heads umstrukturieren, Lernratenpläne ändern, Gewichtsinitialisierung anpassen) – solange der modifizierte Code weiterhin trainiert und einen val_bpb-Wert produziert.
program.md ist in einfachem Markdown geschrieben und die einzige Datei, die der Mensch anfasst. Sie sagt dem Agenten, welchen Forschungsrichtungen er folgen soll, was zu vermeiden ist und wie Experimente anzugehen sind.
program.md steuertDie Datei ist konkreter, als viele erwarten. Sie schreibt Baseline-Metriken fest, damit der Agent weiß, was es zu schlagen gilt (val_bpb: 0,997900, maximale VRAM-Nutzung (Videospeicher): 45 GB).
Sie legt exakte Befehle zum Ausführen der Experimente und Extrahieren der Ergebnisse fest. Sie sagt dem Agenten, wie mit Fehlern umzugehen ist: Tippfehler beheben und neu starten, Ideen überspringen, die grundsätzlich kaputt sind, alles beenden, was länger als 10 Minuten läuft.
Und sie enthält die Anweisung, die das System zum Laufen bringt: „NIEMALS STOPPEN. Sobald die Experimentschleife gestartet ist, halte NICHT an, um den Menschen zu fragen, ob du weitermachen sollst.“
Außerdem gibt es eine Designvorgabe, die jedes Experiment prägt: „Bei gleicher Wirkung gilt: Je einfacher, desto besser. Eine kleine Verbesserung, die hässliche Komplexität einführt, lohnt sich nicht.“ Das lenkt den Agenten weg von überkonstruierten Lösungen hin zu sauberen Änderungen, die eine menschliche Prüferin oder ein Prüfer abnicken würde.
Die Arbeitsteilung ist klar: Der Mensch setzt die Forschungsrichtung über program.md, der Agent setzt sie um, indem er train.py ändert, und prepare.py fungiert als neutrale Richterin, die keine Seite anfassen darf. Mit diesem Vertrag läuft die Experimentschleife kontinuierlich und ohne Unterbrechung.
Der Kern von AutoResearch ist ein Experimentzyklus ohne menschlichen Input. So läuft eine einzelne Iteration ab – gemäß dem 9-Schritte-Loop in program.md:
program.md, um aktuelle Prioritäten und Constraints zu verstehen.train.py und jüngste Ergebnisse in results.tsv.train.py, um die vorgeschlagene Änderung umzusetzen.val_bpb und schreibt es in results.tsv.val_bpb verbessert hat: Der Commit bleibt. Wenn nicht: git reset HEAD~1 setzt auf die vorherige Version zurück.Dann beginnt alles wieder bei Schritt 1.
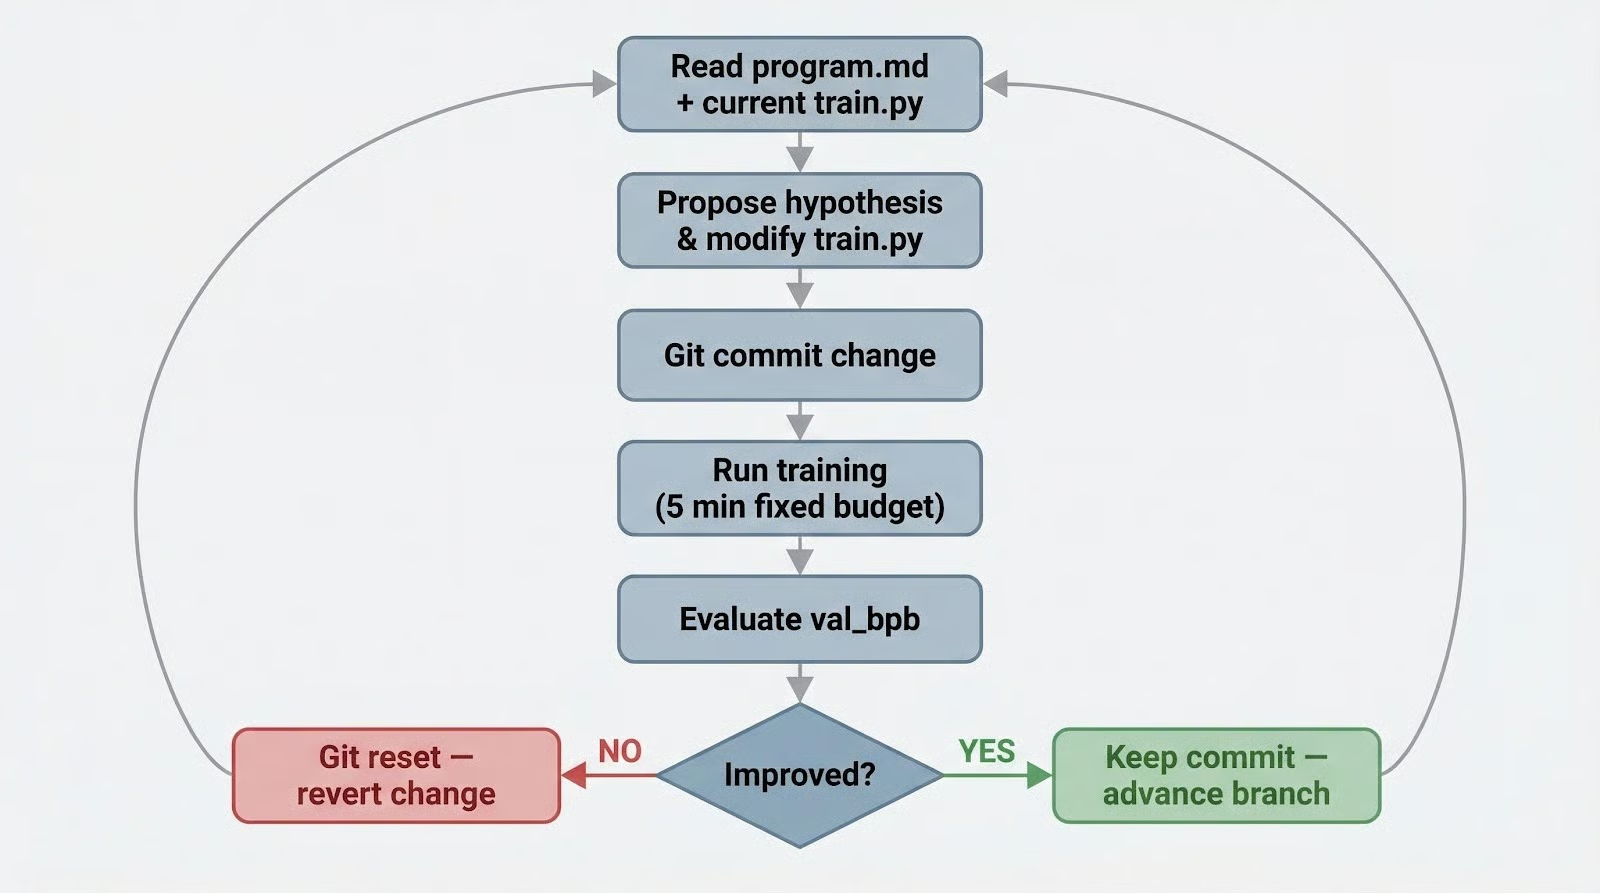
Jedes Experiment erhält dasselbe 5-Minuten-Wall-Clock-Budget, wodurch die Ergebnisse direkt vergleichbar sind. Eine Änderung, die schneller trainiert, und eine Änderung, die niedriger konvergiert, werden gleichrangig bewertet.
Bei 5 Minuten pro Experiment schafft das System etwa 12 Experimente pro Stunde.
Der „Ratschen“-Name kommt aus der Git-Historie. Jedes erfolgreiche Experiment fügt einen Commit hinzu; jeder Fehlschlag wird zurückgesetzt. Der Code kann sich nur vorwärts bewegen – nie rückwärts – und sammelt validierte Verbesserungen Schritt für Schritt.
Das ähnelt in der Struktur evolutionären Algorithmen, doch AutoResearch hält eine einzelne Linie statt einer Population. Anstatt Crossover und Mutation über Kandidaten wirkt das LLM zugleich als Mutationsoperator (macht Vorschläge) und als Selektionsdruck (wählt basierend auf bisherigen Ergebnissen aus, was es versucht).
Es liest seine eigene Git-Historie und results.tsv, um auf allem aufzubauen, was vielversprechend war.
Die Datei results.tsv erfasst jedes Experiment: Commit-Hash, val_bpb-Wert, GPU-Speicherauslastung, Pass/Fail-Status und eine Beschreibung dessen, was der Agent versucht hat.
So erhältst du morgens eine klare Prüfbarkeit, und der Agent nutzt dasselbe Log, um das nächste Vorgehen zu kalibrieren. Frühe Experimente sind tendenziell breit (verschiedene Optimizer-Konfigurationen), spätere fokussieren die Richtungen, die die Daten validiert haben.
Für AutoResearch brauchst du eine Maschine mit NVIDIA-GPU (die Standardkonfiguration zielt auf moderne GPUs mit 20+ GB VRAM), Python 3.10+, uv und einen Coding-Agenten (Claude Code, Cursor oder ähnlich).
Klon das Repo, installiere Abhängigkeiten und bereite den Datensatz vor:
git clone https://github.com/karpathy/autoresearch.git
cd autoresearch
uv sync
uv run prepare.py
Es gibt kein Orchestrierungsskript. Kein run.py, keine Pipeline, kein Framework.
Im README heißt es, du sollst „einfach deinen Claude/Codex oder was auch immer in diesem Repo starten“.
Du öffnest einen Coding-Agenten im Projektverzeichnis, gibst ihm den Prompt, program.md zu lesen, und der Agent führt die Experimentschleife eigenständig aus.
Das LLM ist die Automatisierungsschicht. Verfolge den Fortschritt, indem du results.tsv tailst oder den Git-Log auf neue Commits prüfst.
Die Standardkonfiguration trainiert ein GPT-Modell auf dem FineWeb-Edu-Datensatz, was eine ordentliche GPU erfordert und mehrere Stunden bis zu sichtbaren Ergebnissen braucht. Für einen ersten Test auf kleinerer Hardware empfiehlt Karpathy den Wechsel auf den TinyStories-Datensatz und das Runterskalieren des Modells, indem die Vokabulargröße auf 256 und die Tiefe auf 4 reduziert wird.
Diese Anpassungen verringern den VRAM-Bedarf und verkürzen jedes Experiment so weit, dass du die Ratsche innerhalb weniger Stunden in Aktion siehst.
Lies die Standard-program.md, bevor du einen Nachlauf startest. Sie definiert die Forschungsagenda des Agenten – über ihre Bearbeitung steuerst du die Experimente.
Wenn der Agent sich auf Attention-Mechanismen konzentrieren soll, schreib das in program.md.
Wenn er den Optimizer nicht anfassen soll, ergänze diese Einschränkung. Der Agent weicht nicht von dem ab, was dort steht.
Für einen ersten Lauf über Nacht kannst du mit 80–100 Experimenten rechnen, von denen vielleicht 15–20 Verbesserungen bleiben. Ein paar praktische Hinweise:
results.tsv statt aufs Terminal. Das Treppenmuster der besseren val_bpb-Werte erzählt die Geschichte besser als Einzel-Logs.AutoResearch wurde in mehreren Läufen getestet – von Karpathys eigenen Experimenten über Reproduktionen aus der Community bis hin zum Einsatz in der Produktion.
|
Lauf |
Experimente |
Behaltene Verbesserungen |
Ergebnis |
|
Erster Nachlauf (eine GPU) |
83 |
15 |
val_bpb: 1,000 → 0,975 |
|
Erweiterter 2-Tage-Lauf (Tiefe 12) |
~700 |
~20 |
Alles additiv; auf Tiefe-24-Modelle übertragen |
|
Produktionseffekt |
- |
- |
Zeit bis GPT-2-Benchmark: 2,02 h → 1,80 h (11% schneller) |
|
Community-Session |
126 |
- |
val_bpb: 0,9979 → 0,9697 |
Der Agent fand Dinge, auf die eine methodische Person irgendwann auch stoßen würde. QKnorm fehlte ein Skalierungsfaktor zur Schärfung der Attention, Value-Embeddings profitieren von Regularisierung, und es gab Zugewinne bei gebänderten Attention-Einstellungen, den AdamW-Beta-Parametern und der Planung des Weight Decay.
Das sind strukturelle Codeänderungen – keine zufälligen Hyperparameter-Sweeps – und das manuelle Testen jedes einzelnen hätte Tage gedauert.
Shopify-CEO Tobi Lütke passte AutoResearch für ein internes Query-Expansion-Modell an und erzielte eine Validierungsverbesserung von 19% aus 37 Experimenten auf einem 0,8B-Modell – und berichtete am Tag nach dem Start davon.
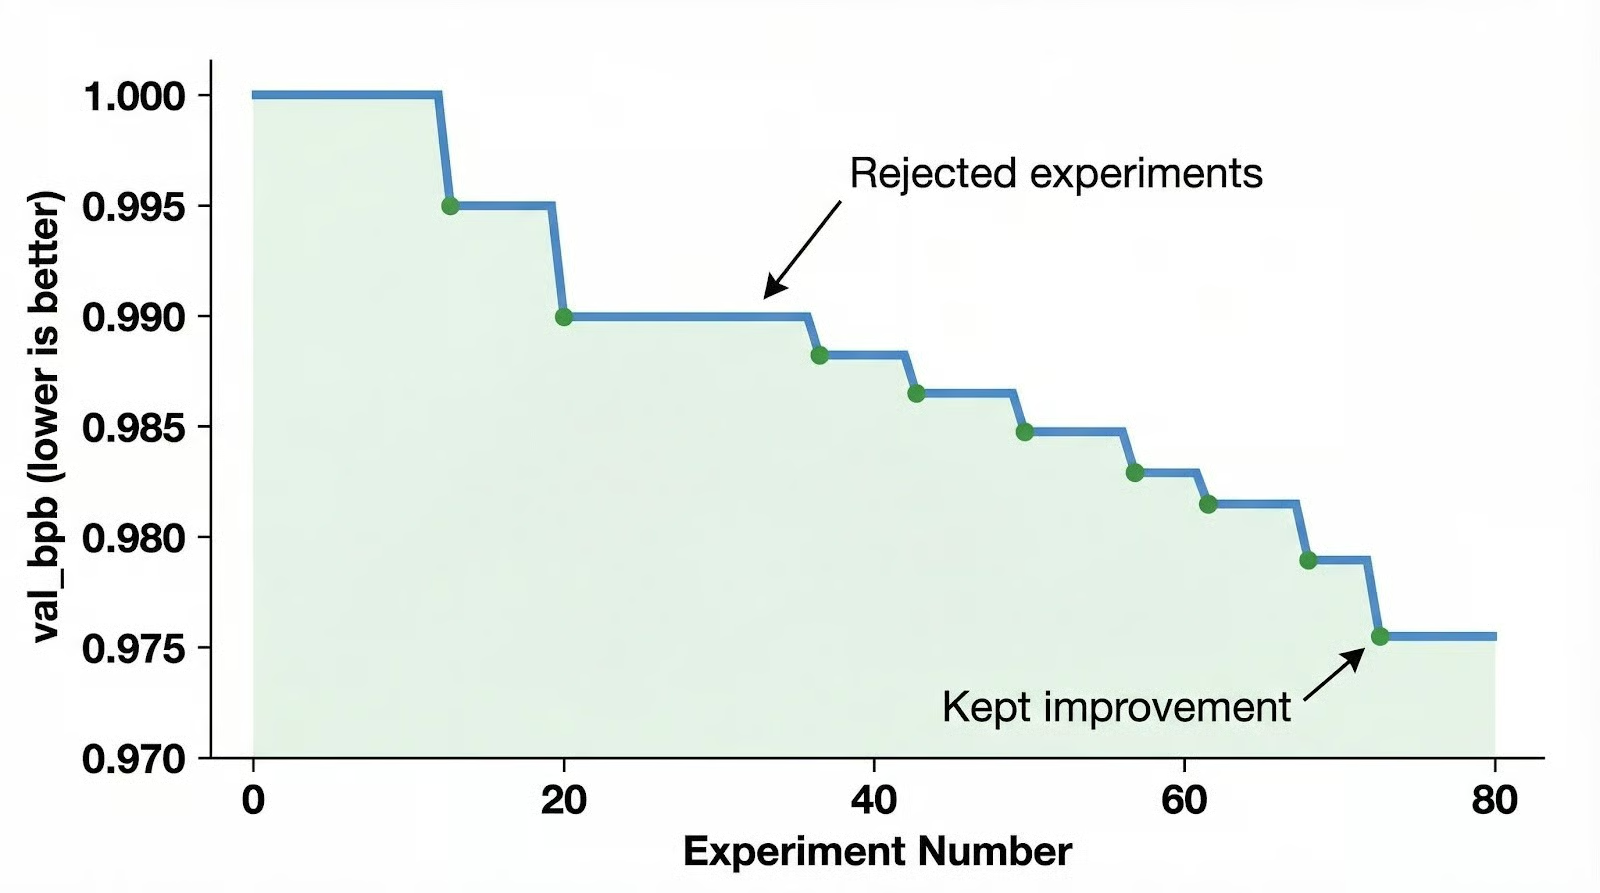
Die Treppenkurve ist real, aber jede Stufe ist klein. Der Agent findet echte Verbesserungen – hier ein Beta-Parameter, dort zusätzliche Regularisierung. Niemand hat berichtet, dass er einen neuartigen Attention-Mechanismus erfunden oder eine architektonische Idee vorgeschlagen hätte, auf die ein Mensch nicht irgendwann auch käme.
GitHub Issue #22 beschreibt das strukturelle Problem. Ein Nutzer beobachtete, dass der Agent in kleinen Variationen dessen rotiert, was zuletzt funktionierte – gefangen in einem lokalen Suchmuster.
Die Ratsche akzeptiert nur Änderungen, die val_bpb sofort verbessern – der Agent kann also nie einen Schritt zurückgehen, um einen größeren Sprung vorzubereiten.
Menschen denken regelmäßig: „Es wird erst schlechter, bevor es besser wird.“ Für die Ratsche gibt es dafür keinen Raum.
Karpathy räumte ein verwandtes Problem auf Hacker News ein: Der Agent wirkt „vorsichtig und ängstlich“ bei offenen Problemen.
Er führt das auf RLHF-Training (Reinforcement Learning from Human Feedback) zurück, das sichere, konservative Ausgaben belohnt – nicht kühne Experimente. Der Agent kann kreative Änderungen vorschlagen, ist aber auf Sicherheit getrimmt.
Das feste 5-Minuten-Trainingsfenster schränkt zusätzlich ein.
Änderungen, deren Nutzen sich schnell zeigt, werden gefunden; Änderungen, die erst über längere Läufe überzeugen, bleiben unsichtbar. Und 100 Experimente gegen dasselbe Validierungsset bergen ein Overfitting-Risiko: Manche Zugewinne sind vielleicht eval-spezifisch statt echte Verbesserungen. Die Unveränderlichkeit von prepare.py – Garant für Fairness – ist zugleich der blinde Fleck des Systems.
Die Community diskutiert, ob die Decke vom Framework oder vom zugrunde liegenden Modell kommt. Vorschläge umfassen Meta-Prompt-Optimierung (ein zweiter Agent schreibt program.md anhand der Ergebnisse um), Diversitätsrichtlinien, die Neuartigkeit neben Verbesserung belohnen, und periodische „Reset“-Experimente ab einem früheren Checkpoint, um lokalen Optima zu entkommen.
Aktuell automatisiert AutoResearch den methodischen Teil der ML-Forschung: Hunderte kleiner Experimente ausführen und auswerten. Den kreativen Teil – neue Forschungsrichtungen zu formulieren – ersetzt es nicht; das bleibt menschliche Aufgabe. Diese Arbeitsteilung ist auch der klarste Indikator dafür, ob das Tool in deinen Workflow passt.
Der Drei-Dateien-Vertrag (unveränderliche Evaluatorin, vom Agenten modifizierbare Implementierung, vom Menschen verfasste Richtung) überträgt sich über das LLM-Training hinaus auf jede Domäne, in der du eine automatische Bewertungsfunktion definieren kannst.
Suchranking-Optimierung, Produktkategorisierung, klinische Named-Entity-Recognition, Betrugsbewertung, Intent-Klassifikation: Diese Aufgaben bringen die richtigen Eigenschaften mit. Kleine Modelle, die in Minuten trainieren, klare Bewertungsfunktionen und Verbesserungen, die beim Hochskalieren übertragen.
Wenn Experimente 100-mal schneller laufen, als es ein Mensch stemmen kann, wird allerdings die Eval-Pipeline zum Engpass. Statische Benchmarks sind schnell ausgereizt. Teams, die dieses Muster übernehmen, brauchen Eval-Sets, die sich parallel zu Produktivdaten und schwierigeren Edge-Cases weiterentwickeln.
Karpathy selbst betreibt eine „größere Cousine“ von AutoResearch auf 8× H100-GPUs mit seinem Produktionsframework nanochat – was nahelegt, dass das Muster über Spielzeugexperimente hinaus skaliert. Die Community hat bereits Forks für macOS/Apple Silicon erstellt und Integrationen für ältere GPUs vorgeschlagen. Der CPU- vs. GPU-Guide erklärt, warum GPU-Hardware für diese Art iterativen Trainings unverzichtbar ist.
Wenn du aus einer gut verstandenen Trainingspipeline letzte Prozentpunkte herauskitzeln willst, passt AutoResearch gut. Wegen der Kreativitätsdecke brauchst du für echte Neuerungen weiterhin menschliche Forschende – und das Tool spielt seine Stärken dort aus, wo es um methodische Iteration geht.
Eine gute program.md zu schreiben setzt voraus, dass du die Forschung selbst gemacht hast. Du musst wissen, welche Richtungen sich lohnen, was „besser“ für dein Problem bedeutet und wann inkrementelle Zugewinne ausgereizt sind. Der Agent übernimmt die Ausführung, aber das Urteilsvermögen hinter der Forschungsagenda bleibt menschlich. Wenn die nächste Generation von Ingenieurinnen und Ingenieuren diese formative Arbeit auslässt, weil Agenten sie heute erledigen, hat das Feld reichlich Rechenleistung – aber zu wenige mit der Erfahrung, sie in die richtige Richtung zu lenken.
Top DataCamp Courses
Kurs
Kurs
Kurs