Curso
Creación de sistemas agentic escalables
1 h 30 min
20.4K
AutoResearch de Andrej Karpathy es una herramienta de código abierto que ejecuta experimentos de ML en bucle y se queda solo con los cambios que superan el mejor resultado actual. Describes las líneas de investigación en un archivo markdown, apuntas un agente de IA que programa al repositorio y te olvidas. Por la mañana, tienes un historial de git con mejoras validadas y un registro de todo lo que probó el agente.
Lanzado el 7 de marzo de 2026, el proyecto sumó más de 21.000 estrellas en GitHub y 8,6 millones de visualizaciones en el anuncio de Karpathy en pocos días. En este artículo verás cómo funciona la arquitectura de tres archivos, qué hace el bucle de carraca durante esas ejecuciones nocturnas, qué resultados ha dado AutoResearch hasta ahora y dónde están sus límites.
AutoResearch es una herramienta Python de código abierto que permite a un agente de IA ejecutar experimentos de ML en una sola GPU sin intervención humana. Itera ciclos de proponer-entrenar-evaluar y mantiene únicamente los cambios que mejoran la pérdida de validación. El proyecto se publica bajo licencia MIT.
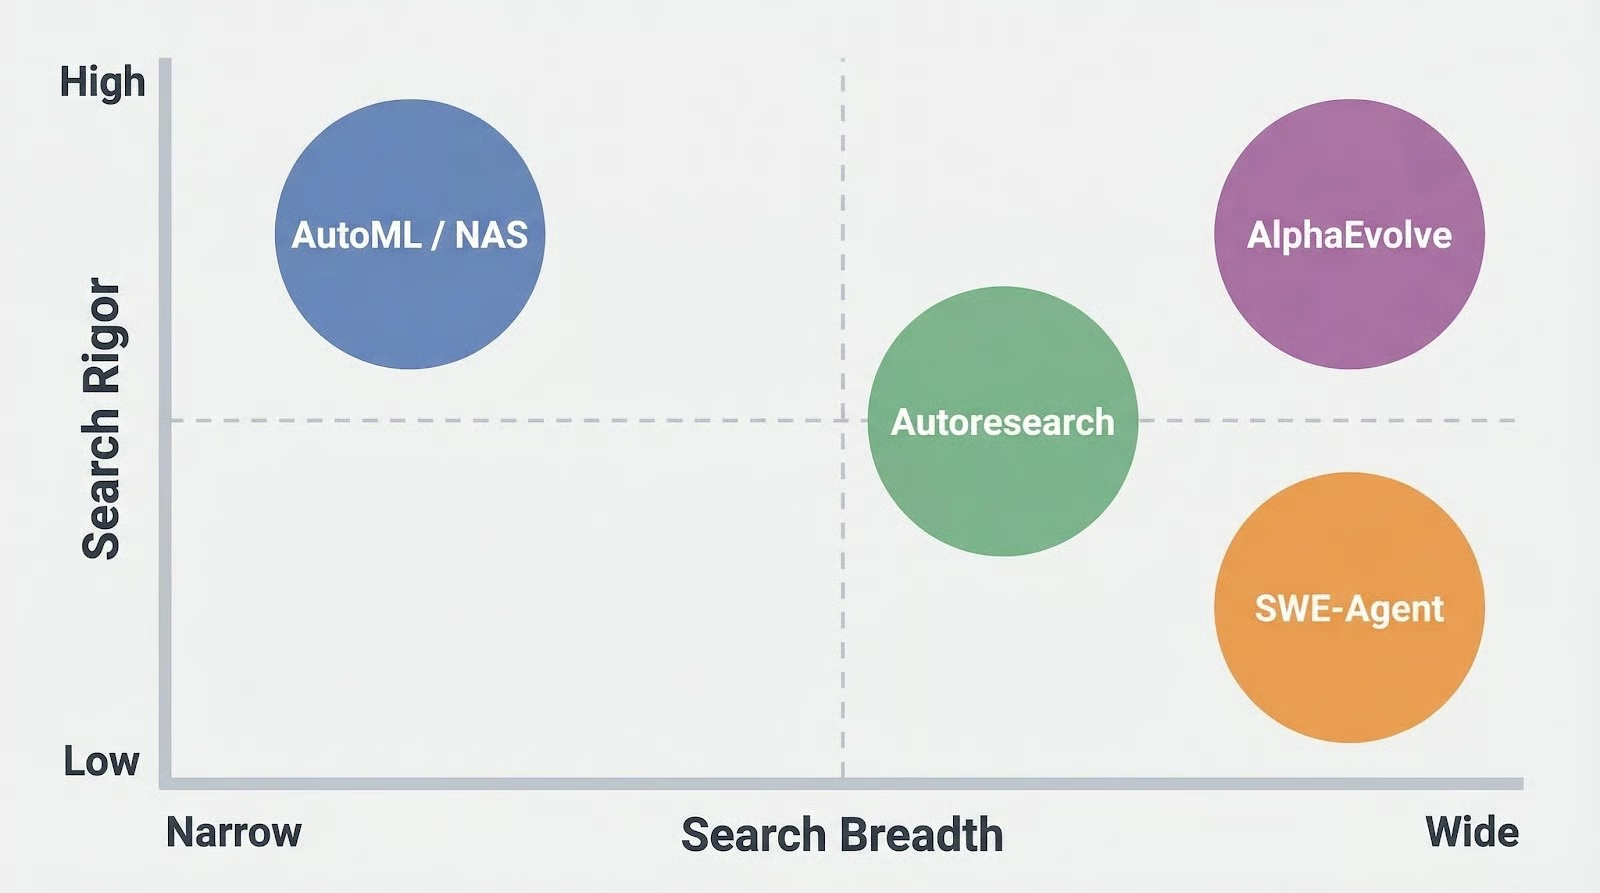
Esto no es ajuste de hiperparámetros. Herramientas como Optuna o Ray Tune buscan en un espacio de parámetros predefinido. AutoResearch da libertad al agente para modificar cualquier parte del código. El espacio de búsqueda es todo lo que se le ocurra al LLM, y eso lo convierte en una categoría distinta a cualquier herramienta disponible hoy.
Los frameworks de AutoML y NAS (búsqueda de arquitectura neuronal) exploran arquitecturas o hiperparámetros con algoritmos estructurados, precisos pero limitados a su espacio de búsqueda definido.
AlphaEvolve (Google DeepMind) va más allá con un enfoque evolutivo y modelos Gemini para descubrir algoritmos, pero es de código cerrado y no está al alcance de la mayoría de equipos. Los agentes de programación de propósito general como SWE-Agent, OpenHands y Aider pueden escribir código arbitrario, pero no están diseñados para el ciclo de experimentar-evaluar-conservar/revertir que exige la investigación en ML.
AutoResearch apuesta por el conocimiento general del LLM para proponer buenos experimentos, en lugar de acotar el espacio de búsqueda para obtener garantías matemáticas.
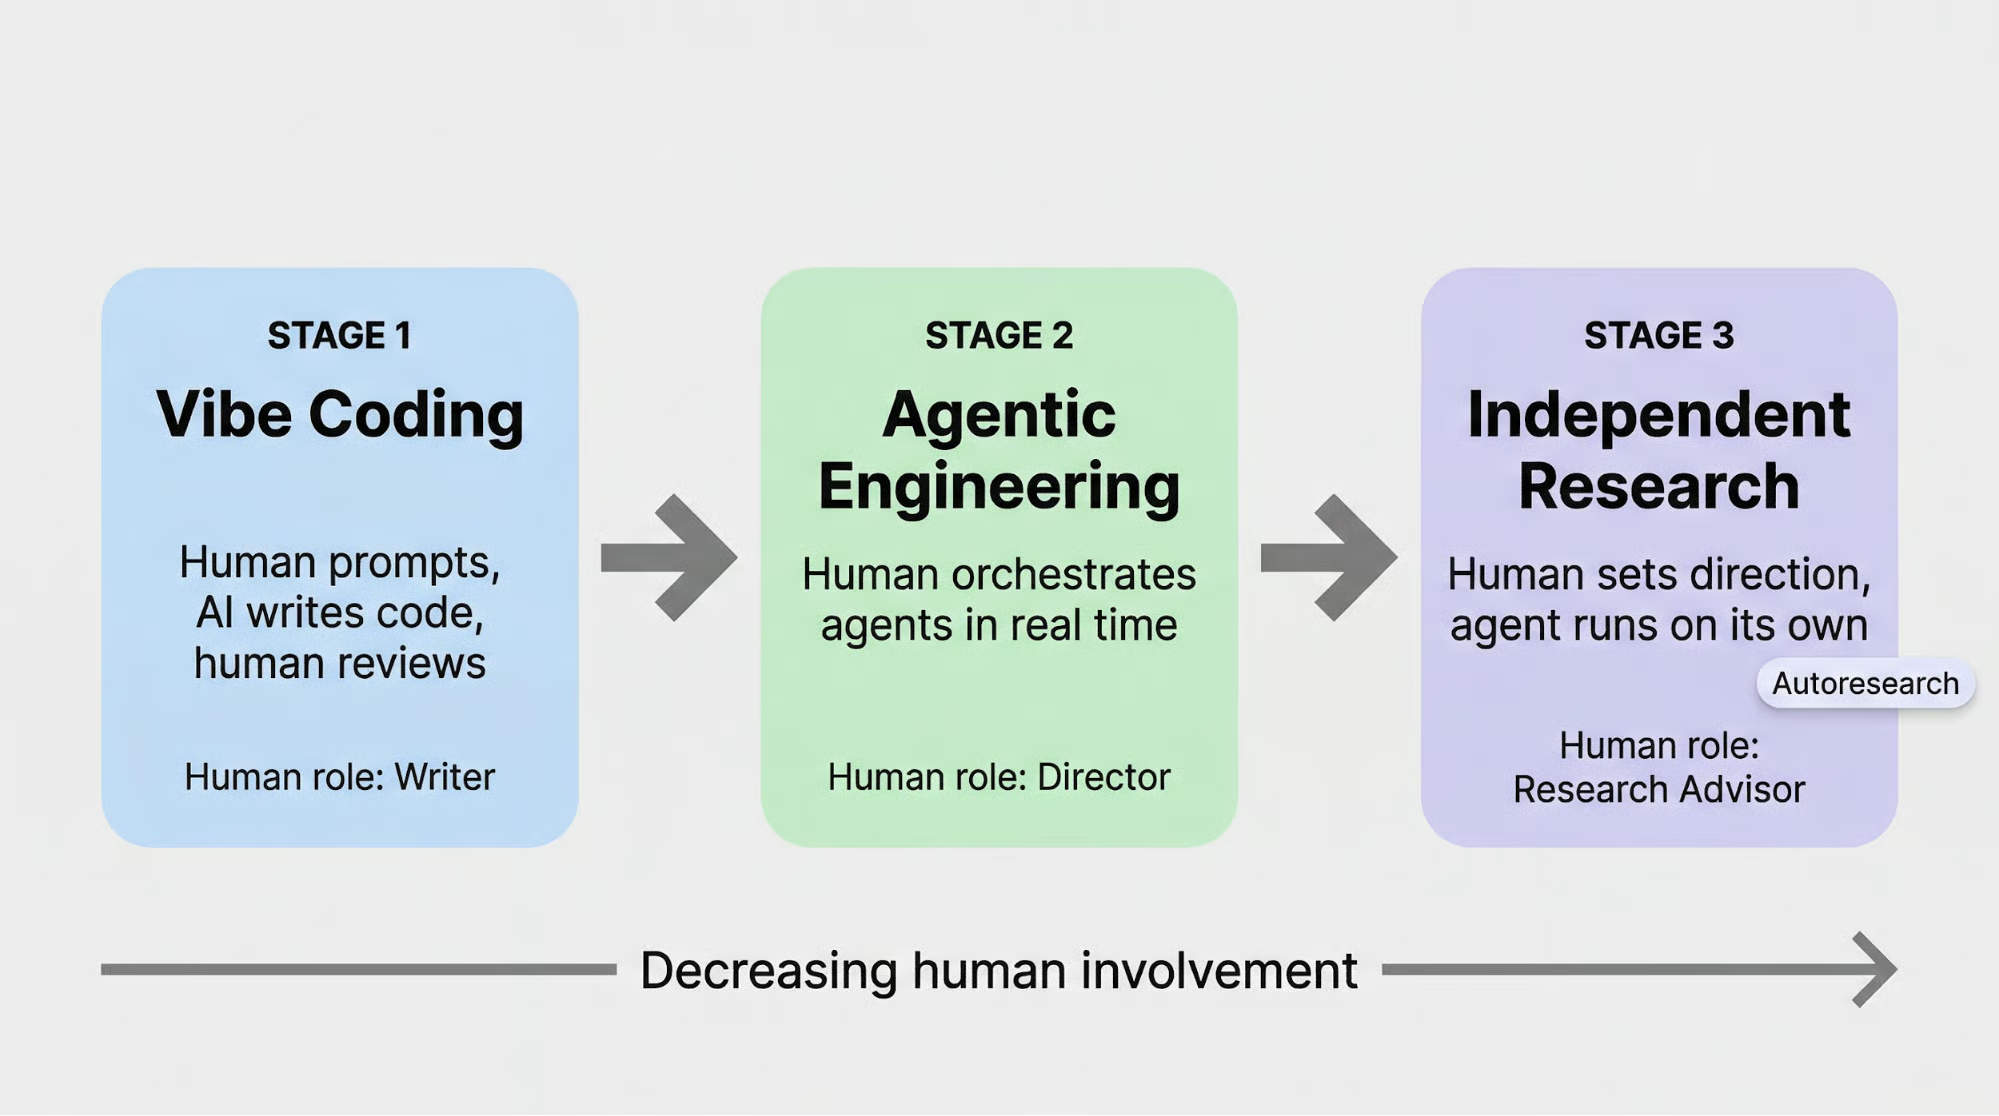
Karpathy lo presenta como una evolución natural de cómo trabajan los ingenieros con IA. En febrero de 2026 acuñó el término «agentic engineering»: «El 99% del tiempo no escribes el código directamente. Orquestas a los agentes que lo hacen y ejerces supervisión.» AutoResearch da el siguiente paso. La persona ni siquiera orquesta. Describe cómo es una buena investigación en un archivo markdown y se va.
La progresión es: vibe coding (la persona indica, la IA escribe, la persona revisa), luego agentic engineering (la persona orquesta agentes en tiempo real) y, por último, investigación totalmente independiente (la persona marca la dirección y el agente trabaja solo).
En cada paso el papel humano se reduce, de escritor a director y, en palabras de Karpathy, a asesor de investigación.
En una publicación posterior describió el siguiente paso: «El objetivo no es emular a una sola persona de doctorado, sino a toda una comunidad de investigación», aludiendo a una colaboración de agentes distribuida al estilo SETI@home.
Cómo materializa el sistema esa visión se reduce a tres archivos.
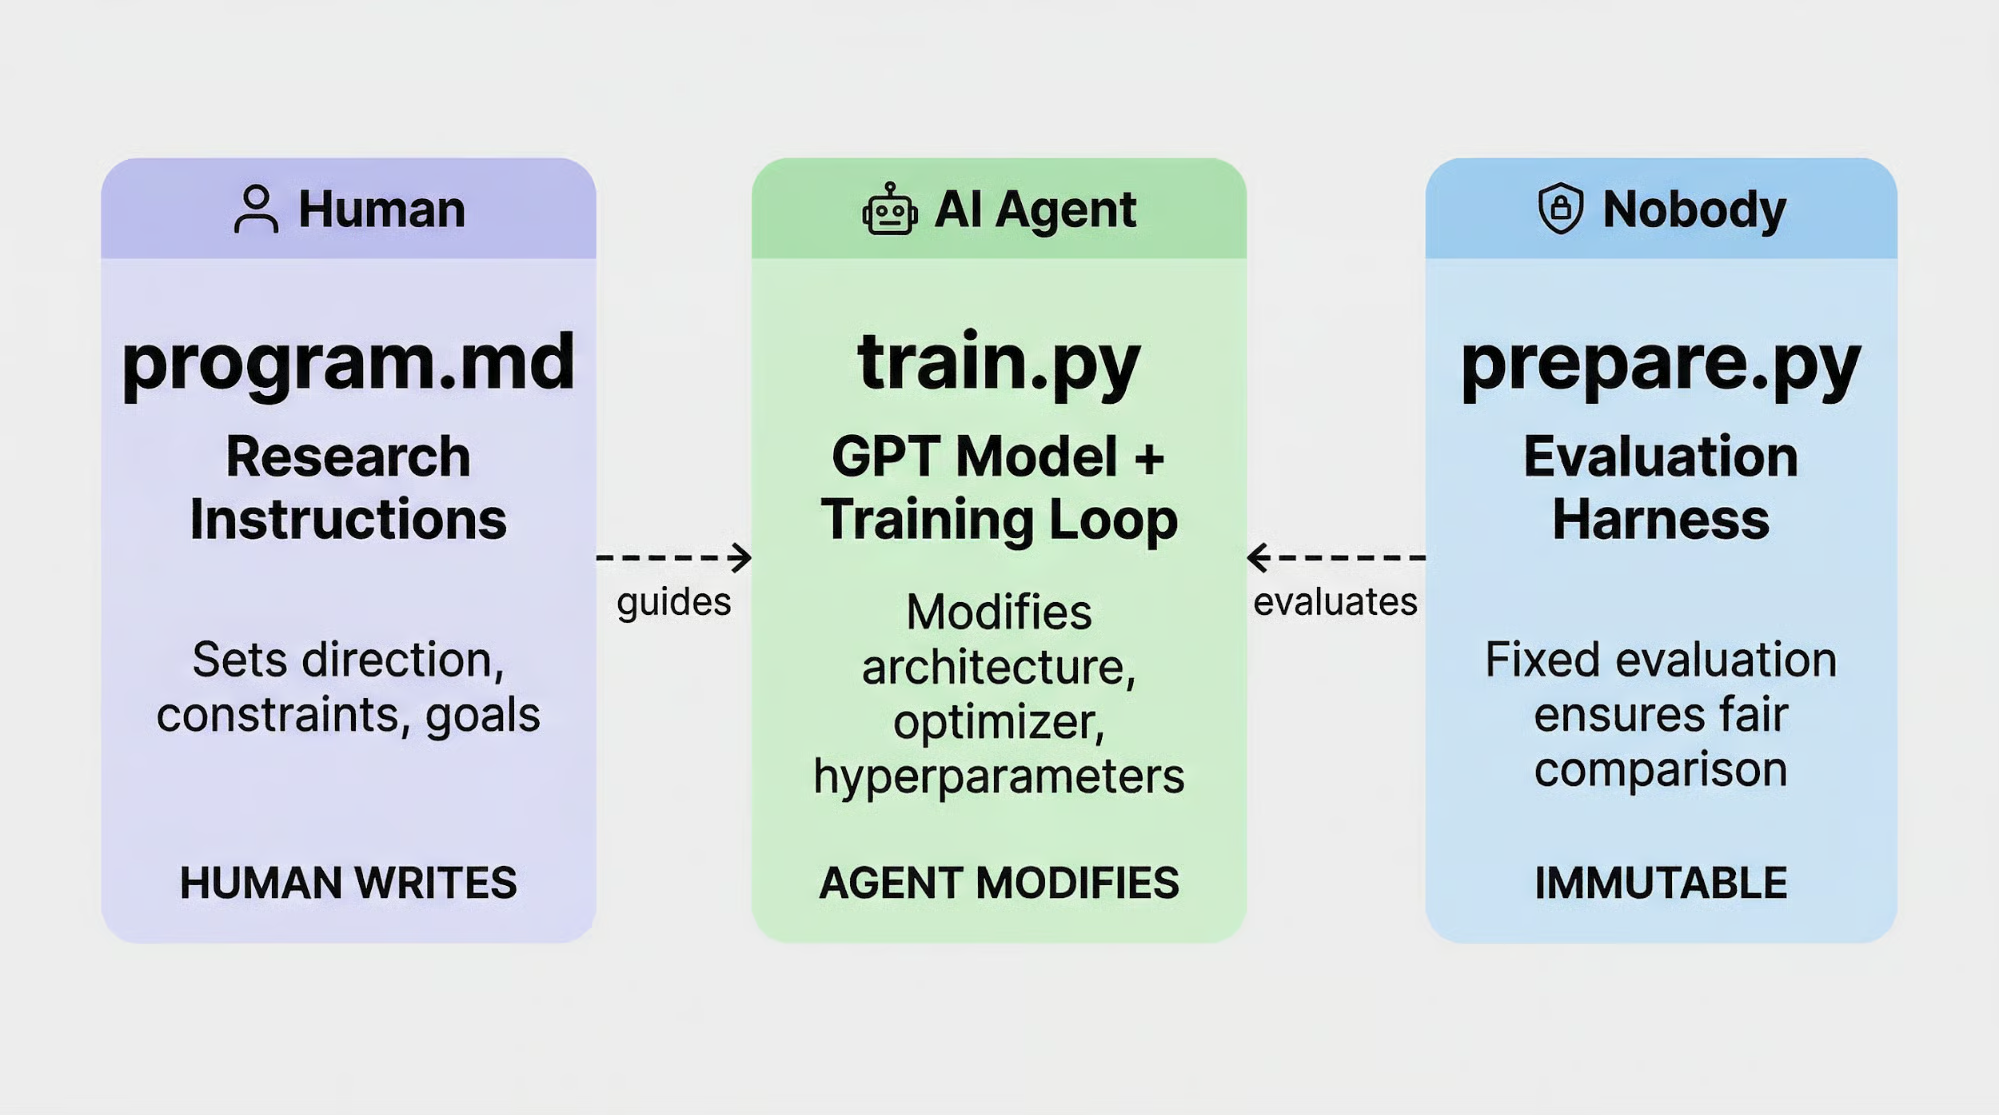
El diseño de AutoResearch se basa en un contrato entre tres archivos, cada uno con reglas estrictas sobre quién puede tocarlo.
prepare.py gestiona la preparación de datos y la evaluación. Construye un tokenizador BPE (Byte Pair Encoding) con un vocabulario de 8.192 tokens, procesa el corpus de entrenamiento y define la métrica de validación: val_bpb (bits por byte en validación).
Este archivo es inmutable: ni la persona ni el agente lo modifican, lo que garantiza que cada experimento se mida con el mismo baremo.
train.py es el sandbox del agente: 630 líneas que contienen la arquitectura del modelo GPT, el optimizador Muon+AdamW y todo el bucle de entrenamiento. El agente puede reescribir cualquier cosa aquí (cambiar funciones de activación, reestructurar las cabezas de atención, variar calendarios de tasa de aprendizaje, modificar la inicialización de pesos) siempre que el código modificado siga entrenando y genere una puntuación val_bpb.
program.md está escrito en markdown plano y es el único archivo que toca la persona. Indica al agente qué líneas de investigación seguir, qué evitar y cómo abordar los experimentos.
program.mdEl archivo es más específico de lo que la mayoría espera. Codifica métricas de referencia para que el agente sepa qué debe superar (val_bpb: 0,997900, pico de VRAM (memoria de vídeo): 45 GB).
Especifica comandos exactos para ejecutar experimentos y extraer resultados. Indica al agente cómo manejar fallos: corregir errores tipográficos y reintentar, saltar ideas rotas de base, matar cualquier cosa que supere los 10 minutos.
E incluye la directriz que hace que todo funcione: «NUNCA PARES. Una vez que comience el bucle de experimentos, NO te detengas para preguntar a la persona si debes continuar.»
También hay una restricción de diseño que condiciona cada experimento: «Si todo lo demás es igual, mejor lo simple. Una pequeña mejora que añade complejidad fea no compensa.» Esto aleja al agente de soluciones sobreingenierizadas y lo orienta hacia cambios limpios que aprobaría una revisión humana.
La división del trabajo es nítida. La persona marca la dirección de la investigación mediante program.md, el agente ejecuta modificando train.py y prepare.py actúa como juez neutral que ninguna de las partes puede tocar. Con ese contrato, el agente ejecuta el bucle de experimentos de forma continua sin detenerse.
El núcleo de AutoResearch es un ciclo de experimentos que se ejecuta sin intervención humana. Así funciona una iteración, siguiendo el bucle de 9 pasos definido en program.md:
program.md para entender prioridades y restricciones de investigación.train.py actual y los resultados recientes en results.tsv.train.py para implementar el cambio propuesto.val_bpb y anota el resultado en results.tsv.val_bpb mejora: el commit se queda. Si no: git reset HEAD~1 revierte a la versión anterior.Luego vuelve a empezar desde el paso 1.
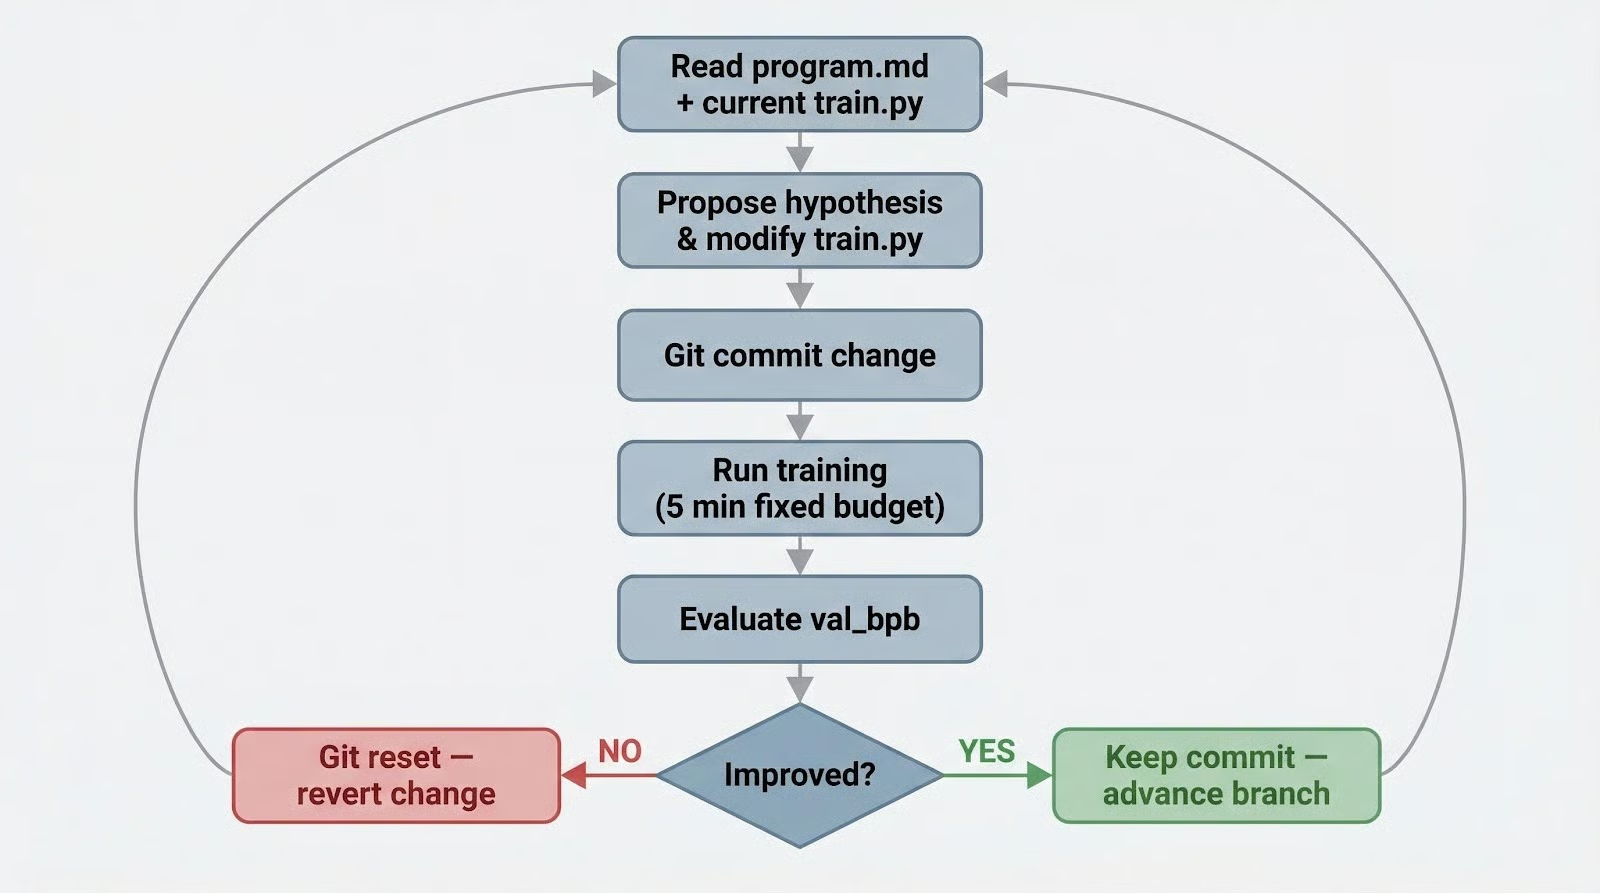
Cada experimento tiene el mismo presupuesto de 5 minutos de tiempo de pared, lo que hace los resultados directamente comparables. Un cambio que entrena más rápido y otro que converge más bajo se evalúan en igualdad de condiciones.
A 5 minutos por experimento, el sistema ejecuta unos 12 por hora.
El nombre «carraca» viene del historial de git. Cada experimento exitoso añade un commit; cada fallo se revierte. La base de código solo puede avanzar, nunca retroceder, acumulando mejoras validadas una a una.
Se parece en estructura a los algoritmos evolutivos, pero AutoResearch mantiene una única línea en lugar de una población. En vez de cruce y mutación entre candidatos, el LLM actúa a la vez como operador de mutación (propone cambios) y como presión de selección (elige qué probar en función de resultados previos).
Lee su propio historial de git y results.tsv para construir sobre lo que haya mostrado potencial.
El archivo results.tsv registra cada experimento: hash del commit, puntuación val_bpb, uso de memoria de la GPU, estado (aprobado/fallido) y una descripción de lo que intentó el agente.
Tienes una trazabilidad clara para revisar por la mañana, y el agente usa el mismo registro para calibrar qué probar a continuación. Los primeros experimentos suelen ser amplios (probar configuraciones de optimizador distintas), y más tarde se concentran en la dirección que validan los datos.
Para ejecutar AutoResearch necesitas una máquina con GPU de NVIDIA (la configuración por defecto apunta a GPUs modernas con más de 20 GB de VRAM), Python 3.10+, uv y un agente de programación (Claude Code, Cursor o similar).
Clona el repositorio, instala dependencias y prepara el conjunto de datos:
git clone https://github.com/karpathy/autoresearch.git
cd autoresearch
uv sync
uv run prepare.py
No hay script de orquestación. No hay run.py, ni pipeline, ni framework.
El README dice: «simplemente inicia tu Claude/Codex o lo que quieras en este repo».
Abres un agente de programación en el directorio del proyecto, le pides que lea program.md y el propio agente ejecuta el bucle de experimentos.
El LLM es la capa de automatización. Supervisa el avance haciendo tail a results.tsv o consultando el log de git para ver nuevos commits.
La configuración por defecto entrena un modelo GPT sobre el conjunto FineWeb-Edu, que requiere una GPU decente y varias horas para mostrar resultados. Para una primera prueba en hardware más modesto, Karpathy recomienda cambiar a TinyStories y reducir el modelo bajando el vocabulario a 256 y la profundidad a 4.
Estos cambios reducen los requisitos de VRAM y acortan cada experimento lo suficiente como para ver la carraca en acción en un par de horas.
Lee el program.md por defecto antes de lanzar una ejecución nocturna. Define la agenda de investigación que seguirá el agente, y editarlo es la forma de dirigir los experimentos.
Si quieres que el agente se centre en mecanismos de atención, indícalo en program.md.
Si quieres que no toque el optimizador, añade esa restricción. El agente no se desviará de lo que esté escrito ahí.
Para una primera noche, espera 80-100 experimentos con quizá 15-20 mejoras que se conserven. Algunas cosas prácticas a tener en cuenta:
results.tsv por la mañana en lugar de mirar la terminal. La «escalera» de puntuaciones val_bpb cuenta mejor la historia que los logs individuales.AutoResearch se ha probado en múltiples ejecuciones: desde experimentos del propio Karpathy hasta reproducciones de la comunidad y adopción en producción.
|
Ejecución |
Experimentos |
Mejoras conservadas |
Resultado |
|
Noche inicial (una GPU) |
83 |
15 |
val_bpb: 1,000 → 0,975 |
|
Ejecución ampliada 2 días (profundidad-12) |
~700 |
~20 |
Todas aditivas; transferidas a modelos profundidad-24 |
|
Impacto en producción |
- |
- |
Tiempo hasta benchmark GPT-2: 2,02 h → 1,80 h (11% más rápido) |
|
Sesión de la comunidad |
126 |
- |
val_bpb: 0,9979 → 0,9697 |
El agente encontró cosas que una persona metódica acabaría encontrando. QKnorm carecía de un multiplicador de escala para afilar la atención, las Value Embeddings se benefician de la regularización y hubo mejoras en el ajuste de atención bandeada, parámetros beta de AdamW y programación del weight decay.
Son cambios estructurales de código, no barridos aleatorios de hiperparámetros, y probar cada uno manualmente habría llevado días.
El CEO de Shopify, Tobi Lutke, adaptó AutoResearch para un modelo interno de expansión de consultas y obtuvo una mejora del 19% en validación tras 37 experimentos con un modelo de 0,8B de parámetros, reportando resultados al día siguiente de empezar.
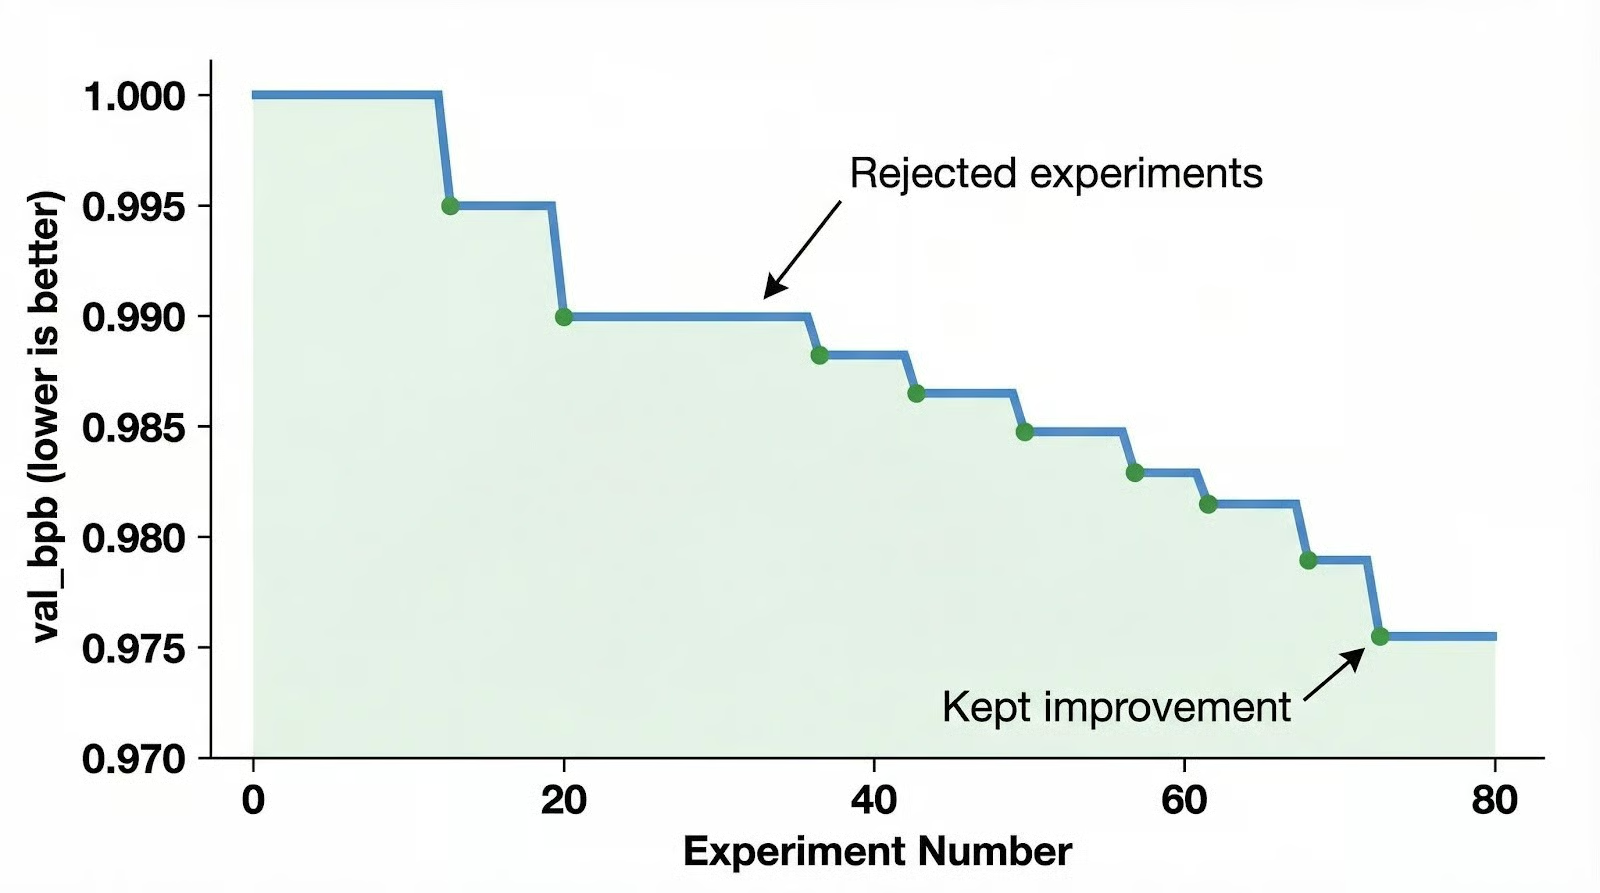
La gráfica en escalera es real, pero cada peldaño es pequeño. El agente encuentra mejoras genuinas, ajustando un beta por aquí, añadiendo regularización por allá. Nadie ha informado de que invente un mecanismo de atención nuevo ni que proponga una idea arquitectónica a la que no llegaría una persona investigadora con el tiempo.
GitHub Issue #22 recoge el problema estructural. Un usuario observó que el agente cicla por variaciones menores de lo que funcionó por última vez, atrapado en un patrón de búsqueda local.
La carraca solo acepta cambios que mejoran val_bpb de inmediato, así que el agente no puede dar un paso atrás para preparar una ganancia mayor.
Las personas investigadoras razonan a menudo: «empeorará antes de mejorar». La carraca no deja espacio para eso.
Karpathy reconoció un problema relacionado en Hacker News: el agente se siente «reservado y asustado» en problemas abiertos.
Lo atribuye al RLHF (aprendizaje por refuerzo con feedback humano), que premia salidas seguras y conservadoras frente a la experimentación audaz. El agente es capaz de proponer cambios creativos, pero está entrenado para ir sobre seguro.
La ventana fija de 5 minutos de entrenamiento añade otra restricción.
Los cambios que demuestran su valor rápido se encuentran; los que solo se justificarían con ejecuciones más largas quedan invisibles. Y ejecutar 100 experimentos contra el mismo conjunto de validación conlleva riesgo de sobreajuste: algunas mejoras pueden ser específicas de esa evaluación y no ganancias reales. La inmutabilidad de prepare.py, garantía de equidad del sistema, es también su punto ciego.
La comunidad debate si el techo viene del marco o del modelo subyacente. Las propuestas incluyen optimización del meta-prompt (un segundo agente reescribe program.md según resultados), directrices de diversidad que premien la novedad además de la mejora, y experimentos de «reinicio» periódicos partiendo de un checkpoint anterior para escapar de óptimos locales.
Hoy por hoy, AutoResearch automatiza la parte metódica de la investigación en ML: ejecutar y evaluar cientos de experimentos pequeños. No sustituye la parte creativa —formular nuevas líneas de investigación—, que sigue siendo humana. Esa división del trabajo es también el mejor indicador de si esta herramienta encaja en tu flujo.
El contrato de tres archivos (evaluador inmutable, implementación modificable por el agente, dirección escrita por la persona) trasciende el entrenamiento de LLM a cualquier dominio donde puedas definir una función de puntuación automática.
Optimización de ranking de búsqueda, categorización de productos, reconocimiento de entidades clínicas, scoring de fraude, clasificación de intención: estas tareas comparten los rasgos adecuados. Modelos pequeños que entrenan en minutos, funciones de evaluación claras y mejoras que se transfieren al escalar.
Cuando los experimentos corren 100 veces más rápido de lo que una persona puede gestionar, la limitación pasa a ser el pipeline de evaluación. Los benchmarks estáticos se saturan rápido. Los equipos que adopten este patrón necesitan conjuntos de evaluación que evolucionen con los datos de producción y casos borde más duros.
El propio Karpathy ejecuta un «primo mayor» de AutoResearch en 8x H100 con su framework de producción nanochat, lo que sugiere que el patrón escala más allá de experimentos de juguete. La comunidad ya lo ha bifurcado para macOS/Apple Silicon y se han propuesto integraciones para GPUs antiguas. La guía CPU vs GPU explica por qué el hardware GPU es innegociable para este tipo de entrenamiento iterativo.
Si tu objetivo es exprimir mejoras incrementales de un pipeline de entrenamiento bien entendido, AutoResearch encaja bien. El techo de creatividad implica que seguirás necesitando a personas investigadoras para problemas que requieren verdadera novedad, y la herramienta brilla en la mayoría de trabajos de investigación que son iteración metódica.
Escribir un buen program.md exige haber hecho tú mismo la investigación. Tienes que saber qué direcciones merece la pena probar, qué significa «mejor» para tu problema y cuándo las mejoras incrementales ya han dado de sí. El agente se encarga de la ejecución, pero el criterio detrás de la agenda de investigación sigue siendo humano. Si la próxima generación de ingenieros se salta ese aprendizaje porque ahora lo hacen los agentes, tendremos mucha computación y pocas personas con la experiencia para dirigirla hacia el lugar correcto.
Los mejores cursos de DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Adel Nehme
15 min
blog
Abid Ali Awan
8 min
Tutorial
Abid Ali Awan
12 min
Tutorial