

学习路径
Python 开发人员
28 小时
实践并学习路径你的进步。
使用 Google 继续当今天的数据从业者谈到数据存储时,大多数情况下指的是数据存放在哪里——本地文件、SQL 或 NoSQL 数据库,或云端。然而,与数据存储相关的另一重要方面是数据如何被存储。
数据存储的如何常常发生在更底层,也就是编程语言的核心层面。它关乎我们所用工具的设计,而非如何使用这些工具。但了解数据是如何存储的,对理解支撑我们工作的底层机制至关重要。而且,这些知识还能帮助我们做出更好的决策,以提升计算性能。
如果您对哈希映射,以及链表、栈、队列和图等数据结构真正感兴趣,欢迎在 DataCamp 注册,学习我们的Python 数据结构与算法课程。
要定义哈希映射,首先需要理解什么是哈希。哈希指的是将任意给定的键或字符序列转换为另一个值的过程。结果通常是更短、固定长度的值,比原始键在计算上更易处理。
哈希映射(也称哈希表)是哈希最常见的实现之一。哈希映射以列表形式存储键值对(例如,员工 ID 与员工姓名),并可通过索引访问。可以说,哈希映射是一种利用哈希技术以关联方式存储数据的数据结构。它们经过优化,能够更快地进行插入、删除和查找等数据操作。
哈希映射背后的思想是将条目(键/值对)分布到一个由桶组成的数组中。给定一个键,哈希函数会计算出一个唯一的索引,指示该条目可在何处找到。使用索引而非原始键,使哈希映射特别适合执行多种数据操作,包括插入、删除和查找。
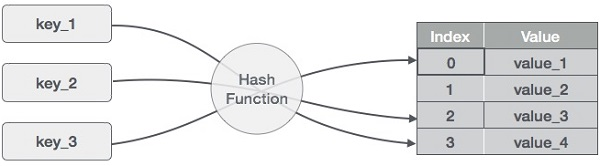
哈希映射的工作原理。图片由作者提供
为计算哈希值(或简称哈希),哈希函数会依据某种数学哈希算法生成新值。由于键值对在理论上是无限的,哈希函数会基于给定的表大小来映射键。
可用的哈希函数有多种,各有优缺点。哈希函数的主要目标是:对相同输入始终返回相同的值。
最常见的有:
Python 通过内置的字典数据类型实现哈希映射。与哈希映射类似,字典以 {key:value} 形式存储数据。创建字典后(见下一节),Python 会在底层应用合适的哈希函数来计算每个键的哈希值。
Python 字典具有以下特性:
因此,如果您曾经疑惑哈希映射与字典的区别,答案很简单。字典正是 Python 对哈希映射的原生实现。哈希映射是一类可用多种哈希技术构建的数据结构,而字典是特定的、基于 Python 的哈希映射,其设计与行为由 Python 的 dict 类所定义。
许多现代编程语言(如 Python、Java 和 C++)都支持哈希映射。在 Python 中,哈希映射通过字典来实现——这是一种您很可能已经熟悉的常用数据结构。接下来几节,我们将介绍字典的基础、其工作原理,以及如何借助不同的 Python 包来使用它们。
下面来看看一些最常见的字典操作。要了解更多用法,请查看我们的Python 字典教程。
在 Python 中创建字典非常简单。您只需使用花括号,并以逗号分隔插入键值对。或者,也可以使用内置的 dict() 函数。让我们创建一个将首都映射到国家的字典:
# Create dictionary
dictionary_capitals = {'Madrid': 'Spain', 'Lisboa': 'Portugal', 'London': 'United Kingdom'}

# Print the content of the dictionary
print(dictionary_capitals)

# Expected output:
# {'Madrid': 'Spain', 'Lisboa': 'Portugal', 'London': 'United Kingdom'}
需要牢记,字典中的键必须唯一;不允许重复。然而,如果出现重复键,Python 不会报错,而是以最后一次出现的该键为准,忽略第一次的键值对。亲自看看:
dictionary_capitals = {'Madrid': 'China', 'Lisboa': 'Portugal',
                       'London': 'United Kingdom','Madrid':'Spain'}

print(dictionary_capitals)

# Expected output:
# {'Madrid': 'Spain', 'Lisboa': 'Portugal', 'London': 'United Kingdom'}要在字典中查找信息,我们需要在方括号中指定键,Python 将返回关联的值,如下所示:
# Search for data
print(dictionary_capitals['Madrid'])

# Expected output: Spain
如果尝试访问字典中不存在的键,Python 会抛出错误。为避免这种情况,可以使用 .get() 方法访问键。若键不存在,将返回 None:
print(dictionary_capitals.get('Prague'))

# Expected output: None我们来添加一个新的首都-国家对:
# Create a new key-value pair
dictionary_capitals['Berlin'] = 'Italy'

print(dictionary_capitals)

# Expected output:
# {'Madrid': 'Spain', 'Lisboa': 'Portugal', 'London': 'United Kingdom', 'Berlin': 'Italy'}
相同的语法也可用于更新某个键关联的值。我们来修正 Berlin 对应的值:
# Update the value of a key
dictionary_capitals['Berlin'] = 'Germany'

print(dictionary_capitals)

# Expected output:
# {'Madrid': 'Spain', 'Lisboa': 'Portugal', 'London': 'United Kingdom', 'Berlin': 'Germany'}
现在我们来删除字典中的一对键值:
# Delete key-value pair
del dictionary_capitals['Lisboa']

print(dictionary_capitals)

# Expected output:
# {'Madrid': 'Spain', 'London': 'United Kingdom', 'Berlin': 'Germany'}
或者,如果要删除字典中的所有键值对,可以使用 .clear() 方法:
dictionary_capitals.clear()

print(dictionary_capitals)

# Expected output: {}如果您想获取所有键值对,请使用 .items() 方法,Python 会返回一个可迭代的元组列表:
dictionary_capitals = {'Madrid': 'Spain', 'Lisboa': 'Portugal',
                      'London': 'United Kingdom', 'Berlin': 'Germany'}

print(dictionary_capitals.items())

# Expected output:
# dict_items([('Madrid', 'Spain'), ('Lisboa', 'Portugal'),
# ('London', 'United Kingdom'), ('Berlin', 'Germany')])
# Iterate over key-value pairs
for key, value in dictionary_capitals.items():
print('the capital of {} is {}'.format(value, key))
# Expected output:
# the capital of Spain is Madrid
# the capital of Portugal is Lisboa
# the capital of United Kingdom is London
# the capital of Germany is Berlin同样地,如果您想分别获取键和值组成的可迭代列表,可以使用 .keys() 和 .values() 方法:
print(dictionary_capitals.keys())

# Expected output:
# dict_keys(['Madrid', 'Lisboa', 'London', 'Berlin'])
for key in dictionary_capitals.keys():
print(key.upper())
# Expected output:
# MADRID
# LISBOA
# LONDON
# BERLINprint(dictionary_capitals.values())
# Expected output:
# dict_values(['Spain', 'Portugal', 'United Kingdom', 'Germany'])for value in dictionary_capitals.values():
print(value.upper())
# Expected output:
# SPAIN
# PORTUGAL
# UNITED KINGDOM
# GERMANY哈希映射是功能强大的数据结构,几乎无处不在。以下是一些真实世界中的应用:
哈希映射是极其通用且高效的数据结构,但也存在问题与局限。为应对与哈希映射相关的常见挑战,需要牢记一些注意事项与良好实践。
这很好理解:如果键的内容发生变化,哈希函数会返回不同的哈希值,Python 将无法找到与该键关联的值。
哈希只有在每个项目都映射到哈希表中的唯一位置时才理想。但有时,不同输入会产生相同的哈希输出。例如,若使用除留余数法,不同整数可能得到相同的余数,从而产生所谓的碰撞。碰撞必须被解决,已有多种技术可用。幸运的是,就字典而言,Python 会在底层处理潜在的碰撞。
装载因子定义为表中元素数量与桶总数之比。它用于估计数据分布的均匀程度。经验上,数据分布越均匀,发生碰撞的可能性越小。同样地,对于字典,Python 会在插入或删除键值对时自动调整表大小。
一个良好的哈希函数应尽量减少碰撞、易于计算,并将项目在哈希表中均匀分布。这可以通过增大表大小或提高哈希函数复杂度来实现。虽然对小规模项目可行,但当可能项目数巨大时,就不可取了,因为这会导致占用大量内存、效率更低的哈希映射。
字典很强大,但针对您的具体数据与需求,其他数据结构或许更合适。毕竟,字典不支持诸如索引、切片与拼接等常见操作,使其在某些场景下不够灵活、使用难度更高。
如前所述,Python 通过内置字典实现哈希映射。不过,还需注意,Python 还有其他原生工具以及第三方库,可用于发挥哈希映射的威力。
下面来看一些最受欢迎的示例。
每当您尝试访问字典中不存在的键时,Python 会抛出 KeyError。一种防范方式是使用 .get() 方法来查找。但更优化的方式是使用 Defaultdict(位于 collections 模块)。Defaultdict 与字典几乎相同,唯一区别在于:Defaultdict 对不存在的键会提供默认值,因此从不抛出错误。
from collections import defaultdict

# Defining the dict
capitals = defaultdict(lambda: "The key doesn't exist")
capitals['Madrid'] = 'Spain'
capitals['Lisboa'] = 'Portugal'

print(capitals['Madrid'])
print(capitals['Lisboa'])
print(capitals['Ankara'])

# Expected output:
# Spain
# Portugal
# The key doesn't exist
Counter 是 Python 字典的一个子类,专为统计可哈希对象而设计。它把元素作为键、计数作为值来存储。
初始化 Counter 的方式有多种:
通过一个序列。
通过包含键与计数的字典。
使用 name:value 的映射。
from collections import Counter

# a new counter from an iterable
c1 = Counter(['aaa','bbb','aaa','ccc','ccc','aaa'])
# a new counter from a mapping
c2 = Counter({'red': 4, 'blue': 2})
# a new counter from keyword args
c3 = Counter(cats=4, dogs=8)
# print results
print(c1)
print(c2)
print(c3)

# Expected output:
# Counter({'aaa': 3, 'ccc': 2, 'bbb': 1})
# Counter({'red': 4, 'blue': 2})
# Counter({'dogs': 8, 'cats': 4})
Counter 类带有一系列便捷方法,可用于完成常见统计。
print('keys of the counter: ', c3.keys())
print('values of the counter: ',c3.values())
print('list with all elements: ', list(c3.elements()))
print('number of elements: ', c3.total()) # number elements
print('2 most common occurrences: ', c3.most_common(2)) # 2 most common occurrences

# Expected output:
# keys of the counter:  dict_keys(['cats', 'dogs'])
# values of the counter:  dict_values([4, 8])
# list with all elements:  ['cats', 'cats', 'cats', 'cats', 'dogs', 'dogs', 'dogs', 'dogs', 'dogs', 'dogs', 'dogs', 'dogs']
# number of elements:  12
# 2 most common occurrences: [('dogs', 8), ('cats', 4)]Scikit-learn(也称 sklearn)是一个开源、强大的 Python 机器学习库,旨在简化在 Python 中实现机器学习与统计模型的过程。
Sklearn 提供多种哈希相关方法,对特征工程非常有用。
其中最常见的方法之一是 CountVectorizer。它将给定文本按词频转换为向量,特别适用于文本分析场景。
from sklearn.feature_extraction.text import CountVectorizer
import pandas as pd

documents = ["Welcome to this new DataCamp Python course",
            "Welcome to this new DataCamp R skill track",
            "Welcome to this new DataCamp Data Analyst career track"]

# Create a Vectorizer Object
vectorizer = CountVectorizer()

X = vectorizer.fit_transform(documents)

# print unique values
print('unique words: ', vectorizer.get_feature_names_out())

# print sparse matrix with word frequency
pd.DataFrame(X.toarray(), columns = vectorizer.get_feature_names_out())

# Expected output:
# unique words:  ['analyst' 'career' 'course' 'data' 'datacamp' 'new' 'python' 'skill'
# 'this' 'to' 'track' 'welcome']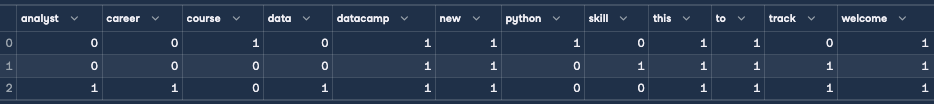
sklearn 中还有其他哈希方法,包括 FeatureHasher 和 DictVectorizer。
恭喜您完成本次关于哈希映射的教程。我们希望您现在对哈希映射与 Python 字典有了更深入的理解。如果您想进一步了解字典及其在真实场景中的用法,我们强烈建议阅读我们的Python 字典教程以及Python 字典推导式教程。
最后,如果您刚开始学习 Python,想了解更多,请学习 DataCamp 的Python 数据科学入门课程,并查看我们的面向初学者的 Python 课程。
立即开启您的 Python 学习之旅!
学习路径
课程
实践并学习路径你的进步。
使用 Google 继续