

लर्निंग पाथ
Python डेवलपर
28 घंटा
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंजब डेटा पेशेवर आज डेटा स्टोरेज की बात करते हैं, तो अधिकतर समय वे इस पर चर्चा करते हैं कि डेटा कहाँ संग्रहीत है—चाहे लोकल फ़ाइलें हों, SQL या NoSQL डेटाबेस, या क्लाउड। हालांकि, डेटा स्टोरेज का एक और महत्वपूर्ण पहलू यह है कि डेटा कैसे संग्रहीत होता है।
डेटा स्टोरेज का यह कैसे अक्सर निचले स्तर पर, प्रोग्रामिंग भाषाओं के मूल में होता है। यह उन औज़ारों के डिज़ाइन से जुड़ा है जिनका हम उपयोग करते हैं, न कि उन्हें कैसे उपयोग किया जाए। फिर भी, यह जानना कि डेटा कैसे संग्रहीत होता है, उन अंतर्निहित तंत्रों को समझने के लिए महत्वपूर्ण है जो काम को संभव बनाते हैं। साथ ही, यह ज्ञान कंप्यूटिंग प्रदर्शन में सुधार के लिए बेहतर निर्णय लेने में हमारी मदद कर सकता है।
यदि आप हैशमैप्स के साथ-साथ लिंक्ड लिस्ट्स, स्टैक्स, क्यूज़ और ग्राफ़्स में वास्तव में रुचि रखते हैं, तो DataCamp के साथ साइन अप करें ताकि आप हमारा Data Structures and Algorithms in Python कोर्स कर सकें।
हैशमैप को परिभाषित करने के लिए, हमें पहले यह समझना होगा कि हैशिंग क्या है। हैशिंग किसी भी दी गई कुंजी या अक्षरों की स्ट्रिंग को किसी अन्य मान में बदलने की प्रक्रिया है। परिणाम सामान्यतः एक छोटा, निश्चित-लंबाई का मान होता है, जो मूल कुंजी की तुलना में संगणनात्मक रूप से काम करने में आसान होता है।
हैशमैप्स, जिन्हें हैशटेबल्स भी कहा जाता है, हैशिंग के सबसे सामान्य इम्प्लीमेंटेशनों में से एक का प्रतिनिधित्व करते हैं। हैशमैप्स सूची में कुंजी-मूल्य युग्म (उदा., कर्मचारी ID और कर्मचारी नाम) संग्रहीत करते हैं, जिसे उसके इंडेक्स के माध्यम से एक्सेस किया जा सकता है। हम कह सकते हैं कि हैशमैप एक डेटा संरचना है जो एसोसिएटिव ढंग से डेटा संग्रहीत करने के लिए हैशिंग तकनीकों का प्रयोग करती है। ये अनुकूलित डेटा संरचनाएं हैं जो तेज़ इन्सर्शन, डिलीशन और सर्च सहित तेज़ डेटा ऑपरेशन्स की अनुमति देती हैं।
हैशमैप्स के पीछे विचार यह है कि प्रविष्टियों (कुंजी/मूल्य युग्मों) को बकेट्स की एक ऐरे में वितरित किया जाए। किसी कुंजी को देखते हुए, एक हैशिंग फ़ंक्शन एक विशिष्ट इंडेक्स की गणना करेगा जो इंगित करता है कि प्रविष्टि कहाँ मिल सकती है। मूल कुंजी के बजाय इंडेक्स का उपयोग करने से हैशमैप्स डेटा इन्सर्शन, रिमूवल और सर्च सहित कई ऑपरेशन्स के लिए विशेष रूप से उपयुक्त हो जाते हैं।
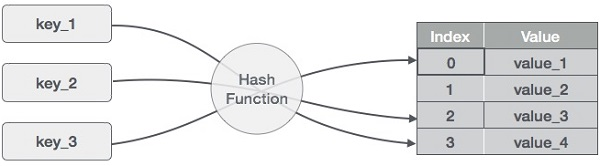
हैशमैप कैसे काम करता है। चित्र: लेखक द्वारा
हैश मान, या संक्षेप में हैश की गणना करने के लिए, एक हैश फ़ंक्शन गणितीय हैशिंग एल्गोरिदम के अनुसार नए मान उत्पन्न करता है। चूंकि सिद्धांततः कुंजी-मूल्य युग्म असीमित हो सकते हैं, हैशिंग फ़ंक्शन दी गई टेबल साइज के आधार पर कुंजियों का मैप करेगा।
विभिन्न हैश फ़ंक्शन्स उपलब्ध हैं, जिनके अपने-अपने फायदे और सीमाएं हैं। हैश फ़ंक्शन का मुख्य लक्ष्य यह है कि किसी भी समान इनपुट के लिए हमेशा वही मान लौटाए।
सबसे आम निम्नलिखित हैं:
Python अंतर्निहित dictionary डेटा टाइप के माध्यम से हैशमैप्स को लागू करता है। हैशमैप्स की तरह, डिक्शनरीज़ डेटा को {key:value} युग्मों में संग्रहीत करती हैं। एक बार जब आप डिक्शनरी बना लेते हैं (अगला अनुभाग देखें), तो Python पर्दे के पीछे एक उपयुक्त हैश फ़ंक्शन लागू करेगा ताकि हर कुंजी का हैश निकाल सके।
Python डिक्शनरीज़ में निम्नलिखित विशेषताएँ होती हैं:
तो, यदि आपने कभी हैशमैप्स बनाम डिक्शनरीज़ के बीच अंतर के बारे में सोचा है, तो उत्तर सरल है। डिक्शनरी Python में हैशमैप का स्वदेशी इम्प्लीमेंटेशन है। जहाँ हैशमैप एक डेटा संरचना है जिसे कई हैशिंग तकनीकों से बनाया जा सकता है, वहीं डिक्शनरी एक विशिष्ट, Python-आधारित हैशमैप है, जिसका डिज़ाइन और व्यवहार Python की dict क्लास में निर्दिष्ट है।
कई आधुनिक प्रोग्रामिंग भाषाएँ, जैसे Python, Java और C++, हैशमैप्स का समर्थन करती हैं। Python में, हैशमैप्स डिक्शनरीज़ के माध्यम से लागू होते हैं—एक व्यापक रूप से प्रयुक्त डेटा संरचना जिससे आप संभवतः परिचित होंगे। अगले अनुभागों में, हम डिक्शनरीज़ की बुनियादी बातें, वे कैसे काम करती हैं, और विभिन्न Python पैकेजों का उपयोग करके उन्हें कैसे लागू किया जाए, कवर करेंगे।
आइए कुछ सबसे सामान्य डिक्शनरी ऑपरेशन्स देखें। डिक्शनरीज़ का उपयोग कैसे करें, इस बारे में अधिक जानने के लिए हमारा Python Dictionaries Tutorial देखें।
Python में डिक्शनरी बनाना काफी सरल है। आपको बस कर्ली ब्रेसेज़ का उपयोग करना है और कॉमा से अलग किए गए कुंजी-मूल्य युग्म डालने हैं। वैकल्पिक रूप से, आप अंतर्निहित dict() फ़ंक्शन का उपयोग कर सकते हैं। आइए एक डिक्शनरी बनाते हैं जो राजधानियों को देशों से मैप करती है:
# Create dictionary
dictionary_capitals = {'Madrid': 'Spain', 'Lisboa': 'Portugal', 'London': 'United Kingdom'}

# Print the content of the dictionary
print(dictionary_capitals)

# Expected output:
# {'Madrid': 'Spain', 'Lisboa': 'Portugal', 'London': 'United Kingdom'}
यह याद रखना महत्वपूर्ण है कि किसी डिक्शनरी में कुंजी अद्वितीय होनी चाहिए; डुप्लिकेट की अनुमति नहीं है। हालांकि, डुप्लिकेट कुंजियों के मामले में, त्रुटि देने के बजाय, Python कुंजी की अंतिम उपस्थिति को मान्य मानेगा और पहले कुंजी-मूल्य युग्म को अनदेखा कर देगा। स्वयं देखें:
dictionary_capitals = {'Madrid': 'China', 'Lisboa': 'Portugal',
                       'London': 'United Kingdom','Madrid':'Spain'}

print(dictionary_capitals)

# Expected output:
# {'Madrid': 'Spain', 'Lisboa': 'Portugal', 'London': 'United Kingdom'}अपनी डिक्शनरी में जानकारी खोजने के लिए, हमें कोष्ठक में कुंजी निर्दिष्ट करनी होती है, और Python संबद्ध मान लौटाएगा, जैसा कि नीचे है:
# Search for data
print(dictionary_capitals['Madrid'])

# Expected output: Spain
यदि आप किसी ऐसी कुंजी तक पहुंचने का प्रयास करते हैं जो डिक्शनरी में मौजूद नहीं है, तो Python एक त्रुटि देगा। इसे रोकने के लिए, आप वैकल्पिक रूप से .get() मेथड का उपयोग करके कुंजियों तक पहुंच सकते हैं। गैर-मौजूद कुंजी के मामले में, यह बस None मान लौटाएगा:
print(dictionary_capitals.get('Prague'))

# Expected output: Noneआइए एक नया राजधानी-देश युग्म जोड़ते हैं:
# Create a new key-value pair
dictionary_capitals['Berlin'] = 'Italy'

print(dictionary_capitals)

# Expected output:
# {'Madrid': 'Spain', 'Lisboa': 'Portugal', 'London': 'United Kingdom', 'Berlin': 'Italy'}
उसी सिंटैक्स का उपयोग किसी कुंजी से जुड़े मान को अपडेट करने के लिए भी किया जा सकता है। आइए Berlin से जुड़े मान को ठीक करें:
# Update the value of a key
dictionary_capitals['Berlin'] = 'Germany'

print(dictionary_capitals)

# Expected output:
# {'Madrid': 'Spain', 'Lisboa': 'Portugal', 'London': 'United Kingdom', 'Berlin': 'Germany'}
अब आइए अपनी डिक्शनरी में से एक युग्म हटाते हैं
# Delete key-value pair
del dictionary_capitals['Lisboa']

print(dictionary_capitals)

# Expected output:
# {'Madrid': 'Spain', 'London': 'United Kingdom', 'Berlin': 'Germany'}
या, यदि आप डिक्शनरी में सभी कुंजी-मूल्य युग्म हटाना चाहें, तो आप .clear() मेथड का उपयोग कर सकते हैं:
dictionary_capitals.clear()

print(dictionary_capitals)

# Expected output: {}यदि आप सभी कुंजी-मूल्य युग्म प्राप्त करना चाहते हैं, तो .items() मेथड का उपयोग करें, और Python ट्यूपल्स की एक इटेरेबल सूची लौटाएगा:
dictionary_capitals = {'Madrid': 'Spain', 'Lisboa': 'Portugal',
                      'London': 'United Kingdom', 'Berlin': 'Germany'}

print(dictionary_capitals.items())

# Expected output:
# dict_items([('Madrid', 'Spain'), ('Lisboa', 'Portugal'),
# ('London', 'United Kingdom'), ('Berlin', 'Germany')])
# Iterate over key-value pairs
for key, value in dictionary_capitals.items():
print('the capital of {} is {}'.format(value, key))
# Expected output:
# the capital of Spain is Madrid
# the capital of Portugal is Lisboa
# the capital of United Kingdom is London
# the capital of Germany is Berlinउसी तरह, यदि आप कुंजियों और मानों के साथ इटेरेबल सूची प्राप्त करना चाहते हैं, तो क्रमशः .keys() और .values() मेथड का उपयोग कर सकते हैं:
print(dictionary_capitals.keys())

# Expected output:
# dict_keys(['Madrid', 'Lisboa', 'London', 'Berlin'])
for key in dictionary_capitals.keys():
print(key.upper())
# Expected output:
# MADRID
# LISBOA
# LONDON
# BERLINprint(dictionary_capitals.values())
# Expected output:
# dict_values(['Spain', 'Portugal', 'United Kingdom', 'Germany'])for value in dictionary_capitals.values():
print(value.upper())
# Expected output:
# SPAIN
# PORTUGAL
# UNITED KINGDOM
# GERMANYहैशमैप्स शक्तिशाली डेटा संरचनाएँ हैं जिनका उपयोग डिजिटल दुनिया में लगभग हर जगह होता है। नीचे आप हैशमैप्स के वास्तविक-जीवन अनुप्रयोगों की सूची पा सकते हैं:
हैशमैप्स अत्यंत बहुमुखी और कुशल डेटा संरचनाएँ हैं। हालांकि, इनके साथ समस्याएँ और सीमाएँ भी आती हैं। हैशमैप्स से जुड़ी सामान्य चुनौतियों का समाधान करने के लिए, कुछ बातों और अच्छी प्रथाओं को ध्यान में रखना महत्वपूर्ण है।
यह तर्कसंगत है: यदि कुंजी की सामग्री बदलती है, तो हैश फ़ंक्शन अलग हैश लौटाएगा, इसलिए Python उस कुंजी से जुड़े मान को नहीं खोज पाएगा।
हैशिंग तभी काम करती है जब प्रत्येक आइटम हैश टेबल में एक अद्वितीय स्थान पर मैप हो। लेकिन कभी-कभी, हैश फ़ंक्शन्स विभिन्न इनपुट्स के लिए वही आउटपुट लौटा सकते हैं। उदाहरण के लिए, यदि आप डिवीजन हैश फ़ंक्शन का उपयोग कर रहे हैं, तो अलग-अलग पूर्णांकों का वही हैश हो सकता है (मॉड्यूलो डिवीजन लागू करने पर वही शेषफल लौट सकता है), जिससे कोलिज़न नामक समस्या उत्पन्न होती है। कोलिज़न को हल करना आवश्यक है, और कई तकनीकें मौजूद हैं। सौभाग्य से, डिक्शनरीज़ के मामले में, Python संभावित कोलिज़न को पर्दे के पीछे संभालता है।
लोड फैक्टर को टेबल में तत्वों की संख्या और कुल बकेट्स की संख्या के अनुपात के रूप में परिभाषित किया जाता है। यह इस बात का आकलन करने का एक माप है कि डेटा कितना अच्छा वितरित है। सामान्य नियम के रूप में, डेटा जितना समान रूप से वितरित होगा, कोलिज़न की संभावना उतनी ही कम होगी। फिर से, डिक्शनरीज़ के मामले में, Python नए कुंजी-मूल्य युग्म जोड़ने या हटाने की स्थिति में स्वचालित रूप से टेबल का आकार अनुकूलित करता है।
एक अच्छा हैश फ़ंक्शन कोलिज़न की संख्या को न्यूनतम करेगा, गणना में आसान होगा, और आइटम्स को हैश टेबल में समान रूप से वितरित करेगा। यह टेबल साइज बढ़ाकर या हैश फ़ंक्शन की जटिलता बढ़ाकर किया जा सकता है। हालांकि यह कम संख्या वाले आइटम्स के लिए व्यावहारिक है, लेकिन संभावित आइटम्स की संख्या बड़ी होने पर यह संभव नहीं है, क्योंकि इससे मेमोरी-खपत करने वाले, कम कुशल हैशमैप्स बनेंगे।
डिक्शनरीज़ बेहतरीन हैं, लेकिन अन्य डेटा संरचनाएँ आपके विशेष डेटा और आवश्यकताओं के लिए अधिक उपयुक्त हो सकती हैं। अंततः, डिक्शनरीज़ सामान्य ऑपरेशन्स जैसे इंडेक्सिंग, स्लाइसिंग और कंकैटनेशन का समर्थन नहीं करतीं, जिससे वे कुछ परिदृश्यों में कम लचीली और काम करने में अधिक कठिन हो सकती हैं।
जैसा कि पहले उल्लेख किया गया है, Python अंतर्निहित डिक्शनरीज़ के माध्यम से हैशमैप्स को लागू करता है। हालाँकि, यह ध्यान देने योग्य है कि हैशमैप्स की शक्ति का लाभ उठाने के लिए अन्य मूल Python टूल्स के साथ-साथ थर्ड-पार्टी लाइब्रेरीज़ भी मौजूद हैं।
आइए कुछ सबसे लोकप्रिय उदाहरण देखें।
हर बार जब आप अपनी डिक्शनरी में मौजूद नहीं किसी कुंजी तक पहुँचने का प्रयास करते हैं, तो Python एक KeyError लौटाएगा। इसे रोकने का एक तरीका .get() मेथड का उपयोग करके जानकारी खोजना है। हालांकि, इसका एक अनुकूलित तरीका Defaultdict का उपयोग करना है, जो collections मॉड्यूल में उपलब्ध है। Defaultdict और डिक्शनरीज़ लगभग समान हैं। एकमात्र अंतर यह है कि Defaultdict कभी त्रुटि नहीं उठाता क्योंकि यह गैर-मौजूद कुंजियों के लिए एक डिफ़ॉल्ट मान प्रदान करता है।
from collections import defaultdict

# Defining the dict
capitals = defaultdict(lambda: "The key doesn't exist")
capitals['Madrid'] = 'Spain'
capitals['Lisboa'] = 'Portugal'

print(capitals['Madrid'])
print(capitals['Lisboa'])
print(capitals['Ankara'])

# Expected output:
# Spain
# Portugal
# The key doesn't exist
Counter Python डिक्शनरी का एक सबक्लास है जिसे विशेष रूप से हैशेबल ऑब्जेक्ट्स की गिनती के लिए डिज़ाइन किया गया है। यह एक डिक्शनरी है जहाँ तत्व कुंजियों के रूप में और उनकी गणना मानों के रूप में संग्रहीत होती है।
Counter को आरंभ करने के कई तरीके हैं:
आइटम्स के अनुक्रम द्वारा।
डिक्शनरी में कुंजियों और काउंट्स द्वारा।
name:value मैपिंग का उपयोग करके।
from collections import Counter

# a new counter from an iterable
c1 = Counter(['aaa','bbb','aaa','ccc','ccc','aaa'])
# a new counter from a mapping
c2 = Counter({'red': 4, 'blue': 2})
# a new counter from keyword args
c3 = Counter(cats=4, dogs=8)
# print results
print(c1)
print(c2)
print(c3)

# Expected output:
# Counter({'aaa': 3, 'ccc': 2, 'bbb': 1})
# Counter({'red': 4, 'blue': 2})
# Counter({'dogs': 8, 'cats': 4})
Counter क्लास सामान्य गणनाएँ करने के लिए कई उपयोगी मेथड्स के साथ आता है।
print('keys of the counter: ', c3.keys())
print('values of the counter: ',c3.values())
print('list with all elements: ', list(c3.elements()))
print('number of elements: ', c3.total()) # number elements
print('2 most common occurrences: ', c3.most_common(2)) # 2 most common occurrences

# Expected output:
# keys of the counter:  dict_keys(['cats', 'dogs'])
# values of the counter:  dict_values([4, 8])
# list with all elements:  ['cats', 'cats', 'cats', 'cats', 'dogs', 'dogs', 'dogs', 'dogs', 'dogs', 'dogs', 'dogs', 'dogs']
# number of elements:  12
# 2 most common occurrences: [('dogs', 8), ('cats', 4)]Scikit-learn, जिसे sklearn भी कहा जाता है, एक मुक्त-स्रोत, मज़बूत Python मशीन लर्निंग लाइब्रेरी है। इसे Python में मशीन लर्निंग और सांख्यिकीय मॉडलों को लागू करने की प्रक्रिया को सरल बनाने के लिए बनाया गया था।
Sklearn विभिन्न हैशिंग विधियों के साथ आता है जो फीचर इंजीनियरिंग प्रक्रियाओं के लिए बहुत उपयोगी हो सकती हैं।
सबसे आम में से एक CountVectorizer मेथड है। इसका उपयोग दिए गए टेक्स्ट को एक वेक्टर में बदलने के लिए किया जाता है, जो पूरे टेक्स्ट में प्रत्येक शब्द की आवृत्ति पर आधारित होता है। CountVectorizer टेक्स्ट विश्लेषण संदर्भों में विशेष रूप से सहायक है।
from sklearn.feature_extraction.text import CountVectorizer
import pandas as pd

documents = ["Welcome to this new DataCamp Python course",
            "Welcome to this new DataCamp R skill track",
            "Welcome to this new DataCamp Data Analyst career track"]

# Create a Vectorizer Object
vectorizer = CountVectorizer()

X = vectorizer.fit_transform(documents)

# print unique values
print('unique words: ', vectorizer.get_feature_names_out())

# print sparse matrix with word frequency
pd.DataFrame(X.toarray(), columns = vectorizer.get_feature_names_out())

# Expected output:
# unique words:  ['analyst' 'career' 'course' 'data' 'datacamp' 'new' 'python' 'skill'
# 'this' 'to' 'track' 'welcome']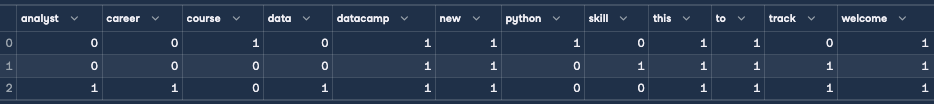
sklearn में अन्य हैशिंग विधियाँ भी हैं, जिनमें FeatureHasher और DictVectorizer शामिल हैं।
इस हैशमैप ट्यूटोरियल को पूरा करने पर बधाई। हमें उम्मीद है कि अब आपको हैशमैप्स और Python डिक्शनरीज़ की बेहतर समझ है। यदि आप डिक्शनरीज़ के बारे में और वास्तविक परिदृश्यों में उनका उपयोग कैसे करें, यह सीखना चाहते हैं, तो हम आपको हमारा समर्पित Python Dictionaries Tutorial और हमारा Python Dictionary Comprehension Tutorial पढ़ने की अत्यधिक सलाह देते हैं।
अंत में, यदि आप Python में अभी शुरुआत कर रहे हैं और अधिक सीखना चाहते हैं, तो DataCamp का Introduction to Data Science in Python कोर्स करें और हमारा Python course for Beginners देखें।
आज ही अपना Python सफर शुरू करें!
लर्निंग पाथ
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें