
课程
理解机器学习
2 小时
313.2K
实践并学习路径你的进步。
使用 Google 继续机器学习算法热度很高,对相关专家的需求也与日俱增。众所周知,技能要求与人才供给之间存在显著缺口。H2O 的目标是为非专家提供一个便于进行机器学习试验的平台。
H2O 的架构可分为不同层:顶层是各类 API,底层是 H2O JVM。
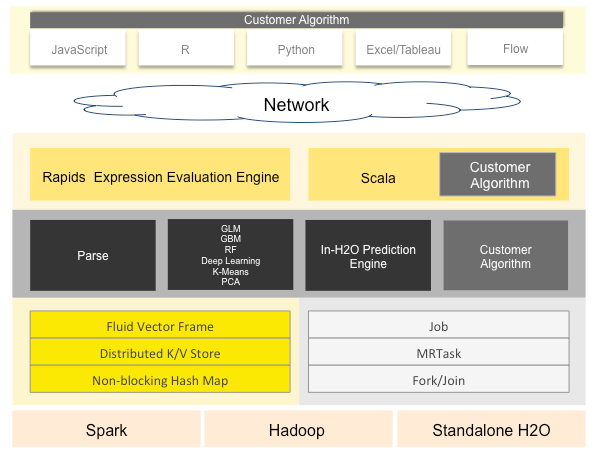
H2O 的核心代码使用 Java 编写,使整个框架具备多线程能力。尽管使用 Java 编写,但它提供了 R、Python 等接口(如架构图所示),因此可以高效使用。
总而言之,H2O 是一个开源、内存型、分布式、快速且可扩展的机器学习与预测分析平台,使构建机器学习模型变得更为容易。
如果您想在 R 中使用 H2O 功能,只需运行 install.packages("h2o") 安装 H2O 包。
library(h2o)
##
## ----------------------------------------------------------------------
##
## Your next step is to start H2O:
##     > h2o.init()
##
## For H2O package documentation, ask for help:
##     > ??h2o
##
## After starting H2O, you can use the Web UI at http://localhost:54321
## For more information visit http://docs.h2o.ai
##
## ----------------------------------------------------------------------

##
## Attaching package: 'h2o'

## The following objects are masked from 'package:stats':
##
##     cor, sd, var

## The following objects are masked from 'package:base':
##
##     %*%, %in%, &&, ||, apply, as.factor, as.numeric, colnames,
##     colnames<-, ifelse, is.character, is.factor, is.numeric, log,
##     log10, log1p, log2, round, signif, trunc
h2o.init()
##  Connection successful!
##
## R is connected to the H2O cluster:
##     H2O cluster uptime:         32 minutes 57 seconds
##     H2O cluster timezone:       Asia/Kolkata
##     H2O data parsing timezone:  UTC
##     H2O cluster version:        3.20.0.2
##     H2O cluster version age:    3 months and 22 days !!!
##     H2O cluster name:           H2O_started_from_R_NSingh1_wou076
##     H2O cluster total nodes:    1
##     H2O cluster total memory:   1.55 GB
##     H2O cluster total cores:    4
##     H2O cluster allowed cores:  4
##     H2O cluster healthy:        TRUE
##     H2O Connection ip:          localhost
##     H2O Connection port:        54321
##     H2O Connection proxy:       NA
##     H2O Internal Security:      FALSE
##     H2O API Extensions:         Algos, AutoML, Core V3, Core V4
##     R Version:                  R version 3.5.1 (2018-07-02)
在未安装 64 位 JDK 的情况下初始化 H2O 可能会报错。如果出现此问题,请安装最新的 64 位 JDK,之后即可正常使用。
如果您使用 Python,方法相同:在命令行运行 pip install -U h2o,即可在 Python 环境中安装 h2o。初始化 h2o 的流程也相同。
h2o.init() 命令相当智能,会完成大量工作。它会先查找是否已有活动的 h2o 实例;若无,再启动一个新实例。
该命令也提供参数用于为 h2o 实例分配资源,常用的有:
nthreads:默认值为 -1,表示实例可使用 CPU 的全部核心。您也可以通过传入数值来限制可用核心数。
max_mem_size:用于限制分配给实例的最大内存。其类型为字符串,例如传入“2g”或“2G”代表 2 GB 内存;若以 MB 为单位,写法同理。
实例创建后,您可以在浏览器中输入 http://localhost:54321 访问 Flow。Flow 是 h2o 自带的 Web 界面,无需额外安装,使用 CoffeeScript(类 JavaScript 语言)编写。您可以用它来:
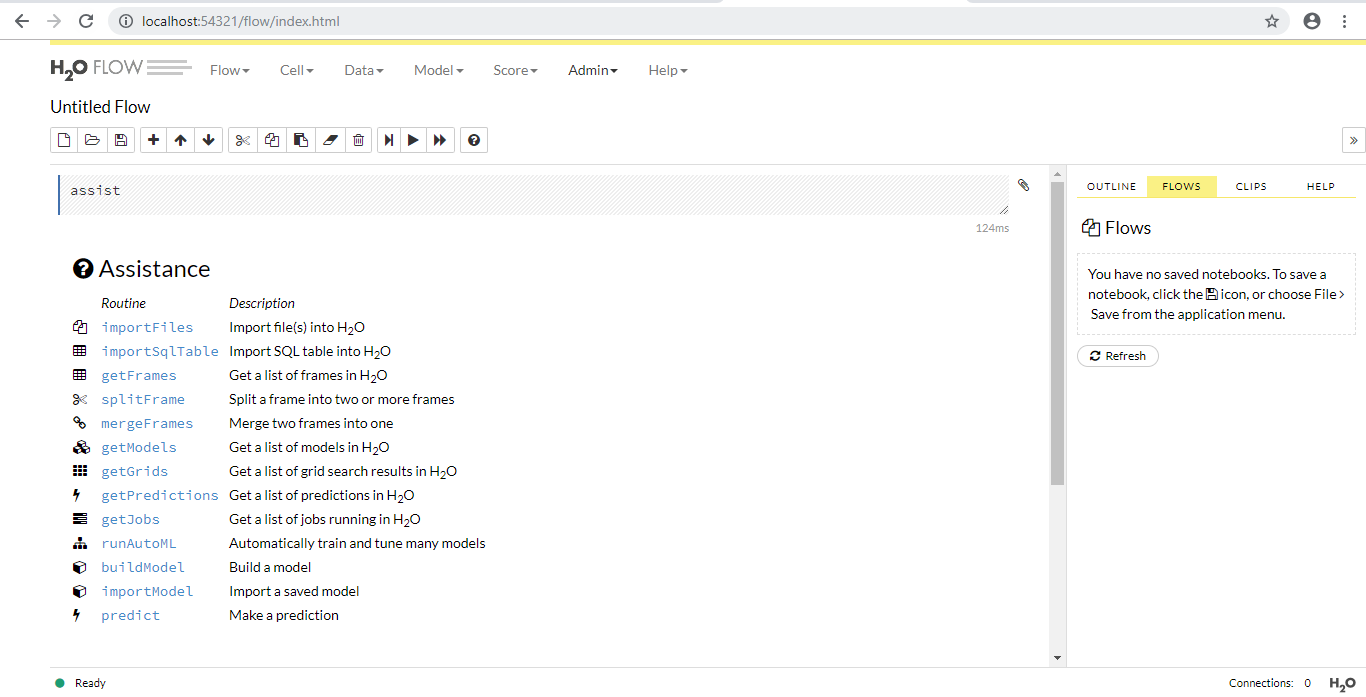
该界面十分实用,也便于非专家上手。建议您亲自尝试并做一些实验。
谈到 H2O 的 AutoML,它可在用户设定的时间限制内自动训练并调优多种模型。
当前版本的 AutoML 函数可以训练并交叉验证随机森林、极端随机森林、GBM 的随机网格、深度神经网络的随机网格,并最终使用所有模型训练一个堆叠集成(Stacked Ensemble)。
所谓 AutoML,应当涵盖数据准备、模型生成与集成等环节,并尽可能提供少量参数,以便用户少走弯路。H2O AutoML 正是以较少的用户参数,轻松完成这些任务。
在 R 和 Python API 中,数据相关参数相同:x、y、training_frame、validation frame,其中 y 和 training_frame 为必填,其余为可选。您还可以配置 max_runtime_sec 和 max_models;其中 max_runtime_sec 为必填,max_model 为可选,若不传则默认为 NULL。
x 参数是来自 training_frame 的预测变量向量;如果您不想使用传入数据帧中的全部预测变量,可以通过设置 x 来指定。
下面介绍一些可选与杂项参数。即使您暂不熟悉,也可以尝试调整,这将有助于理解一些进阶主题:
validation_frame:用于对 AutoML 中各个模型进行早停。它是您传入用于模型验证的数据框;若未传,则可由训练数据划分得到。
leaderboard_frame:若传入,模型将根据该数据上的得分进行排序,而非使用交叉验证指标。若未传入,同样可由训练数据划分得到。
nfolds:K 折交叉验证,默认 5;调整可能影响模型表现。
fold_columns:指定用于交叉验证的折列索引。
weights_column:为特定列指定权重;将权重设为 0 意味着排除该列。
ignored_columns:仅在 Python 中可用,其作用与 x 相反。
stopping_metric:指定用于对网格搜索与模型进行早停的指标;分类默认 logloss,回归默认 deviance。
sort_metric:用于在最终对排行榜模型进行排序的指标;二分类默认 AUC,多分类默认 mean_per_class_error,回归默认 deviance。
validation_frame 与 leaderboard_frame 的行为取决于交叉验证参数 nfolds。
以下两种情形下会出现不同的数据划分方案:
使用交叉验证的 AutoML 情况下:* 仅传入训练集(training frame)—— 数据将按 80/20 划分为训练集与验证集。* 传入训练集与排行榜集(leaderboard frame)—— 训练与验证的 80/20 划分方式不变。* 传入训练集与验证集(validation frame)—— 不再额外划分。* 同时传入三者—— 不再划分。
不使用交叉验证(对排行榜集影响较大,nfolds = 0)时:* 仅传入训练集—— 数据将按 80/10/10 划分为训练、验证与排行榜。* 传入训练集与排行榜集—— 数据将按 80/20 划分为训练与验证。* 传入训练集与验证集—— validation_frame 将再按 50/50 划分为验证与排行榜。* 同时传入三者—— 不再划分。
H2O 将数据导入为 Frame,这与我们在 R 和 Python 中用于各类操作的 data frame 不同。
train <- h2o.importFile("train.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
test <- h2o.importFile("test.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
设置自变量与因变量。
y <- "response"
x <- setdiff(names(train), y)
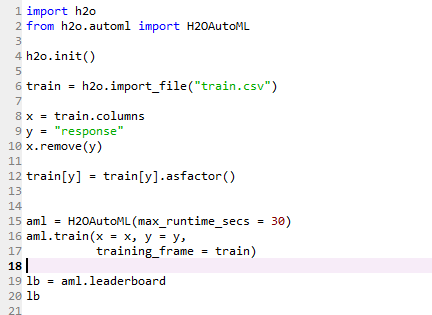
仅传入必需参数创建 automl 对象。这里我们只传入训练集,nfolds 使用默认值。您可根据需要延长模型的运行时间。
train[,y] <- as.factor(train[,y])

aml <- h2o.automl(x = x, y = y,
                  training_frame = train,
                  max_runtime_secs = 30)
##
  |
  |                                                                 |   0%
  |
  |=                                                                |   1%
  |
  |=                                                                |   2%
  |
  |==                                                               |   3%
  |
  |===                                                              |   4%
  |
  |===                                                              |   5%
  |
  |====                                                             |   6%
  |
  |=====                                                            |   8%
  |
  |======                                                           |   9%
  |
  |======                                                           |  10%
  |
  |========                                                         |  13%
  |
  |==========                                                       |  15%
  |
  |==========                                                       |  16%
  |
  |===========                                                      |  16%
  |
  |===========                                                      |  17%
  |
  |===========                                                      |  18%
  |
  |============                                                     |  18%
  |
  |==============================================================   |  95%
  |
  |=================================================================| 100%
查看不同模型的排行榜。
lb <- aml@leaderboard
lb
##                                                model_id       auc
## 1    StackedEnsemble_AllModels_0_AutoML_20181008_110411 0.7823564
## 2 StackedEnsemble_BestOfFamily_0_AutoML_20181008_110411 0.7789898
## 3             GBM_grid_0_AutoML_20181008_110411_model_0 0.7738653
## 4             GBM_grid_0_AutoML_20181008_110411_model_1 0.7720842
## 5             GBM_grid_0_AutoML_20181008_110411_model_2 0.7713380
## 6                          DRF_0_AutoML_20181008_110411 0.7456390
##     logloss mean_per_class_error      rmse       mse
## 1 0.5596939            0.3197364 0.4359927 0.1900896
## 2 0.5628477            0.3112125 0.4374262 0.1913417
## 3 0.5662489            0.3164375 0.4393990 0.1930715
## 4 0.5679111            0.3192612 0.4402417 0.1938127
## 5 0.5679935            0.3297330 0.4405557 0.1940894
## 6 0.5985811            0.3611326 0.4520878 0.2043834
##
## [8 rows x 6 columns]
如果您想在 Python 中进一步学习,欢迎观看 DataCamp 的“使用 Dask 的并行计算”课程。
进一步了解机器学习
课程
课程
实践并学习路径你的进步。
使用 Google 继续