
कोर्स
Understanding Machine Learning
2 घंटा
313.2K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंमशीन लर्निंग एल्गोरिद्म के लिए आजकल काफी चर्चा है, और इसके विशेषज्ञों की मांग भी बढ़ रही है। हम सभी जानते हैं कि कौशल की आवश्यकता और उपलब्धता के बीच एक बड़ा अंतर है। H2O का उद्देश्य एक ऐसा प्लेटफ़ॉर्म उपलब्ध कराना है जो गैर-विशेषज्ञों के लिए भी मशीन लर्निंग पर प्रयोग करना आसान बना दे।
H2O की आर्किटेक्चर को अलग-अलग लेयर में बांटा जा सकता है, जहाँ सबसे ऊपर विभिन्न API होते हैं और सबसे नीचे H2O JVM होता है।
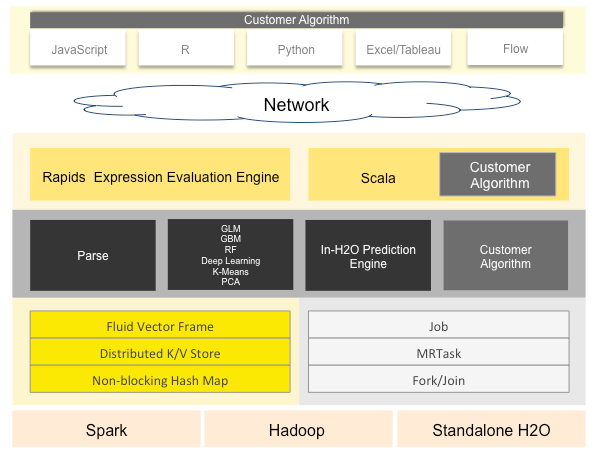
H2O का कोर कोड Java में लिखा गया है जो पूरे फ्रेमवर्क को मल्टी-थ्रेडिंग सक्षम बनाता है। यद्यपि यह Java में लिखा है, यह R, Python और आर्किटेक्चर में दिखाए गए कुछ अन्य इंटरफेस प्रदान करता है, जिससे इसका कुशलतापूर्वक उपयोग संभव होता है।
संक्षेप में, हम कह सकते हैं कि H2O एक ओपन-सोर्स, इन-मेमोरी, डिस्ट्रीब्यूटेड, तेज़ और स्केलेबल मशीन लर्निंग और प्रेडिक्टिव एनालिटिक्स प्लेटफ़ॉर्म है जो मशीन लर्निंग मॉडल बनाना आसान बनाता है।
यदि आप R में H2O की क्षमताओं का उपयोग करना चाहते हैं, तो आप साधारणत: install.packages("h2o") कमांड से H2O पैकेज इंस्टॉल कर सकते हैं।
library(h2o)
##
## ----------------------------------------------------------------------
##
## Your next step is to start H2O:
##     > h2o.init()
##
## For H2O package documentation, ask for help:
##     > ??h2o
##
## After starting H2O, you can use the Web UI at http://localhost:54321
## For more information visit http://docs.h2o.ai
##
## ----------------------------------------------------------------------

##
## Attaching package: 'h2o'

## The following objects are masked from 'package:stats':
##
##     cor, sd, var

## The following objects are masked from 'package:base':
##
##     %*%, %in%, &&, ||, apply, as.factor, as.numeric, colnames,
##     colnames<-, ifelse, is.character, is.factor, is.numeric, log,
##     log10, log1p, log2, round, signif, trunc
h2o.init()
##  Connection successful!
##
## R is connected to the H2O cluster:
##     H2O cluster uptime:         32 minutes 57 seconds
##     H2O cluster timezone:       Asia/Kolkata
##     H2O data parsing timezone:  UTC
##     H2O cluster version:        3.20.0.2
##     H2O cluster version age:    3 months and 22 days !!!
##     H2O cluster name:           H2O_started_from_R_NSingh1_wou076
##     H2O cluster total nodes:    1
##     H2O cluster total memory:   1.55 GB
##     H2O cluster total cores:    4
##     H2O cluster allowed cores:  4
##     H2O cluster healthy:        TRUE
##     H2O Connection ip:          localhost
##     H2O Connection port:        54321
##     H2O Connection proxy:       NA
##     H2O Internal Security:      FALSE
##     H2O API Extensions:         Algos, AutoML, Core V3, Core V4
##     R Version:                  R version 3.5.1 (2018-07-02)
यदि आपके सिस्टम में 64-बिट JDK नहीं है, तो H2O को इनिशियलाइज़ करते समय त्रुटि आ सकती है। ऐसी स्थिति में नवीनतम 64-बिट JDK इंस्टॉल करें; उसके बाद यह बिना समस्या के काम करेगा।
यदि आप Python का उपयोग कर रहे हैं, तो प्रक्रिया समान है: कमांड लाइन से pip install -U h2o चलाएँ और h2o आपके Python वातावरण में इंस्टॉल हो जाएगा। H2O को इनिशियलाइज़ करने की प्रक्रिया भी यही है।
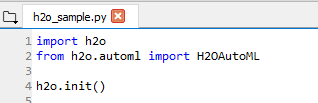
h2o.init() कमांड काफी स्मार्ट है और बहुत-सा काम खुद कर देता है। यह नई इंस्टेंस शुरू करने से पहले पहले से सक्रिय h2o इंस्टेंस ढूँढता है, और यदि कोई इंस्टेंस नहीं मिलता, तो एक नया शुरू करता है।
इसमें ऐसे आर्ग्युमेंट भी हैं जो h2o इंस्टेंस के लिए संसाधन आवंटित करने में मदद करते हैं; अक्सर प्रयुक्त विकल्प हैं:
nthreads: डिफ़ॉल्ट मान -1 होता है, जिसका अर्थ है कि इंस्टेंस CPU के सभी कोर का उपयोग कर सकता है। आप इस आर्ग्युमेंट को मान देकर उपयोग किए जाने वाले कोर की संख्या सीमित कर सकते हैं।
max_mem_size: इस आर्ग्युमेंट में मान देकर आप इंस्टेंस को आवंटित अधिकतम मेमोरी सीमित कर सकते हैं। यह स्ट्रिंग प्रकार का होता है; उदाहरण के लिए 2 GB मेमोरी के लिए ‘2g’ या ‘2G’ पास करें। MB में आवंटित करने पर भी यही प्रारूप है।
इंस्टेंस बन जाने के बाद, आप ब्राउज़र में http://localhost:54321 खोलकर Flow तक पहुँच सकते हैं। Flow h2o का वेब इंटरफ़ेस है, जिसके लिए किसी अतिरिक्त इंस्टॉलेशन की आवश्यकता नहीं होती और यह CoffeeScript (JavaScript जैसी भाषा) में लिखा है। आप इससे निम्न कार्य कर सकते हैं:
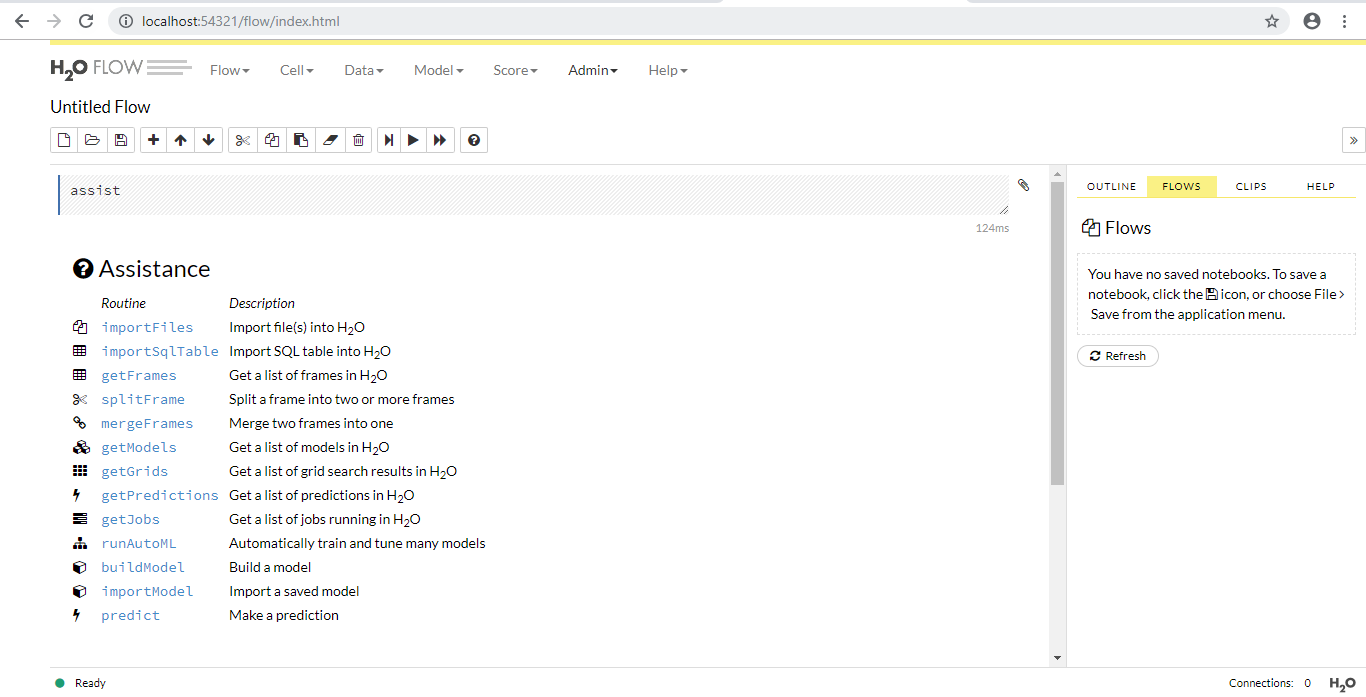
यह इंटरफ़ेस काफी उपयोगी है और गैर-विशेषज्ञों के लिए उपयोग में सरलता लाता है। मैं सुझाव दूँगा कि आप इसे आज़माएँ और अपने कुछ प्रयोग करें।
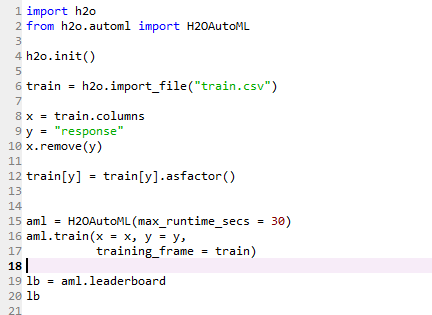
अब H2O के AutoML भाग की बात करें—AutoML उपयोगकर्ता-निर्धारित समय सीमा के भीतर अनेक मॉडलों का स्वचालित प्रशिक्षण और ट्यूनिंग करने में मदद करता है।
AutoML फ़ंक्शन का वर्तमान संस्करण Random Forest, Extremely-Randomized Forest, Gradient Boosting Machines (GBMs) का रैंडम ग्रिड, Deep Neural Nets का रैंडम ग्रिड प्रशिक्षित करता है, और अंत में सभी मॉडलों का उपयोग करके एक Stacked Ensemble ट्रेन करता है।
जब हम AutoML कहते हैं, तो इसे डेटा तैयारी, मॉडल निर्माण और एन्सेंबल के पहलुओं को कवर करना चाहिए और जितना संभव हो उतने कम पैरामीटर प्रदान करने चाहिए, ताकि उपयोगकर्ता कम भ्रम के साथ कार्य कर सकें। H2O AutoML यह कार्य आसानी से और उपयोगकर्ता द्वारा दिए गए न्यूनतम पैरामीटरों के साथ करता है।
R और Python दोनों API में यह समान डेटा-संबंधी आर्ग्युमेंट्स का उपयोग करता है: x, y, training_frame, validation frame; इनमें से y और training_frame अनिवार्य हैं, शेष वैकल्पिक। आप यहाँ max_runtime_sec और max_models के मान भी कॉन्फ़िगर कर सकते हैं; max_runtime_sec अनिवार्य है और max_model वैकल्पिक—यदि आप कोई मान नहीं देते, तो यह डिफ़ॉल्ट रूप से NULL लेता है।
x पैरामीटर training_frame से प्रिडिक्टर्स का वेक्टर है। यदि आप दिए गए फ्रेम के सभी प्रिडिक्टर उपयोग नहीं करना चाहते, तो आप उन्हें x में पास कर सेट कर सकते हैं।
अब कुछ वैकल्पिक और विविध पैरामीटरों की बात करें—चाहे आप उनसे अपरिचित हों, उन्हें बदलकर देखें; इससे आपको उन्नत विषयों पर समझ बढ़ेगी:
validation_frame: यह पैरामीटर AutoML में व्यक्तिगत मॉडलों के लिए अर्ली स्टॉपिंग हेतु प्रयुक्त होता है। यह वह डेटा फ्रेम है जिसे आप मॉडल वैलिडेशन के लिए पास करते हैं; यदि आप पास नहीं करते, तो यह ट्रेनिंग डेटा का हिस्सा होता है।
leaderboard_frame: यदि पास किया जाए, तो मॉडलों का स्कोरिंग क्रॉस-वैलिडेशन मैट्रिक्स के बजाय इन मानों के अनुसार होगा। फिर से, यदि आप पास नहीं करते, तो ये मान ट्रेनिंग डेटा के हिस्से से लिए जाएँगे।
nfolds: K-fold क्रॉस-वैलिडेशन; डिफ़ॉल्ट 5 है, इसे बदलने से मॉडल प्रदर्शन पर प्रभाव पड़ सकता है।
fold_columns: क्रॉस-वैलिडेशन के लिए इंडेक्स निर्दिष्ट करता है।
weights_column: यदि आप विशिष्ट कॉलमों को वेट देना चाहते हैं, तो यह पैरामीटर उपयोग करें; वेट 0 देने का अर्थ है उस कॉलम को बाहर करना।
ignored_columns: केवल Python में; यह x का विलोम है।
stopping_metric: ग्रिड सर्च और मॉडलों की अर्ली स्टॉपिंग के लिए मैट्रिक निर्दिष्ट करता है; वर्गीकरण के लिए डिफ़ॉल्ट logloss और रिग्रेशन के लिए deviance है।
sort_metric: अंत में लीडरबोर्ड मॉडलों को सॉर्ट करने का पैरामीटर। बाइनरी क्लासिफिकेशन के लिए डिफ़ॉल्ट AUC, मल्टीनोमियल क्लासिफिकेशन के लिए mean_per_class_error, और रिग्रेशन के लिए deviance है।
validation_frame और leaderboard_frame का व्यवहार क्रॉस-वैलिडेशन पैरामीटर nfolds पर निर्भर करता है।
निम्न परिदृश्य दो स्थितियों में उत्पन्न हो सकते हैं:
जब हम AutoML में क्रॉस-वैलिडेशन का उपयोग कर रहे हों: * केवल training frame पास किया गया है - तब डेटा 80-20 में training और validation फ्रेम में विभाजित होगा। * training और leaderboard frame पास किए गए हैं - training और validation फ्रेम में डेटा के 80-20 विभाजन में कोई बदलाव नहीं। * जब training और validation frame पास किए गए हैं - कोई विभाजन नहीं। * जब तीनों फ्रेम पास किए गए हैं - कोई विभाजन नहीं।
जब हम क्रॉस-वैलिडेशन का उपयोग नहीं कर रहे हों (nfolds = 0), जिससे leaderboard frame पर काफ़ी प्रभाव पड़ेगा: * केवल training frame पास किया गया है - डेटा 80/10/10 में training, validation और leaderboard में विभाजित होगा। * training और leaderboard frame पास किए गए हैं - डेटा 80-20 में training और validation फ्रेम में विभाजित होगा। * जब training और validation frame पास किए गए हैं - validation_frame डेटा 50-50 में validation और leaderboard में विभाजित होगा। * जब तीनों फ्रेम पास किए गए हैं - कोई विभाजन नहीं।
H2O डेटा को Frame के रूप में इंपोर्ट करता है, जो R और Python में अलग-अलग कार्यों के लिए उपयोग होने वाले data frame से भिन्न होता है।
train <- h2o.importFile("train.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
test <- h2o.importFile("test.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
प्रिडिक्टर्स और रिस्पॉन्स सेट करना।
y <- "response"
x <- setdiff(names(train), y)
अनिवार्य पैरामीटर पास करके एक AutoML ऑब्जेक्ट बनाएँ। हम केवल training frame पास कर रहे हैं, और nfolds पैरामीटर अपना डिफ़ॉल्ट मान लेता है। आप आवश्यकता अनुसार मॉडल का रनटाइम बढ़ा सकते हैं।
train[,y] <- as.factor(train[,y])

aml <- h2o.automl(x = x, y = y,
                  training_frame = train,
                  max_runtime_secs = 30)
##
  |
  |                                                                 |   0%
  |
  |=                                                                |   1%
  |
  |=                                                                |   2%
  |
  |==                                                               |   3%
  |
  |===                                                              |   4%
  |
  |===                                                              |   5%
  |
  |====                                                             |   6%
  |
  |=====                                                            |   8%
  |
  |======                                                           |   9%
  |
  |======                                                           |  10%
  |
  |========                                                         |  13%
  |
  |==========                                                       |  15%
  |
  |==========                                                       |  16%
  |
  |===========                                                      |  16%
  |
  |===========                                                      |  17%
  |
  |===========                                                      |  18%
  |
  |============                                                     |  18%
  |
  |==============================================================   |  95%
  |
  |=================================================================| 100%
विभिन्न मॉडलों के लीडरबोर्ड को देखना।
lb <- aml@leaderboard
lb
##                                                model_id       auc
## 1    StackedEnsemble_AllModels_0_AutoML_20181008_110411 0.7823564
## 2 StackedEnsemble_BestOfFamily_0_AutoML_20181008_110411 0.7789898
## 3             GBM_grid_0_AutoML_20181008_110411_model_0 0.7738653
## 4             GBM_grid_0_AutoML_20181008_110411_model_1 0.7720842
## 5             GBM_grid_0_AutoML_20181008_110411_model_2 0.7713380
## 6                          DRF_0_AutoML_20181008_110411 0.7456390
##     logloss mean_per_class_error      rmse       mse
## 1 0.5596939            0.3197364 0.4359927 0.1900896
## 2 0.5628477            0.3112125 0.4374262 0.1913417
## 3 0.5662489            0.3164375 0.4393990 0.1930715
## 4 0.5679111            0.3192612 0.4402417 0.1938127
## 5 0.5679935            0.3297330 0.4405557 0.1940894
## 6 0.5985811            0.3611326 0.4520878 0.2043834
##
## [8 rows x 6 columns]
यदि आप Python में और सीखना चाहते हैं, तो DataCamp का Parallel Computing with Dask कोर्स लें।
मशीन लर्निंग के बारे में और जानें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें