Kurs
Machine Learning verstehen
2 Std.
308K
Rund um Machine-Learning-Algorithmen gibt es viel Hype – und eine große Nachfrage nach Expertinnen und Experten. Wir wissen alle, dass es eine deutliche Lücke bei den geforderten Kompetenzen gibt. Das Ziel von H2O ist es, eine Plattform bereitzustellen, mit der auch Nicht-Profis einfach mit Machine Learning experimentieren können.
Die H2O-Architektur lässt sich in verschiedene Schichten gliedern: Oben liegen die unterschiedlichen APIs, unten die H2O-JVM.
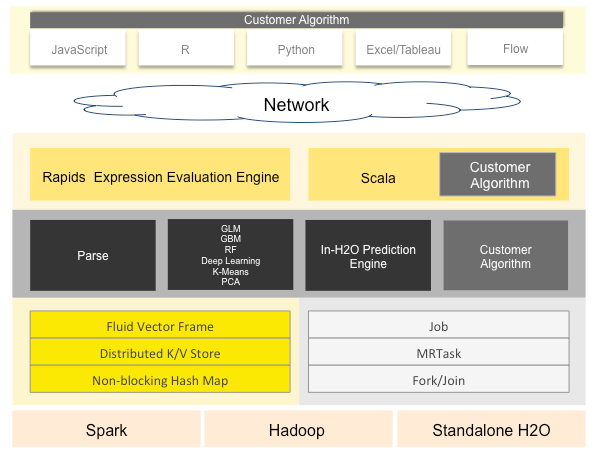
Der Kerncode von H2O ist in Java geschrieben und ermöglicht damit durchgängiges Multithreading. Obwohl H2O in Java entwickelt wurde, stellt es Schnittstellen für R, Python und einige weitere Sprachen bereit, wie in der Architektur dargestellt – so lässt es sich effizient einsetzen.
Kurz gesagt: H2O ist eine Open-Source-, In-Memory-, verteilte, schnelle und skalierbare Machine-Learning- und Predictive-Analytics-Plattform, mit der sich ML-Modelle sehr einfach erstellen lassen.
Wenn du H2O in R nutzen möchtest, kannst du das Paket H2O einfach mit dem Befehl install.packages("h2o") installieren.
library(h2o)
##
## ----------------------------------------------------------------------
##
## Your next step is to start H2O:
##     > h2o.init()
##
## For H2O package documentation, ask for help:
##     > ??h2o
##
## After starting H2O, you can use the Web UI at http://localhost:54321
## For more information visit http://docs.h2o.ai
##
## ----------------------------------------------------------------------

##
## Attaching package: 'h2o'

## The following objects are masked from 'package:stats':
##
##     cor, sd, var

## The following objects are masked from 'package:base':
##
##     %*%, %in%, &&, ||, apply, as.factor, as.numeric, colnames,
##     colnames<-, ifelse, is.character, is.factor, is.numeric, log,
##     log10, log1p, log2, round, signif, trunc
h2o.init()
##  Connection successful!
##
## R is connected to the H2O cluster:
##     H2O cluster uptime:         32 minutes 57 seconds
##     H2O cluster timezone:       Asia/Kolkata
##     H2O data parsing timezone:  UTC
##     H2O cluster version:        3.20.0.2
##     H2O cluster version age:    3 months and 22 days !!!
##     H2O cluster name:           H2O_started_from_R_NSingh1_wou076
##     H2O cluster total nodes:    1
##     H2O cluster total memory:   1.55 GB
##     H2O cluster total cores:    4
##     H2O cluster allowed cores:  4
##     H2O cluster healthy:        TRUE
##     H2O Connection ip:          localhost
##     H2O Connection port:        54321
##     H2O Connection proxy:       NA
##     H2O Internal Security:      FALSE
##     H2O API Extensions:         Algos, AutoML, Core V3, Core V4
##     R Version:                  R version 3.5.1 (2018-07-02)
Beim Initialisieren von H2O kann es zu einem Fehler kommen, wenn kein 64-Bit-JDK vorhanden ist. Installiere in diesem Fall ein aktuelles 64-Bit-JDK, danach funktioniert es problemlos.
Wenn du Python nutzt, ist der Ablauf ähnlich: Über die Kommandozeile pip install -U h2o ausführen, dann ist h2o für deine Python-Umgebung installiert. Die Initialisierung von h2o erfolgt genauso.
Der Befehl h2o.init() ist ziemlich smart und übernimmt viel Arbeit. Er sucht zuerst nach einer aktiven h2o-Instanz und startet nur dann eine neue, wenn keine vorhanden ist.
Es gibt Argumente, mit denen du Ressourcen für die h2o-Instanz festlegen kannst. Häufig genutzt sind:
nthreads: Standardmäßig ist nthreads -1, also darf die Instanz alle CPU-Kerne nutzen. Du kannst die Anzahl der genutzten Kerne explizit setzen.
max_mem_size: Damit begrenzt du den maximalen Speicher für die Instanz. Als String, z. B. ‘2g’ oder ‘2G’ für 2 GB, entsprechend auch für MB.
Sobald die Instanz läuft, erreichst du Flow im Browser über http://localhost:54321. Flow ist die Weboberfläche von h2o und erfordert keine zusätzliche Installation. Sie ist in CoffeeScript (einer JavaScript-ähnlichen Sprache) geschrieben. Du kannst damit Folgendes tun:
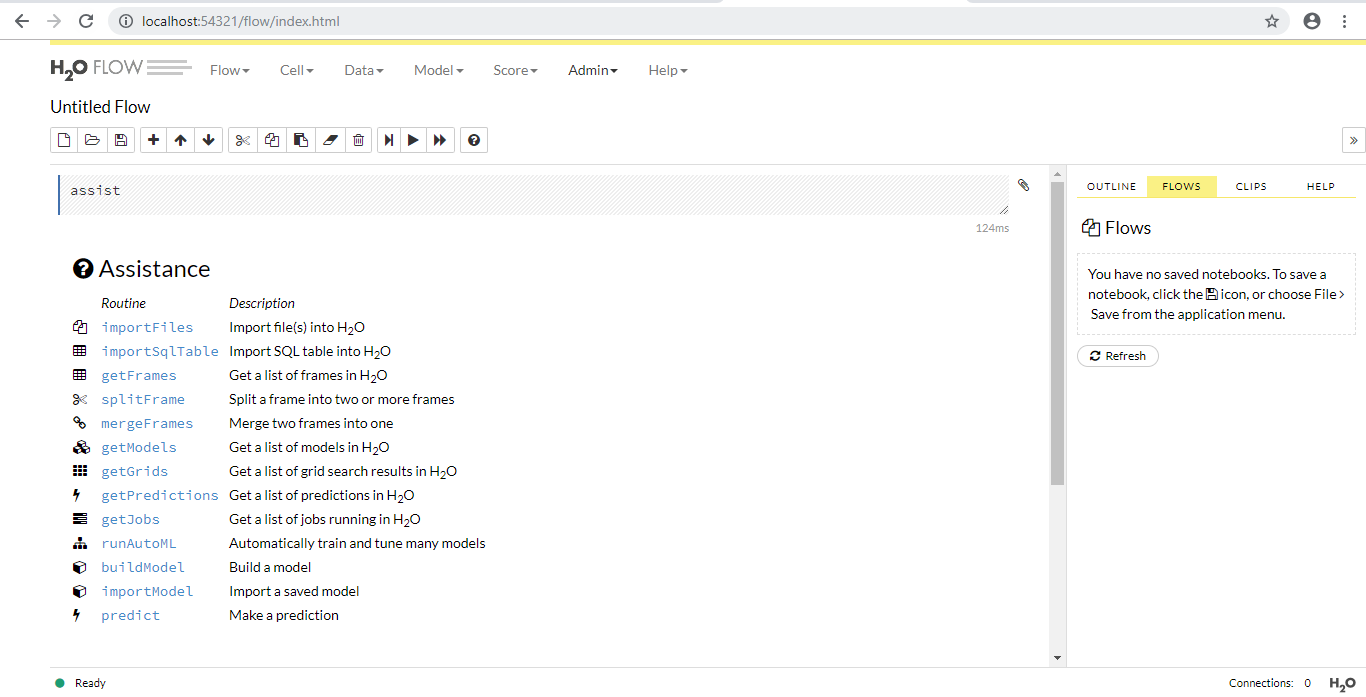
Die Oberfläche ist sehr hilfreich und macht die Nutzung für Nicht-Profis angenehm einfach. Probier sie aus und experimentiere ein wenig.
Kommen wir zum AutoML-Teil von H2O: AutoML unterstützt dich dabei, innerhalb eines festgelegten Zeitlimits automatisch viele Modelle zu trainieren und zu tunen.
Die aktuelle AutoML-Version kann einen Random Forest, einen Extremely Randomized Forest, ein zufälliges Grid aus Gradient Boosting Machines (GBMs), ein zufälliges Grid aus Deep Neural Nets trainieren und anschließend ein Stacked Ensemble aus allen Modellen erstellen und validieren.
AutoML sollte Aspekte wie Datenvorbereitung, Modellerzeugung und Ensembles abdecken und dabei möglichst wenige Parameter verlangen, damit Nutzerinnen und Nutzer ohne viel Verwirrung arbeiten können. H2O AutoML erfüllt genau das – mit minimalem Parameteraufwand.
In R- und Python-API werden die gleichen datenbezogenen Argumente verwendet: x, y, training_frame, validation frame. Davon sind y und training_frame Pflicht, der Rest ist optional. Außerdem kannst du max_runtime_sec und max_models setzen. Hier ist max_runtime_sec erforderlich, max_models optional. Ohne Angabe ist der Standard NULL.
Das Argument x ist der Prädiktor-Vektor aus dem training_frame. Wenn du nicht alle Prädiktoren aus dem übergebenen Frame verwenden möchtest, gib die gewünschten Spalten in x an.
Schauen wir auf einige optionale und weiterführende Parameter. Spiel ruhig damit, auch wenn du sie noch nicht im Detail kennst – so lernst du fortgeschrittene Konzepte kennen:
validation_frame: Dient zum Early Stopping einzelner Modelle im AutoML. Es ist ein Dataframe, den du zur Validierung übergibst, oder – wenn nicht vorhanden – ein Teil der Trainingsdaten.
leaderboard_frame: Falls gesetzt, werden Modelle anhand dieser Werte bewertet, statt Cross-Validation-Metriken zu nutzen. Ohne Angabe stammen die Werte aus den Trainingsdaten.
nfolds: K-fache Cross-Validation, standardmäßig 5. Eine zu geringe Wahl kann die Modellleistung beeinträchtigen.
fold_columns: Legt die Indizes für die Cross-Validation fest.
weights_column: Weist bestimmten Spalten Gewichte zu. Gewicht 0 bedeutet Ausschluss der Spalte.
ignored_columns: Nur in Python, das Gegenstück zu x.
stopping_metric: Metrik für Early Stopping bei Grid-Searches und Modellen. Standard: logloss für Klassifikation, deviance für Regression.
sort_metric: Metrik zum Sortieren des Leaderboards. Standard: AUC bei binärer Klassifikation, mean_per_class_error bei multinomialer Klassifikation, deviance bei Regression.
validation_frame und leaderboard_frame hängen vom Cross-Validation-Parameter nfolds ab.
Es ergeben sich zwei Szenarien:
Wenn Cross-Validation in AutoML verwendet wird: * Nur training_frame übergeben – Die Daten werden im Verhältnis 80/20 in Training und Validierung geteilt. * training und leaderboard_frame übergeben – Die 80/20-Aufteilung in Training und Validierung bleibt unverändert. * training und validation_frame übergeben – Keine weitere Teilung. * Alle drei Frames übergeben – Keine Teilung.
Wenn keine Cross-Validation verwendet wird (nfolds = 0), was das Leaderboard stark beeinflusst: * Nur training_frame übergeben – Aufteilung in 80/10/10 für Training, Validierung und Leaderboard. * training und leaderboard_frame übergeben – Aufteilung 80/20 in Training und Validierung. * training und validation_frame übergeben – validation_frame wird 50/50 in Validierung und Leaderboard geteilt. * Alle drei Frames übergeben – Keine Teilung.
H2O importiert Daten als Frame, der sich vom Data Frame unterscheidet, den wir in R und Python für verschiedene Operationen verwenden.
train <- h2o.importFile("train.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
test <- h2o.importFile("test.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
Prädiktoren und Zielvariable festlegen.
y <- "response"
x <- setdiff(names(train), y)
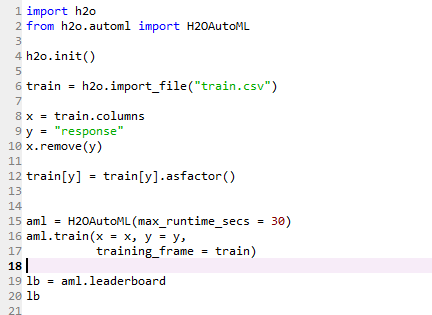
Erstelle ein AutoML-Objekt mit den Pflichtparametern. Wir übergeben nur den Trainingsframe, und nfolds bleibt beim Standardwert. Du kannst die Laufzeit nach Bedarf erhöhen.
train[,y] <- as.factor(train[,y])

aml <- h2o.automl(x = x, y = y,
                  training_frame = train,
                  max_runtime_secs = 30)
##
  |
  |                                                                 |   0%
  |
  |=                                                                |   1%
  |
  |=                                                                |   2%
  |
  |==                                                               |   3%
  |
  |===                                                              |   4%
  |
  |===                                                              |   5%
  |
  |====                                                             |   6%
  |
  |=====                                                            |   8%
  |
  |======                                                           |   9%
  |
  |======                                                           |  10%
  |
  |========                                                         |  13%
  |
  |==========                                                       |  15%
  |
  |==========                                                       |  16%
  |
  |===========                                                      |  16%
  |
  |===========                                                      |  17%
  |
  |===========                                                      |  18%
  |
  |============                                                     |  18%
  |
  |==============================================================   |  95%
  |
  |=================================================================| 100%
Das Leaderboard der Modelle ansehen.
lb <- aml@leaderboard
lb
##                                                model_id       auc
## 1    StackedEnsemble_AllModels_0_AutoML_20181008_110411 0.7823564
## 2 StackedEnsemble_BestOfFamily_0_AutoML_20181008_110411 0.7789898
## 3             GBM_grid_0_AutoML_20181008_110411_model_0 0.7738653
## 4             GBM_grid_0_AutoML_20181008_110411_model_1 0.7720842
## 5             GBM_grid_0_AutoML_20181008_110411_model_2 0.7713380
## 6                          DRF_0_AutoML_20181008_110411 0.7456390
##     logloss mean_per_class_error      rmse       mse
## 1 0.5596939            0.3197364 0.4359927 0.1900896
## 2 0.5628477            0.3112125 0.4374262 0.1913417
## 3 0.5662489            0.3164375 0.4393990 0.1930715
## 4 0.5679111            0.3192612 0.4402417 0.1938127
## 5 0.5679935            0.3297330 0.4405557 0.1940894
## 6 0.5985811            0.3611326 0.4520878 0.2043834
##
## [8 rows x 6 columns]
Wenn du in Python tiefer einsteigen möchtest, schau dir den DataCamp-Kurs Parallel Computing with Dask an.
Mehr über Machine Learning lernen
Kurs
Kurs
Kurs
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
Aditya Sharma
7 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Satyabrata Pal
15 Min.
Tutorial
Mark Pedigo
10 Min.


