Curso
Entendendo Machine Learning
2 h
308.6K
Há muito burburinho sobre algoritmos de machine learning e uma demanda crescente por especialistas na área. Todos sabemos que existe uma lacuna significativa de competências. O objetivo do H2O é oferecer uma plataforma que facilite para não especialistas experimentarem com machine learning.
A arquitetura do H2O pode ser dividida em camadas: na camada superior ficam as diferentes APIs e, na inferior, a H2O JVM.
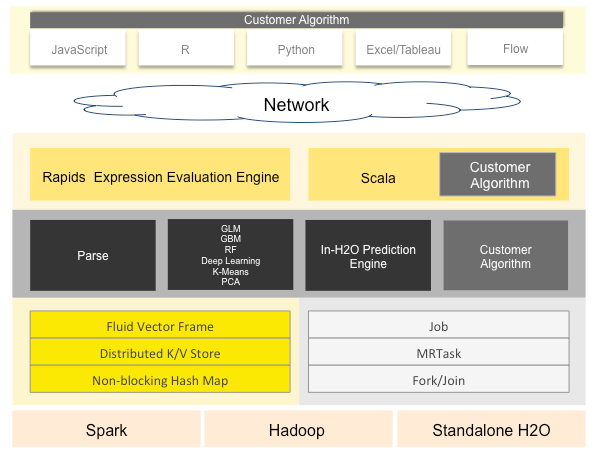
O núcleo do H2O é escrito em Java, o que habilita todo o framework para multithreading. Embora seja escrito em Java, ele oferece interfaces para R, Python e outros (como na arquitetura), permitindo um uso eficiente.
Em resumo, podemos dizer que o H2O é open source, em memória, distribuído, rápido e escalável para machine learning e análise preditiva, tornando a criação de modelos de machine learning muito mais simples.
Se quiser usar os recursos do H2O no R, basta instalar o pacote H2O com o comando install.packages("h2o").
library(h2o)
##
## ----------------------------------------------------------------------
##
## Your next step is to start H2O:
##     > h2o.init()
##
## For H2O package documentation, ask for help:
##     > ??h2o
##
## After starting H2O, you can use the Web UI at http://localhost:54321
## For more information visit http://docs.h2o.ai
##
## ----------------------------------------------------------------------

##
## Attaching package: 'h2o'

## The following objects are masked from 'package:stats':
##
##     cor, sd, var

## The following objects are masked from 'package:base':
##
##     %*%, %in%, &&, ||, apply, as.factor, as.numeric, colnames,
##     colnames<-, ifelse, is.character, is.factor, is.numeric, log,
##     log10, log1p, log2, round, signif, trunc
h2o.init()
##  Connection successful!
##
## R is connected to the H2O cluster:
##     H2O cluster uptime:         32 minutes 57 seconds
##     H2O cluster timezone:       Asia/Kolkata
##     H2O data parsing timezone:  UTC
##     H2O cluster version:        3.20.0.2
##     H2O cluster version age:    3 months and 22 days !!!
##     H2O cluster name:           H2O_started_from_R_NSingh1_wou076
##     H2O cluster total nodes:    1
##     H2O cluster total memory:   1.55 GB
##     H2O cluster total cores:    4
##     H2O cluster allowed cores:  4
##     H2O cluster healthy:        TRUE
##     H2O Connection ip:          localhost
##     H2O Connection port:        54321
##     H2O Connection proxy:       NA
##     H2O Internal Security:      FALSE
##     H2O API Extensions:         Algos, AutoML, Core V3, Core V4
##     R Version:                  R version 3.5.1 (2018-07-02)
Ao inicializar o H2O, pode ocorrer um erro caso você não tenha o JDK de 64 bits. Se isso acontecer, instale a versão mais recente do JDK 64 bits e tudo deve funcionar normalmente depois.
Se você usa Python, o processo é semelhante: no terminal, rode pip install -U h2o e o h2o será instalado no seu ambiente Python. A inicialização do h2o segue o mesmo fluxo.
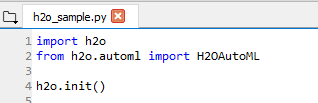
O comando h2o.init() é bem esperto e faz bastante coisa. Primeiro, ele procura por uma instância ativa do h2o antes de iniciar uma nova; se não houver nenhuma, ele cria uma nova.
Ele também possui argumentos para ajustar os recursos da instância do h2o. Os mais usados são:
nthreads: por padrão, o valor é -1, o que significa que a instância pode usar todos os núcleos da CPU. Você pode limitar a quantidade de núcleos passando um valor para esse argumento.
max_mem_size: ao passar um valor para esse argumento, você restringe a memória máxima alocada para a instância. É do tipo string; por exemplo, passe ‘2g’ ou ‘2G’ para 2 GB de memória (ou em MBs, se preferir).
Depois que a instância é criada, você pode acessar o Flow digitando http://localhost:54321 no navegador. Flow é o nome da interface web que faz parte do h2o, não exige instalações extras e é escrita em CoffeeScript (uma linguagem similar ao JavaScript). Você pode usar para:
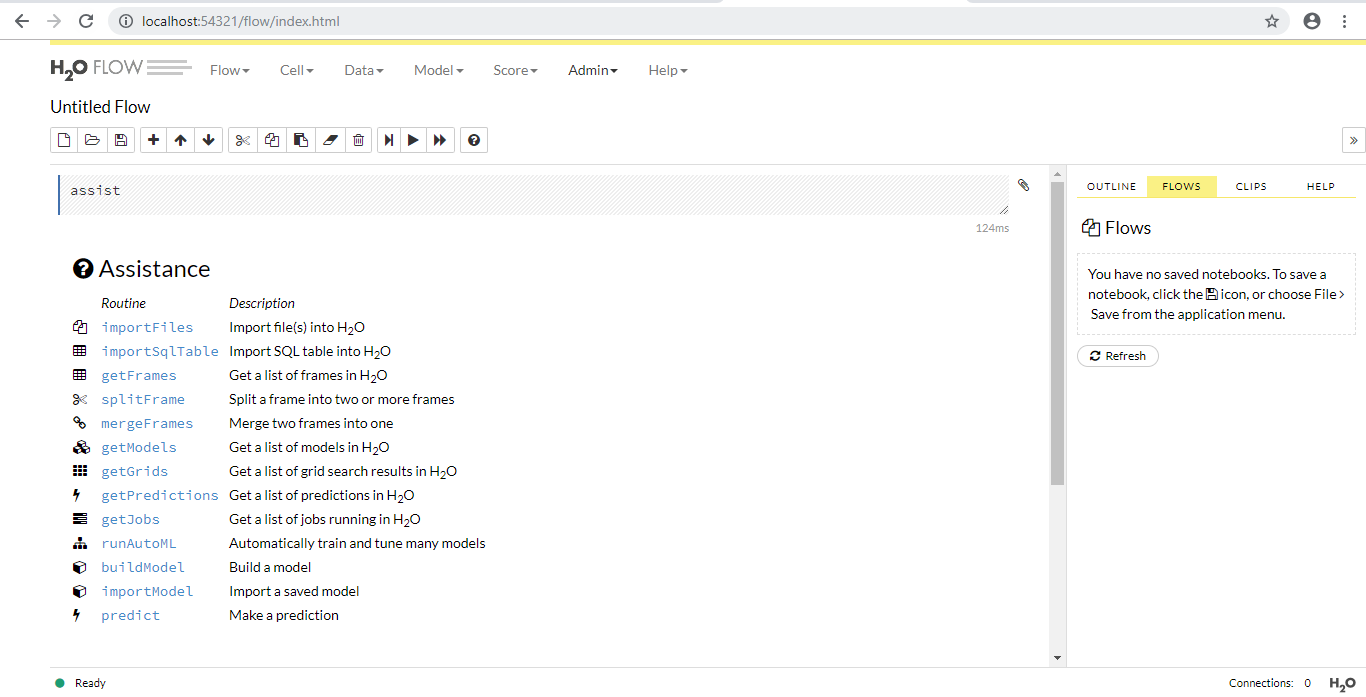
A interface é bem útil e facilita a vida de quem não é especialista. Vale testar e fazer seus próprios experimentos.
Falando agora do AutoML do H2O: o AutoML ajuda a treinar e ajustar automaticamente diversos modelos dentro de um limite de tempo definido pelo usuário.
A versão atual da função AutoML pode treinar e validar via cross-validation um Random Forest, um Extremely Randomized Forest, uma busca aleatória (random grid) de Gradient Boosting Machines (GBMs), uma busca aleatória de Deep Neural Nets e, por fim, treinar um Stacked Ensemble usando todos os modelos.
Quando falamos em AutoML, ele deve cobrir aspectos de preparação de dados, geração de modelos e ensembles, oferecendo o mínimo possível de parâmetros para que o usuário execute as tarefas com menos confusão. O H2O AutoML cumpre bem esse papel com poucos parâmetros fornecidos pelo usuário.
Nas APIs de R e Python, os argumentos de dados são os mesmos: x, y, training_frame, validation frame; desses, y e training_frame são obrigatórios e o restante é opcional. Você também pode configurar max_runtime_sec e max_models: o parâmetro max_runtime_sec é obrigatório e max_model é opcional; se você não passar nada, assume NULL por padrão.
O parâmetro x é o vetor de preditores em training_frame. Se você não quiser usar todos os preditores do frame fornecido, indique apenas os desejados em x.
Agora, vamos falar de alguns parâmetros opcionais e outros diversos. Experimente ajustá-los, mesmo que você ainda não domine todos — isso ajuda a aprender tópicos avançados:
validation_frame: usado para early stopping de modelos individuais no AutoML. É um dataframe que você passa para validação do modelo; se não for passado, pode ser parte dos dados de treino.
leaderboard_frame: se fornecido, os modelos serão pontuados com base nesses dados em vez de usar métricas de cross-validation. Novamente, se não for passado, os valores podem vir dos dados de treino.
nfolds: cross-validation K-fold (padrão 5); pode impactar o desempenho dos modelos.
fold_columns: especifica o índice para cross-validation.
weights_column: caso queira atribuir pesos a colunas específicas; peso 0 significa excluir a coluna.
ignored_columns: apenas em Python; é o inverso de x.
stopping_metric: define a métrica para early stopping em buscas em grade (grids) e modelos; o padrão é logloss para classificação e deviance para regressão.
sort_metric: métrica usada para ordenar os modelos no leaderboard ao final. O padrão é AUC para classificação binária, mean_per_class_error para classificação multiclasse e deviance para regressão.
Os parâmetros validation_frame e leaderboard_frame dependem do parâmetro de cross-validation, nfolds.
Os seguintes cenários podem ocorrer em dois casos:
quando usamos cross-validation no AutoML: * Apenas o training frame é passado - então os dados serão divididos em 80-20 entre treino e validação. * training e leaderboard frame são passados - mantém-se a divisão 80-20 entre treino e validação. * Quando training e validation frame são passados - não há divisão. * quando os três frames são passados - não há divisões.
Quando não usamos cross-validation, o que impacta bastante o leaderboard frame (nfolds = 0): * Apenas o training frame é passado - os dados são divididos em 80/10/10 entre treino, validação e leaderboard. * training e leaderboard frame são passados - divisão 80-20 entre treino e validação. * Quando training e validation frame são passados - o validation_frame é dividido em 50-50 entre validação e leaderboard. * quando os três frames são passados - não há divisões.
O H2O importa dados como Frame, que é diferente do data frame que usamos no R e no Python para várias manipulações.
train <- h2o.importFile("train.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
test <- h2o.importFile("test.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
Definindo os preditores e a variável resposta.
y <- "response"
x <- setdiff(names(train), y)
Crie um objeto automl passando os parâmetros obrigatórios. Aqui estamos passando apenas o training frame, e o parâmetro nfolds fica com o valor padrão. Você pode aumentar o tempo de execução conforme a sua necessidade.
train[,y] <- as.factor(train[,y])

aml <- h2o.automl(x = x, y = y,
                  training_frame = train,
                  max_runtime_secs = 30)
##
  |
  |                                                                 |   0%
  |
  |=                                                                |   1%
  |
  |=                                                                |   2%
  |
  |==                                                               |   3%
  |
  |===                                                              |   4%
  |
  |===                                                              |   5%
  |
  |====                                                             |   6%
  |
  |=====                                                            |   8%
  |
  |======                                                           |   9%
  |
  |======                                                           |  10%
  |
  |========                                                         |  13%
  |
  |==========                                                       |  15%
  |
  |==========                                                       |  16%
  |
  |===========                                                      |  16%
  |
  |===========                                                      |  17%
  |
  |===========                                                      |  18%
  |
  |============                                                     |  18%
  |
  |==============================================================   |  95%
  |
  |=================================================================| 100%
Visualizando o leaderboard dos diferentes modelos.
lb <- aml@leaderboard
lb
##                                                model_id       auc
## 1    StackedEnsemble_AllModels_0_AutoML_20181008_110411 0.7823564
## 2 StackedEnsemble_BestOfFamily_0_AutoML_20181008_110411 0.7789898
## 3             GBM_grid_0_AutoML_20181008_110411_model_0 0.7738653
## 4             GBM_grid_0_AutoML_20181008_110411_model_1 0.7720842
## 5             GBM_grid_0_AutoML_20181008_110411_model_2 0.7713380
## 6                          DRF_0_AutoML_20181008_110411 0.7456390
##     logloss mean_per_class_error      rmse       mse
## 1 0.5596939            0.3197364 0.4359927 0.1900896
## 2 0.5628477            0.3112125 0.4374262 0.1913417
## 3 0.5662489            0.3164375 0.4393990 0.1930715
## 4 0.5679111            0.3192612 0.4402417 0.1938127
## 5 0.5679935            0.3297330 0.4405557 0.1940894
## 6 0.5985811            0.3611326 0.4520878 0.2043834
##
## [8 rows x 6 columns]
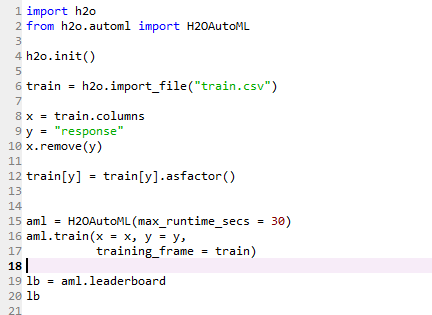
Se quiser se aprofundar em Python, faça o curso Parallel Computing with Dask da DataCamp.
Saiba mais sobre machine learning
Curso
Curso
Curso
Tutorial
Abid Ali Awan
11 min
Tutorial
Javier Canales Luna
7 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Kevin Babitz
8 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Arunn Thevapalan
15 min