Cours
Comprendre le Machine Learning
2 h
308.2K
Les algorithmes d’apprentissage automatique suscitent un vif intérêt, tout comme la demande d’experts dans ce domaine. Nous savons tous qu’il existe un écart important entre les besoins et les compétences disponibles. L’objectif de H2O est d’offrir une plateforme qui facilite les expérimentations en apprentissage automatique pour les non-spécialistes.
L’architecture de H2O se décompose en différentes couches : les API en couche supérieure et la JVM H2O en couche inférieure.
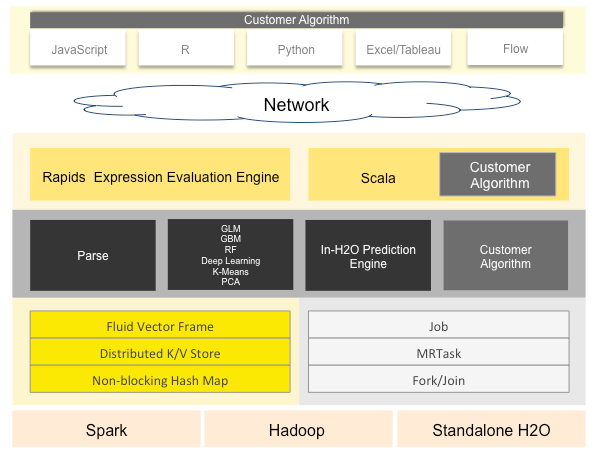
Le cœur de H2O est écrit en Java, ce qui permet le multithreading sur l’ensemble du framework. Bien qu’écrit en Java, il propose des interfaces pour R, Python et d’autres langages présentés dans l’architecture, ce qui le rend très efficace à l’usage.
En bref, H2O est une solution open source, en mémoire, distribuée, rapide et évolutive pour l’apprentissage automatique et l’analytique prédictive, qui simplifie la création de modèles de machine learning.
Pour utiliser H2O dans R, installez simplement le package H2O avec la commande install.packages("h2o").
library(h2o)
##
## ----------------------------------------------------------------------
##
## Your next step is to start H2O:
##     > h2o.init()
##
## For H2O package documentation, ask for help:
##     > ??h2o
##
## After starting H2O, you can use the Web UI at http://localhost:54321
## For more information visit http://docs.h2o.ai
##
## ----------------------------------------------------------------------

##
## Attaching package: 'h2o'

## The following objects are masked from 'package:stats':
##
##     cor, sd, var

## The following objects are masked from 'package:base':
##
##     %*%, %in%, &&, ||, apply, as.factor, as.numeric, colnames,
##     colnames<-, ifelse, is.character, is.factor, is.numeric, log,
##     log10, log1p, log2, round, signif, trunc
h2o.init()
##  Connection successful!
##
## R is connected to the H2O cluster:
##     H2O cluster uptime:         32 minutes 57 seconds
##     H2O cluster timezone:       Asia/Kolkata
##     H2O data parsing timezone:  UTC
##     H2O cluster version:        3.20.0.2
##     H2O cluster version age:    3 months and 22 days !!!
##     H2O cluster name:           H2O_started_from_R_NSingh1_wou076
##     H2O cluster total nodes:    1
##     H2O cluster total memory:   1.55 GB
##     H2O cluster total cores:    4
##     H2O cluster allowed cores:  4
##     H2O cluster healthy:        TRUE
##     H2O Connection ip:          localhost
##     H2O Connection port:        54321
##     H2O Connection proxy:       NA
##     H2O Internal Security:      FALSE
##     H2O API Extensions:         Algos, AutoML, Core V3, Core V4
##     R Version:                  R version 3.5.1 (2018-07-02)
L’initialisation de H2O peut générer une erreur si votre système n’a pas de JDK 64 bits. Si cela se produit, installez la dernière version 64 bits du JDK : tout fonctionnera ensuite correctement.
Si vous utilisez Python, procédez de la même manière depuis la ligne de commande : pip install -U h2o. H2O sera installé dans votre environnement Python. L’initialisation de H2O suit le même processus.
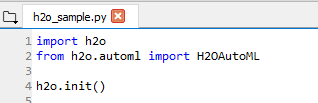
La commande h2o.init() est maline et fait beaucoup de choses : elle commence par rechercher une instance H2O active avant d’en démarrer une nouvelle, et ne lance un nouveau processus qu’en l’absence d’instance.
Elle propose des arguments pour ajuster les ressources de l’instance H2O. Les plus utilisés :
nthreads : par défaut, sa valeur est -1, ce qui signifie que l’instance peut utiliser tous les cœurs CPU. Vous pouvez limiter le nombre de cœurs utilisés en passant une valeur explicite.
max_mem_size : en passant une valeur à cet argument, vous limitez la mémoire maximale allouée à l’instance. C’est une chaîne de caractères : par exemple ‘2g’ ou ‘2G’ pour 2 Go de mémoire, et de même pour des valeurs en Mo.
Une fois l’instance créée, accédez à Flow en saisissant http://localhost:54321 dans votre navigateur. Flow est l’interface web intégrée à H2O, écrite en CoffeeScript (un langage proche de JavaScript), qui ne nécessite aucune installation supplémentaire. Vous pouvez l’utiliser pour :
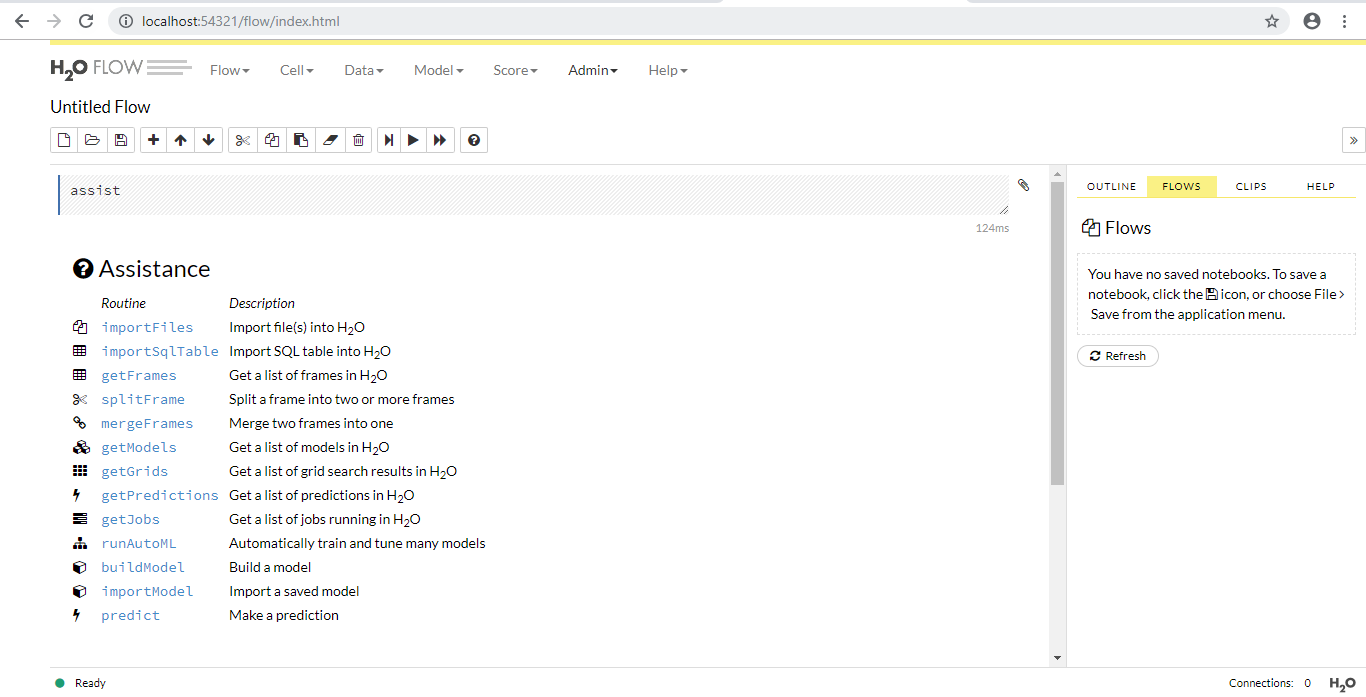
L’interface est très pratique et facilite la prise en main pour les non-spécialistes. Nous vous recommandons de l’essayer et de mener vos propres expériences.
Passons maintenant à la partie AutoML de H2O : AutoML permet d’entraîner et d’ajuster automatiquement de nombreux modèles dans une limite de temps définie par l’utilisateur.
La version actuelle d’AutoML peut entraîner et valider en croisé une Random Forest, une Extremely Randomized Forest, une grille aléatoire de Gradient Boosting Machines (GBM), une grille aléatoire de réseaux de neurones profonds, puis entraîner un Stacked Ensemble en combinant tous ces modèles.
Un AutoML efficace doit couvrir la préparation des données, la génération de modèles et les ensembles, tout en exposant le moins de paramètres possible afin de réduire l’ambiguïté pour l’utilisateur. H2O AutoML répond bien à ces exigences avec un minimum de paramètres à renseigner.
Dans les API R et Python, on retrouve les mêmes arguments liés aux données : x, y, training_frame, validation frame. Parmi eux, y et training_frame sont obligatoires, les autres sont optionnels. Vous pouvez également définir max_runtime_sec et max_models : max_runtime_sec est requis, et max_model est optionnel (par défaut à NULL si non renseigné).
Le paramètre x est le vecteur de variables prédictives issues de training_frame. Si vous ne souhaitez pas utiliser tous les prédicteurs du jeu de données, indiquez ceux à retenir via x.
Voyons quelques paramètres optionnels et divers. N’hésitez pas à les tester, même sans tout maîtriser : cela vous aidera à progresser sur des sujets avancés.
validation_frame : utilisé pour l’arrêt anticipé des modèles individuels dans l’AutoML. Il s’agit d’un dataframe de validation que vous fournissez, ou d’une partie des données d’entraînement si vous ne le passez pas.
leaderboard_frame : si fourni, les modèles sont scorés sur ces données au lieu d’utiliser les métriques de validation croisée. Là encore, il s’agit d’une partie des données d’entraînement si vous ne le passez pas.
nfolds : nombre de plis pour la validation croisée (par défaut : 5). Peut impacter la performance du modèle.
fold_columns : précise l’indexation pour la validation croisée.
weights_column : pour pondérer des colonnes spécifiques. Attribuer un poids de 0 revient à exclure la colonne.
ignored_columns : uniquement en Python, c’est l’inverse de x.
stopping_metric : métrique d’arrêt anticipé des recherches en grille et des modèles. Par défaut : logloss pour la classification et deviance pour la régression.
sort_metric : métrique utilisée pour trier le classement final des modèles. Par défaut : AUC pour la classification binaire, mean_per_class_error pour la classification multinomiale et deviance pour la régression.
Les paramètres validation_frame et leaderboard_frame dépendent de la validation croisée définie par nfolds.
Les scénarios suivants peuvent se produire dans deux cas :
Lorsque l’on utilise la validation croisée dans AutoML : * Seul le training_frame est fourni : les données sont scindées en 80/20 pour entraînement et validation. * training_frame et leaderboard_frame sont fournis : la répartition 80/20 entraînement/validation est conservée. * training_frame et validation_frame sont fournis : aucune scission supplémentaire. * Les trois frames sont fournis : aucune scission.
Lorsque l’on n’utilise pas la validation croisée (impact fort sur le leaderboard_frame, nfolds = 0) : * Seul le training_frame est fourni : scission en 80/10/10 pour entraînement, validation et leaderboard. * training_frame et leaderboard_frame sont fournis : scission 80/20 pour entraînement et validation. * training_frame et validation_frame sont fournis : validation_frame est scindé 50/50 entre validation et leaderboard. * Les trois frames sont fournis : aucune scission.
H2O importe les données sous forme de Frame, différent du data frame que nous utilisons en R et Python pour diverses manipulations.
train <- h2o.importFile("train.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
test <- h2o.importFile("test.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
Définition des prédicteurs et de la variable cible.
y <- "response"
x <- setdiff(names(train), y)
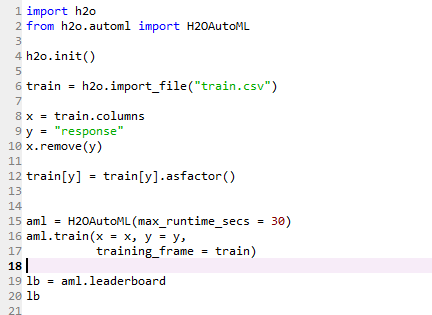
Créez un objet AutoML en passant les paramètres obligatoires. Ici, nous ne passons que le training_frame et la valeur par défaut de nfolds est conservée. Vous pouvez allonger le temps d’exécution selon vos besoins.
train[,y] <- as.factor(train[,y])

aml <- h2o.automl(x = x, y = y,
                  training_frame = train,
                  max_runtime_secs = 30)
##
  |
  |                                                                 |   0%
  |
  |=                                                                |   1%
  |
  |=                                                                |   2%
  |
  |==                                                               |   3%
  |
  |===                                                              |   4%
  |
  |===                                                              |   5%
  |
  |====                                                             |   6%
  |
  |=====                                                            |   8%
  |
  |======                                                           |   9%
  |
  |======                                                           |  10%
  |
  |========                                                         |  13%
  |
  |==========                                                       |  15%
  |
  |==========                                                       |  16%
  |
  |===========                                                      |  16%
  |
  |===========                                                      |  17%
  |
  |===========                                                      |  18%
  |
  |============                                                     |  18%
  |
  |==============================================================   |  95%
  |
  |=================================================================| 100%
Afficher le classement (leaderboard) des différents modèles.
lb <- aml@leaderboard
lb
##                                                model_id       auc
## 1    StackedEnsemble_AllModels_0_AutoML_20181008_110411 0.7823564
## 2 StackedEnsemble_BestOfFamily_0_AutoML_20181008_110411 0.7789898
## 3             GBM_grid_0_AutoML_20181008_110411_model_0 0.7738653
## 4             GBM_grid_0_AutoML_20181008_110411_model_1 0.7720842
## 5             GBM_grid_0_AutoML_20181008_110411_model_2 0.7713380
## 6                          DRF_0_AutoML_20181008_110411 0.7456390
##     logloss mean_per_class_error      rmse       mse
## 1 0.5596939            0.3197364 0.4359927 0.1900896
## 2 0.5628477            0.3112125 0.4374262 0.1913417
## 3 0.5662489            0.3164375 0.4393990 0.1930715
## 4 0.5679111            0.3192612 0.4402417 0.1938127
## 5 0.5679935            0.3297330 0.4405557 0.1940894
## 6 0.5985811            0.3611326 0.4520878 0.2043834
##
## [8 rows x 6 columns]
Pour aller plus loin en Python, suivez le cours Parallel Computing with Dask de DataCamp.
En savoir plus sur le machine learning
Cours
Cours
Cours