Curso
Comprender el machine learning
2 h
308K
Hay mucho ruido en torno a los algoritmos de aprendizaje automático y una gran demanda de especialistas. Sabemos que existe una brecha importante entre la demanda y las habilidades disponibles. El objetivo de H2O es ofrecer una plataforma que facilite a quienes no son expertos experimentar con el aprendizaje automático.
La arquitectura de H2O puede dividirse en distintas capas: en la superior tienes diferentes APIs y, en la inferior, la JVM de H2O.
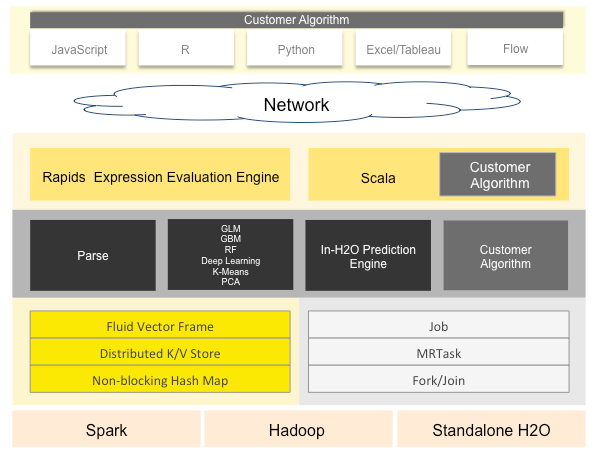
El núcleo de H2O está escrito en Java, lo que habilita el framework completo para multithreading. Aunque esté escrito en Java, ofrece interfaces para R, Python y otros, como se muestra en la arquitectura, lo que permite usarlo de forma eficiente.
En resumen, H2O es una plataforma de código abierto, en memoria, distribuida, rápida y escalable para aprendizaje automático y analítica predictiva, que facilita mucho la construcción de modelos.
Si quieres usar la funcionalidad de H2O en R, puedes instalar el paquete H2O con el comando install.packages(\"h2o\").
library(h2o)
##
## ----------------------------------------------------------------------
##
## Your next step is to start H2O:
##     > h2o.init()
##
## For H2O package documentation, ask for help:
##     > ??h2o
##
## After starting H2O, you can use the Web UI at http://localhost:54321
## For more information visit http://docs.h2o.ai
##
## ----------------------------------------------------------------------

##
## Attaching package: 'h2o'

## The following objects are masked from 'package:stats':
##
##     cor, sd, var

## The following objects are masked from 'package:base':
##
##     %*%, %in%, &&, ||, apply, as.factor, as.numeric, colnames,
##     colnames<-, ifelse, is.character, is.factor, is.numeric, log,
##     log10, log1p, log2, round, signif, trunc
h2o.init()
##  Connection successful!
##
## R is connected to the H2O cluster:
##     H2O cluster uptime:         32 minutes 57 seconds
##     H2O cluster timezone:       Asia/Kolkata
##     H2O data parsing timezone:  UTC
##     H2O cluster version:        3.20.0.2
##     H2O cluster version age:    3 months and 22 days !!!
##     H2O cluster name:           H2O_started_from_R_NSingh1_wou076
##     H2O cluster total nodes:    1
##     H2O cluster total memory:   1.55 GB
##     H2O cluster total cores:    4
##     H2O cluster allowed cores:  4
##     H2O cluster healthy:        TRUE
##     H2O Connection ip:          localhost
##     H2O Connection port:        54321
##     H2O Connection proxy:       NA
##     H2O Internal Security:      FALSE
##     H2O API Extensions:         Algos, AutoML, Core V3, Core V4
##     R Version:                  R version 3.5.1 (2018-07-02)
Al inicializar H2O puede aparecer un error si no tienes instalada una JDK de 64 bits. Si te ocurre, instala la última JDK de 64 bits y funcionará sin problemas.
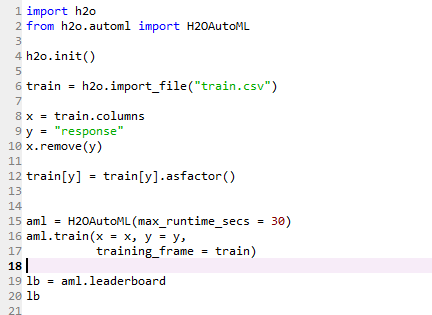
Si usas Python, el proceso es similar: desde la línea de comandos ejecuta pip install -U h2o y se instalará en tu entorno de Python. La inicialización de h2o sigue el mismo procedimiento.
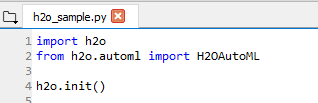
El comando h2o.init() es bastante inteligente y hace mucho trabajo por ti. Primero busca si hay alguna instancia activa de h2o antes de arrancar una nueva, y solo inicia otra si no hay ninguna en ejecución.
Tiene argumentos que te ayudan a ajustar los recursos de la instancia de h2o; los más usados son:
nthreads: por defecto su valor es -1, lo que significa que la instancia puede usar todos los núcleos de la CPU. Puedes fijar cuántos núcleos usar pasando el valor al argumento.
max_mem_size: si pasas un valor a este argumento, limitas la memoria máxima asignada a la instancia. Es de tipo cadena; por ejemplo, puedes pasar \"2g\" o \"2G\" para 2 GB de memoria, y de forma análoga para MB.
Una vez creada la instancia, puedes acceder a Flow escribiendo http://localhost:54321 en tu navegador. Flow es el nombre de la interfaz web de h2o, no requiere instalaciones adicionales y está escrita en CoffeeScript (un lenguaje similar a JavaScript). Puedes usarla para:
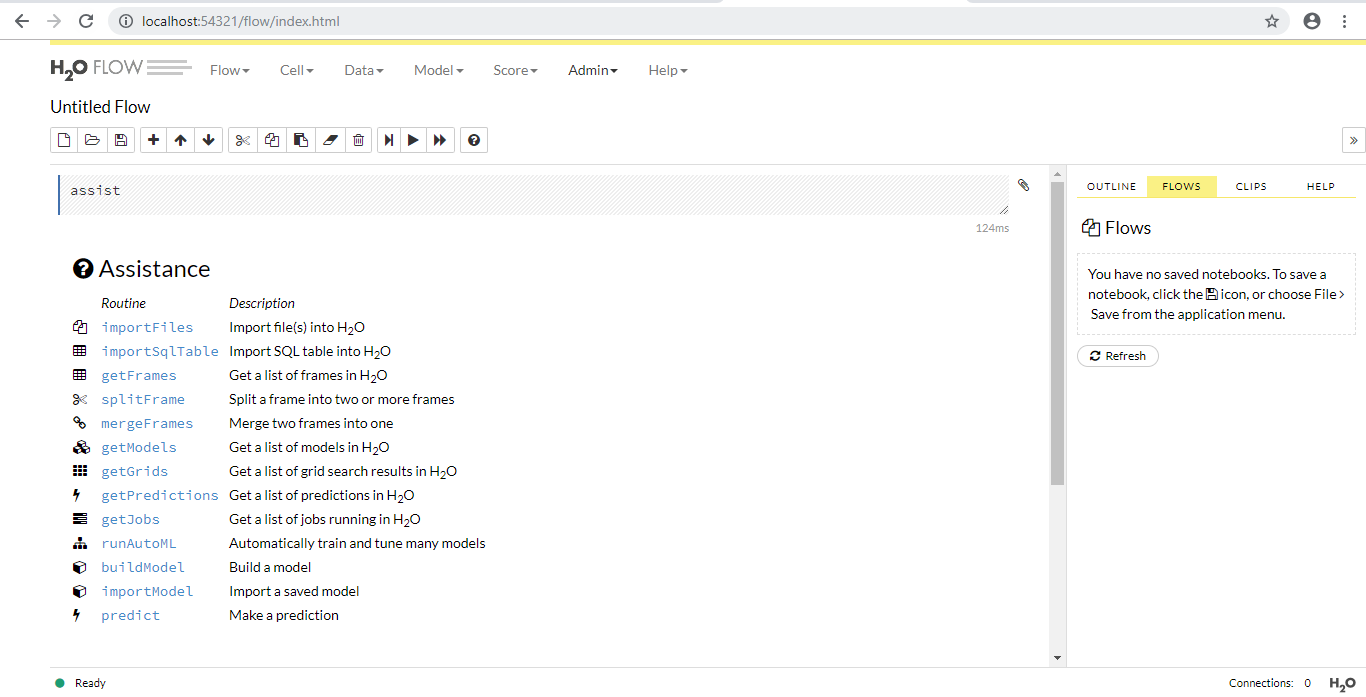
La interfaz es muy útil y facilita el uso a quienes no son expertos. Te recomiendo probarla y hacer tus propios experimentos.
Pasemos ahora a la parte de AutoML de H2O. AutoML ayuda a entrenar y ajustar automáticamente muchos modelos dentro de un límite de tiempo definido por el usuario.
La versión actual de la función AutoML puede entrenar y validar mediante cross-validation un Random Forest, un Extremely Randomized Forest, una búsqueda aleatoria de Gradient Boosting Machines (GBMs), una búsqueda aleatoria de redes neuronales profundas y, después, entrena un Stacked Ensemble con todos los modelos.
Cuando hablamos de AutoML, debería cubrir aspectos de preparación de datos, generación de modelos y ensamblados, y ofrecer el menor número posible de parámetros para que los usuarios puedan trabajar sin complicaciones. H2O AutoML cumple con esta premisa con un conjunto mínimo de parámetros.
En las APIs de R y Python se usan los mismos argumentos de datos: x, y, training_frame, validation frame, de los cuales y y training_frame son obligatorios y el resto opcionales. También puedes configurar max_runtime_sec y max_models; aquí max_runtime_sec es obligatorio y max_models es opcional. Si no pasas ningún valor, toma NULL por defecto.
El parámetro x es el vector de predictores de training_frame. Si no quieres usar todos los predictores del frame que pasaste, puedes indicarlos explícitamente en x.
Veamos ahora algunos parámetros opcionales y misceláneos. Anímate a probarlos aunque no los conozcas todavía; te ayudará a aprender temas avanzados:
validation_frame: se utiliza para el early stopping de los modelos individuales en AutoML. Es un dataframe que pasas para la validación del modelo o, si no lo pasas, puede tomarse de los datos de entrenamiento.
leaderboard_frame: si se proporciona, los modelos se puntúan con estos datos en lugar de usar las métricas de cross-validation. De nuevo, si no lo pasas, se toma de los datos de entrenamiento.
nfolds: validación cruzada K-fold (por defecto 5). Ten en cuenta que puede afectar al rendimiento del modelo.
fold_columns: especifica el índice para la validación cruzada.
weights_column: si quieres asignar pesos a columnas concretas, usa este parámetro. Asignar peso 0 excluye la columna.
ignored_columns: solo en Python, es el inverso de x.
stopping_metric: métrica para el early stopping de las búsquedas en grid y los modelos; por defecto es logloss para clasificación y deviance para regresión.
sort_metric: métrica para ordenar los modelos del leaderboard al final. Por defecto es AUC para clasificación binaria, mean_per_class_error para clasificación multiclase y deviance para regresión.
Los parámetros validation_frame y leaderboard_frame dependen del parámetro de validación cruzada nfolds.
Se dan los siguientes escenarios en dos casos:
Cuando usamos validación cruzada en AutoML: * Solo se pasa el training frame: los datos se dividen en 80-20 para entrenamiento y validación. * Se pasan training y leaderboard frame: no cambia la división 80-20 entre entrenamiento y validación. * Se pasan training y validation frame: no hay división. * Se pasan los tres frames: no hay divisiones.
Cuando no usamos validación cruzada (nfolds = 0), lo que afecta bastante al leaderboard frame: * Solo se pasa el training frame: los datos se dividen en 80/10/10 para entrenamiento, validación y leaderboard. * Se pasan training y leaderboard frame: división 80-20 entre entrenamiento y validación. * Se pasan training y validation frame: los datos de validation_frame se dividen en 50-50 para validación y leaderboard. * Se pasan los tres frames: no hay divisiones.
H2O importa los datos como Frame, que es distinto del data frame que usamos en R y Python para diversas manipulaciones.
train <- h2o.importFile("train.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
test <- h2o.importFile("test.csv")
##
  |
  |                                                                 |   0%
  |
  |=================================================================| 100%
Definimos los predictores y la variable de respuesta.
y <- "response"
x <- setdiff(names(train), y)
Crea un objeto AutoML pasando los parámetros obligatorios. Aquí solo pasamos el training frame, y nfolds mantiene su valor por defecto. Puedes aumentar el tiempo de ejecución según tus necesidades.
train[,y] <- as.factor(train[,y])

aml <- h2o.automl(x = x, y = y,
                  training_frame = train,
                  max_runtime_secs = 30)
##
  |
  |                                                                 |   0%
  |
  |=                                                                |   1%
  |
  |=                                                                |   2%
  |
  |==                                                               |   3%
  |
  |===                                                              |   4%
  |
  |===                                                              |   5%
  |
  |====                                                             |   6%
  |
  |=====                                                            |   8%
  |
  |======                                                           |   9%
  |
  |======                                                           |  10%
  |
  |========                                                         |  13%
  |
  |==========                                                       |  15%
  |
  |==========                                                       |  16%
  |
  |===========                                                      |  16%
  |
  |===========                                                      |  17%
  |
  |===========                                                      |  18%
  |
  |============                                                     |  18%
  |
  |==============================================================   |  95%
  |
  |=================================================================| 100%
Consulta el leaderboard de los distintos modelos.
lb <- aml@leaderboard
lb
##                                                model_id       auc
## 1    StackedEnsemble_AllModels_0_AutoML_20181008_110411 0.7823564
## 2 StackedEnsemble_BestOfFamily_0_AutoML_20181008_110411 0.7789898
## 3             GBM_grid_0_AutoML_20181008_110411_model_0 0.7738653
## 4             GBM_grid_0_AutoML_20181008_110411_model_1 0.7720842
## 5             GBM_grid_0_AutoML_20181008_110411_model_2 0.7713380
## 6                          DRF_0_AutoML_20181008_110411 0.7456390
##     logloss mean_per_class_error      rmse       mse
## 1 0.5596939            0.3197364 0.4359927 0.1900896
## 2 0.5628477            0.3112125 0.4374262 0.1913417
## 3 0.5662489            0.3164375 0.4393990 0.1930715
## 4 0.5679111            0.3192612 0.4402417 0.1938127
## 5 0.5679935            0.3297330 0.4405557 0.1940894
## 6 0.5985811            0.3611326 0.4520878 0.2043834
##
## [8 rows x 6 columns]
Si quieres aprender más con Python, echa un vistazo al curso de DataCamp Parallel Computing with Dask.
Más sobre machine learning
Curso
Curso
Curso
Tutorial
Abid Ali Awan
11 min
Tutorial
Arunn Thevapalan
15 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Tutorial
Eugenia Anello
8 min
Tutorial
Javier Canales Luna
7 min