

随着数据科学版图愈发复杂、技术日新月异,为项目选择合适的工具箱至关重要。项目越复杂,您在选用工具时就越需要谨慎,因为这些选择将深刻影响开发进度,并最终影响项目成败。
如果您正在进行数据科学项目,设计上的取舍早已超越了Python 与 R 的争论。同样重要的是:一旦确定了编程语言,您将选用哪些库。
在 Python 的数据科学场景中,pandas 是事实上的数据处理标准工具。使用 pandas 的理由既多且有力,但它也存在局限,可能在项目中形成瓶颈。尤其是面对大型数据集时,pandas 的性能受限广为人知。
为解决这些问题,pandas 近期发布了 2.0 版本,带来了重要修订与性能提升(想了解pandas 2.0 的全部要点,请查看此文)。
与此同时,Python 生态中也出现了新的替代方案,挑战 pandas 的主导地位。其中最受欢迎的之一是 polars,一款基于 Python 与 Rust 的更快数据分析库。
本文将分析 pandas 2.0 与 polars 在数据处理方面的差异。我们将先介绍提升计算性能的策略,最后通过一系列测试比较两者的表现。让我们开始吧!
如何在 pandas 与 polars 之间做选择
没有任何一种技术能够在绝对意义上成为解决数据科学流程中所有问题与情景的最佳答案。做出选择前,您需要权衡多种因素。以下是一些最值得关注的方面:
- 计算性能。经验法则是:项目越大、越复杂,就越应考虑高性能工具,以避免计算瓶颈。
- 技术栈匹配。数据科学项目中的工具很少是孤立工作的,它们需要与技术栈中的其他工具协同。做出选择前,应充分考虑技术之间的协同与契合度。
- 代码兼容性。采用新技术同样涉及代码兼容与效率。如果引入新工具意味着要在现有项目中重写代码,这一成本也应纳入考量。
- 流行度。工具的流行度可以反映其用户规模,这对于招聘开发者或在 Stack Overflow 等平台上解决问题都很有帮助。
如何提升数据处理性能?
本节将介绍几种有助于提升数据处理性能的关键技术。
通过写时复制减少拷贝
在传统数据处理工具中,每次数据操作都会创建整个数据集的新副本。面对大型数据集时,这种行为会给内存资源带来压力。
写时复制(copy-on-write)是解决该问题的常见技术。本质上,写时复制是一种资源管理手段,让您能高效实现对可修改资源的“复制”操作。这意味着,如果一个数据集被复制但未(完全)修改,就无需创建新资源;相反,副本与原数据可以共享内存资源。
并行计算
pandas 的主要短板之一是其线程模型限制,无法充分利用如今数据科学中常见的并行计算。并行计算主要通过多核机器或分布式计算(即集群中多台计算机协作)实现。
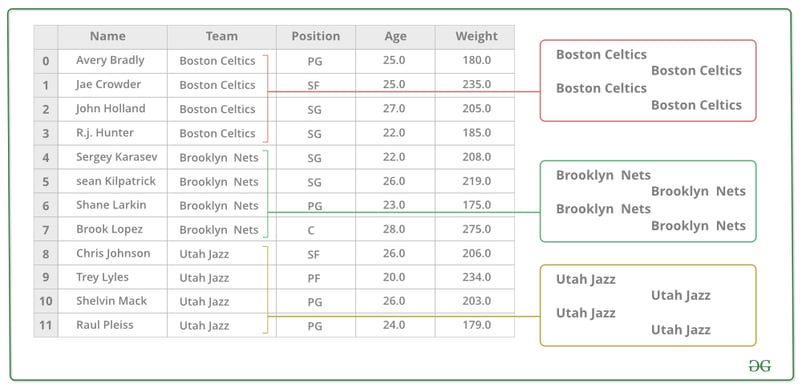
以常见的 group by 为例。如果想按球队计算篮球运动员的平均年龄,可以用并行计算把每个分组的均值计算分配到不同的内核或机器,而不是逐一计算,从而提升性能。
优化数据导入
数据分析的起点通常是读取待研究的数据集。但在涉及大型数据集的项目中,这往往是瓶颈。以下技巧有助于提升读取文件时的性能:
- 分块读取。与其一次性读取完整文件,不如将其拆分为多个“小块”。这样既能更快导入数据,又能降低同时存储所需的内存。
- 仅读取所需列。有时您事先就知道分析需要哪些列。此时可先做预筛选,只读取所需列。
- 向下转换数据类型。像 pandas 这样的工具在为导入列分配数据类型时有默认行为。有时可以选择占用更少内存且不丢失信息的类型。向下转换是将数据类型改为可承载其数值的最小类型的过程。
惰性求值与查询规划
操作的执行顺序会影响性能。很多时候,通过调整计算顺序,可以更高效地得到相同结果。
实现这一点的两种策略是惰性求值与查询规划。前者指将计算尽可能延后,直到确有必要才执行;后者则是在给定一系列不同查询时,寻找执行多步数据处理的最高效方式。查询规划通常需要借助查询优化器。
外存计算
像 pandas 这样的工具会将整个数据集存入内存。如果您处理的规模超出机器内存,或要执行某些内存密集型操作,就会遇到麻烦。
这时外存计算就很关键。简单说,外存计算是指利用外部存储(如外置硬盘)来存放原本无法装入主内存的数据。外存计算允许您按块处理外部存储中的数据,最终得到与在本机一次性处理相同的结果。
有哪些高性能的 pandas 替代方案?
本文聚焦 pandas 2.0 与 polars 的对比,但也值得一提其他可能满足您需求的替代工具。以下是一些很有前景的选择:
- Koalas。基于 PySpark 的 pandas API。如果您使用 Spark,应考虑它。
- Vaex。面向外存计算的 pandas API,适合以每秒十亿行的速度分析大型表格数据。
- Modin。面向并行编程的 pandas API,基于 Dask 或 Ray 框架,适用于大数据项目。如果您使用 Dask 或 Ray,Modin 很有价值。
- cuDF。RAPIDS 项目的一部分,提供类似 pandas 的 GPU 计算 API,依赖 NVIDIA GPU 或 RAPIDS 的其他组件以实现高速数据处理。
为何选择 polars?
对使用 Python 的数据从业者而言,pandas 是首选。但如前所述,在处理大型数据集时它存在多项重要限制。polars 的核心使命是提供一个极速的 dataframe 库,直面 pandas 的痛点。
它以 Rusk 编写(这是一种强大的编程语言,提供接近 C/C++ 的性能,并允许在查询引擎中完全掌控性能关键部分),polars 融合了旨在提升性能的前沿方法,包括:
- 强化并行计算,充分利用机器上的所有内核。
- 借助惰性求值与查询规划优化查询,减少不必要的工作与内存分配。
- 通过写时复制语义与 Apache Arrow 改善存储性能。
- 通过其流式 API 的外存数据能力,处理远超内存规模的数据集。
最后但同样重要的是,polars 的语法与 pandas 相当接近,并共享诸如 Series 与 DataFrame 等基本构件。如果您决定迁移到 polars,这将让您更容易上手。
pandas 2.0 如何应对竞争加剧?
为缓解性能问题并应对竞争压力,pandas 近期发布了期待已久的 2.0 版本。作为一次重大更新,pandas 2.0 引入了多项新特性,并强制弃用了一些功能,从而带来 API 变化。
新的 PyArrow 后端是 pandas 用以解决性能限制的重头戏。用户如今可以在传统的 NumPy 后端与全新的 PyArrow 后端之间进行选择。PyArrow 是一个 Python 库,基于 Arrow 内存结构为处理大型数据集提供接口。
pd.read_csv(my_file, engine='pyarrow')另一项重要改进是引入了多处写时复制优化,旨在通过节省内存资源来提升性能。
因此,许多 pandas 操作现在包含默认的“copy”参数,会返回 Series 与 DataFrame 等基础对象的惰性副本,而非对象的完全相同、缓存副本。
目前还为时尚早,无法断言 pandas 的这些能力是否足以化解其性能问题。即便有其他工具表现更佳,继续使用 pandas 依然有充分理由:您无需重写既有代码,也无需学习新语法——毕竟您很可能已经在用它。
pandas 2.0 与 polars:对比框架
理论了解之后,是动手实测的时候了。接下来我们将通过一系列测试比较 pandas 2.0 与 polars 的性能。我们的基准是完成任务所需时间。为此将使用 time 模块来简单计算执行时长。
除性能测试外,我们还将分析 polars 与 pandas 的代码兼容性(也就是:若切换到 polars,您需要改动多少代码?)
数据集
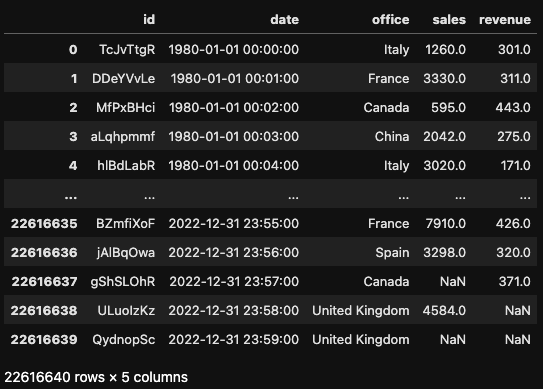
我们将使用一个虚构数据集,包含 1980–2022 年间一家在多国设有办事处的公司按小时计的销售记录,以此测试 pandas 2.0 与 polars 的性能。为增加基准的复杂度,我们会随机加入缺失值。
整体而言,该数据集包含超过 2200 万行,占用超 1.6 GB 内存,足以让 pandas 承压。完整基准测试代码可在此 DataLab 工作簿中找到。
导入测试
先从数据导入的性能比较开始。Polars 明确宣称其 CSV 导入性能强劲。事实是否如此?
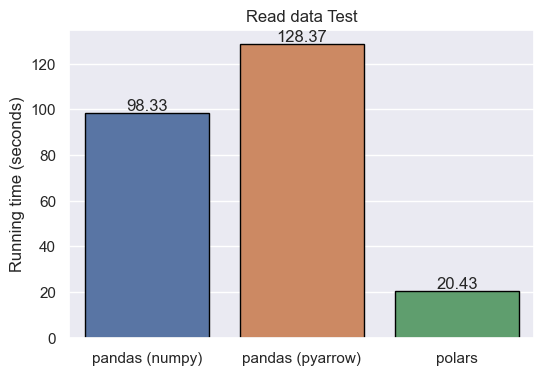
我们将测试 pandas 与 polars 读取部分列与行所需的时间。比如,假设您只想分析法国办事处的销售情况。使用 pandas,您需要先读取所有行,再通过筛选去除不需要的行。我们将使用全新的 .query() 方法来实现。为体验 pandas 2.0 的表现,我们会分别用传统的 numpy 引擎和新的 pyarrow 引擎导入 CSV。
相比之下,polars 提供了 filter() 方法,可结合条件只读取您关心的行。
# pandas query
df_pd = pd.read_csv("./example.csv", engine="pyarrow")
df_pd = df_pd[['id', 'date', 'office', 'sales']]
df_pd = df_pd.query("office=='France'")
# polars filter
df_pl = pl.read_csv('example.csv').filter(
(pl.col('office') == 'France'))
df_pl.select(pl.col(['id', 'date', 'office', 'sales']))
测试结果显示,如图所示,polars 的表现明显优于 pandas。出人意料的是,pyarrow 引擎并未优于标准的 numpy 引擎。
从语法兼容性看,polars 明显延续了 pandas 的“味道”,如 pl.read_csv() 等函数与 pandas 高度对应。不过,两者底层机制不同,必然导致语法差异,例如本文中对比的 query() 与 filter() 方法。
分组测试
Groupby 操作非常适合并行化。我们来看看在若干分组聚合操作中,pandas 与 polars 的表现。具体来说,我们将按办事处与月份计算销售额的均值与中位数。
df_pd.groupby([df_pd.office, df_pd.date.dt.month])['sales'].agg('mean') # pandas groupby mean
df_pl.groupby([pl.col('office'), pl.col('date').dt.month()]).agg([pl.mean('sales')]) # polars groupby mean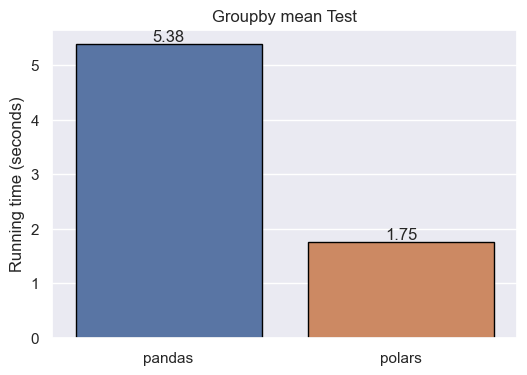
df_pd.groupby([df_pd.office, df_pd.date.dt.month])['sales'].agg('median') # pandas groupby median
df_pl.groupby([pl.col('office'), pl.col('date').dt.month()]).agg([pl.median('sales')]) pandas groupby median
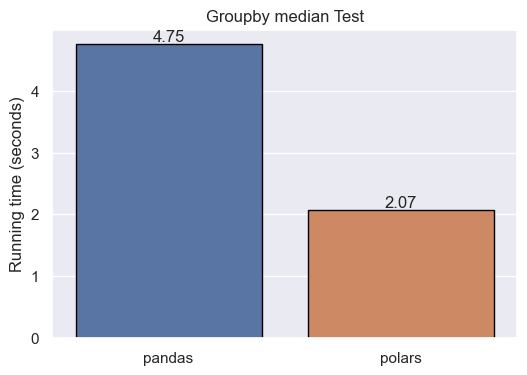
结果表明,在分组与聚合计算中,polars 的性能优于 pandas。再次说明,polars 的语法与 pandas 相似。
滚动统计测试
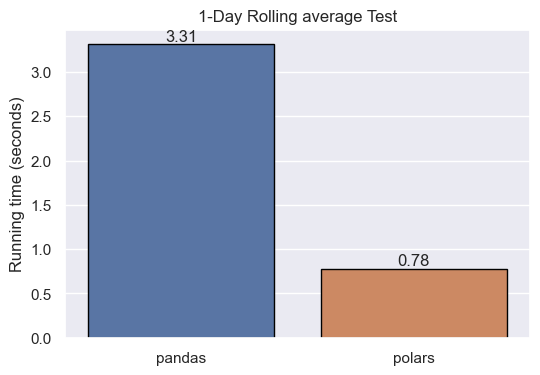
另一个适合对比 pandas 与 polars 性能的操作是滚动统计。优化这类计算涉及不少棘手的算法工作。我们来看一下按天计算销售额滚动均值时的表现。
# pandas rolling mean
df_pd['sales'].rolling(1440, min_periods=1).mean()
# polars rolling mean
df_pl['sales'].rolling_mean(1440, min_periods=1)再次,polars 胜出。请注意语法上的细微差别:polars 提供 rolling_mean() 方法;而 pandas 通过 rolling() 再配合 mean() 等方法实现同样结果。
抽样测试
在研究某一现象时,通常无法考察整体总体,因此抽样成为统计与数据科学中最常见的任务之一。这常涉及使用蒙特卡罗模拟技术(如自助法和置换)进行随机抽样。然而,这一操作也需要大量变量拷贝,如果计算资源不足将颇具挑战。
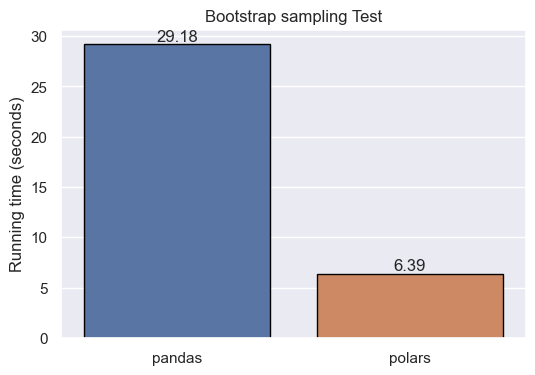
来看在执行自助法(即有放回重采样)时,pandas 与 polars 的表现。我们将从包含 1000 个数据点的样本中重复抽样 10000 次,估计销售额的均值。
#pandas bootstrap
simu_weights = []
for i in range(10000):
bootstrap_sample = random.choices(df_pd['sales'], k=1000)
simu_weights.append(np.nanmean(bootstrap_sample))
#polars bootstrap
simu_weights = []
for i in range(10000):
bootstrap_sample = df_pl['sales'].sample(n=1000,with_replacement=True)
simu_weights.append(bootstrap_sample.mean())在进行自助抽样时,polars 的速度几乎是 pandas 的 5 倍。
从语法上看,pandas 依赖 numpy 完成抽样操作,而 polars 则内置了便捷的 sample() 方法。
复合操作
最后一个测试中,我们将执行一系列关联的数据处理操作。这是数据专业人士的日常。然而,多步骤的数据操作很容易在计算上写得不够高效。
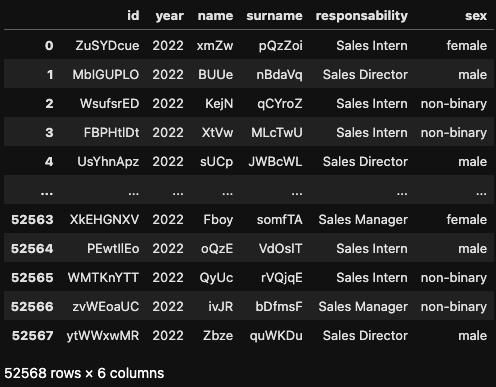
假设这家虚构公司的意大利办事处考虑在 2022 年实习期结束后,留用部分实习生。我们的目标是分析 2022 年完成了最大十笔销售的实习生,以据此挑选最合适的候选人。
为此,我们需要将主数据集与第二个名为“italy_2022”的数据集合并,后者包含 2022 年每笔交易对应的人员信息。两者的公共列为 “id”。
# pandas compound operations
df_pd.merge(italy_2022, on='id').query("responsibility =='Sales Intern'").sort_values('sales', ascending=False).head(10)[['name','surname','sales','sex']]
#polars compound manipulations
df_pl.join(italy_2022_pl, on="id").filter(pl.col('responsability') == 'Sales Intern').sort('sales',descending=True).head(10).select(pl.col(['name','surname','sales','sex']))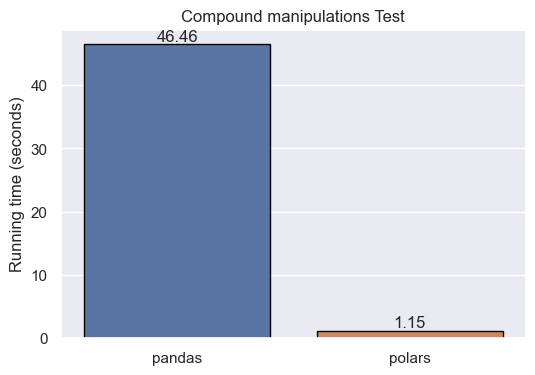
与此前所有测试一致,polars 在性能上领先。在本测试中,pandas 在连接操作上显得更吃力;相对而言,polars 高效得多,完成整条链式任务的时间不到两秒。
pandas 2.0 与 polars 对比表
我们将上述测试总结为下表,便于快速对比:
|
测试 |
Pandas 2.0 |
Polars |
胜出者 |
语法相似度 |
|
导入测试 |
读取所有行,再用 .query() 过滤不需要的行 |
使用 filter() 直接仅读取感兴趣的行 |
Polars(性能更佳) |
相似,但因底层实现不同(.query() vs filter())而略有差异 |
|
分组测试 |
使用 .groupby() 执行聚合操作,如按办事处与月份计算销售额均值与中位数 |
与 pandas 相同,但性能更佳 |
Polars(性能更佳) |
相似 |
|
滚动统计测试 |
使用 rolling() 并配合 mean() 等方法计算滚动均值 |
使用 rolling_mean() 计算滚动均值 |
Polars(性能更佳) |
相似,但略有差异(.rolling().mean() vs rolling_mean()) |
|
抽样测试 |
依赖 numpy 进行自助抽样 |
使用内置 sample() 方法进行自助抽样 |
Polars(快近 5 倍) |
不同:pandas 依赖 numpy,polars 提供内置方法 |
|
复合操作测试 |
与另一数据集执行连接操作,然后排序并选择数据 |
执行相同任务,但更高效 |
Polars(显著更快) |
相似,但略有差异(merge().query().sort_values().head() vs join().filter().sort().head().select()) |
更进一步
恭喜您读完本教程。根据测试结果,polars 在几乎所有测试中的表现都明显优于 pandas 2.0。尽管这对 pandas 的主导地位构成了现实威胁,但 pandas 作为 Python 数据处理的首选,依然享有更大用户社区所带来的诸多优势。
如果您处理大型数据集,提升性能是刚需。DataCamp 可为您提供支持。以下课程可助您将计算性能更上一层楼:

我是一名自由职业的数据分析师,与全球各地的公司和组织合作开展数据科学项目。我也担任数据科学讲师,拥有2年以上授课经验。我经常用英语和西班牙语撰写与数据科学相关的文章,其中一些已发表在 DataCamp、Towards Data Science 和 Analytics Vidhya 等知名网站上。作为一名具有政治学与法律背景的数据科学家,我的目标是在公共政策、法律与技术的交汇处开展工作,借助思想的力量推动创新解决方案与叙事,帮助我们应对紧迫挑战,尤其是气候危机。我认为自己是自学成才、不断进步的人,坚定支持跨学科合作。学习新事物永远不嫌晚。