
Our biggest-ever sale. 60% off AI & data skills
Buy Now
जैसे-जैसे डेटा साइंस का परिदृश्य और जटिल होता जा रहा है और नई तकनीकें रोज़ सामने आ रही हैं, अपने प्रोजेक्ट के लिए सही टूलबॉक्स चुनना बेहद अहम हो गया है। प्रोजेक्ट जितना जटिल होगा, टूल्स चुनते समय उतनी ही ज्यादा सावधानी बरतनी होगी, क्योंकि आपके चुनाव विकास पर, और अंततः, प्रोजेक्ट की सफलता पर गहरा असर डालेंगे।
यदि आप किसी डेटा साइंस प्रोजेक्ट पर काम कर रहे हैं, तो डिज़ाइन विकल्प महज़ Python बनाम R बहस से कहीं आगे जाते हैं। बात उन लाइब्रेरीज़ की भी होती है जिनका इस्तेमाल आप उस प्रोग्रामिंग भाषा के साथ करेंगे जिस पर आपका प्रोजेक्ट आधारित होगा।
डेटा साइंस के लिए Python के मामले में, डेटा मैनिप्युलेशन के लिए pandas वास्तविक मानक टूल है। pandas का उपयोग करने के कई ठोस कारण हैं, लेकिन इसके साथ ऐसी सीमाएँ भी आती हैं जो आपके प्रोजेक्ट्स में अहम बाधाएँ बन सकती हैं। खासकर, बड़े डेटासेट संभालते समय pandas के सीमित प्रदर्शन के लिए जाना जाता है।
इन समस्याओं को दूर करने के लिए, pandas ने हाल ही में अपना 2.0 संस्करण जारी किया है, जो महत्वपूर्ण संशोधनों और प्रदर्शन सुधारों के साथ आता है (यह जानने के लिए कि pandas 2.0 के बारे में आपको क्या-क्या जानना चाहिए, यह लेख देखें)।
इस बीच, Python इकोसिस्टम में pandas के प्रभुत्व को चुनौती देने के लिए नए विकल्प सामने आए हैं। उनमें से एक सबसे लोकप्रिय है polars, जो Python-और-Rust आधारित लाइब्रेरी है, तेज़ डेटा विश्लेषण के लिए।
यह लेख डेटा मैनिप्युलेशन के लिए pandas 2.0 और polars के बीच के अंतर का विश्लेषण करेगा। यह कंप्यूटिंग प्रदर्शन सुधारने की रणनीतियों के विश्लेषण से शुरू होगा और अंत में दोनों टूल्स के प्रदर्शन की तुलना के लिए कई परीक्षणों के साथ समाप्त होगा। आइए शुरू करें!
कोई एकल तकनीक ऐसी नहीं है जो आपके डेटा साइंस वर्कफ्लो के दौरान उत्पन्न होने वाली सभी समस्याओं और परिस्थितियों का सर्वोत्तम समाधान हो। किसी भी चुनाव से पहले कई कारकों के बीच संतुलन बनाना ज़रूरी है। यहाँ कुछ सबसे प्रासंगिक कारक दिए गए हैं:
इस खंड में, हम मुख्य तकनीकों को कवर करेंगे जो डेटा मैनिप्युलेशन का प्रदर्शन बढ़ाने में सहायक हो सकती हैं।
डेटा मैनिप्युलेशन के पारंपरिक टूल्स में, हर डेटा ऑपरेशन पूरे डेटाबेस की एक नई कॉपी बना देता है। बड़े डेटासेट के साथ काम करते समय यह व्यवहार मेमोरी संसाधनों के लिए समस्या खड़ी कर सकता है।
कॉपी-ऑन-राइट इस समस्या का सबसे आम हल है। मूल रूप से, कॉपी-ऑन-राइट एक संसाधन-प्रबंधन तकनीक है जो परिवर्तनीय संसाधनों पर "डुप्लिकेट" या "कॉपी" ऑपरेशन को कुशलतापूर्वक लागू करने देती है। इसका मतलब है कि यदि किसी डेटासेट को डुप्लिकेट किया गया है लेकिन उसे (पूरी तरह) संशोधित नहीं किया गया, तो नई संसाधन बनाने की आवश्यकता नहीं है। इसके बजाय, कॉपी और मूल के बीच मेमोरी संसाधन साझा किए जा सकते हैं।
pandas की एक प्रमुख कमी यह है कि यह सिंगल-थ्रेडेड है, यानी यह समानांतर कंप्यूटिंग तकनीकों का लाभ नहीं उठा सकता जो अब डेटा साइंस में आम हैं। समानांतर कंप्यूटिंग मुख्य रूप से मल्टी-कोर मशीनों या वितरित कंप्यूटिंग (अर्थात, क्लस्टर में एक साथ काम करने वाले कंप्यूटरों का समूह) द्वारा की जाती है।
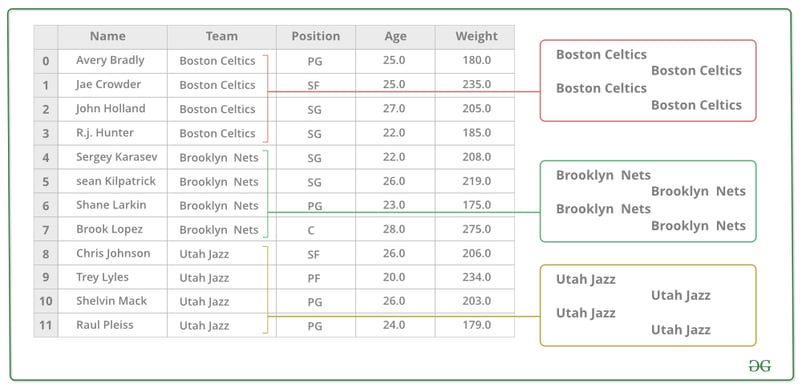
लोकप्रिय group by फ़ंक्शन का निम्नलिखित उदाहरण देखें। यदि आप टीमों के आधार पर समूहित बास्केटबॉल खिलाड़ियों की औसत आयु गणना करना चाहते हैं, तो आप समानांतर कंप्यूटिंग का उपयोग करके प्रत्येक समूह के औसत की गणना को एक-एक कोर या मशीन को सौंप सकते हैं, बजाय उन्हें क्रमशः एक-एक करके निकालने के, और इस प्रकार प्रदर्शन बढ़ा सकते हैं।
डेटा विश्लेषण का शुरुआती बिंदु आमतौर पर उन डेटासेट्स को पढ़ना है जिनका आप अध्ययन करना चाहते हैं। हालाँकि, बड़े डेटासेट वाले प्रोजेक्ट्स में यह अक्सर एक बाधा बन जाता है। डेटा फाइलें पढ़ते समय प्रदर्शन सुधारने में सहायक कुछ तकनीकें यहाँ हैं:
ऑपरेशन्स किस क्रम में किए जाते हैं, इससे प्रदर्शन प्रभावित हो सकता है। कई बार आप कुछ गणनाओं का क्रम बदलकर वही उत्तर अधिक कुशलता से प्राप्त कर सकते हैं।
इसे हासिल करने के दो तरीके हैं: लेज़ी इवैल्युएशन और क्वेरी प्लानिंग। पहला रणनीति गणनाओं को तब तक टालने से संबंधित है जब तक कि वे बिल्कुल आवश्यक न हों। इसके विपरीत, क्वेरी प्लानिंग एक ऐसी प्रक्रिया है जिसमें विभिन्न क्वेरीज़ के एक सेट को देखते हुए, कई डेटा मैनिप्युलेशन्स को करने का सबसे कुशल तरीका खोजा जाता है। ऐसा करने के लिए, क्वेरी प्लानिंग आम तौर पर क्वेरी ऑप्टिमाइज़र का उपयोग करती है।
pandas जैसे टूल्स पूरे डेटासेट्स को आपकी मेमोरी में स्टोर करते हैं, जो परेशानी पैदा कर सकता है यदि आप बड़े डेटासेट्स के साथ काम करते हैं जो आपके कंप्यूटर की मेमोरी में फिट नहीं होते, या कुछ मेमोरी-गहन ऑपरेशन्स करते हैं।
यहीं आउट-ऑफ-कोर कम्प्यूटेशन्स मायने रखते हैं। सरल शब्दों में, आउट-ऑफ-कोर प्रोसेसिंग बाहरी मेमोरी (जैसे, एक बाहरी डिस्क) को संदर्भित करती है जो ऐसे डेटा को स्टोर करती है जो अन्यथा कोर मेमोरी में फिट नहीं हो सकता। आउट-ऑफ-कोर प्रोसेसिंग आपको बाहरी रूप से स्टोर किए गए डेटा को चंक्स में प्रोसेस करने देती है, ताकि अंततः आपको वही परिणाम मिलें जैसे कि आपने पूरा प्रोसेस अपने कंप्यूटर पर किया हो।
यह लेख pandas 2.0 बनाम polars तुलना पर केंद्रित है, लेकिन अन्य टूल्स का भी उल्लेख करना उचित है जो pandas के विकल्प के रूप में आपकी ज़रूरतें पूरी कर सकते हैं। यहाँ कुछ सबसे संभावनाशील टूल्स हैं:
Python का उपयोग करने वाले डेटा प्रैक्टिशनर्स के लिए pandas डिफ़ॉल्ट विकल्प है, लेकिन जैसा कि पहले समझाया गया, बड़े डेटासेट्स से निपटने में इसकी कई महत्वपूर्ण सीमाएँ हैं। polars का मुख्य उद्देश्य एक बिजली-सी तेज़ डेटा फ्रेम लाइब्रेरी प्रदान करना है जो pandas की सभी समस्याओं का समाधान करे।
Rust में लिखी गई (एक शक्तिशाली प्रोग्रामिंग भाषा जो C/C++ के स्तर का प्रदर्शन देती है और क्वेरी इंजन के प्रदर्शन-आलोच्य हिस्सों पर पूरा नियंत्रण देती है), polars प्रदर्शन बढ़ाने के लिए अत्याधुनिक पद्धतियाँ समाहित करता है, जिनका डिज़ाइन इस प्रकार है:
अंत में, polars की एक और अहम विशेषता यह है कि इसकी सिंटैक्स pandas से काफ़ी मिलती-जुलती है और यह Series और DataFrames जैसे समान बिल्डिंग ब्लॉक्स साझा करता है। यदि आप polars पर शिफ्ट होना चाहें, तो यह आपके लिए चीज़ें आसान बना देगा।
अपने प्रदर्शन संबंधी मुद्दों को दूर करने और प्रतिस्पर्धियों के दबाव का संतुलन बनाने के लिए, pandas ने हाल ही में अपना लंबे समय से प्रतीक्षित 2.0 संस्करण जारी किया है। यह एक प्रमुख अपडेट है जो नई सुविधाओं की एक शृंखला लाता है। इसमें प्रवर्तित डिप्रिकेशन्स भी शामिल हैं, जिनसे API में बदलाव आए हैं।
नया PyArrow बैकएंड pandas की प्रदर्शन सीमाओं को दूर करने के लिए इसकी सबसे बड़ी पहल है। उपयोगकर्ता अब पारंपरिक NumPy बैकएंड और बिल्कुल नए PyArrow बैकएंड में से चुन सकते हैं। PyArrow एक Python लाइब्रेरी है जो Arrow मेमोरी संरचनाओं का उपयोग करते हुए बड़े डेटासेट्स को संभालने के लिए इंटरफ़ेस प्रदान करती है।
pd.read_csv(my_file, engine='pyarrow')एक और महत्वपूर्ण सुविधा कई कॉपी-ऑन-राइट सुधारों का समावेश है, जिनका उद्देश्य मेमोरी संसाधन बचाकर प्रदर्शन में सुधार करना है।
नतीजतन, अब कई pandas ऑपरेशन्स में डिफ़ॉल्ट “copy” पैरामीटर शामिल है जो समान, कैश्ड ऑब्जेक्ट कॉपीज़ के बजाय, series और dataframes जैसे मूलभूत pandas ऑब्जेक्ट्स की लेज़ी कॉपी लौटाएगा।
यह कहना अभी जल्दबाज़ी होगी कि pandas की क्षमताएँ उसके प्रदर्शन मुद्दों को दूर कर पाएंगी या नहीं। भले ही अन्य टूल्स इसे पछाड़ दें, pandas का उपयोग जारी रखने के पर्याप्त कारण रहेंगे: आपको कोई मौजूदा कोड फिर से लिखने या नया कोड सीखने की ज़रूरत नहीं होगी, क्योंकि संभवतः आप पहले से ही इसका उपयोग कर रहे हैं।
अब जबकि आपने सिद्धांत समझ लिया है, हाथ गंदे करने का समय है। अगले खंडों में, हम pandas 2.0 बनाम polars के प्रदर्शन की तुलना करने के लिए कई परीक्षण करेंगे। हमारा बेंचमार्क किसी कार्य को पूरा करने में लगने वाला समय होगा। इसके लिए, हम time मॉड्यूल का उपयोग करेंगे, जो निष्पादन समय की गणना का सरल तरीका प्रदान करता है।
प्रदर्शन परीक्षणों के अलावा, हम polars की pandas के साथ कोड संगतता का भी विश्लेषण करेंगे (अर्थात, यदि आप polars पर स्विच करना चाहें तो आपको कितना कोड बदलना होगा?)
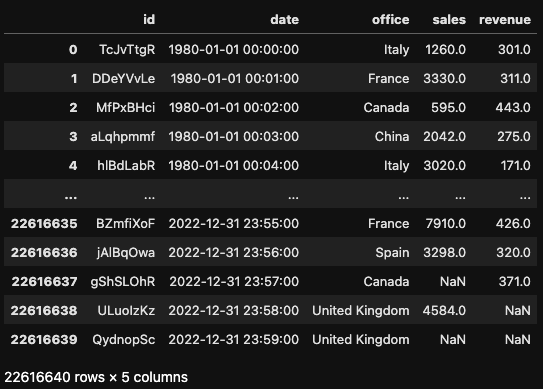
हम 1980-2022 की अवधि में विभिन्न देशों में कार्यालय रखने वाली एक कंपनी की प्रति घंटा बिक्री के काल्पनिक डेटासेट के साथ pandas 2.0 बनाम polars के प्रदर्शन का परीक्षण करेंगे। बेंचमार्क विश्लेषण में जटिलता जोड़ने के लिए, हम कुछ यादृच्छिक अनुपलब्ध मान जोड़ेंगे।
कुल मिलाकर, डेटासेट में 2.2 करोड़ से अधिक पंक्तियाँ और 1.6 GB से अधिक मेमोरी शामिल है, जो pandas पर पर्याप्त दबाव डालने के लिए काफी है। बेंचमार्क परीक्षणों का पूरा कोड इस DataLab वर्कबुक में पाया जा सकता है।
आइए डेटा आयात करते समय pandas 2.0 और polars के प्रदर्शन की तुलना से शुरू करें। Polars साफ़ तौर पर CSV से आयात में अपने मजबूत प्रदर्शन का दावा करता है। क्या यह सही साबित होता है?
हम एक परीक्षण करेंगे ताकि यह जाँचा जा सके कि pandas और polars को कॉलम्स और रो की एक उपसमुच्चय पढ़ने में कितना समय लगता है। उदाहरण के लिए, मान लें कि आप केवल फ्रांस कार्यालय की बिक्री का विश्लेषण करना चाहते हैं। pandas में, आपको सभी रो पढ़ने होंगे और फिर अनचाही रो हटाने के लिए फ़िल्टरिंग करनी होगी। इसके लिए हम बिल्कुल नए .query() मेथड का उपयोग करेंगे। pandas 2.0 के व्यवहार को परखने के लिए, हम CSV को पारंपरिक numpy इंजन और नए pyarrow इंजन, दोनों से आयात करेंगे।
इसके विपरीत, polars filter() मेथड प्रदान करता है जिसे कुछ शर्तों के साथ मिलाकर केवल आपकी रुचि वाली रो पढ़ने के लिए इस्तेमाल किया जा सकता है।
# pandas query
df_pd = pd.read_csv("./example.csv", engine="pyarrow")
df_pd = df_pd[['id', 'date', 'office', 'sales']]
df_pd = df_pd.query("office=='France'")
# polars filter
df_pl = pl.read_csv('example.csv').filter(
(pl.col('office') == 'France'))
df_pl.select(pl.col(['id', 'date', 'office', 'sales']))
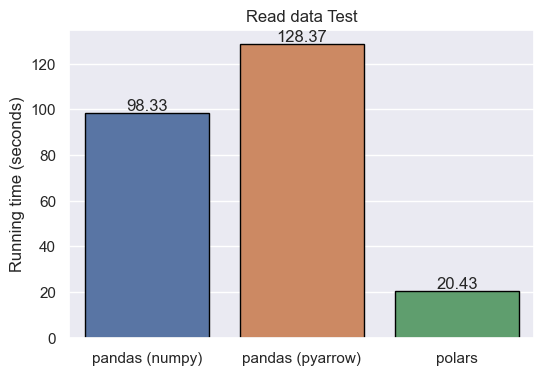
जब हम परीक्षण करते हैं, तो polars का प्रदर्शन pandas की तुलना में काफी बेहतर होता है, जैसा कि प्लॉट में दिखाया गया है। हैरानी की बात है कि pyarrow इंजन ने मानक numpy इंजन से बेहतर परिणाम नहीं दिए।
सिंटैक्स संगतता के संदर्भ में, polars का रूप-रंग स्पष्ट रूप से pandas जैसा है, pl.read_csv() जैसी फ़ंक्शन्स pandas का बेहतरीन प्रतिबिंब हैं। हालाँकि, दोनों लाइब्रेरीज़ अंदरूनी स्तर पर अलग ढंग से काम करती हैं, और इससे query() बनाम filter() मेथड्स की तरह सिंटैक्स में अंतर आना स्वाभाविक है।
Groupby ऑपरेशन्स समानांतरता के लिए उपयुक्त प्रत्याशी हैं। आइए देखें कि विभिन्न समेकित ऑपरेशन्स का अनुसरण करते हुए, कई समूहों में pandas और polars कैसे व्यवहार करते हैं। खास तौर पर, हम कार्यालय और महीने के आधार पर बिक्री का औसत और माध्यिका निकालेंगे।
df_pd.groupby([df_pd.office, df_pd.date.dt.month])['sales'].agg('mean') # pandas groupby mean
df_pl.groupby([pl.col('office'), pl.col('date').dt.month()]).agg([pl.mean('sales')]) # polars groupby mean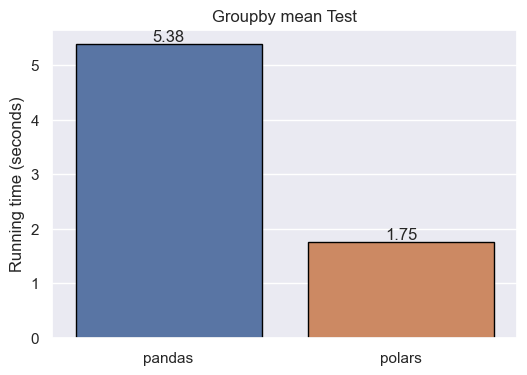
df_pd.groupby([df_pd.office, df_pd.date.dt.month])['sales'].agg('median') # pandas groupby median
df_pl.groupby([pl.col('office'), pl.col('date').dt.month()]).agg([pl.median('sales')]) pandas groupby median
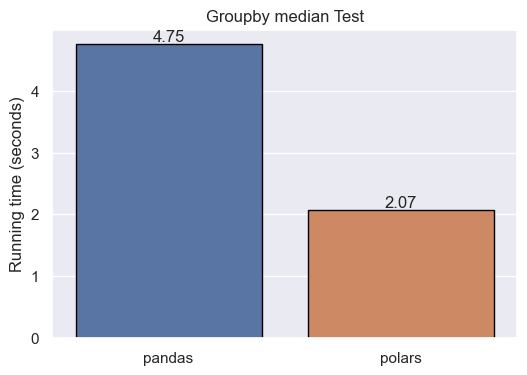
नतीजे बताते हैं कि group by और एग्रीगेशन गणनाओं में polars, pandas से बेहतर प्रदर्शन करता है। फिर भी, polars की सिंटैक्स pandas से मेल खाती है।
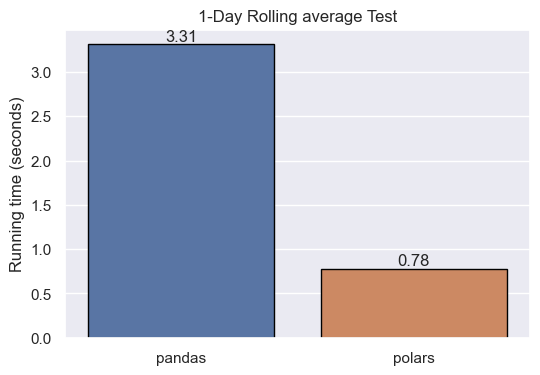
pandas और polars के प्रदर्शन को जाँचने के लिए एक और उपयुक्त ऑपरेशन है रोलिंग सांख्यिकी। इस तरह की गणना को अनुकूलित करने में पेचीदा एल्गोरिथ्मिक काम शामिल होता है। आइए देखें, दिन के आधार पर बिक्री का रोलिंग औसत निकालते समय वे कैसे व्यवहार करते हैं।
# pandas rolling mean
df_pd['sales'].rolling(1440, min_periods=1).mean()
# polars rolling mean
df_pl['sales'].rolling_mean(1440, min_periods=1)एक बार फिर, polars विजेता है। सिंटैक्स के संदर्भ में हल्का-सा अंतर ध्यान दें। polars में rolling_mean() मेथड शामिल है, जबकि pandas में rolling() मेथड आता है जिसे समान परिणाम देने के लिए mean() जैसे अन्य मेथड्स के साथ संयोजित करना पड़ता है।
किसी विशेष परिघटना का विश्लेषण करने के लिए पूरी जनसंख्या का अध्ययन करना सामान्यतः संभव नहीं होता। इसलिए सांख्यिकी और डेटा साइंस में सैंपलिंग सबसे आम कार्यों में से एक है। इसमें Monte Carlo Simulation तकनीकों, जैसे बूटस्ट्रैपिंग और परमीटेशन, का उपयोग करते हुए रैंडम सैंपल्स लेना शामिल है। हालाँकि, इस ऑपरेशन में बड़ी मात्रा में वेरिएबल कॉपी करना भी पड़ता है, जो पर्याप्त कंप्यूटिंग संसाधन न होने पर चुनौती बन सकता है।
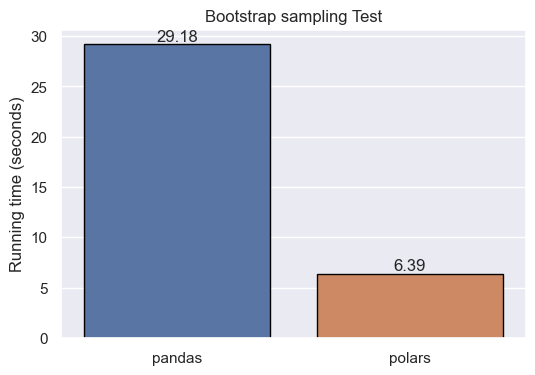
आइए देखें, बूटस्ट्रैप—यानी, रिप्लेसमेंट के साथ री-सैंपलिंग—करते समय pandas और polars कैसे काम करते हैं। हम 1000 डेटा पॉइंट्स वाले 10000 सैंपल्स में बिक्री का औसत आँकेंगे।
#pandas bootstrap
simu_weights = []
for i in range(10000):
bootstrap_sample = random.choices(df_pd['sales'], k=1000)
simu_weights.append(np.nanmean(bootstrap_sample))
#polars bootstrap
simu_weights = []
for i in range(10000):
bootstrap_sample = df_pl['sales'].sample(n=1000,with_replacement=True)
simu_weights.append(bootstrap_sample.mean())बूटस्ट्रैप सैंपलिंग करते समय, polars लगभग 5 गुना तेज़ है pandas से।
सिंटैक्स के संदर्भ में, जहाँ pandas सैंपलिंग ऑपरेशन्स के लिए numpy पर निर्भर करता है, वहीं polars अपने अंतर्निर्मित, उपयोगी sample() मेथड के साथ आता है।
अंतिम परीक्षण के लिए, हम परस्पर जुड़े डेटा मैनिप्युलेशन्स की एक शृंखला करेंगे। यह डेटा प्रोफेशनल्स के रोज़मर्रा के काम का हिस्सा है। फिर भी, कई चरणों वाले डेटा ऑपरेशन्स को कंप्यूटेशनली उप-इष्टतम तरीके से लिख देना आसान होता है।
मान लें कि काल्पनिक कंपनी का इटली कार्यालय 2022 के इंटर्न्स में से कुछ को उनके प्रशिक्षण काल के अंत के बाद नियुक्त करने पर विचार कर रहा है। हमारा उद्देश्य यह विश्लेषण करना है कि 2022 में सबसे बड़ी दस बिक्री किस इंटर्न्स ने कीं, ताकि हम इस जानकारी का उपयोग सबसे उपयुक्त उम्मीदवारों का चयन करने में कर सकें।
इसके लिए, हमें अपने डेटासेट को “italy_2022” नामक दूसरे डेटासेट से जोड़ना होगा, जिसमें 2022 में प्रत्येक लेन-देन किस व्यक्ति ने किया, इसकी जानकारी है। “id” कॉलम दोनों डेटासेट्स का साझा कॉलम है।
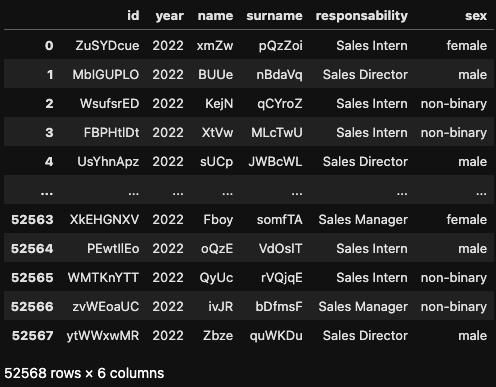
# pandas compound operations
df_pd.merge(italy_2022, on='id').query("responsibility =='Sales Intern'").sort_values('sales', ascending=False).head(10)[['name','surname','sales','sex']]
#polars compound manipulations
df_pl.join(italy_2022_pl, on="id").filter(pl.col('responsability') == 'Sales Intern').sort('sales',descending=True).head(10).select(pl.col(['name','surname','sales','sex']))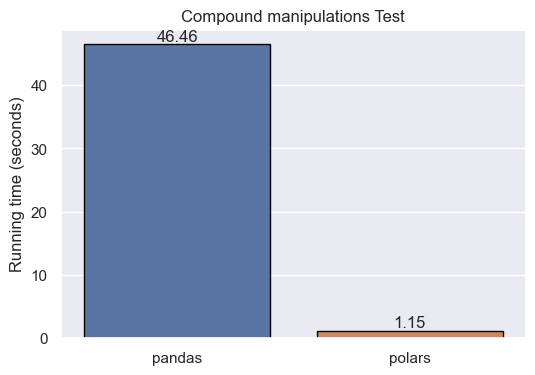
जैसा कि पिछले सभी परीक्षणों में हुआ, प्रदर्शन के मामले में polars, pandas को मात देता है। इस परीक्षण में, जॉइन ऑपरेशन pandas के लिए सबसे बड़ी चुनौती प्रतीत होता है। इसके विपरीत, polars कहीं अधिक कुशल है और सभी चेन किए गए कार्यों को पूरा करने में दो सेकंड से भी कम समय लेता है।
हमने ऊपर दिए गए परीक्षणों को एक तालिका में संक्षेपित किया है ताकि त्वरित तुलना दिखाई जा सके:
|
टेस्ट |
Pandas 2.0 |
Polars |
विजेता |
सिंटैक्स समानता |
|
आयात परीक्षण |
सभी रो पढ़ना और फिर .query() मेथड से अनचाही रो को फ़िल्टर करना |
filter() मेथड से सीधे केवल रुचि वाली रो पढ़ना |
Polars (बेहतर प्रदर्शन) |
समान, पर अंतर्निहित इम्प्लिमेंटेशन के कारण अंतर (.query() बनाम filter()) |
|
ग्रुप बाय परीक्षण |
कार्यालय और महीने के आधार पर बिक्री के औसत और माध्यिका जैसी एग्रीगेशन के लिए .groupby() का उपयोग |
pandas जैसा ही, लेकिन बेहतर प्रदर्शन के साथ |
Polars (बेहतर प्रदर्शन) |
समान |
|
रोलिंग सांख्यिकी परीक्षण |
रोलिंग औसत गणना के लिए rolling() मेथड को mean() जैसे अन्य मेथड्स के साथ मिलाकर उपयोग |
रोलिंग औसत गणना के लिए rolling_mean() मेथड का उपयोग |
Polars (बेहतर प्रदर्शन) |
समान, पर हल्के अंतर (.rolling().mean() बनाम rolling_mean()) |
|
सैंपलिंग परीक्षण |
बूटस्ट्रैप सैंपलिंग ऑपरेशन्स के लिए numpy का उपयोग |
बूटस्ट्रैप सैंपलिंग ऑपरेशन्स के लिए अंतर्निर्मित sample() मेथड का उपयोग |
Polars (लगभग 5 गुना तेज़) |
भिन्न—pandas numpy पर निर्भर, जबकि polars में अंतर्निर्मित मेथड्स हैं |
|
यौगिक मैनिप्युलेशन्स परीक्षण |
दूसरे डेटासेट के साथ जॉइन करना और फिर डेटा को सॉर्ट व चयन करना |
उसी कार्यों को अधिक कुशलता से करना |
Polars (काफी तेज़) |
समान, पर हल्के अंतर (merge().query().sort_values().head() बनाम join().filter().sort().head().select()) |
इस ट्यूटोरियल के अंत तक पहुँचने पर बधाई। परीक्षणों के अनुसार, लगभग सभी परीक्षणों में polars का प्रदर्शन pandas 2.0 से काफी बेहतर है। यद्यपि यह उसके प्रभुत्व के लिए वास्तविक खतरा है, फिर भी डेटा मैनिप्युलेशन के लिए Python में pandas अब भी पहला विकल्प होने का लाभ उठाता है, और इस प्रकार बड़ी यूज़र कम्युनिटी के सभी फ़ायदों का आनंद लेता है।
यदि आप बड़े डेटासेट्स के साथ काम कर रहे हैं, तो प्रदर्शन बढ़ाना ज़रूरी है। DataCamp आपकी मदद के लिए तैयार है। यहाँ कुछ कोर्सेज़ की सूची है जो आपकी कंप्यूटिंग परफॉर्मेंस को अगले स्तर तक ले जाने में सहायक हो सकते हैं:

मैं एक स्वतंत्र डेटा विश्लेषक हूँ और दुनिया भर की कंपनियों व संगठनों के साथ डेटा साइंस परियोजनाओं पर सहयोग करता/करती हूँ। मैं 2+ वर्षों के अनुभव वाला/वाली डेटा साइंस प्रशिक्षक भी हूँ। मैं नियमित रूप से अंग्रेज़ी और स्पेनिश में डेटा साइंस से संबंधित लेख लिखता/लिखती हूँ, जिनमें से कुछ DataCamp, Towards Data Science और Analytics Vidhya जैसी स्थापित वेबसाइटों पर प्रकाशित हुए हैं। राजनीतिक विज्ञान और क़ानून की पृष्ठभूमि वाले/वाली डेटा वैज्ञानिक के रूप में, मेरा लक्ष्य लोक नीति, क़ानून और प्रौद्योगिकी के संगम पर काम करना है—विचारों की शक्ति का उपयोग करके ऐसे अभिनव समाधान और कथाएँ विकसित करना जो हमें तात्कालिक चुनौतियों, विशेषकर जलवायु संकट, से निपटने में मदद कर सकें। मैं स्वयं-अध्येता, सतत सीखने वाला/वाली और बहुविषयक दृष्टिकोण का प्रबल समर्थक/समर्थक हूँ। नई चीज़ें सीखने में कभी देर नहीं होती।

