
什么是专家混合(MoE)?
可以把一个 AI 模型想象成一个由各类专才组成的团队,每个人都有自己的拿手领域。专家混合(MoE)模型正是基于这一理念,将复杂任务分配给更小、更专门化的网络,这些网络被称为“专家”。
每位专家专注于问题的某个方面,使模型能够更高效、更准确地完成任务。这就像看病找医生、修车找技师、烹饪找大厨——各施其长。
通过协作,这些专家能比单一的通才更有效地解决更广泛的问题。
请先看看下面的示意图——我们稍后会进行讲解。
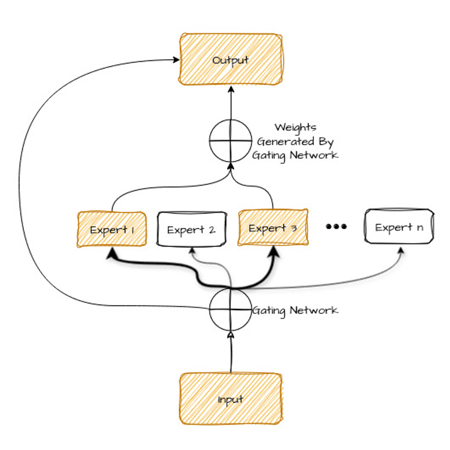
我们来拆解一下这张图的组成部分:
- 输入: 即您希望 AI 处理的问题或数据。
- 专家: 这些是更小的 AI 模型,每个都在整体问题的某一部分上训练得很擅长。可以把它们视为团队中的不同专才。
- 门控网络: 类似一位经理,决定哪个专家最适合处理问题的哪一部分。它查看输入并判断该分配给谁。
- 输出: 专家完成工作后,AI 模型给出的最终答案或解决方案。
使用 MoE 的优势包括:
- 高效: 只启用擅长处理特定部分问题的专家,从而节省时间和算力。
- 灵活: 您可以轻松添加更多专家或调整其专长,使系统能够适配不同问题。
- 更佳结果: 由于每位专家都专注于自己的强项,整体解决方案通常更准确、更可靠。
下面我们来具体了解专家网络和门控网络。
专家网络
在 MoE 模型中,“专家网络”就像一个专家团队。与其让一个 AI 模型包打天下,不如让每位专家聚焦于某类任务或数据。
在 MoE 中,这些专家类似于独立的神经网络,分别在不同数据集或任务上进行训练。
它们被设计为稀疏的,也就是说,同一时间只会根据输入特点激活少数几个。这可以避免系统超载,并确保最相关的专家参与解决问题。
但模型如何知道要选哪些专家?这就需要门控网络出场了。
门控网络
门控网络(也称为路由器)是另一类神经网络,它学会分析输入数据(如待翻译的句子),并确定哪些专家最适合处理。
其方法是根据输入特征为每位专家分配一个“权重”或重要性分数。权重最高的专家随后被选中来处理数据。
门控网络有多种选择合适专家的方式(称为“路由算法”)。常见的有:
- Top-k 路由: 最简单的方法。门控网络挑选亲和度分数最高的前 k 个专家,并将输入数据发送给他们。
- 专家自选路由: 在这种方法中,不是由数据来选择专家,而是专家来决定自己最擅长处理哪些数据。该策略旨在实现最佳负载均衡,并提供多样的数据到专家映射方式。
- 稀疏路由: 这种方法对每条数据只激活少数专家,形成稀疏网络。与每条数据都激活全部专家的致密路由相比,稀疏路由使用更少的算力。
在进行预测的过程中,模型会按照分配任务时的相同流程,将各位专家的输出进行组合。对于单个任务,可能需要不止一位专家,具体取决于问题的复杂度与多样性。
现在,我们来了解一下 MoE 的工作方式。
专家混合(MoE)如何工作
MoE 的运行分为两个阶段:
- 训练阶段
- 推理阶段
训练阶段
与其他机器学习模型类似,MoE 从在数据集上训练开始。不过,训练并非作用于整个模型,而是分别对其组成部分进行。
专家训练
MoE 框架的每个组件都会在特定的数据子集或任务上进行训练。目标是让每个组件聚焦于更大问题的某个方面。
这种聚焦通过为每个组件提供与其指派任务相关的数据来实现。比如,在语言处理任务中,一个组件可能专注于句法,另一个则专注于语义。
每个组件的训练都遵循标准的神经网络训练流程,即让模型在其对应的数据子集上最小化损失函数。
门控网络训练
门控网络负责学习如何为给定输入选择最合适的专家。
在训练门控网络时,它会与专家网络同步训练。门控网络接收与专家相同的输入,并学习对各位专家输出一个概率分布。该分布表示哪位专家最适合处理当前输入。
门控网络的训练通常采用同时考虑门控网络准确性和被选专家表现的优化方法。
联合训练
在联合训练阶段,整个 MoE 系统,即专家模型与门控网络,一同训练。
这种策略确保门控网络与专家能够协同优化。联合训练中的损失函数会将各专家与门控网络的损失结合起来,促进协作式的优化。
随后将合并后的损失梯度同时反向传播至门控网络与专家模型,以提升 MoE 系统的整体性能。
推理阶段
推理是通过将门控网络提供的上下文与专家输出相结合来生成结果。在 MoE 中,此过程旨在尽量降低推理成本。
输入路由
在 MoE 语境下,门控网络在决定哪些模型应处理特定输入方面至关重要。
门控网络接收输入后,会对所有模型生成一个概率分布。该分布据此将输入导向最合适的模型,利用训练阶段学到的模式。这样可以确保每项任务都能用到恰当的专长,从而优化决策过程。
专家选择
只有少数几个模型(通常为一到数个)会被选中来处理每个输入。此选择由门控网络分配的概率决定。
为每个输入只选择有限数量的模型,有助于高效利用算力资源,同时仍能受益于 MoE 框架中的专门知识。
门控网络的输出确保所选模型最适合处理该输入,从而提升系统的整体效率与性能。
输出合并
推理过程的最后一步是将所选模型的输出进行合并。
这种合并通常通过加权平均来实现,权重反映了门控网络分配的概率。在某些场景中,也可能采用投票或学习得到的组合技术来合并专家输出。目的在于将所选模型的多样化见解整合为统一且准确的最终预测,最大化 MoE 架构的优势。
随着技术的快速发展,人们对快速、高效、优化的大模型处理技术需求日益增长。MoE 正在成为一条有前景的路径。那么,MoE 还有哪些益处?
专家混合(MoE)的优势
专家混合(MoE)架构具有多项优势:
- 性能: 通过仅选择与任务相关的专家参与,MoE 模型避免不必要的计算,从而提升速度并降低资源消耗。
- 灵活性: 专家的多样能力使 MoE 模型高度灵活。通过调用具备专门能力的专家,MoE 模型能在更广泛的任务中取得成功。
- 容错性: MoE 的“分而治之”方式将任务分别执行,增强了模型对故障的韧性。若某位专家出现问题,不一定会影响整个模型的功能。
- 可扩展性:将复杂问题分解为更小、更易管理的任务,有助于 MoE 模型应对日益复杂的输入。
专家混合(MoE)的应用
MoE 已经存在 30 年之久,因此在机器学习的不同领域被广泛采用。
自然语言处理(NLP)
MoE为训练大型模型提供了一种独特路径,兼具更高效率、更快的预训练速度和有竞争力的推理速度。
在传统的致密模型中,所有参数都会用于所有输入;而稀疏性允许模型根据输入仅运行系统的特定部分,从而显著降低计算量。
一个示例是微软的翻译 API,Z-code。Z-code 中的 MoE 架构支持庞大的模型参数规模,同时保持计算量不变。
计算机视觉
Google 的 V-MoE,一种基于视觉Transformer(ViT)的稀疏架构,展示了 MoE 在计算机视觉任务中的有效性。
通过将图像划分为更小的 patch 并输入至门控/路由层,V-MoE 能够为每个 patch 动态选择最合适的专家,同时优化准确性与效率。
这种方法的一个显著优势是其灵活性:无需对模型权重进行进一步训练,您就可以减少每个 token 所选专家的数量,以节省时间和算力。
推荐系统
MoE 也成功应用于推荐系统。例如,Google 的研究人员为 YouTube 视频推荐提出了一种基于 MMoE(多门控专家混合)的排序系统。
他们首先将任务目标分为两类:参与度与满意度。给定召回步骤得到的候选视频列表,排序系统使用候选、用户和上下文特征来学习预测这两类用户行为对应的概率。
需要注意的是,他们并未将 MoE 层直接应用于输入,因为输入的高维性会带来显著的模型训练与在线服务成本。
MoE 已在业界被大规模采用,服务于多种应用。其学习过程将任务划分为合适的子任务,每个子任务都可由非常简单的专家网络解决。这一能力意味着训练可并行化且推理快速,使 MoE 对大型系统颇具吸引力。
专家混合(MoE):挑战
在涉及多台机器的高吞吐场景中,专家尤其有利。在固定的预训练算力预算下,稀疏模型可能更高效。
然而,稀疏模型在执行时需要大量内存,因为所有专家都需要常驻内存。在显存有限的系统中,这可能是个重要限制,模型可能难以运作。
我们再来看 MoE 的其他局限。
训练复杂度
训练 MoE 模型比训练单一模型更为复杂,原因包括:
- 协同: 需要门控网络学会将输入正确路由至合适的专家,同时每位专家又分别在不同数据部分上特化,平衡起来并不容易。
- 优化: 联合训练所用的损失函数必须在专家表现与门控网络表现之间取得平衡,增加了优化难度。
- 超参数调优: MoE 模型包含更多超参数,例如专家数量与门控网络架构。调优过程既耗时又复杂。
推理效率
MoE 模型的推理效率可能受到多方面影响:
- 门控网络: 对每个输入都需运行门控网络来确定合适专家,这会增加额外计算。
- 专家选择与激活: 即便每个输入只激活少数专家,进行选择与激活的开销仍可能增加推理时延。
- 并行性: 并行运行多个专家可能具有挑战,尤其在算力有限的环境中。高效并行需要更先进的调度与资源管理。
模型规模增大
由于包含多个专家,MoE 模型往往比单一模型更大:
- 存储需求: 需要存储多个专家网络和门控网络,总体存储需求上升,这在存储受限环境中是个缺点。
- 内存占用: 训练与推理时需要更多内存,因为必须同时加载并维持多个模型在内存中。这在资源受限场景下会带来困难。
- 部署挑战: 由于规模与复杂度更高,MoE 模型的部署更为困难。要在各类平台(包括边缘设备)上高效部署,可能需要额外的优化与工程投入。
结语
本文探讨了专家混合(MoE)技术,这是一种用于扩展神经网络以处理复杂任务与多样数据的精巧方法。MoE 通过多个专门化专家与门控网络对输入进行有效路由。
我们覆盖了 MoE 的核心组成部分,包括专家网络与门控网络,并讨论了其训练与推理流程。
我们还强调了性能提升、可扩展性与适应性等优势,以及在自然语言处理、计算机视觉与推荐系统中的应用。
尽管在训练复杂度与模型规模方面存在挑战,MoE 依然为推动 AI 能力发展提供了颇具前景的途径。

训练大型语言模型(LLM)往往需要大量计算资源,这对许多组织和研究者来说是一个门槛。
为了解决这一挑战,专家混合(MoE)技术将大型模型拆分为更小的、专门化的网络。
MoE 的概念源自 1991 年论文Adaptive Mixture of Local Experts。此后,MoE 被应用于多万亿参数的模型,如开源的 1.6 万亿参数 Switch Transformer。
本文将深入解析 MoE,包括其应用、优势与挑战。