

什么是 Llama.cpp?
Llama.cpp 由 Georgi Gerganov 开发。它以高效的 C/C++ 实现了 Meta 的 LLaMa 架构,是 LLM 推理领域最活跃的开源社区之一:在官方 GitHub 仓库中拥有 900 多位贡献者、超过 69000 颗星标和 2600+ 次发布。
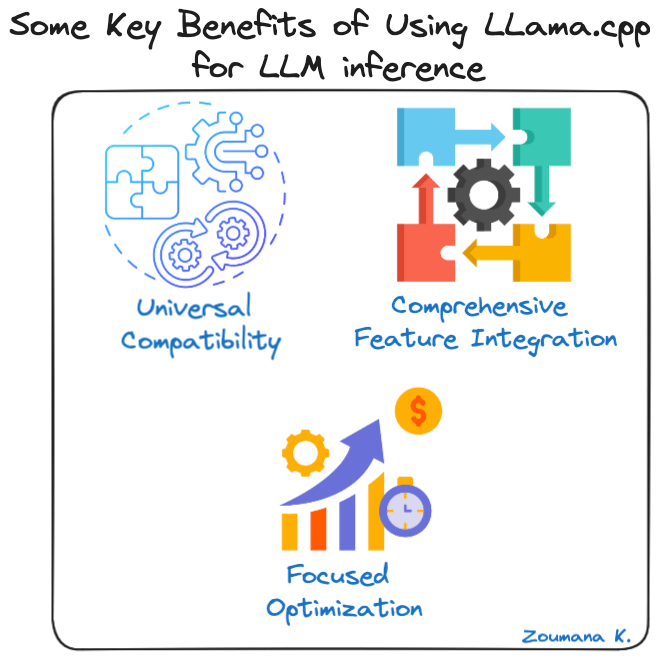
在 LLM 推理中使用 LLama.cpp 的一些关键优势
- 通用兼容性:Llama.cpp 作为一个“CPU 优先”的 C++ 库,设计上更少复杂性,并能与其他编程环境无缝集成。这种广泛的兼容性加速了其在各平台的采用。
- 全面的功能整合:作为关键底层特性的“仓库”,Llama.cpp 在高层能力上与 LangChain 的思路相呼应,从而简化开发流程,但未来在可扩展性上可能面临挑战。
- 聚焦优化:Llama.cpp 专注于单一模型架构,使改进能够更精准、更有效。其通过 GGML、GGUF 等格式对 Llama 模型的持续投入带来了显著的效率提升。
了解了 Llama.cpp 之后,教程接下来的部分将带您完成一个文本生成用例的实现过程。我们先从 LLaMa.cpp 的基础入手,理解项目的端到端工作流程,并分析其在不同行业中的部分应用。
Llama.cpp 架构
Llama.cpp 的骨干是原始的 Llama 模型,同样基于 Transformer 架构。Llama 的作者吸收并采用了随后在诸如 PaLM 等不同模型中提出的多项改进。
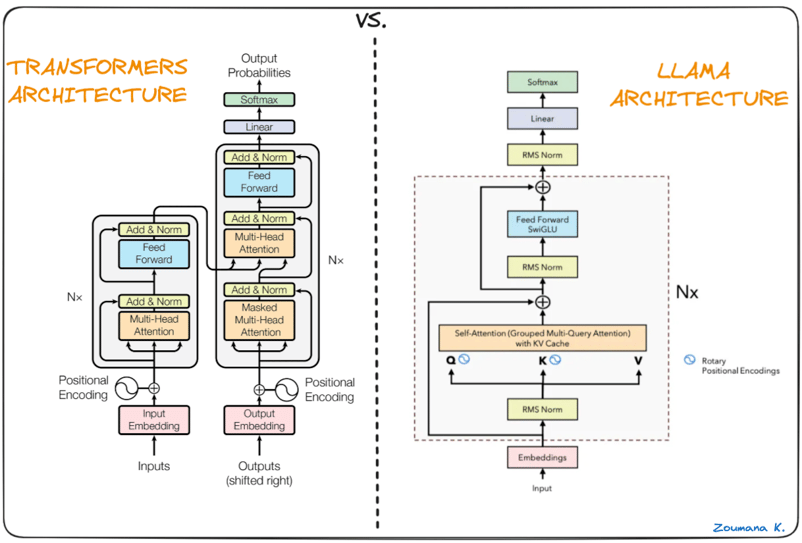
Transformers 与 Llama 架构的差异(Llama 架构作者:Umar Jamil)
LLaMa 架构与 Transformer 的主要差异在于:
- 预归一化(GPT-3):使用 RMSNorm 对每个 Transformer 子层的输入进行归一化,以提升训练稳定性,而非对输出归一化。
- SwiGLU 激活函数(PaLM):用 SwiGLU 取代原始的 ReLU 非线性激活函数,从而带来性能提升。
- 旋转位置嵌入(GPTNeo):移除绝对位置嵌入后,在网络的每一层加入旋转位置嵌入(RoPE)。
环境搭建
开始使用 LLama.cpp 的前置条件包括:
Python:便于运行 Python 包管理器 pipLlama-cpp-python:llama.cpp 的 Python 绑定
创建虚拟环境
建议创建一个虚拟环境,以避免安装过程中的各种问题;conda 是不错的环境管理工具选择。
本节所有命令均在终端中运行。使用 conda create 命令创建名为 llama-cpp-env 的虚拟环境。
conda create --name llama-cpp-env成功创建虚拟环境后,使用 conda activate 命令激活该环境,如下所示:
conda activate llama-cpp-env上述命令应会在终端开头用括号显示环境名称,如下:
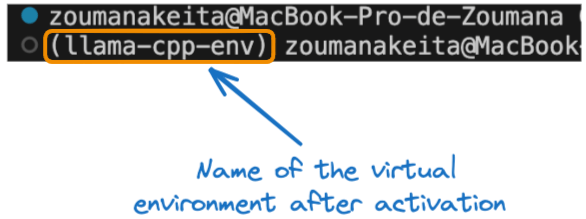
激活后显示的虚拟环境名称
现在,我们可以按如下方式安装 llama-cpp-python 包:
pip install llama-cpp-python
or
pip install llama-cpp-python==0.1.48成功执行 llama_cpp_script.py 意味着库已正确安装。
为确保安装成功,我们来创建并添加 import 语句,然后执行脚本。
- 首先,将
from llama_cpp import Llama添加到llama_cpp_script.py文件中,然后 - 运行 Python 脚本
llama_cpp_script.py。如果库导入失败,会抛出错误;此时需要进一步检查安装过程。
了解 Llama.cpp 基础
至此,安装应已完成。接下来让我们深入理解 LLama.cpp 的基础知识。
上文导入的 Llama 类是使用 Llama.cpp 时的主要构造器,它接受多个参数(不止以下列出)。完整参数列表见官方文档:
model_path:所使用的 Llama 模型文件路径prompt:输入给模型的提示词。该文本会被分词并传入模型。device:用于运行 Llama 模型的设备,可为 CPU 或 GPU。max_tokens:模型响应中要生成的最大 token 数stop:一组字符串,命中任一即会停止生成过程temperature:取值范围为 0 到 1。值越低,结果越确定;值越高,随机性越强,输出也更丰富、更具创造性。top_p:用于控制预测的多样性,即选择累计概率超过阈值的最可能 token。从 0 开始,值越高越可能得到更优输出,但需要更多计算。echo:布尔值,决定模型是否在开头包含原始提示词(True 为包含,False 为不包含)
例如,假设我们要使用一个名为 <MY_AWESOME_MODEL> 的大型语言模型,存放在当前工作目录。实例化过程如下:
# Instanciate the model
my_aweseome_llama_model = Llama(model_path="./MY_AWESOME_MODEL")
prompt = "This is a prompt"
max_tokens = 100
temperature = 0.3
top_p = 0.1
echo = True
stop = ["Q", "\n"]
# Define the parameters
model_output = my_aweseome_llama_model(
prompt,
max_tokens=max_tokens,
temperature=temperature,
top_p=top_p,
echo=echo,
stop=stop,
)
final_result = model_output["choices"][0]["text"].strip()上述代码不言自明,可结合前面的要点理解各参数的含义。
模型的结果是一个字典,包含生成的响应及一些附加元数据。其输出格式将在下文进一步探讨。
您的第一个 Llama.cpp 项目
现在,是时候开始实现这个文本生成项目了。新建一个 Llama.cpp 项目并不复杂,只需遵循上面的 Python 代码模板,从加载目标大语言模型到生成最终响应的步骤一应俱全。
该项目使用来自 Hugging Face 的 Zephyr-7B-Beta 的 GGUF 版本。它是在 mistralai/Mistral-7B-v0.1 基础上微调的模型,训练数据为公开可用与合成数据集的混合,并采用了直接偏好优化(DPO)方法。
我们的Transformer 与 Hugging Face 入门教程可帮助您更好地理解 Transformer,并学会将其用于解决实际问题。我们也提供了Mistral 7B 教程。
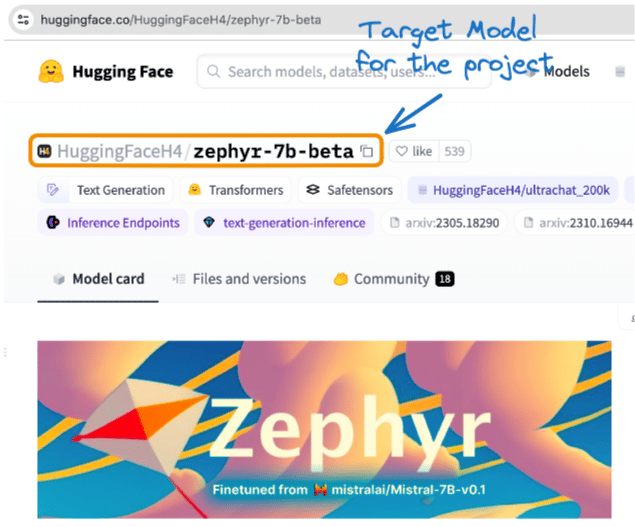
来自 Hugging Face 的 Zephyr 模型(来源)
将模型下载到本地后,可将其移动到项目位置的 model 文件夹。在开始实现之前,先了解一下项目结构:
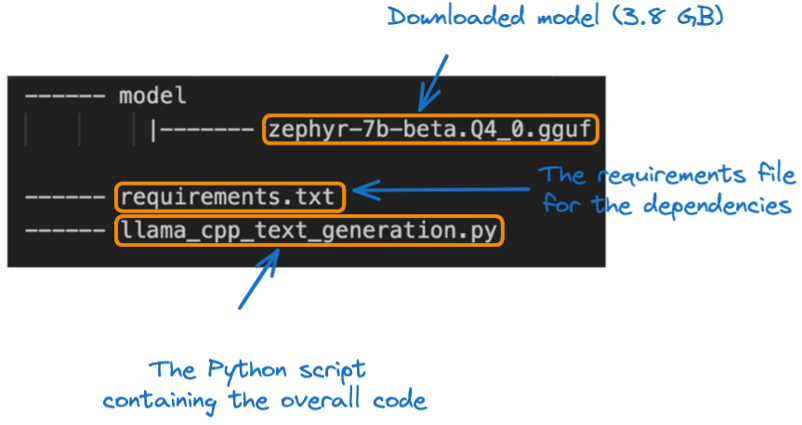
项目结构
第一步是使用 Llama 构造器加载模型。由于这是一个较大的模型,务必指定要加载的最大上下文长度。在本项目中,我们使用 512 个 token。
from llama_cpp import Llama
# GLOBAL VARIABLES
my_model_path = "./model/zephyr-7b-beta.Q4_0.gguf"
CONTEXT_SIZE = 512
# LOAD THE MODEL
zephyr_model = Llama(model_path=my_model_path,
n_ctx=CONTEXT_SIZE)模型加载完成后,下一步是文本生成阶段。我们沿用原始的代码模板,但通过一个名为 generate_text_from_prompt 的辅助函数来调用。
def generate_text_from_prompt(user_prompt,
max_tokens = 100,
temperature = 0.3,
top_p = 0.1,
echo = True,
stop = ["Q", "\n"]):
# Define the parameters
model_output = zephyr_model(
user_prompt,
max_tokens=max_tokens,
temperature=temperature,
top_p=top_p,
echo=echo,
stop=stop,
)
return model_output在 __main__ 判断中,可使用给定的提示词来执行该函数。
if __name__ == "__main__":
my_prompt = "What do you think about the inclusion policies in Tech companies?"
zephyr_model_response = generate_text_from_prompt(my_prompt)
print(zephyr_model_response)模型响应如下所示:
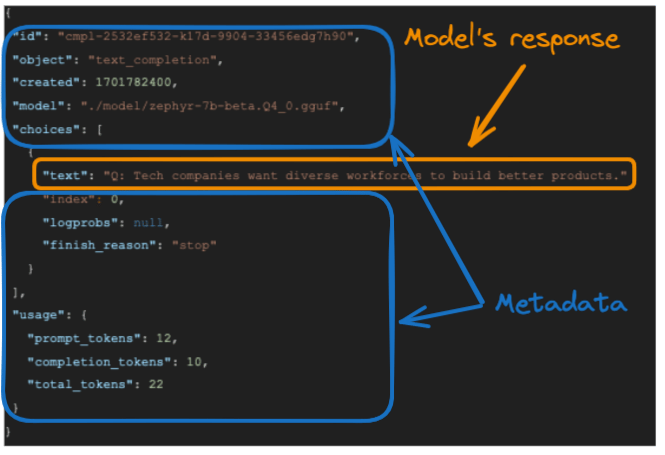
模型响应
模型生成的响应为 <What do you think about the inclusion policies in Tech companies?>,模型的实际回答部分已在橙色框中高亮。
- 原始提示词包含 12 个 token
- 响应(补全)包含 10 个 token,
- 总 token 数为两者之和,共 22
尽管完整输出对于后续用途很有价值,但有时我们只关心模型的文本回答。可通过选择 “choices” 元素中的 “text” 字段来格式化响应,如下:
final_result = model_output["choices"][0]["text"].strip()
strip() 函数用于移除字符串首尾的空白字符,得到的结果为:
Tech companies want diverse workforces to build better products.Llama.CPP 的真实应用
本节将以一个真实应用场景为例,介绍所面临的问题、可能的解决方案以及使用 Llama.cpp 的优势。
问题
设想 ETP4Africa 是一家科技初创公司,他们的教育应用需要一套能够在多种设备上高效运行、且不会带来延迟的语言模型。
使用 Llama.cpp 的解决方案
他们采用 Llama.cpp,利用其对 CPU 的优化性能,以及与其基于 Go 的后端进行接口对接的能力。
收益
- 可移植性与速度:Llama.cpp 设计轻量,响应迅速,并兼容多种设备。
- 可定制化:可定制的底层特性使应用能够提供高效的实时编码辅助。
集成 Llama.cpp 之后,ETP4Africa 的应用可以提供即时、交互式的编程指导,提升用户体验与参与度。
数据工程是任何数据科学与 AI 项目的关键组成部分,我们的教程面向数据工程与数据应用的 LangChain 入门提供了在数据管道与应用中引入大语言模型 AI 的完整指南。
结语
总之,本文全面介绍了使用 LLama.cpp 搭建并利用大型语言模型的流程。
文中提供了详细的步骤,帮助您理解 Llama.cpp 的基础、搭建工作环境、安装所需库,并实现一个文本生成(问答)用例。
最后,我们结合真实应用给出了实践见解,说明如何使用 Llama.cpp 高效解决底层问题。
准备更深入探索大语言模型的世界了吗?通过我们面向 AI 专业人士常用的强大深度学习框架 LangChain 与 Pytorch 的教程,提升您的技能:如何使用 LangChain 构建 LLM 应用与如何使用 PyTorch 训练 LLM。
常见问题解答
Llama.cpp 与其他轻量级 LLM 框架有何不同?
Llama.cpp 专为 CPU 使用场景优化,这一点使其有别于可能严重依赖 GPU 加速的其他框架。这使其非常适合硬件资源受限的环境。
高效运行 Llama.cpp 的系统要求是什么?
虽然 Llama.cpp 旨在轻量化,但在更大的模型上运行时,拥有现代多核 CPU 与充足的内存仍然会带来收益。具体需求取决于您所使用的模型规模。
Llama.cpp 是否能与除 Python 之外的其他编程语言集成?
可以。Llama.cpp 作为 C++ 库的设计使其能够集成到 Python 之外的其他编程环境中,但每种语言都需要相应的绑定实现。
在 Llama 模型中提到的 GGML 与 GGUF 格式是什么?
GGML(Georgi Gerganov Model Language)和 GGUF 是用于高效存储 Llama 模型的格式,重点在于降低存储体积并提升加载速度。
Llama.cpp 如何跟进 LLaMa 模型的更新与改进?
开源社区在积极维护 Llama.cpp,确保其及时纳入 LLaMa 模型的最新进展与优化,从而提升效率与性能。
使用 Llama.cpp 是否存在局限或已知问题?
与任何软件一样,Llama.cpp 也可能存在局限性,尤其是在超大模型或复杂工作流上的可扩展性方面。此外,因其针对 CPU 优化,在某些任务中的性能可能不及基于 GPU 的方案。
temperature 参数如何影响 Llama.cpp 的输出?
参数 temperature 会影响模型响应的随机性。较低取值会使输出更确定,而较高取值会引入更多变化,这在创意类应用中很有用。

一位多才多艺、乐于分享知识并回馈他人的数据科学家。Zoumana 是 YouTube 内容创作者,也是 Medium 上的顶尖科技写作者。他热爱演讲、编程与教学。Zoumana 拥有两个硕士学位:其一是在法国巴黎获得的计算机科学硕士,专注于机器学习;其二是在美国德州理工大学获得的数据科学硕士。他的职业生涯始于法国 Groupe OPEN 的软件开发工程师,随后加入 IBM 担任机器学习顾问,为保险公司构建端到端的 AI 解决方案。之后,Zoumana 加入了 Axionable——一家总部位于巴黎与蒙特利尔的首家“可持续 AI”初创公司。在那里,他担任数据科学家,为来自法国、蒙特利尔、新加坡和瑞士的客户交付 AI 产品,主要聚焦 NLP 场景。此外,他将 5% 的时间投入到研发工作。目前,他在 IFC(世界银行集团)担任高级数据科学家。
大型语言模型(LLM)正在重塑各行各业。从客服聊天机器人到复杂的数据分析工具,这一强大技术的能力正在改变数字交互与自动化的格局。
然而,LLM 的落地应用常常受制于高性能计算资源或对快速响应时间的需求。这些模型通常需要复杂的硬件与大量依赖项,使其在资源受限的环境中难以采用。
这正是 LLaMa.cpp(或 LLaMa C++)大显身手之处,它为重量级框架提供了更轻量、更可移植的替代方案。
Llama.cpp 标志(来源)