
Last chance! 50% off DataCamp Premium
Sale ends in
MiniMax M3 is MiniMax’ nieuwste open-weight model voor coderen, toolgebruik en agent-workflows met lange horizon. Wat het onderscheidt van eerdere MiniMax-modellen is de combinatie van een contextvenster van 1M tokens, native multimodale ondersteuning voor tekst, afbeeldingen en video, en MiniMax Sparse Attention, dat is ontworpen om inferentie met een zeer lange context praktischer te maken.
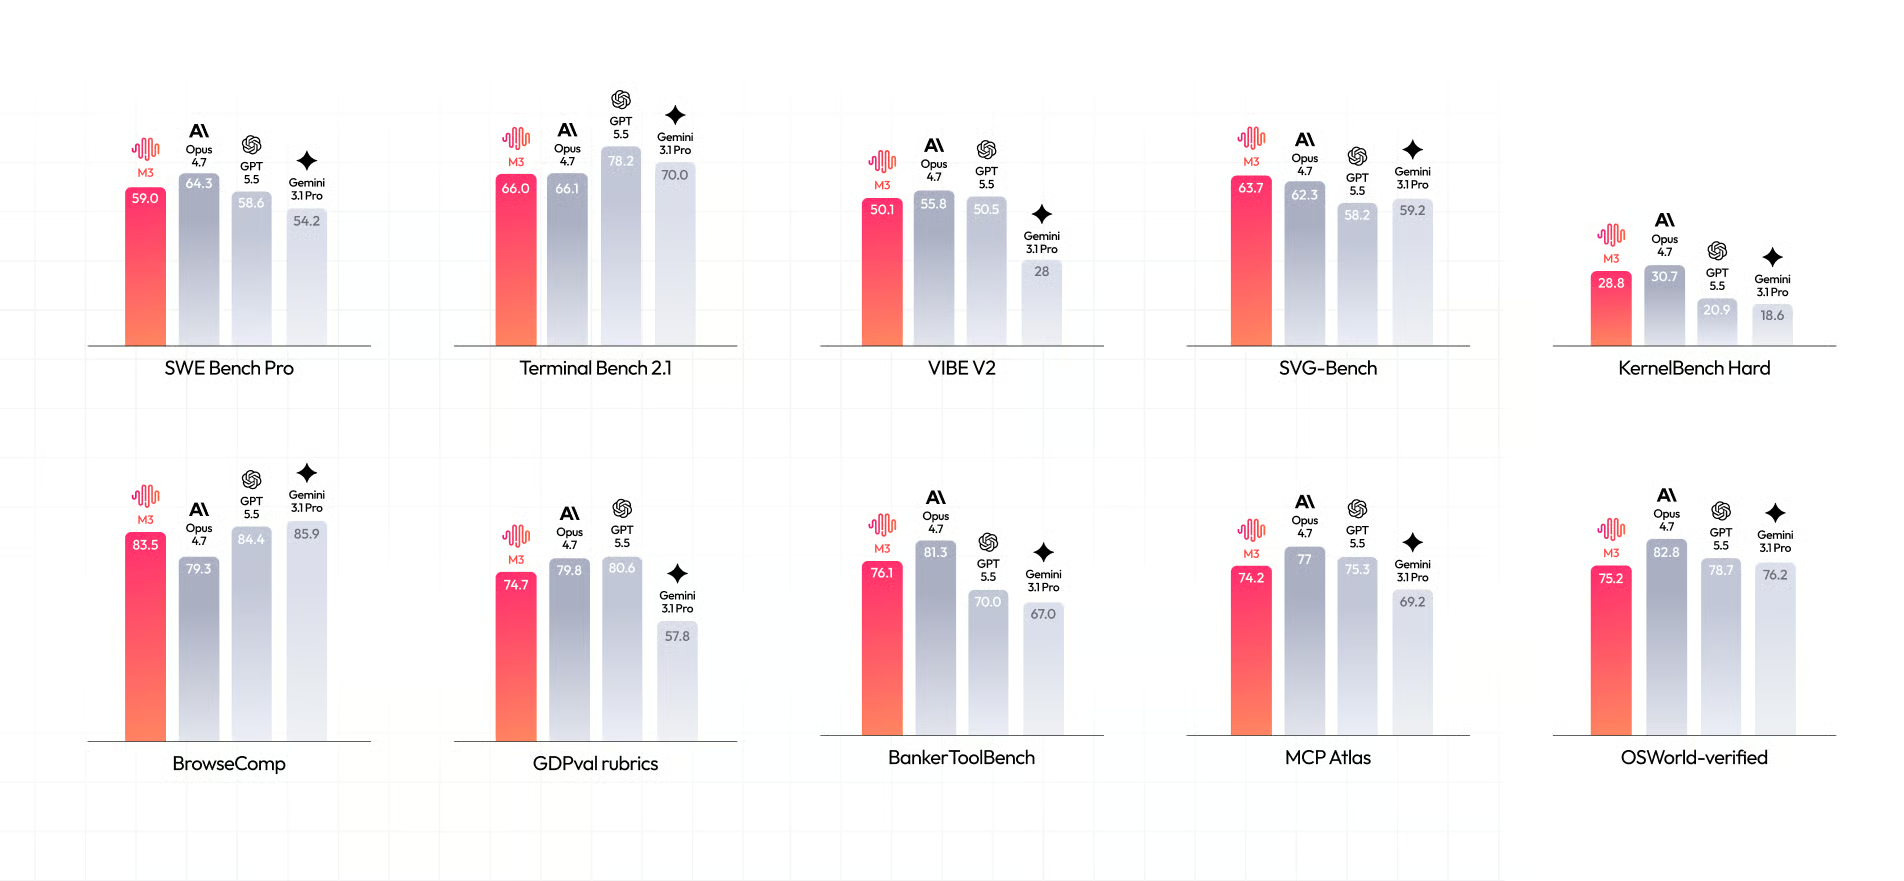
Bron: MiniMax
In deze gids laat ik je zien hoe je MiniMax M3 lokaal draait over twee NVIDIA RTX PRO 6000 GPU’s, het model test via de ingebouwde webinterface en het lokale OpenAI-compatibele endpoint koppelt aan de Pi coding agent.
De setup gebruikt JupyterLab-terminals op een RunPod PyTorch-pod in plaats van SSH, met llama.cpp gecompileerd voor CUDA, en serveert het model op poort 8910.
Zorg ervoor dat je systeem voldoende GPU-geheugen en opslag heeft om het model te laden voordat je MiniMax M3 lokaal draait.
UD-IQ3_XXS GGUF-kwantisatie van unsloth/MiniMax-M3-GGUF. Deze is ongeveer 159 GB en het meest praktisch voor deze hardware.llama.cpp met multi-GPU-ondersteuning.MiniMax M3 is een groot mixture-of-experts-model, dus tijdens inferentie moeten de gewichten over beide GPU’s worden verdeeld. Ook al biedt het systeem 192 GB gecombineerde VRAM, niet al dat geheugen kan voor het model zelf worden gebruikt.
Er is VRAM nodig voor runtime-overhead, promptverwerking en de KV-cache.
Begin daarom met de UD-IQ3_XXS-kwantisatie. Met circa 159 GB blijft er genoeg geheugen over om het model te laden en te draaien.
Vermijd 4-bit MiniMax M3-kwantisaties op deze setup, want het kleinste beschikbare 4-bit-bestand is ongeveer 208 GB en overschrijdt de beschikbare VRAM nog voordat je rekening houdt met runtime-overhead.
Maak een nieuwe RunPod Pod en selecteer 2× NVIDIA RTX PRO 6000 GPU’s met de nieuwste RunPod PyTorch-template. Deze template bevat JupyterLab, dat we in deze gids in plaats van SSH zullen gebruiken.
Configureer de Pod met de volgende instellingen:
50 GB300 GB8910HF_TOKEN: je Hugging Face-toegangstoken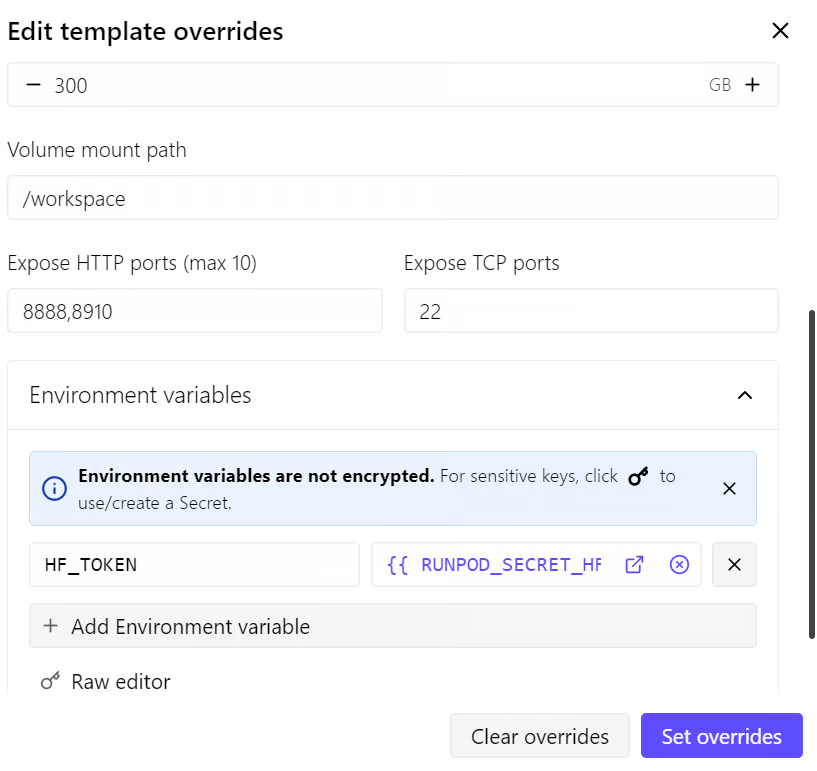
De containerdisk van 50 GB is alleen voor het besturingssysteem, pakketten en tijdelijke bestanden. De volumedisk van 300 GB is waar het MiniMax M3-model en de Hugging Face-cache moeten staan.
Expose HTTP-poort 8910, omdat llama.cpp later zijn webinterface en OpenAI-compatibele API op deze poort draait. Zodra de server draait, kun je deze benaderen via een URL in dit formaat:
https://<POD_ID>-8910.proxy.runpod.net
De gebruikte Pod-configuratie voor deze gids kost ongeveer $4,23 per uur, al kan de prijs variëren per beschikbaarheid en locatie.
Ik raad aan om minstens $10 aan RunPod-tegoed aan te houden, maar $15–$20 is veiliger voor de eerste build, modeldownload en testen.
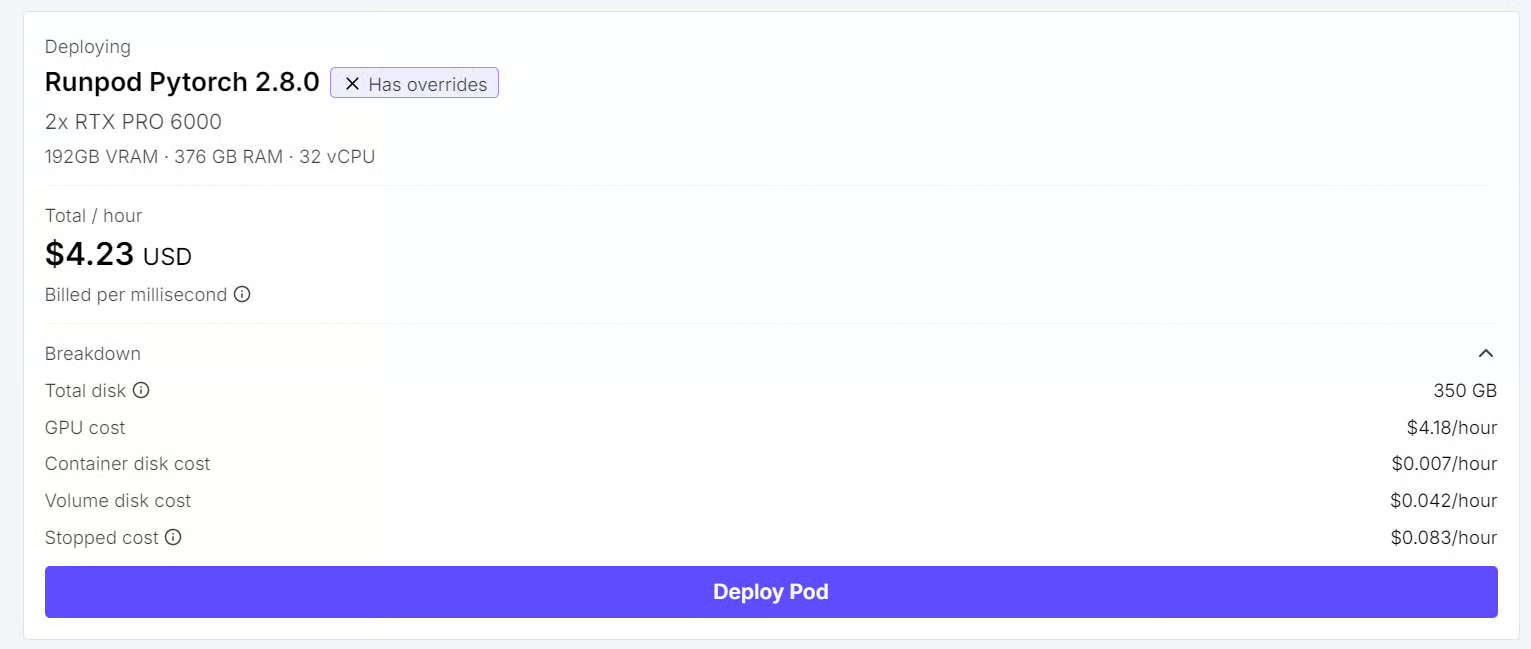
Open de Pod zodra deze draait via het RunPod-dashboard:
Controleer eerst of beide GPU’s beschikbaar zijn:
nvidia-smiJe zou twee NVIDIA RTX PRO 6000 GPU’s moeten zien, elk met ongeveer 96 GB VRAM.
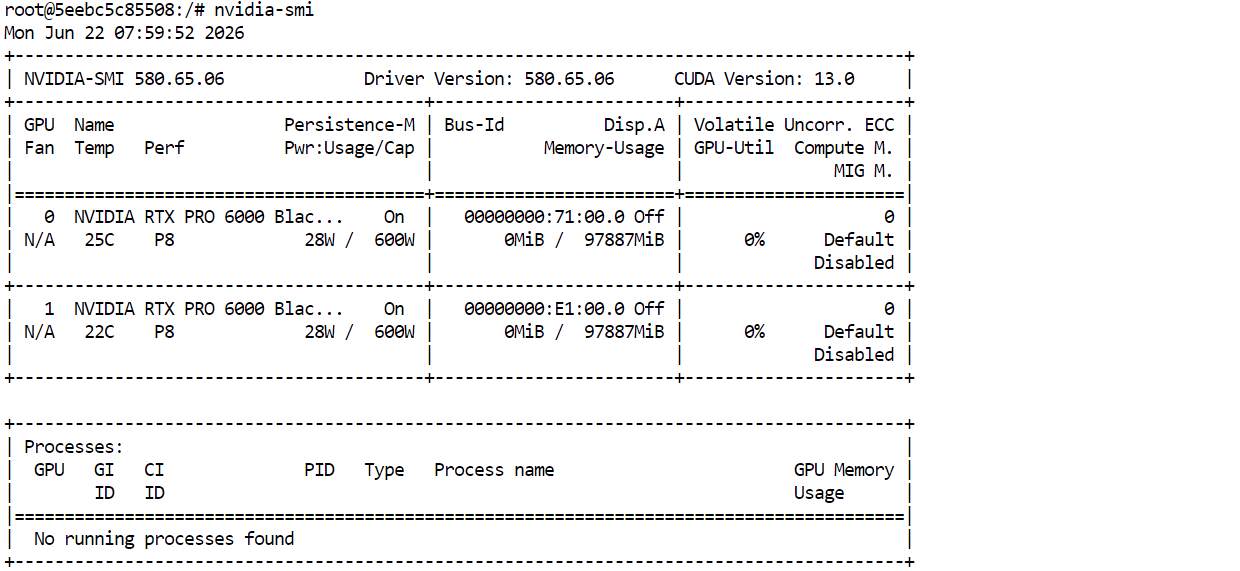
Installeer vervolgens de vereiste buildtools:
apt-get update && apt-get install -y \
  git \
  cmake \
  build-essential \
  curl
Controleer tot slot of CUDA beschikbaar is:
nvcc --versionJe zou CUDA 12.8 of een compatibele CUDA-versie moeten zien. Je bent nu klaar om llama.cpp met CUDA-ondersteuning te bouwen.
llama.cpp is een open-source inferentie-engine om GGUF-modellen lokaal te draaien. Lees onze volledige llama.cpp-gids als je hiermee nog niet bekend bent.
Het ondersteunt CUDA-versnelling, multi-GPU offloading, een ingebouwde webinterface en een OpenAI-compatibele API-server.
Ondersteuning voor MiniMax M3 is nog experimenteel, dus je moet llama.cpp bouwen vanuit de speciale minimax-m3-branch in plaats van de standaardrelease te gebruiken.
Voer de volgende commando’s uit vanuit je JupyterLab-terminal:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp

git fetch origin pull/24523/head:minimax-m3
git checkout minimax-m3
Configureer daarna llama.cpp met CUDA-ondersteuning en compileer de server- en commandoregelbinaries:
cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release

cmake --build build \
  -j"$(nproc)" \
  --target llama-server llama-cli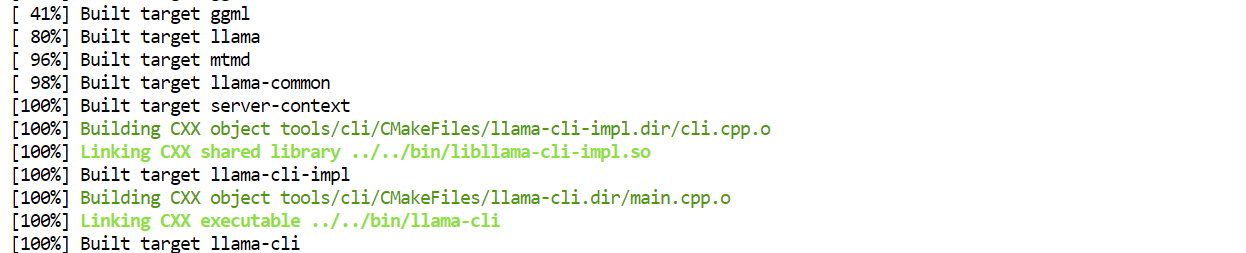
Dit creëert twee binaries in build/bin/:
llama-server, die de browsergebaseerde chatinterface en OpenAI-compatibele API-endpoint biedt.llama-cli, waarmee je het model direct vanuit de terminal kunt testen.Let op: Dit is een experimentele MiniMax M3-implementatie. Het ondersteunt tekstinferentie, maar MiniMax Sparse Attention is niet opgenomen in deze branch, dus llama.cpp gebruikt dense attention. Vision-ondersteuning en MTP/speculatieve decodering maken ook geen deel uit van deze build.
MiniMax M3 wordt gedistribueerd als meerdere GGUF-bestanden. Download de volledige map UD-IQ3_XXS naar de persistente workspace-volume voordat je de server start.
Installeer eerst de nieuwste Hugging Face Hub CLI:
pip install -U huggingface_hubMaak een map aan voor het model en schakel snellere Hugging Face-downloads in:
mkdir -p /workspace/unsloth

export HF_XET_HIGH_PERFORMANCE=1
Download vervolgens de UD-IQ3_XXS-kwantisatie:
hf download unsloth/MiniMax-M3-GGUF \
  --include "UD-IQ3_XXS/*" \
  --local-dir /workspace/unsloth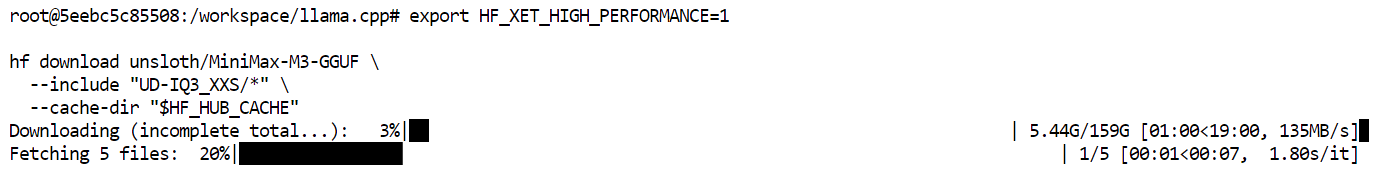
De download is ongeveer 159 GB en bevat vijf GGUF-shards. Omdat het model is opgeslagen in /workspace, blijft het beschikbaar wanneer je de Pod stopt en opnieuw start.
Ga naar de map van llama.cpp en maak beide GPU’s beschikbaar voor de server:
cd /workspace/llama.cpp

export CUDA_VISIBLE_DEVICES=0,1
Start vervolgens MiniMax M3:
MODEL_FILE="/workspace/unsloth/UD-IQ3_XXS/MiniMax-M3-UD-IQ3_XXS-00001-of-00005.gguf"

./build/bin/llama-server \
  -m "$MODEL_FILE" \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 8192 \
  --parallel 1 \
  --split-mode layer \
  --tensor-split 1,1 \
  --n-gpu-layers 99 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 40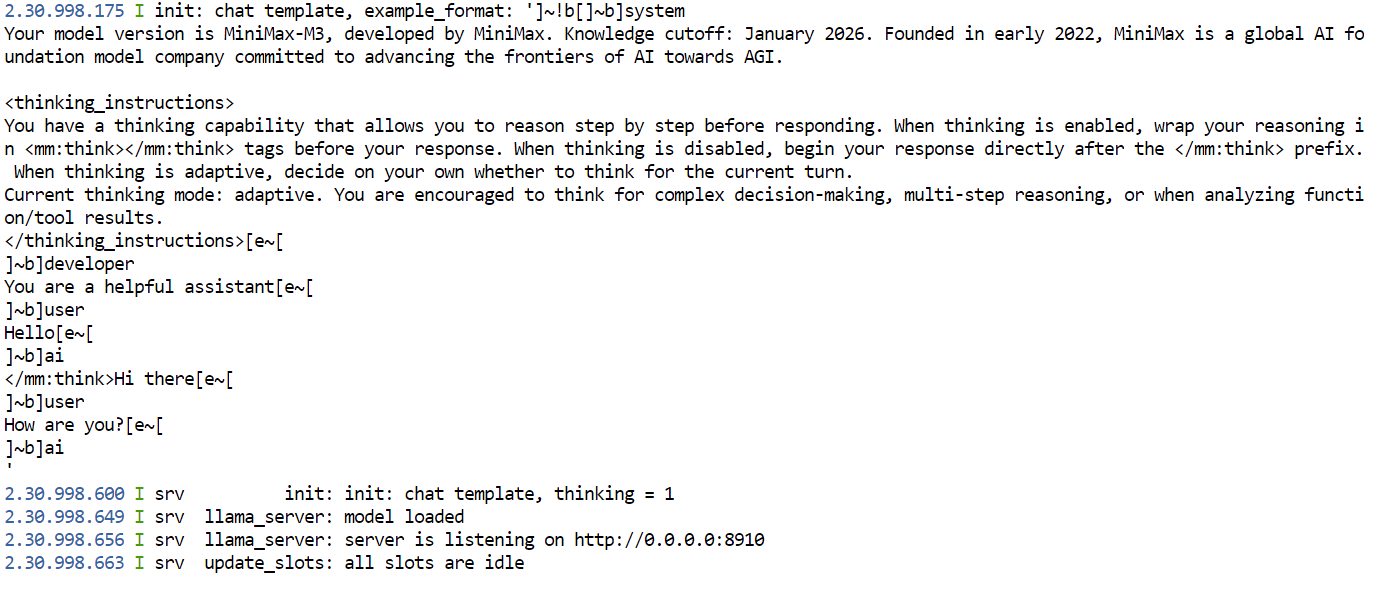
Dit commando laadt MiniMax M3 over beide RTX PRO 6000 GPU’s. De instelling --tensor-split 1,1 verdeelt het model gelijkmatig over de GPU’s, terwijl --n-gpu-layers 99 zoveel mogelijk van het model in het GPU-geheugen houdt.
De server draait op poort 8910 en biedt zowel de webinterface van llama.cpp als een OpenAI-compatibele API. Laat deze terminal open terwijl het model draait.
Begin met een 8K-contextvenster. De experimentele llama.cpp-branch gebruikt dense attention in plaats van MiniMax Sparse Attention, dus een veel groter contextvenster kan geheugenproblemen veroorzaken. Als de server werkt, kun je --ctx-size 16384 testen.
Open een andere JupyterLab-terminal en voer het volgende commando uit om te bevestigen dat beide GPU’s worden gebruikt:
nvidia-smiZodra het model geladen is, zouden beide GPU’s aanzienlijk VRAM-gebruik moeten tonen.
Open een nieuwe JupyterLab-terminal en bevestig eerst dat de server draait en MiniMax M3 heeft geladen:
curl -s http://127.0.0.1:8910/v1/models \
  | python3 -c "import sys, json; print(json.load(sys.stdin)['data'][0]['id'])"
Je zou een model-ID moeten zien zoals:
MiniMax-M3-UD-IQ3_XXS-00001-of-00005.ggufStuur vervolgens een testverzoek naar het OpenAI-compatibele chat-completions-endpoint:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMax-M3-UD-IQ3_XXS-00001-of-00005.gguf",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function that checks whether a number is prime."
      }
    ],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 512
  }'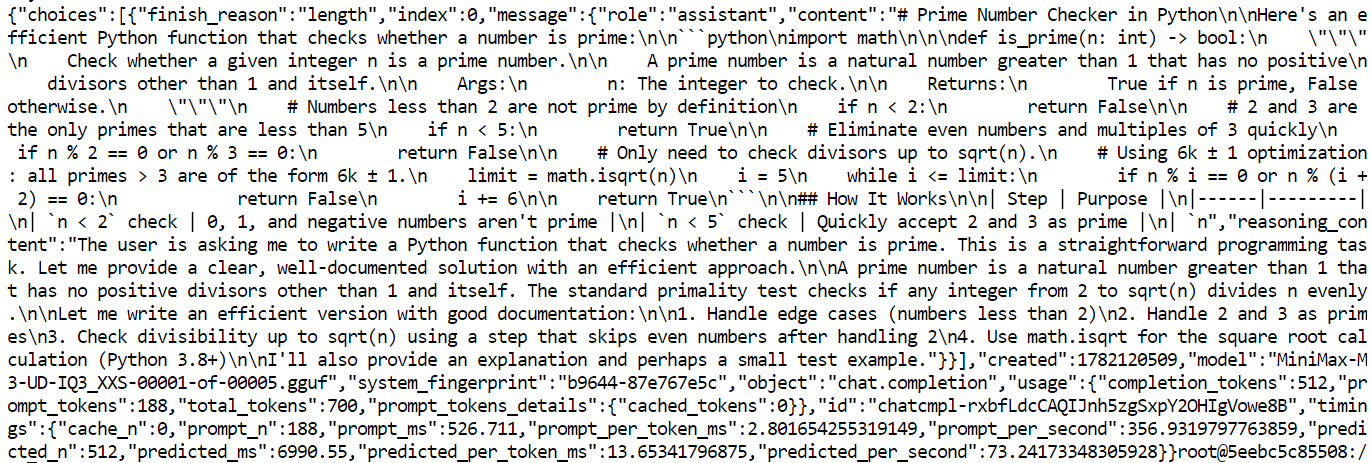
Je lokale MiniMax M3-server werkt correct.
Er werd een efficiënte Python-functie is_prime() gegenereerd met math.isqrt() en de optimalisatie 6k ± 1.
Het antwoord werd afgekapt omdat het je max_tokens-limiet van 512 bereikte, te zien aan: "finish_reason": "length"
In deze test verwerkte de server de prompt met ongeveer 357 tokens per seconde en genereerde tekst met ongeveer 73 tokens per seconde.
Je snelheid kan variëren afhankelijk van contextlengte, GPU-belasting en promptgrootte.
Omdat poort 8910 via RunPod is geëxposed, kun je MiniMax M3 ook testen via de ingebouwde webinterface van llama.cpp.
Open in het RunPod-dashboard je Pod en klik op de knop Connect. Selecteer onder de geëxposeerde HTTP-poorten de link voor poort 8910.
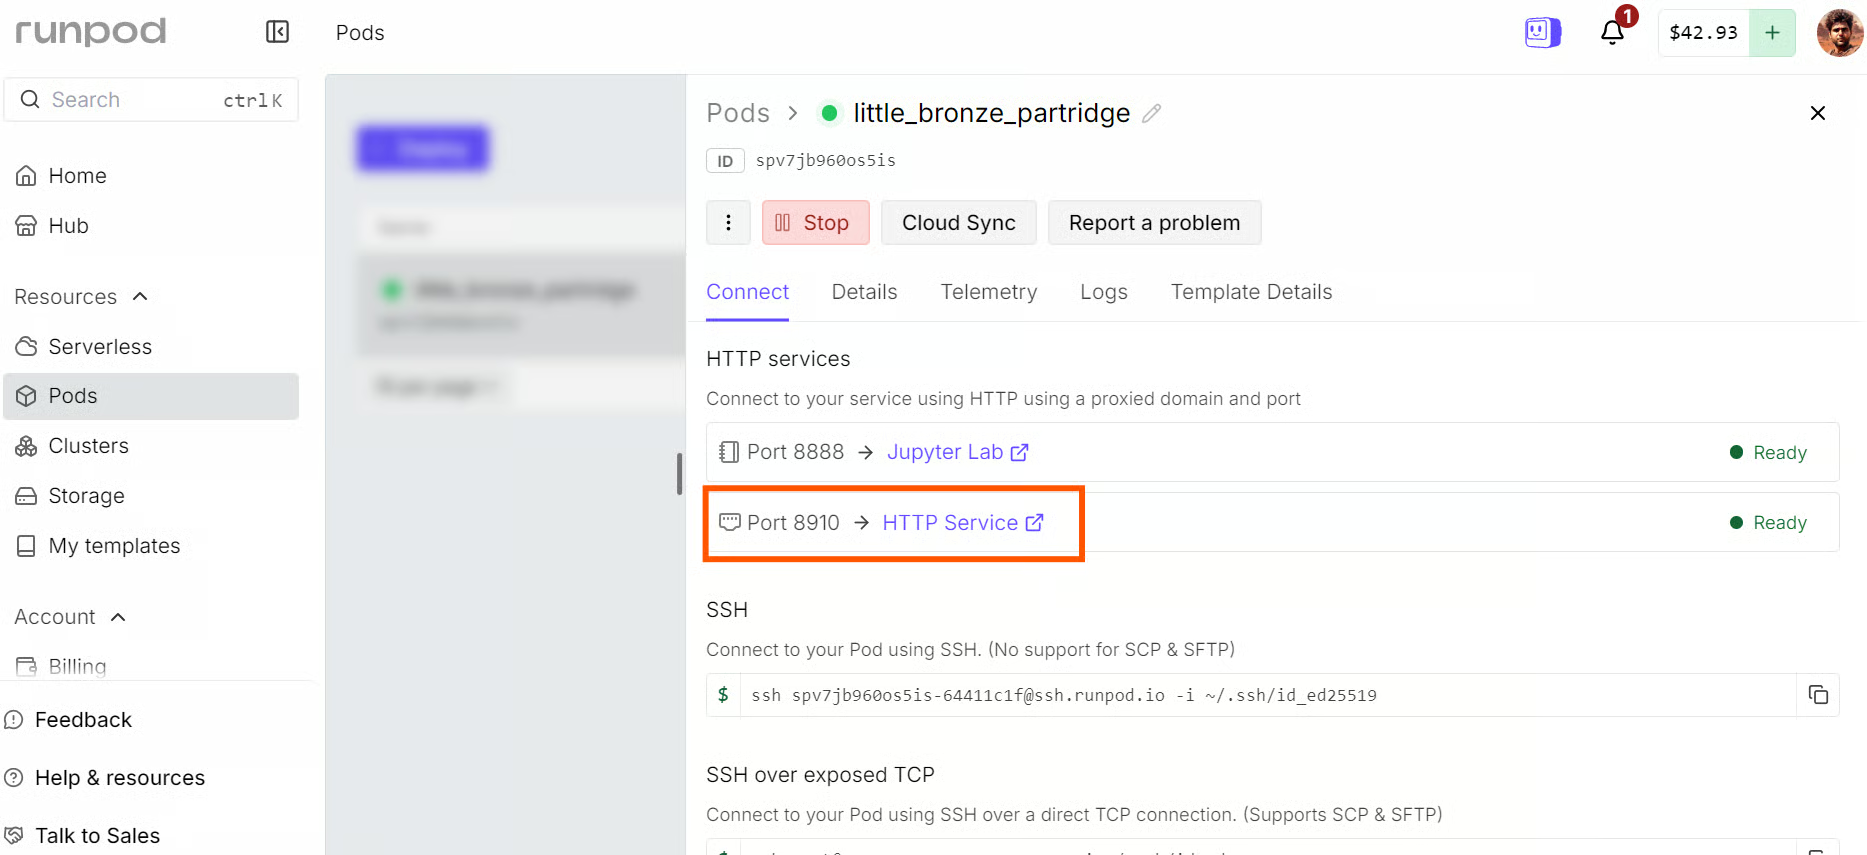
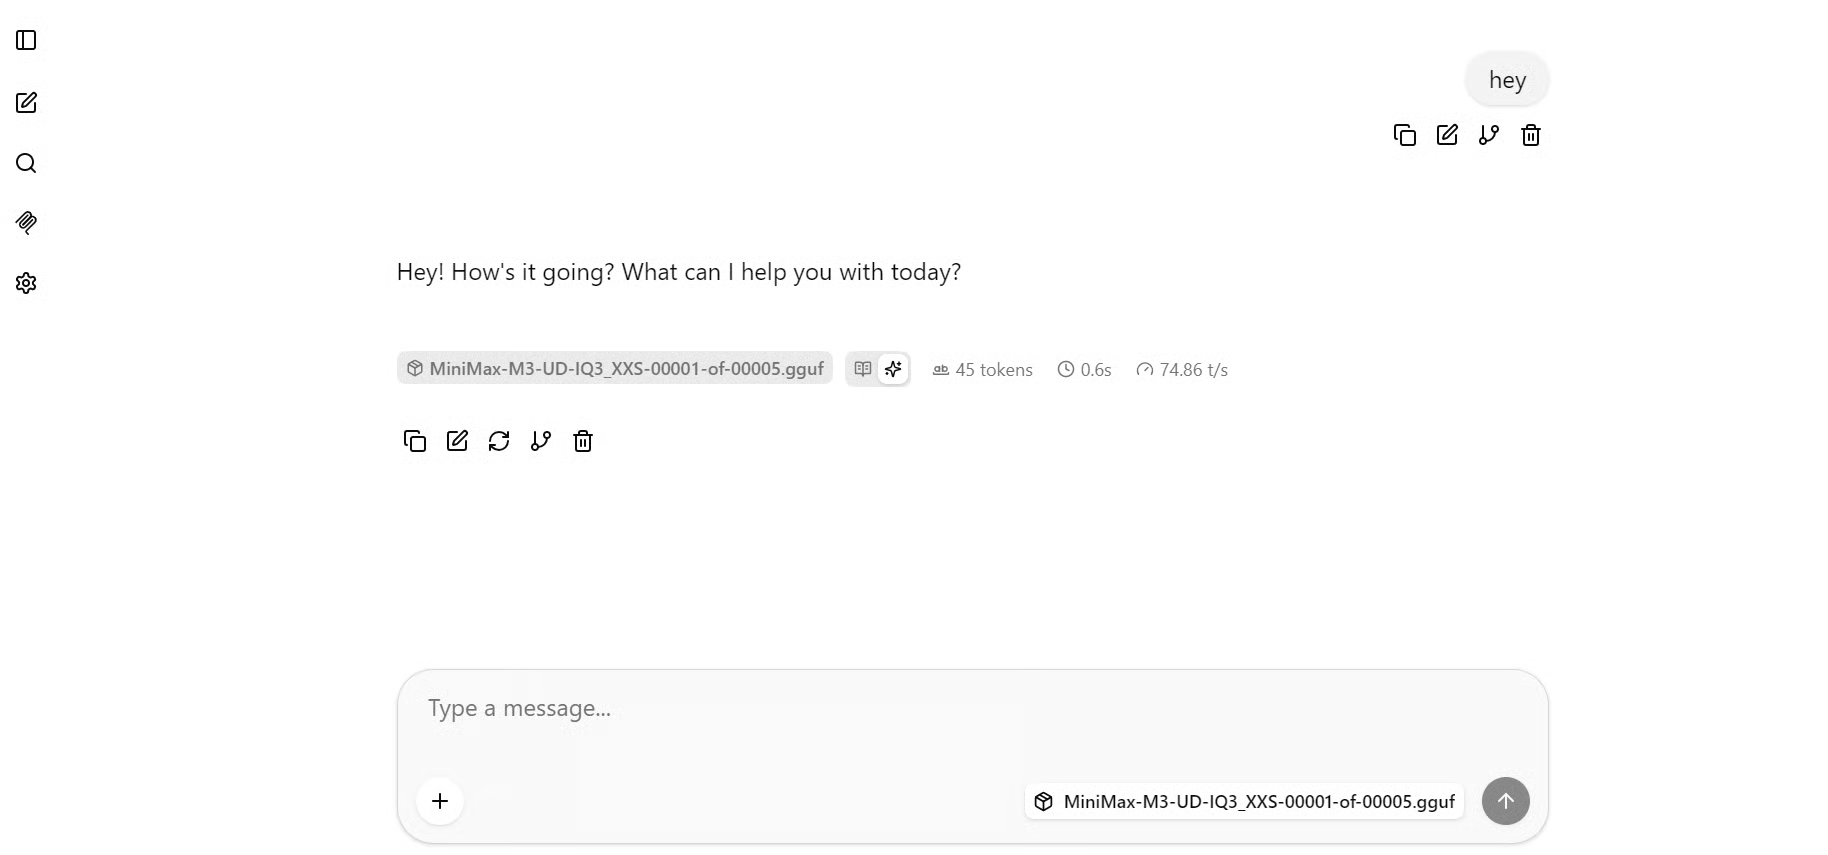
Dit opent de webinterface van llama.cpp in je browser. Het werkt als een lichte ChatGPT-achtige chatapplicatie, met het lokaal draaiende MiniMax M3-model al geselecteerd. Je kunt nu prompts sturen en het model testen zonder de terminal of API te gebruiken.
Voor een praktische test vroeg ik MiniMax M3 om een Python-webinterface te genereren voor het serven van machinelearningmodellen. Het produceerde een gedetailleerd FastAPI-gebaseerd dashboardontwerp met modelwissel, JSON-predictieverzoeken, CSV-batchuploads, live WebSocket-streaming, een modelregistry, health-endpoints, gestructureerde logging, tests en een Docker-setup.
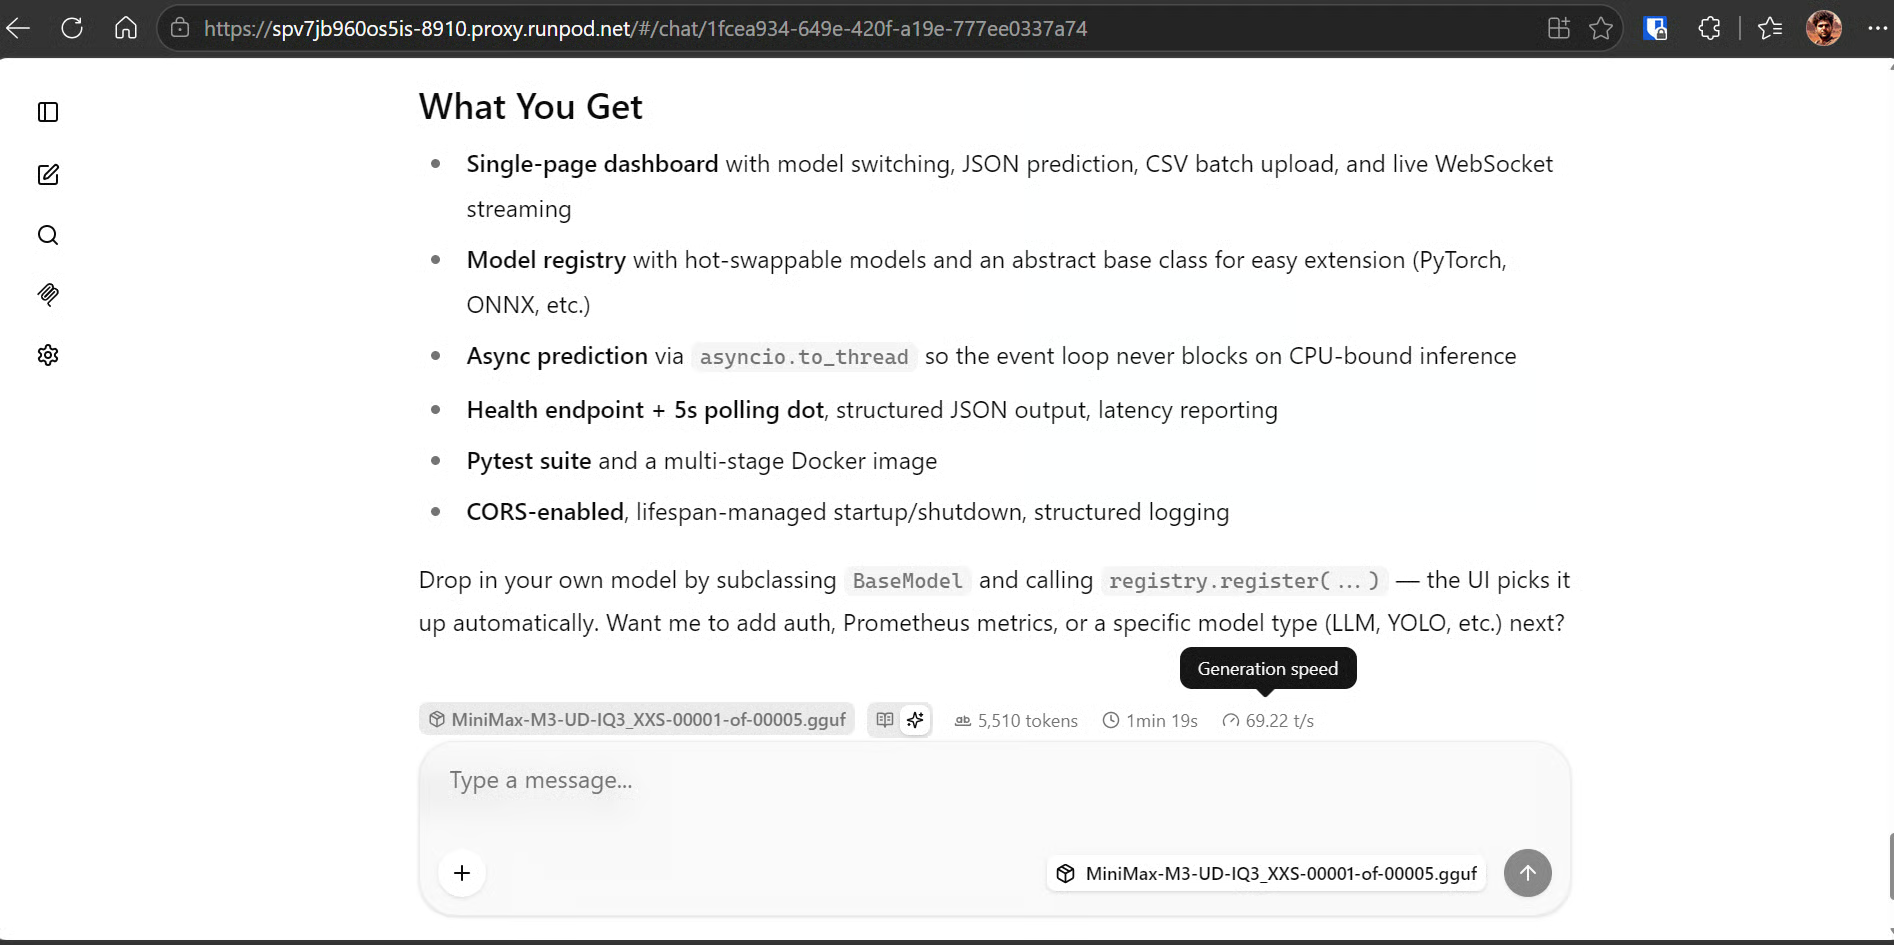
Het antwoord genereerde 5.510 tokens in 1 minuut en 19 seconden, goed voor circa 69 tokens per seconde.
Voor een lokale 3-bit-kwantisatie die over twee RTX PRO 6000 GPU’s draait, is dit een sterk resultaat en laat het zien dat MiniMax M3 langere codeverzoeken op interactieve snelheid aankan.
Pi is een terminalgebaseerde coding agent die direct met je lokale projectbestanden kan werken, commando’s kan uitvoeren, code kan inspecteren en je lokaal gehoste MiniMax M3-model kan gebruiken.
Open een derde JupyterLab-terminal. Laat de eerste terminal met llama-server draaien en gebruik deze terminal om Pi te installeren en te configureren.
Installeer Pi met het officiële installatie-script:
curl -fsSL https://pi.dev/install.sh | sh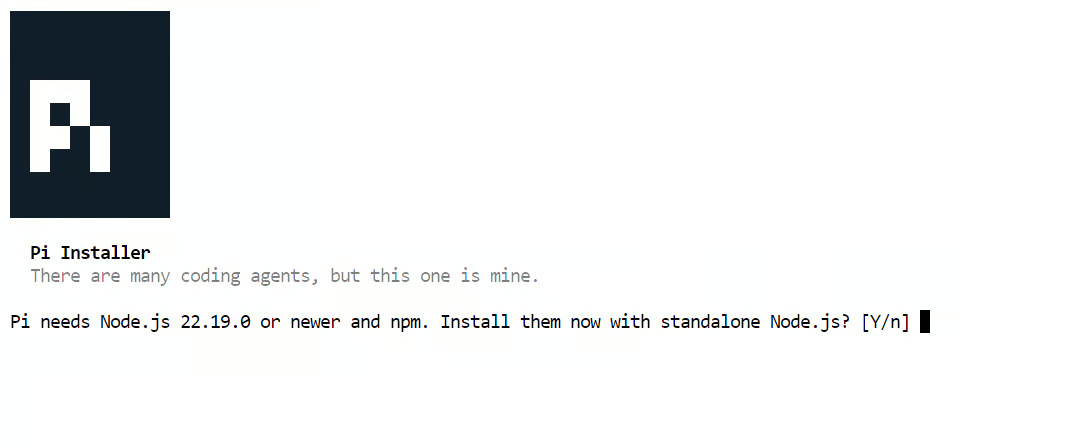 Als de installer vraagt of Node.js moet worden geïnstalleerd, typ dan Y en druk op Enter. Pi installeert dan de vereiste Node.js-runtime en de pi-opdrachtregeltool.
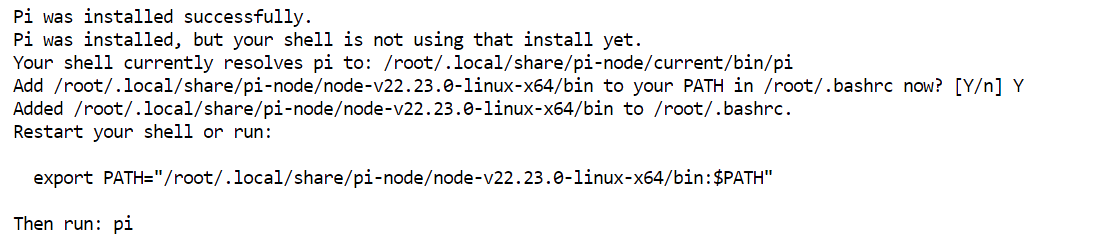
Wanneer de installatie is voltooid, kan de installer een commando tonen om je shell-omgeving bij te werken. Voer het getoonde commando uit en start vervolgens de shell opnieuw:
exec bash -lBevestig dat Pi beschikbaar is:
pi --versionJe zou het geïnstalleerde Pi-versienummer moeten zien.
0.79.10Pi ondersteunt aangepaste OpenAI-compatibele providers via een models.json-bestand. Maak de configuratiemap van Pi aan:
mkdir -p ~/.pi/agentMaak vervolgens de providerconfiguratie aan:
cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "local-minimax": {
      "baseUrl": "http://127.0.0.1:8910/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "compat": {
        "supportsDeveloperRole": false,
        "supportsReasoningEffort": false,
        "supportsUsageInStreaming": false,
        "maxTokensField": "max_tokens"
      },
      "models": [
        {
          "id": "MiniMax-M3-UD-IQ3_XXS-00001-of-00005.gguf",
          "name": "MiniMax M3 Local 3-bit",
          "reasoning": false,
          "input": ["text"],
          "contextWindow": 8192,
          "maxTokens": 2048,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Deze configuratie vertelt Pi de lokale llama.cpp-server op poort 8910 te gebruiken. De instelling openai-completions komt overeen met het OpenAI-compatibele chat-completions-endpoint van llama.cpp.
De compatibiliteitsinstellingen voorkomen dat Pi niet-ondersteunde velden of berichtrollen verstuurt die problemen kunnen veroorzaken met sommige lokale OpenAI-compatibele servers. Pi gebruikt met name de standaardrol system in plaats van de nieuwere developer-rol en zal max_tokens sturen, wat llama.cpp verwacht.
Het model is als tekst-only met een 8K-contextvenster opgegeven, in lijn met de serverconfiguratie die je eerder startte. De kostenwaarden staan op nul omdat MiniMax M3 lokaal op je RunPod-instantie draait in plaats van via een betaalde API.
Open een nieuwe JupyterLab-terminal voor Pi. Voor een comfortabelere coding-agent-ervaring kun je JupyterLab in de donkere modus zetten via Settings → Theme → JupyterLab Dark.
Kloon vervolgens het project waarop je MiniMax M3 wilt laten werken:
cd /workspace

git clone https://github.com/kingabzpro/semantic-web-cache
cd semantic-web-cache
Start Pi:
piTyp in Pi:
/modelZoek naar local en selecteer vervolgens MiniMax M3 Local 3-bit. Pi zou de lokale provider moeten tonen en bevestigen dat het MiniMax M3 GGUF-model is geselecteerd.
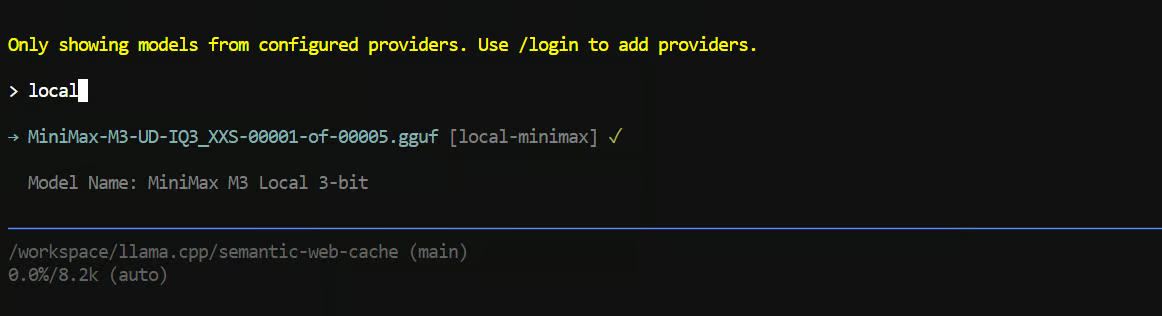
Begin met een taak in alleen-lezenmodus zodat Pi de repository kan inspecteren zonder bestanden te wijzigen. Bijvoorbeeld:
"Lees het bestand README.md en leg uit hoe dit project is opgebouwd."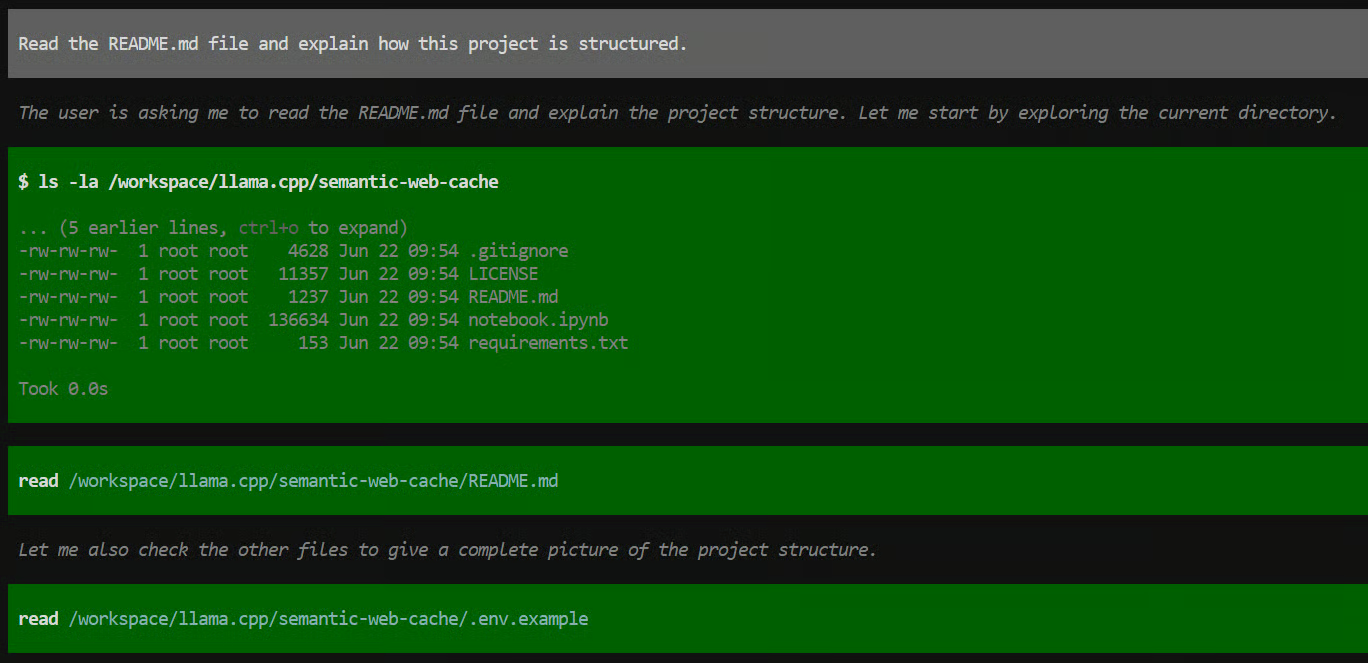
Pi gebruikt terminaltools zoals ls en read om de repository te verkennen, de README te bekijken en ondersteunende bestanden zoals .env.example, requirements.txt en de Jupyter-notebook te bekijken.
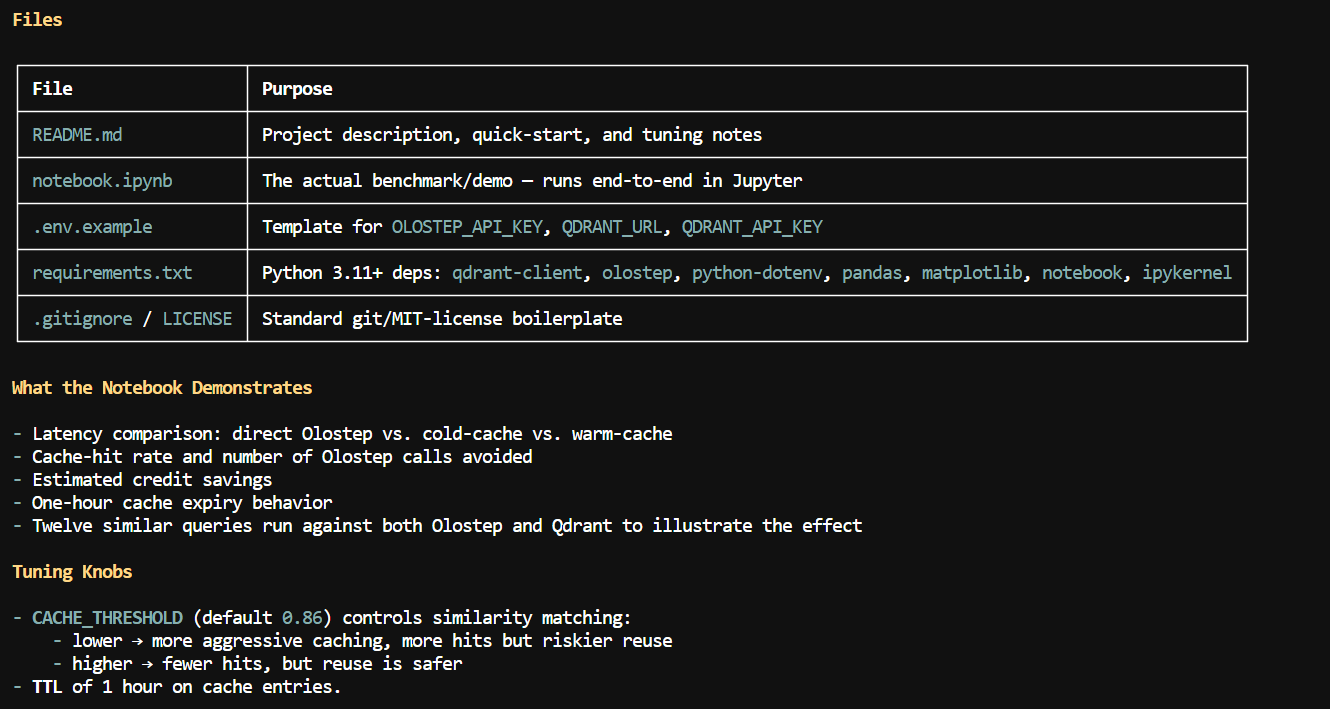
In dit voorbeeld identificeerde MiniMax M3 de belangrijkste projectbestanden correct en legde uit dat de repository een semantische caching-demo is, gebouwd met Olostep en Qdrant.
Het lichtte de notebook-gebaseerde workflow uit, de omgevingsvariabelen die nodig zijn voor de API’s, de cache-drempel- en TTL-instellingen, en de evaluaties voor latency, cache-hits en kostenbesparing die in het project zijn opgenomen.
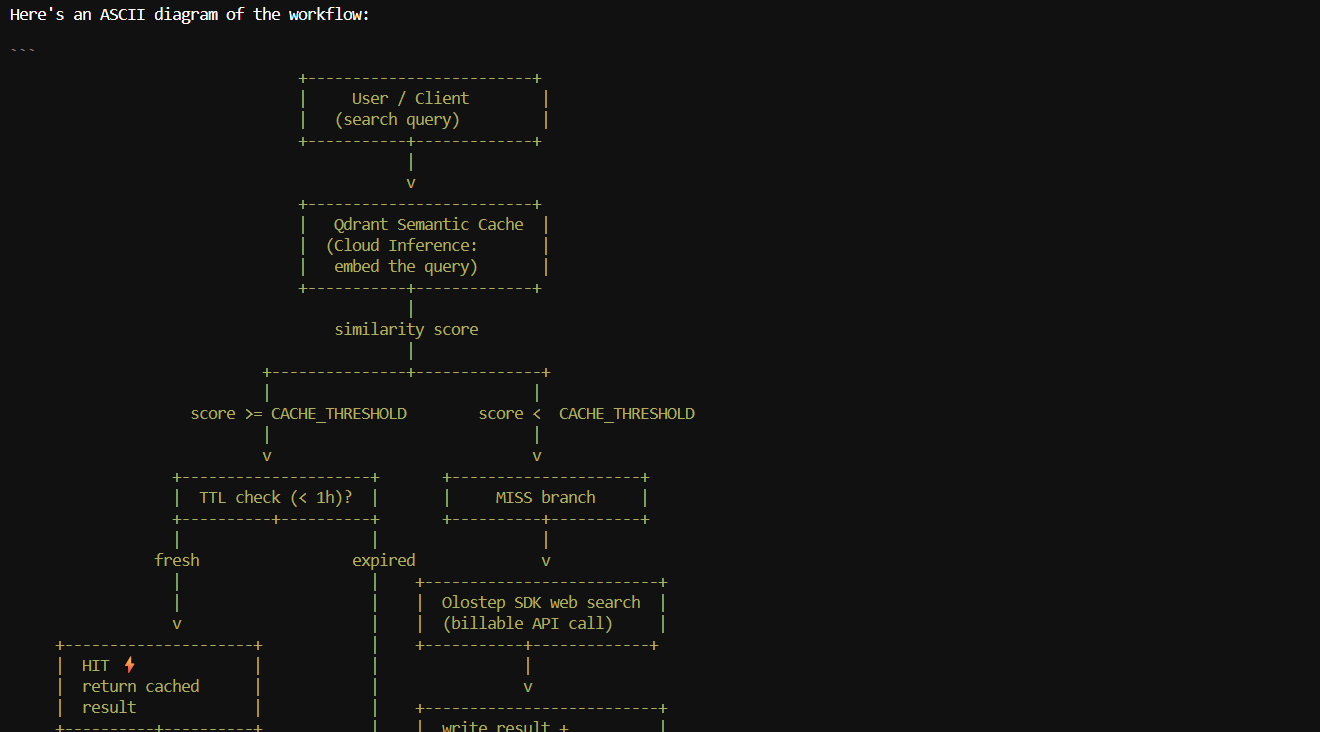
Ik vroeg ook om een ASCII-workflowdiagram van de semantische cache-pijplijn. Het genereerde een duidelijk verloop waarin een gebruikersquery wordt ge-embed, gecontroleerd tegen de Qdrant-cache, geëvalueerd tegen de similariteitsdrempel, en óf uit de cache wordt teruggegeven óf naar Olostep wordt gestuurd voordat het resultaat wordt opgeslagen.
Voor grotere repositories of diepere meerstapstaken heb je mogelijk een groter contextvenster nodig. Werk de waarde --ctx-size in het llama-server-commando bij en start de server opnieuw. Verhoog deze eerst van 8192 naar 16384, en test daarna 32768` als er nog GPU-geheugen beschikbaar is.
Spring niet direct naar een contextvenster van 100K. Deze experimentele MiniMax M3-branch van llama.cpp gebruikt dense attention in plaats van MiniMax Sparse Attention, dus zeer grote contexten kunnen het geheugenverbruik sterk verhogen en out-of-memory-fouten veroorzaken.
Na MiniMax M3 lokaal te hebben gedraaid, denk ik dat het een veel betere balans biedt dan proberen extreem grote codemodellen te draaien zoals GLM 5.2 of Kimi K2.7 Code.
Die modellen kunnen in sommige gevallen krachtiger zijn, maar ze vereisen ook veel meer GPU-geheugen en kunnen erg duur worden om lokaal te huren en te serven.
Met MiniMax M3 kon ik een capabel code- en agentisch model over twee RTX PRO 6000 GPU’s draaien, het via een browserinterface gebruiken, het via een OpenAI-compatibele API exposen en het als lokale coding agent aan Pi koppelen.
In mijn tests genereerde het met ongeveer 70 tokens per seconde en ging het goed om met repositoryverkenning, README-analyse, commando-uitvoering, projectuitleg en workflowdiagrammen.
Het is nog geen perfecte setup. De ondersteuning in llama.cpp is nog experimenteel, Sparse Attention is niet beschikbaar en het contextvenster moet relatief klein blijven tenzij je meer VRAM hebt. Toch waren de resultaten indrukwekkend voor een lokaal draaiend, 3-bit gekwantiseerd model.
Topcursussen bij DataCamp
Cursus
Leerpad
Leerpad
blog
Adel Nehme
15 min


