
कोर्स
Google DeepMind: Fine-Tune Your Model
8 घंटा
164
MiniMax M3, MiniMax का नवीनतम ओपन‑वेट मॉडल है, जो कोडिंग, टूल उपयोग, और लंबे समय तक चलने वाले एजेंट वर्कफ़्लो के लिए बनाया गया है। इसे पहले के MiniMax मॉडलों से अलग बनाता है 1M‑टोकन कॉन्टेक्स्ट विंडो, टेक्स्ट, इमेज और वीडियो के लिए नैटिव मल्टीमॉडल सपोर्ट, और MiniMax Sparse Attention का संयोजन, जिसे बहुत लंबे कॉन्टेक्स्ट पर इन्फ़रेंस को अधिक व्यावहारिक बनाने के लिए डिज़ाइन किया गया है।
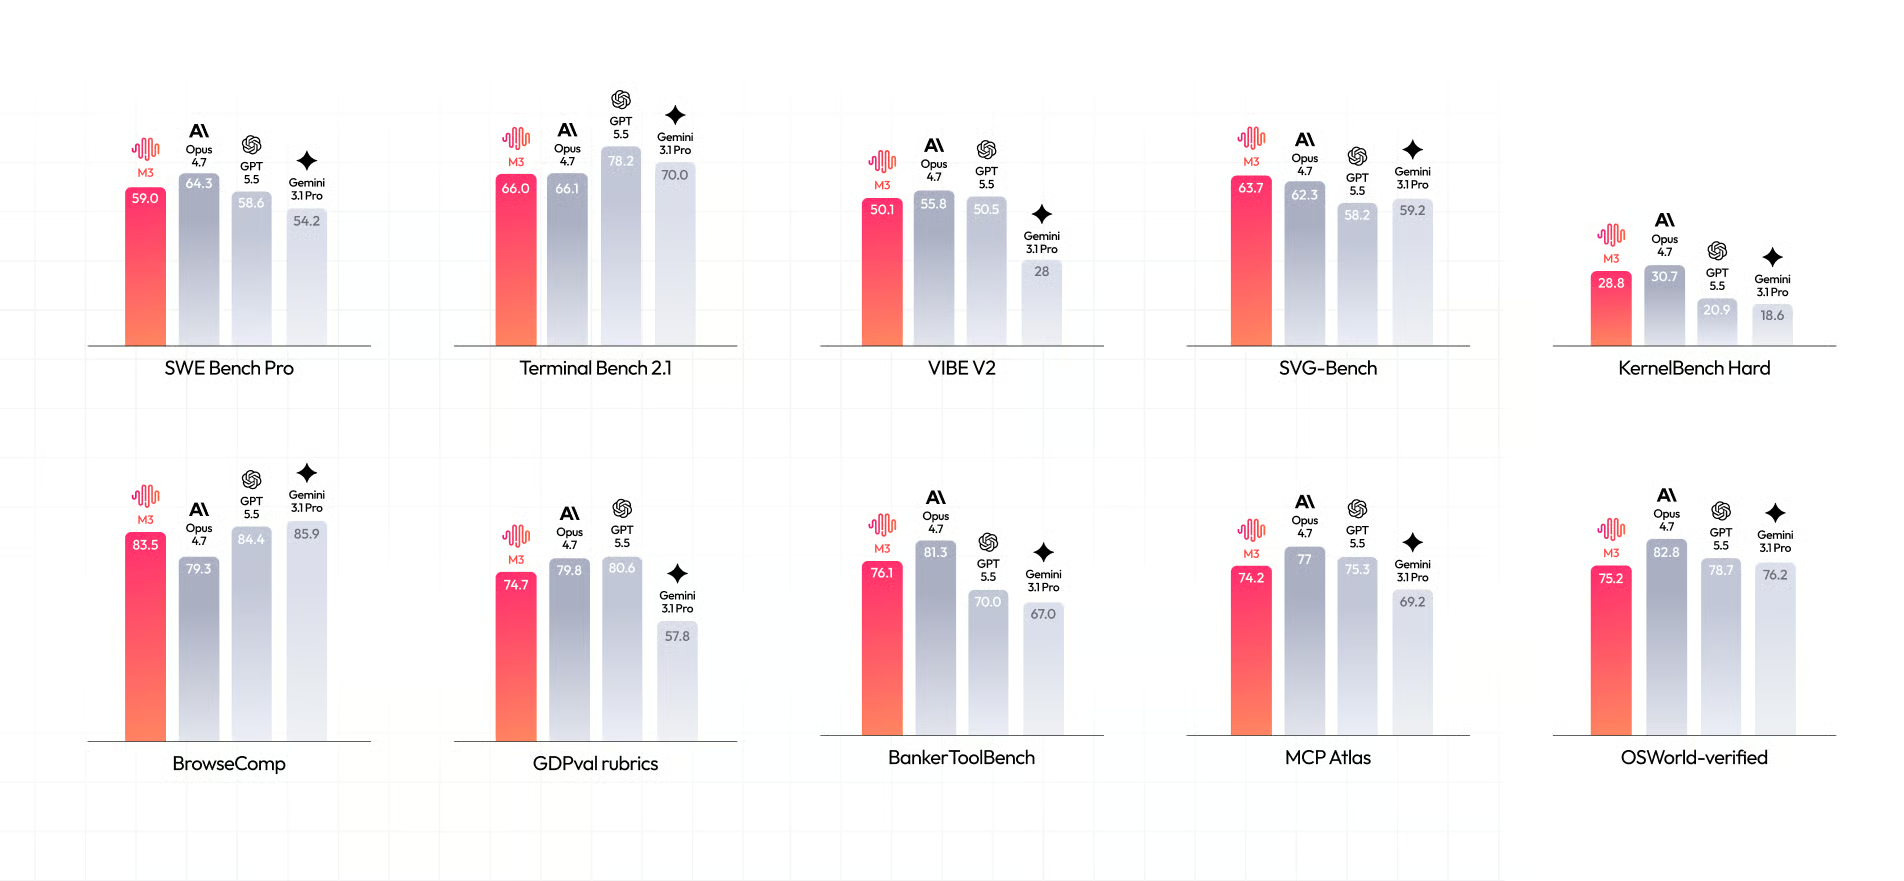
स्रोत: MiniMax
इस गाइड में, मैं दिखाऊँगा कि कैसे MiniMax M3 को लोकली दो NVIDIA RTX PRO 6000 GPUs पर चलाएँ, बिल्ट‑इन वेब इंटरफ़ेस से मॉडल को टेस्ट करें, और लोकल OpenAI‑compatible एंडपॉइंट को Pi कोडिंग एजेंट से कनेक्ट करें।
यह सेटअप SSH के बजाय RunPod PyTorch pod पर JupyterLab टर्मिनलों का उपयोग करता है, जिसमें CUDA के लिए कंपाइल किया हुआ llama.cpp है, जो पोर्ट 8910 पर मॉडल सर्व करता है।
MiniMax M3 को लोकली चलाने से पहले, सुनिश्चित करें कि आपके सिस्टम में मॉडल लोड करने के लिए पर्याप्त GPU मेमोरी और स्टोरेज हो।
unsloth/MiniMax-M3-GGUF से UD-IQ3_XXS GGUF क्वांटाइज़ेशन का उपयोग करें। यह लगभग 159 GB है और इस हार्डवेयर के लिए सबसे व्यावहारिक विकल्प है।llama.cpp का CUDA‑सक्षम बिल्ड।MiniMax M3 एक बड़ा mixture‑of‑experts मॉडल है, इसलिए इन्फ़रेंस के दौरान इसके वेट्स को दोनों GPUs में बाँटना होगा। भले ही सिस्टम में कुल 192 GB VRAM हो, इसका सारा हिस्सा केवल मॉडल के लिए उपयोग योग्य नहीं है।
रनटाइम ओवरहेड, प्रॉम्प्ट प्रोसेसिंग, और KV कैश के लिए कुछ VRAM आवश्यक होती है।
इसी कारण, UD-IQ3_XXS क्वांटाइज़ेशन से शुरुआत करें। लगभग 159 GB पर, यह मॉडल को लोड और रन करने के लिए पर्याप्त मेमोरी छोड़ता है।
इस सेटअप पर 4‑बिट MiniMax M3 क्वांटाइज़ेशन से बचें, क्योंकि उपलब्ध सबसे छोटा 4‑बिट फ़ाइल लगभग 208 GB की है और रनटाइम ओवरहेड से पहले ही उपलब्ध VRAM से अधिक हो जाती है।
नया RunPod Pod बनाएँ और 2× NVIDIA RTX PRO 6000 GPUs के साथ नवीनतम RunPod PyTorch टेम्पलेट चुनें। इस टेम्पलेट में JupyterLab शामिल है, जिसका उपयोग हम इस गाइड में SSH के बजाय करेंगे।
Pod को निम्न सेटिंग्स के साथ कॉन्फ़िगर करें:
50 GB300 GB8910HF_TOKEN: आपका Hugging Face एक्सेस टोकन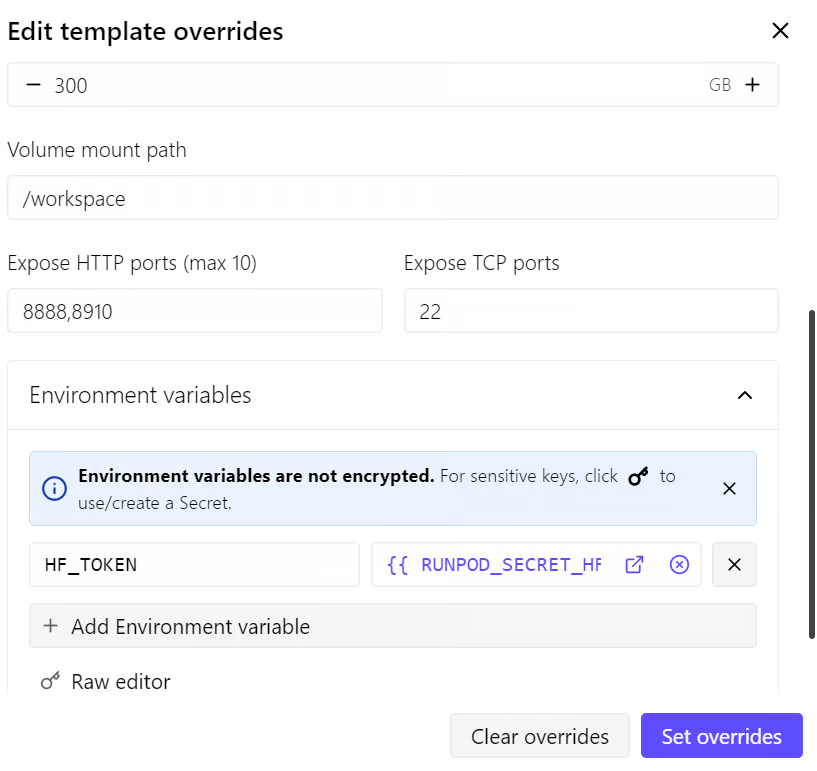
50 GB कंटेनर डिस्क केवल ऑपरेटिंग सिस्टम, पैकेज और अस्थायी फ़ाइलों के लिए है। 300 GB वॉल्यूम डिस्क वह स्थान है जहाँ MiniMax M3 मॉडल और Hugging Face कैश होना चाहिए।
HTTP पोर्ट 8910 एक्सपोज़ करें, क्योंकि आगे चलकर llama.cpp अपना वेब इंटरफ़ेस और OpenAI‑compatible API इसी पोर्ट पर चलाएगा। सर्वर रन होने पर, आप इसे इस प्रारूप के URL से एक्सेस कर सकते हैं:
https://<POD_ID>-8910.proxy.runpod.net
इस गाइड के लिए उपयोग की गई Pod कॉन्फ़िगरेशन की लागत लगभग $4.23 प्रति घंटा है, हालांकि उपलब्धता और लोकेशन के आधार पर कीमत बदल सकती है।
मैं सलाह दूँगा कि आपके RunPod क्रेडिट्स में कम से कम $10 हों, लेकिन शुरुआती बिल्ड, मॉडल डाउनलोड और टेस्टिंग के लिए $15–$20 सुरक्षित रहता है।
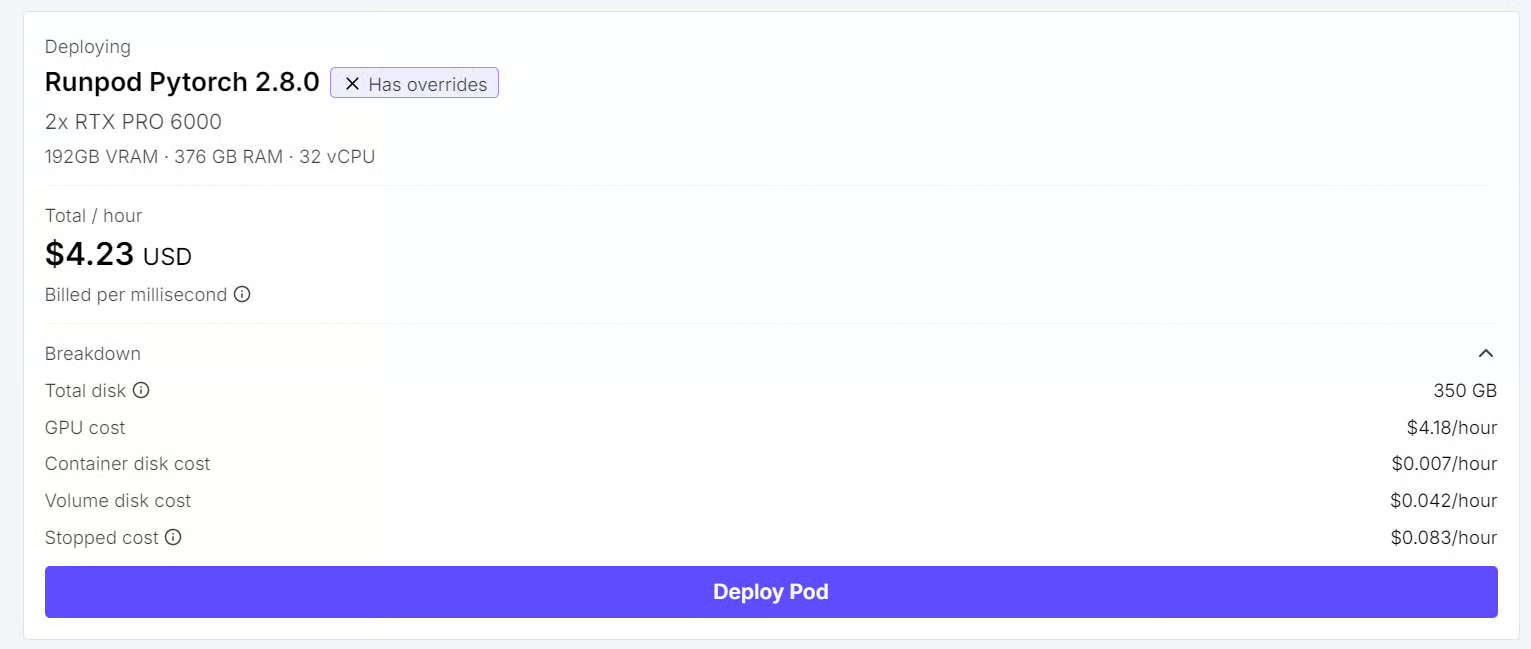
Pod चलने के बाद, RunPod डैशबोर्ड से इसे खोलें:
सबसे पहले, सुनिश्चित करें कि दोनों GPUs उपलब्ध हैं:
nvidia-smiआपको दो NVIDIA RTX PRO 6000 GPUs दिखने चाहिए, प्रत्येक में लगभग 96 GB VRAM।
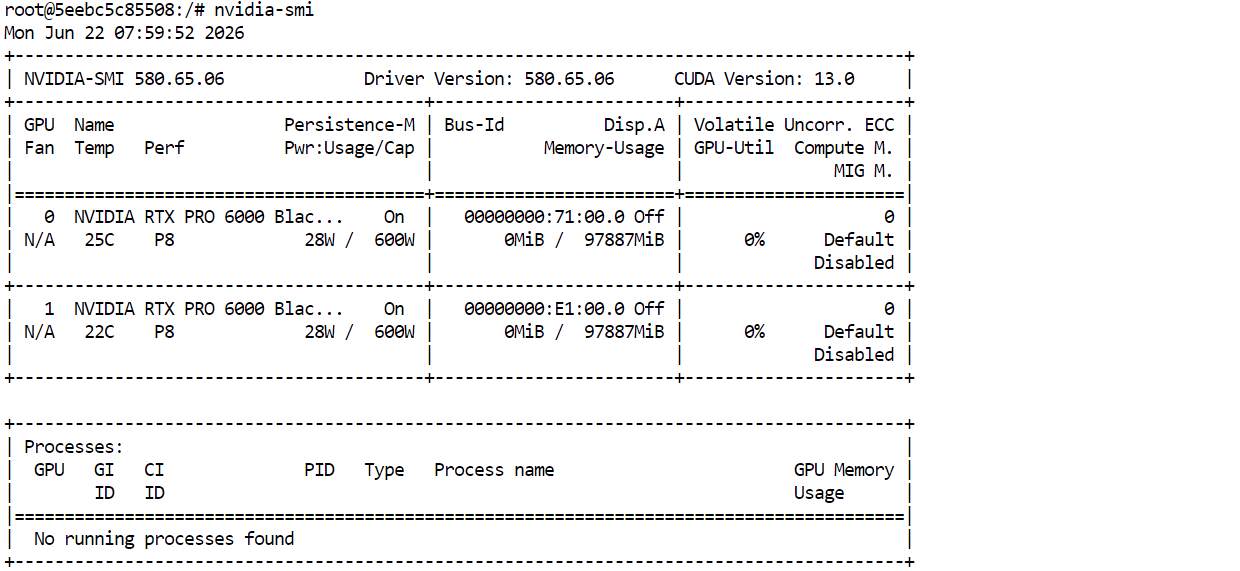
इसके बाद आवश्यक बिल्ड टूल इंस्टॉल करें:
apt-get update && apt-get install -y \
  git \
  cmake \
  build-essential \
  curl
अंत में, जाँच लें कि CUDA उपलब्ध है:
nvcc --versionआपको CUDA 12.8 या संगत CUDA संस्करण दिखना चाहिए। अब आप CUDA सपोर्ट के साथ llama.cpp बनाने के लिए तैयार हैं।
llama.cpp GGUF मॉडलों को लोकली चलाने के लिए एक ओपन‑सोर्स इन्फ़रेंस इंजन है। यदि आप इससे परिचित नहीं हैं, तो हमारा पूरा llama.cpp गाइड पढ़ने का सुझाव देता हूँ।
यह CUDA त्वरक, मल्टी‑GPU ऑफ़लोडिंग, बिल्ट‑इन वेब इंटरफ़ेस, और OpenAI‑compatible API सर्वर सपोर्ट करता है।
MiniMax M3 सपोर्ट अभी प्रयोगात्मक है, इसलिए आपको स्टैंडर्ड रिलीज़ के बजाय समर्पित minimax-m3 ब्रांच से llama.cpp बिल्ड करना होगा।
निम्न कमांड JupyterLab टर्मिनल से चलाएँ:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp

git fetch origin pull/24523/head:minimax-m3
git checkout minimax-m3
इसके बाद, CUDA सपोर्ट के साथ llama.cpp को कॉन्फ़िगर करें और सर्वर व कमांड‑लाइन बाइनरीज़ कम्पाइल करें:
cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release

cmake --build build \
  -j"$(nproc)" \
  --target llama-server llama-cli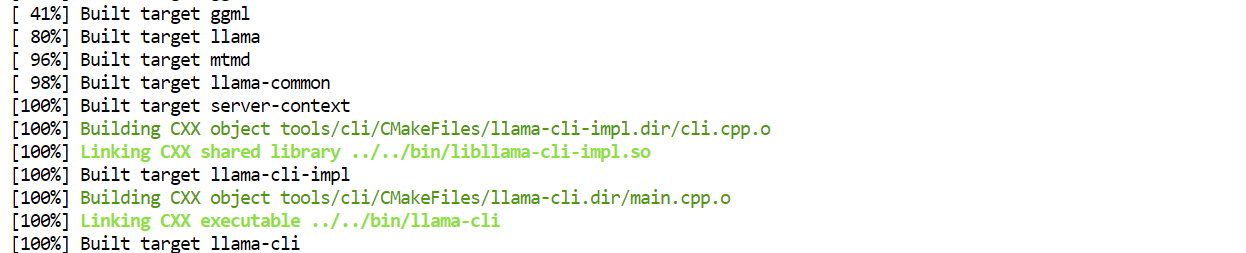
यह build/bin/ में दो बाइनरी बनाता है:
llama-server, जो ब्राउज़र‑आधारित चैट इंटरफ़ेस और OpenAI‑compatible API एंडपॉइंट प्रदान करता है।llama-cli, जिससे आप सीधे टर्मिनल से मॉडल टेस्ट कर सकते हैं।नोट: यह MiniMax M3 का एक प्रयोगात्मक इम्प्लीमेंटेशन है। यह टेक्स्ट इन्फ़रेंस सपोर्ट करता है, लेकिन इस ब्रांच में MiniMax Sparse Attention शामिल नहीं है, इसलिए llama.cpp डेंस अटेंशन का उपयोग करता है। विज़न सपोर्ट और MTP/स्पेकुलेटिव डिकोडिंग भी इस बिल्ड का हिस्सा नहीं हैं।
MiniMax M3 कई GGUF फ़ाइलों के रूप में वितरित होता है। सर्वर शुरू करने से पहले पूरा UD-IQ3_XXS फ़ोल्डर पर्सिस्टेंट वर्कस्पेस वॉल्यूम पर डाउनलोड करें।
सबसे पहले नवीनतम Hugging Face Hub CLI इंस्टॉल करें:
pip install -U huggingface_hubमॉडल के लिए एक डायरेक्टरी बनाएँ और Hugging Face डाउनलोड को तेज करें:
mkdir -p /workspace/unsloth

export HF_XET_HIGH_PERFORMANCE=1
फिर UD-IQ3_XXS क्वांटाइज़ेशन डाउनलोड करें:
hf download unsloth/MiniMax-M3-GGUF \
  --include "UD-IQ3_XXS/*" \
  --local-dir /workspace/unsloth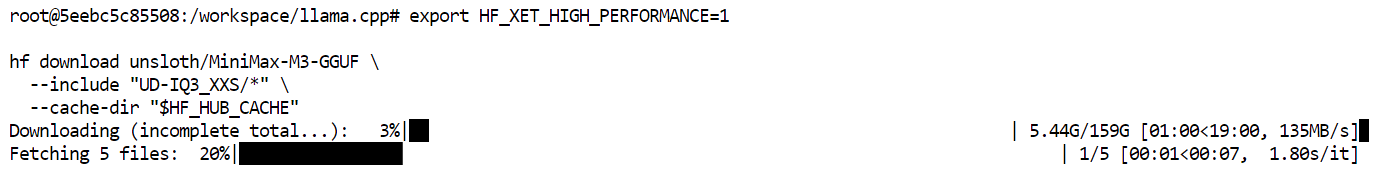
डाउनलोड लगभग 159 GB का है और पाँच GGUF शार्ड्स शामिल हैं। चूँकि मॉडल /workspace में सेव है, इसलिए आप Pod को रोकें या पुनः शुरू करें—मॉडल उपलब्ध रहेगा।
llama.cpp डायरेक्टरी में जाएँ और सर्वर के लिए दोनों GPUs उपलब्ध कराएँ:
cd /workspace/llama.cpp

export CUDA_VISIBLE_DEVICES=0,1
फिर MiniMax M3 शुरू करें:
MODEL_FILE="/workspace/unsloth/UD-IQ3_XXS/MiniMax-M3-UD-IQ3_XXS-00001-of-00005.gguf"

./build/bin/llama-server \
  -m "$MODEL_FILE" \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 8192 \
  --parallel 1 \
  --split-mode layer \
  --tensor-split 1,1 \
  --n-gpu-layers 99 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 40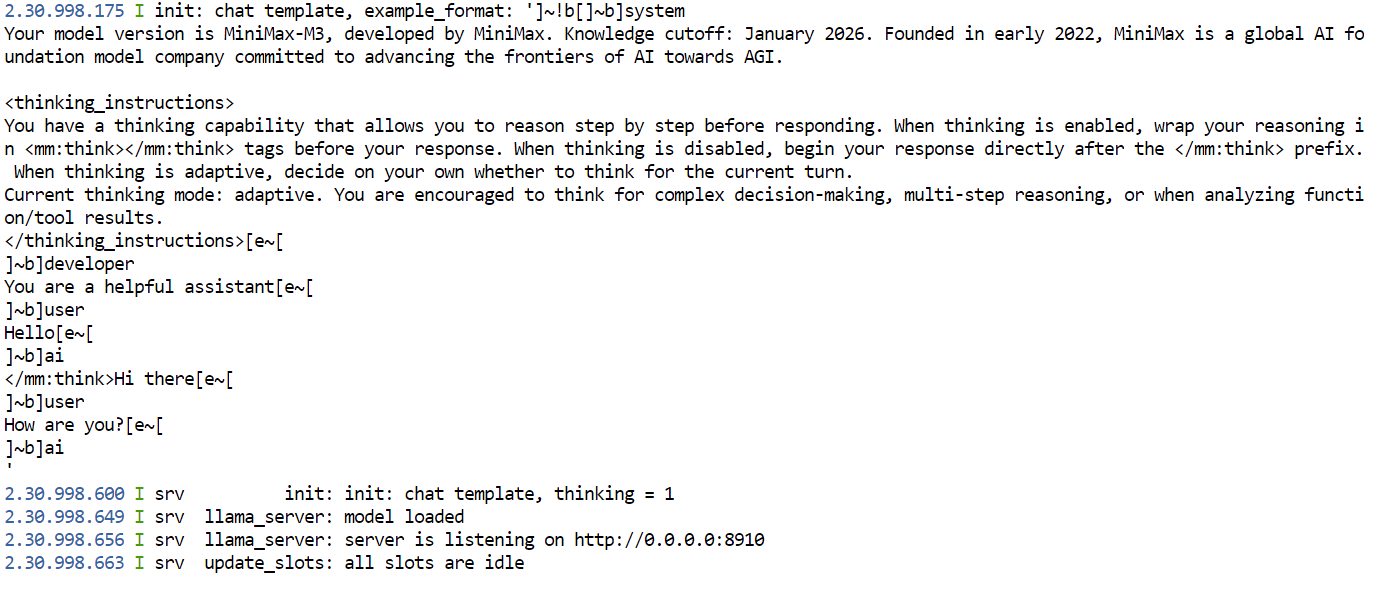
यह कमांड MiniMax M3 को दोनों RTX PRO 6000 GPUs में लोड करता है। --tensor-split 1,1 सेटिंग मॉडल को GPUs के बीच बराबर बाँटती है, जबकि --n-gpu-layers 99 मॉडल के अधिकतम हिस्से को GPU मेमोरी में रखता है।
सर्वर पोर्ट 8910 पर चलता है और llama.cpp वेब इंटरफ़ेस तथा OpenAI‑compatible API—दोनों प्रदान करता है। मॉडल रन होने तक इस टर्मिनल को खुला रखें।
8K कॉन्टेक्स्ट विंडो से शुरुआत करें। यह प्रयोगात्मक llama.cpp ब्रांच MiniMax Sparse Attention के बजाय डेंस अटेंशन का उपयोग करती है, इसलिए बहुत बड़ा कॉन्टेक्स्ट विंडो मेमोरी समस्याएँ पैदा कर सकता है। सर्वर स्थिर होने पर, आप --ctx-size 16384 आज़मा सकते हैं।
एक और JupyterLab टर्मिनल खोलें और निम्न कमांड चलाएँ, यह सुनिश्चित करने के लिए कि दोनों GPUs उपयोग हो रहे हैं:
nvidia-smiमॉडल लोड होने के बाद, दोनों GPUs पर VRAM उपयोग काफ़ी दिखना चाहिए।
नया JupyterLab टर्मिनल खोलें और पहले पुष्टि करें कि सर्वर चल रहा है और MiniMax M3 लोड हो चुका है:
curl -s http://127.0.0.1:8910/v1/models \
  | python3 -c "import sys, json; print(json.load(sys.stdin)['data'][0]['id'])"
आपको ऐसा मॉडल ID दिखना चाहिए:
MiniMax-M3-UD-IQ3_XXS-00001-of-00005.ggufइसके बाद OpenAI‑compatible चैट कम्प्लीशन एंडपॉइंट पर एक टेस्ट रिक्वेस्ट भेजें:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMax-M3-UD-IQ3_XXS-00001-of-00005.gguf",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function that checks whether a number is prime."
      }
    ],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 512
  }'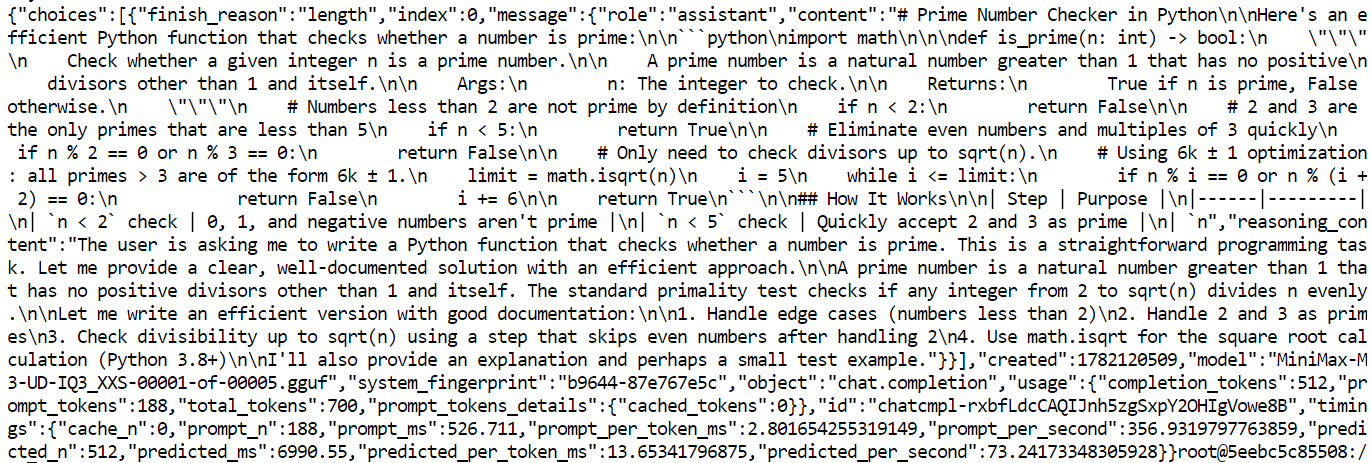
आपका लोकल MiniMax M3 सर्वर सही तरह से काम कर रहा है।
इसने एक कुशल Python is_prime() फ़ंक्शन जेनरेट किया, जिसमें math.isqrt() और 6k ± 1 ऑप्टिमाइज़ेशन का उपयोग हुआ।
रिस्पॉन्स कट गया क्योंकि यह आपके max_tokens लिमिट 512 तक पहुँच गया, जैसा कि दिखता है: "finish_reason": "length"
इस टेस्ट में, सर्वर ने प्रॉम्प्ट को लगभग 357 टोकन/सेकंड की दर से प्रोसेस किया और लगभग 73 टोकन/सेकंड की दर से टेक्स्ट जेनरेट किया।
आपकी स्पीड कॉन्टेक्स्ट लंबाई, GPU लोड, और प्रॉम्प्ट आकार पर निर्भर कर सकती है।
क्योंकि पोर्ट 8910 RunPod के माध्यम से एक्सपोज़ है, आप बिल्ट‑इन llama.cpp वेब इंटरफ़ेस से भी MiniMax M3 को टेस्ट कर सकते हैं।
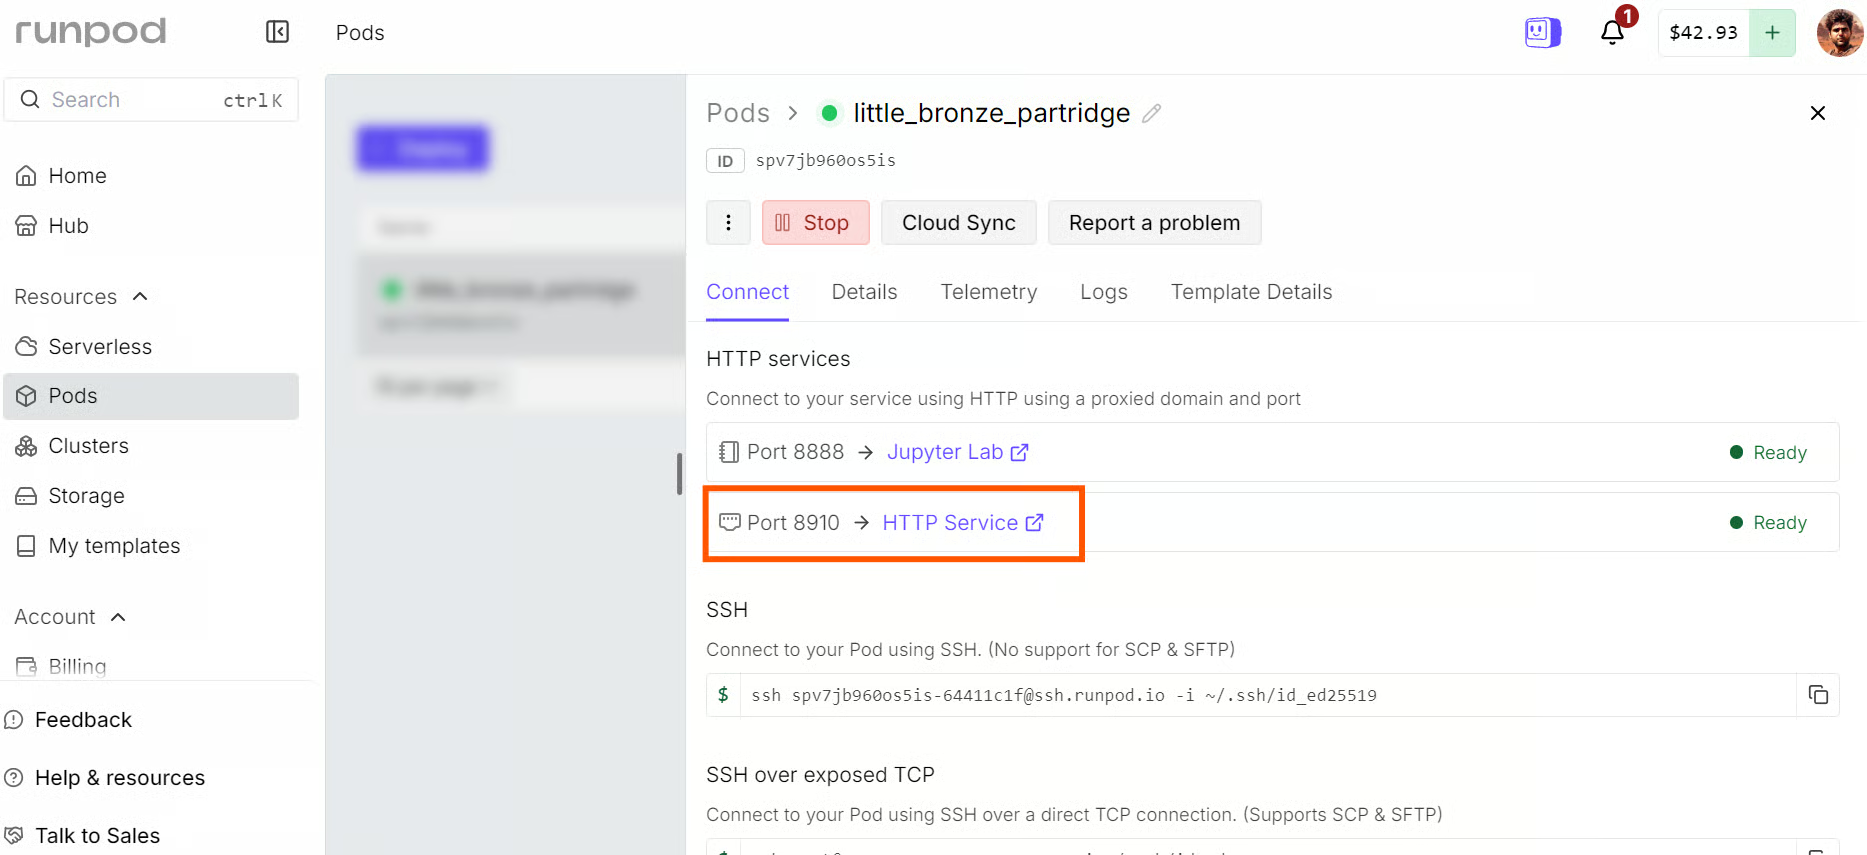
RunPod डैशबोर्ड में, अपना Pod खोलें और Connect बटन पर क्लिक करें। Exposed HTTP ports के अंतर्गत, पोर्ट 8910 के लिंक का चयन करें।
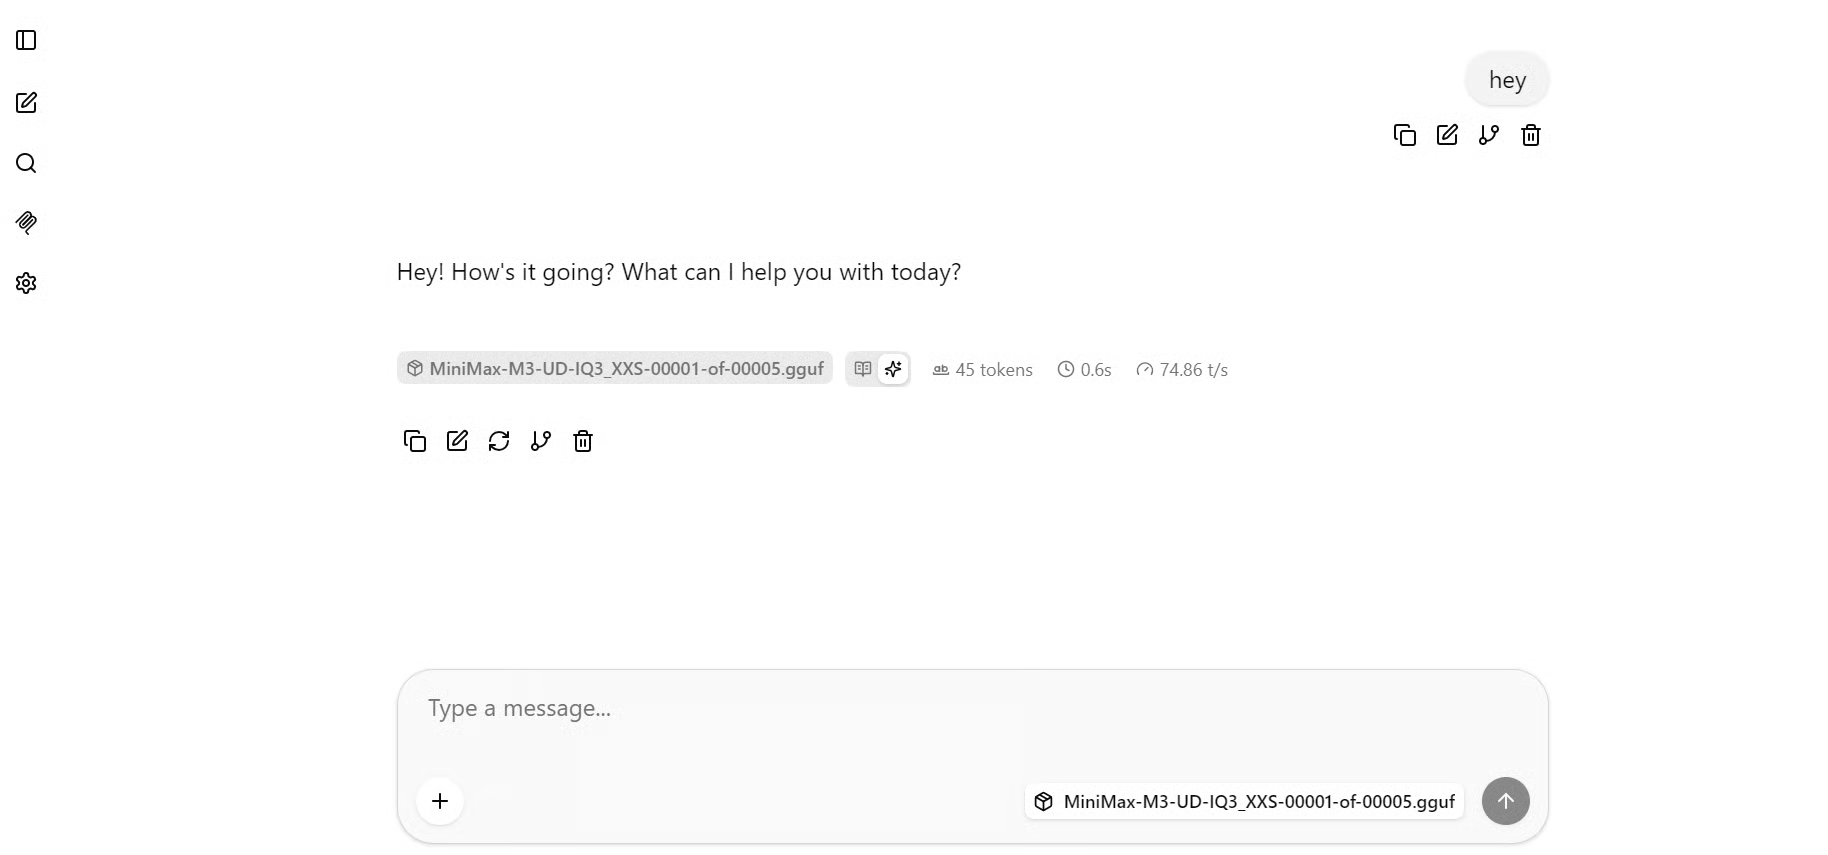
यह आपके ब्राउज़र में llama.cpp वेब इंटरफ़ेस खोलता है। यह हल्का ChatGPT‑शैली का चैट ऐप जैसा काम करता है, और लोकली चल रहा MiniMax M3 मॉडल पहले से चुना हुआ रहता है। अब आप बिना टर्मिनल या API के भी प्रॉम्प्ट भेजकर मॉडल टेस्ट कर सकते हैं।
व्यावहारिक परीक्षण के लिए, मैंने MiniMax M3 से मशीन लर्निंग मॉडल सर्व करने के लिए एक Python वेब इंटरफ़ेस बनाने को कहा। इसने मॉडल स्विचिंग, JSON प्रेडिक्शन रिक्वेस्ट, CSV बैच अपलोड, लाइव WebSocket स्ट्रीमिंग, मॉडल रजिस्ट्री, हेल्थ एंडपॉइंट्स, स्ट्रक्चर्ड लॉगिंग, टेस्ट्स, और Docker सेटअप सहित विस्तृत FastAPI‑आधारित डैशबोर्ड डिज़ाइन बनाया।
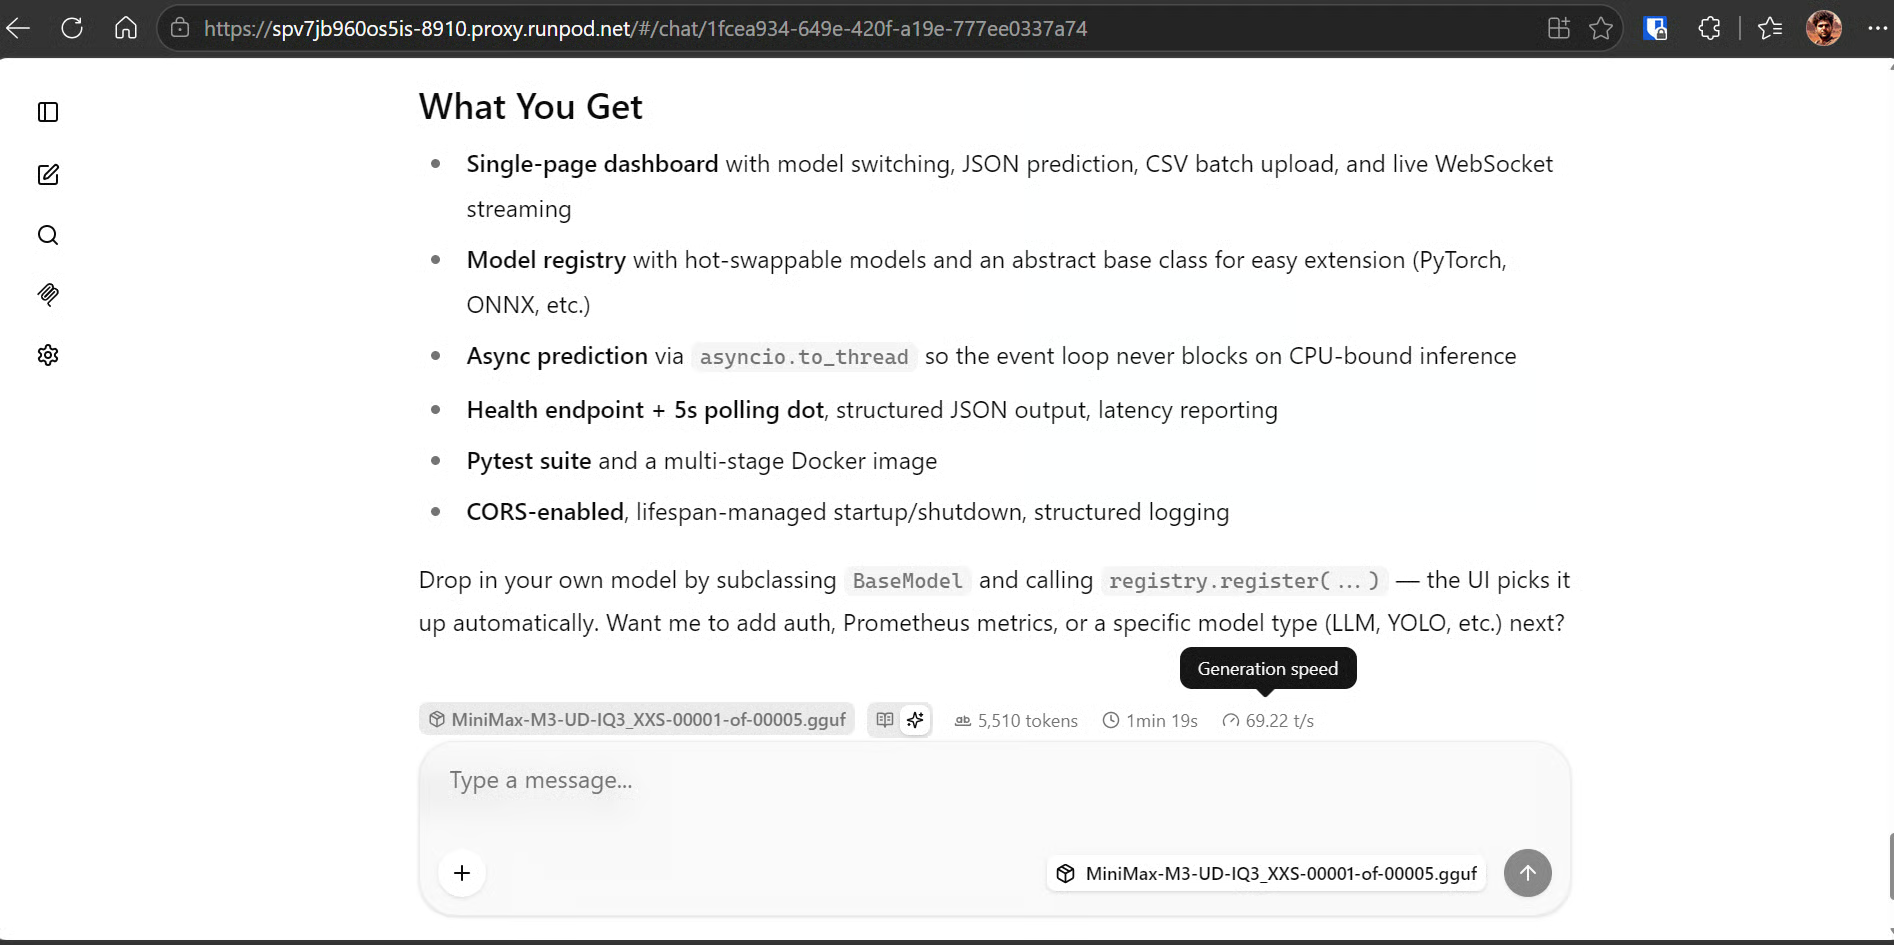
रिस्पॉन्स ने 1 मिनट 19 सेकंड में 5,510 टोकन जेनरेट किए, लगभग 69 टोकन/सेकंड की दर से।
दो RTX PRO 6000 GPUs पर चल रहे 3‑बिट लोकल क्वांटाइज़ेशन के लिए, यह एक मज़बूत परिणाम है और दिखाता है कि MiniMax M3 लंबे कोडिंग रिक्वेस्ट्स को इंटरैक्टिव स्पीड पर संभाल सकता है।
Pi एक टर्मिनल‑आधारित कोडिंग एजेंट है जो आपके लोकल प्रोजेक्ट फ़ाइलों के साथ सीधे काम कर सकता है, कमांड चला सकता है, कोड निरीक्षण कर सकता है, और आपके लोकली होस्टेड MiniMax M3 मॉडल का उपयोग कर सकता है।
तीसरा JupyterLab टर्मिनल खोलें। पहला टर्मिनल llama-server चलाता रहने दें, फिर इस टर्मिनल का उपयोग Pi इंस्टॉल और कॉन्फ़िगर करने के लिए करें।
Pi को आधिकारिक इंस्टॉलेशन स्क्रिप्ट से इंस्टॉल करें:
curl -fsSL https://pi.dev/install.sh | sh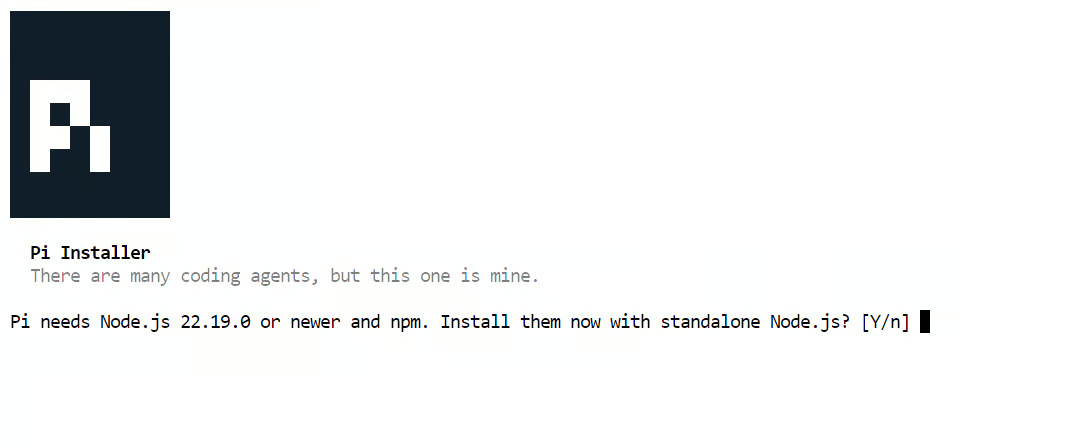 यदि इंस्टॉलर पूछे कि क्या वह Node.js इंस्टॉल कर दे, तो Y टाइप करें और Enter दबाएँ। इसके बाद Pi अपना आवश्यक Node.js रनटाइम और pi कमांड‑लाइन टूल इंस्टॉल कर देगा।
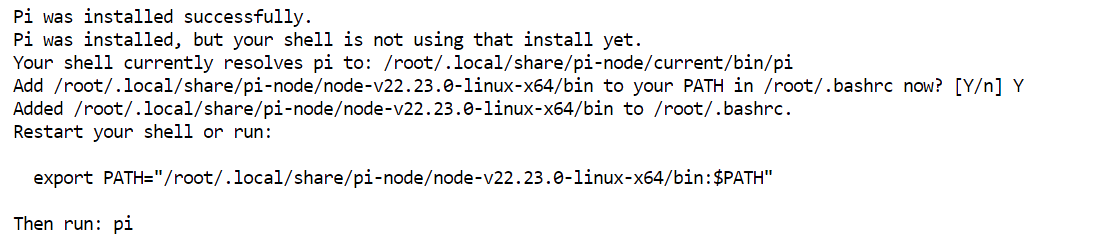
इंस्टॉलेशन पूरा होने पर, इंस्टॉलर शेल एनवायरनमेंट अपडेट करने के लिए कोई कमांड दिखा सकता है। वह कमांड चलाएँ, फिर शेल रीस्टार्ट करें:
exec bash -lपुष्टि करें कि Pi उपलब्ध है:
pi --versionआपको इंस्टॉल किया हुआ Pi संस्करण नंबर दिखना चाहिए।
0.79.10Pi एक models.json फ़ाइल के माध्यम से कस्टम OpenAI‑compatible प्रोवाइडर्स सपोर्ट करता है। Pi का कॉन्फ़िगरेशन डायरेक्टरी बनाएँ:
mkdir -p ~/.pi/agentफिर प्रोवाइडर कॉन्फ़िगरेशन बनाएँ:
cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "local-minimax": {
      "baseUrl": "http://127.0.0.1:8910/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "compat": {
        "supportsDeveloperRole": false,
        "supportsReasoningEffort": false,
        "supportsUsageInStreaming": false,
        "maxTokensField": "max_tokens"
      },
      "models": [
        {
          "id": "MiniMax-M3-UD-IQ3_XXS-00001-of-00005.gguf",
          "name": "MiniMax M3 Local 3-bit",
          "reasoning": false,
          "input": ["text"],
          "contextWindow": 8192,
          "maxTokens": 2048,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
यह कॉन्फ़िगरेशन Pi को पोर्ट 8910 पर चल रहे लोकल llama.cpp सर्वर का उपयोग करने के लिए कहता है। openai-completions API सेटिंग, llama.cpp के OpenAI‑compatible चैट कम्प्लीशन एंडपॉइंट से मेल खाती है।
कम्पैटिबिलिटी सेटिंग्स Pi को ऐसे फ़ील्ड या मैसेज रोल भेजने से रोकती हैं जो कुछ लोकल OpenAI‑compatible सर्वरों पर समस्याएँ पैदा कर सकते हैं। विशेष रूप से, Pi नए developer रोल के बजाय मानक system रोल का उपयोग करेगा और max_tokens भेजेगा, जिसकी llama.cpp अपेक्षा करता है।
मॉडल को केवल टेक्स्ट‑आधारित और 8K कॉन्टेक्स्ट विंडो के साथ सूचीबद्ध किया गया है, जो आपने पहले शुरू किए सर्वर कॉन्फ़िगरेशन से मेल खाता है। कॉस्ट मान शून्य हैं, क्योंकि MiniMax M3 आपके RunPod इंस्टेंस पर लोकली चल रहा है, किसी पेड API के माध्यम से नहीं।
Pi के लिए नया JupyterLab टर्मिनल खोलें। अधिक आरामदायक कोडिंग‑एजेंट अनुभव के लिए, JupyterLab में Settings → Theme → JupyterLab Dark चुनकर डार्क मोड सक्षम करें।
इसके बाद, वह प्रोजेक्ट क्लोन करें जिस पर आप MiniMax M3 से काम कराना चाहते हैं:
cd /workspace

git clone https://github.com/kingabzpro/semantic-web-cache
cd semantic-web-cache
Pi लॉन्च करें:
piPi के अंदर, टाइप करें:
/modellocal खोजें, फिर MiniMax M3 Local 3‑bit चुनें। Pi को लोकल प्रोवाइडर दिखाना चाहिए और पुष्टि करनी चाहिए कि MiniMax M3 GGUF मॉडल चुना गया है।
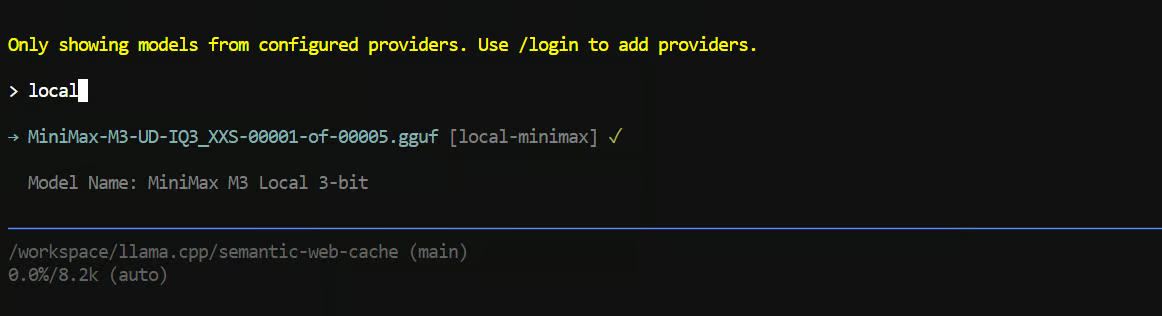
रीड‑ओनली टास्क से शुरुआत करें ताकि Pi बिना कोई फ़ाइल बदले रिपॉजिटरी का निरीक्षण कर सके। उदाहरण के लिए:
"Read the README.md file and explain how this project is structured."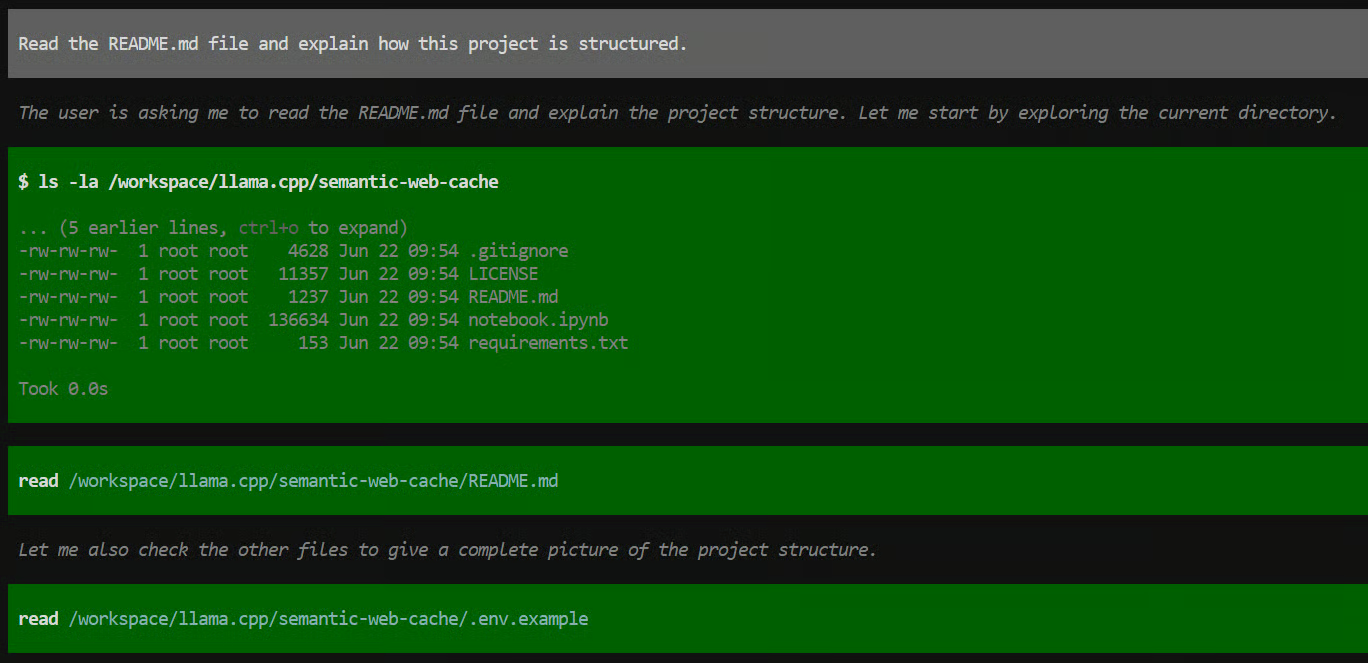
Pi रिपॉजिटरी का पता लगाने, README देखने और सहायक फ़ाइलों जैसे .env.example, requirements.txt और Jupyter नोटबुक की समीक्षा करने के लिए ls और read जैसे टर्मिनल टूल का उपयोग करेगा।
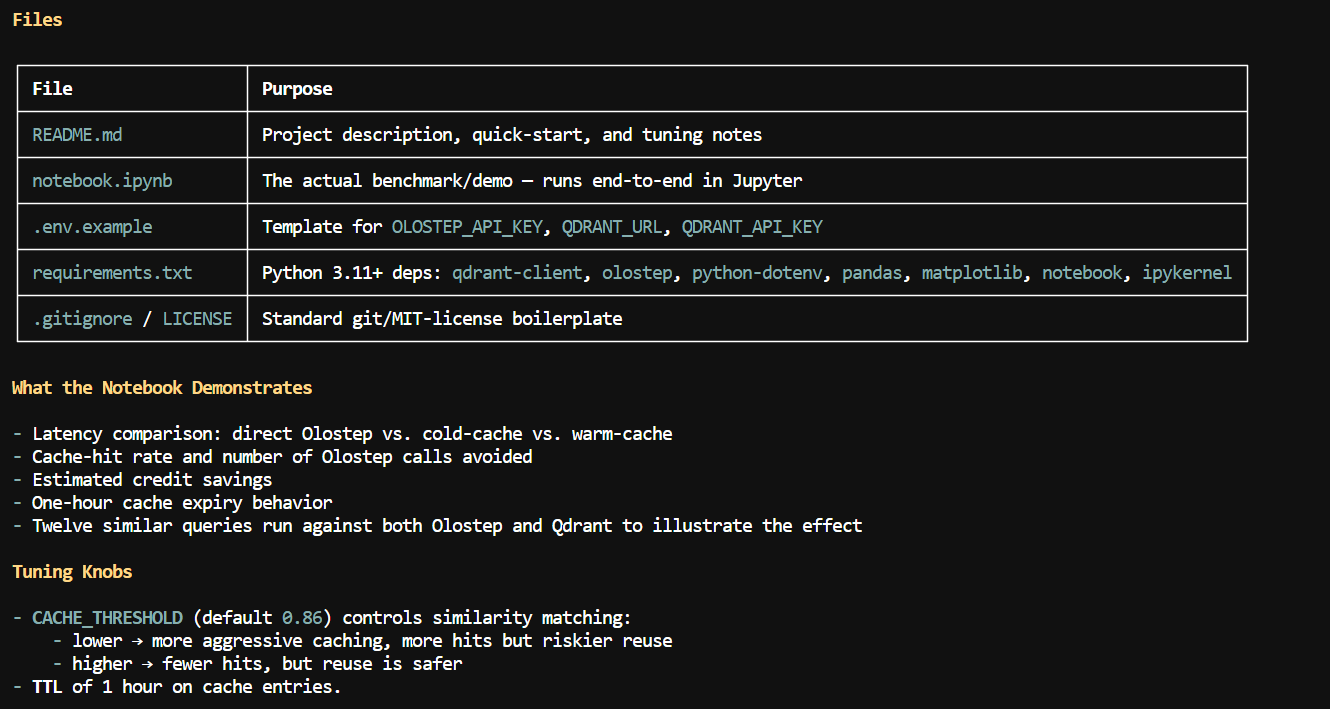
इस उदाहरण में, MiniMax M3 ने मुख्य प्रोजेक्ट फ़ाइलों की सही पहचान की और समझाया कि यह रिपॉजिटरी Olostep और Qdrant के साथ बनाई गई एक सेमांटिक कैशिंग डेमो है।
इसने नोटबुक‑आधारित वर्कफ़्लो, APIs के लिए आवश्यक एनवायरनमेंट वेरिएबल्स, कैश थ्रेशहोल्ड और TTL सेटिंग्स, तथा प्रोजेक्ट में शामिल लेटेंसी, कैश‑हिट और क्रेडिट‑सेविंग इवैल्यूएशन्स को हाइलाइट किया।
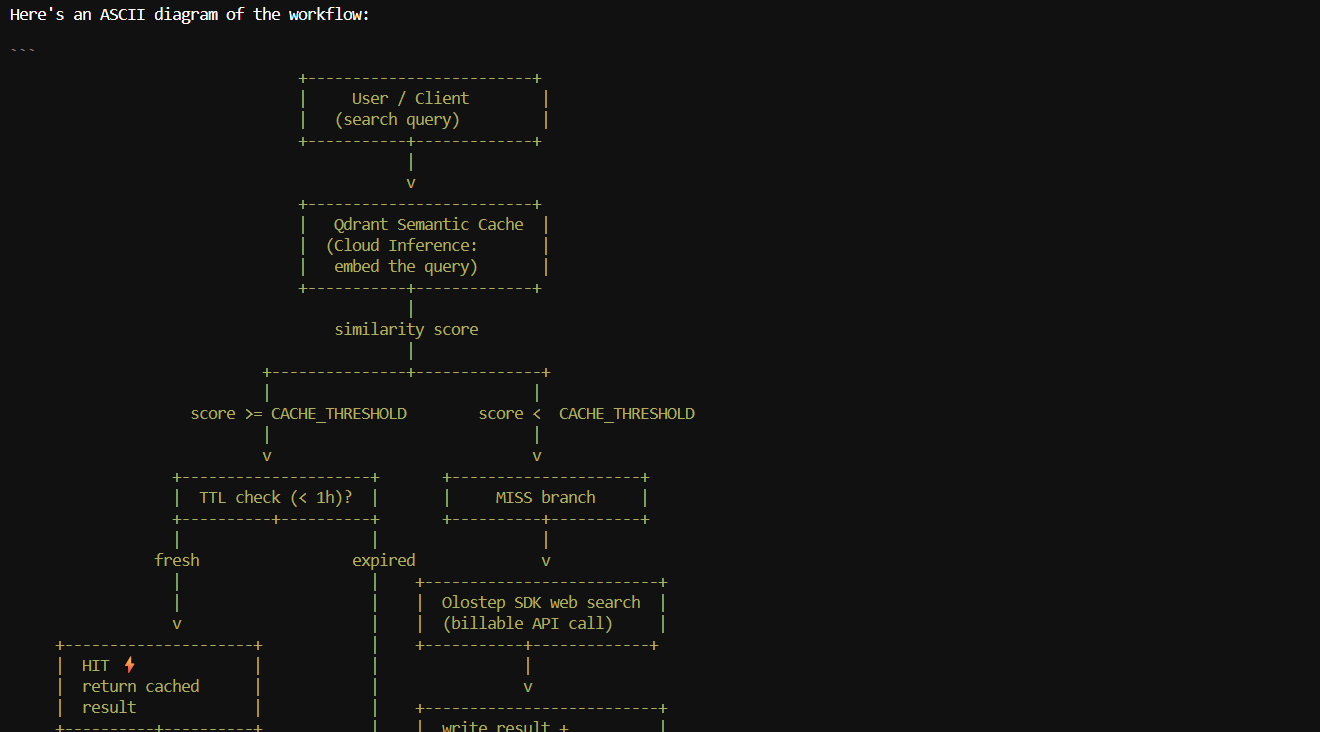
मैंने इससे सेमांटिक कैश पाइपलाइन का एक ASCII वर्कफ़्लो डायग्राम बनाने को भी कहा। इसने एक साफ़ फ़्लो बनाया, जिसमें दिखाया गया कि उपयोगकर्ता क्वेरी को कैसे एम्बेड किया जाता है, Qdrant कैश के ख़िलाफ़ जाँचा जाता है, सिमिलैरिटी थ्रेशहोल्ड के अनुसार आंका जाता है, और या तो कैश से लौटाया जाता है या Olostep को भेजा जाता है, उसके बाद परिणाम स्टोर किया जाता है।
बड़ी रिपॉजिटरीज़ या गहरे मल्टी‑स्टेप टास्क्स के लिए, आपको बड़े कॉन्टेक्स्ट विंडो की ज़रूरत हो सकती है। llama-server कमांड में --ctx-size मान अपडेट करें और सर्वर रीस्टार्ट करें। इसे 8192 से बढ़ाकर 16384 करें, फिर यदि GPU मेमोरी उपलब्ध रहे तो 32768 टेस्ट करें।
सीधे 100K कॉन्टेक्स्ट विंडो पर न जाएँ। यह प्रयोगात्मक MiniMax M3 llama.cpp ब्रांच MiniMax Sparse Attention के बजाय डेंस अटेंशन का उपयोग करती है, इसलिए बहुत बड़े कॉन्टेक्स्ट मेमोरी उपयोग को काफ़ी बढ़ा सकते हैं और out‑of‑memory त्रुटियाँ हो सकती हैं।
MiniMax M3 को लोकली चलाने के बाद, मुझे लगता है कि यह अत्यधिक बड़े कोडिंग मॉडलों—जैसे GLM 5.2 या Kimi K2.7 Code—को चलाने की तुलना में कहीं बेहतर संतुलन देता है।
वे मॉडल कुछ मामलों में अधिक शक्तिशाली हो सकते हैं, लेकिन उन्हें कहीं अधिक GPU मेमोरी चाहिए और लोकल रूप से किराये पर लेकर सर्व करना बहुत महँगा हो सकता है।
MiniMax M3 के साथ, मैं दो RTX PRO 6000 GPUs पर एक सक्षम कोडिंग और एजेंटिक मॉडल चला सका, इसे ब्राउज़र इंटरफ़ेस से उपयोग किया, OpenAI‑compatible API के माध्यम से एक्सपोज़ किया, और Pi से लोकल कोडिंग एजेंट के रूप में कनेक्ट किया।
मेरे टेस्ट में, यह लगभग 70 टोकन/सेकंड की दर से जेनरेट करता रहा और रिपॉजिटरी एक्सप्लोरेशन, README विश्लेषण, कमांड निष्पादन, प्रोजेक्ट व्याख्या, और वर्कफ़्लो डायग्राम को अच्छी तरह संभाला।
हालाँकि सेटअप अभी परफेक्ट नहीं है। llama.cpp सपोर्ट अब भी प्रयोगात्मक है, Sparse Attention उपलब्ध नहीं है, और कॉन्टेक्स्ट विंडो को तब तक अपेक्षाकृत छोटा रखना होगा जब तक आपके पास अधिक VRAM न हो। फिर भी, लोकली चल रहे 3‑बिट क्वांटाइज़्ड मॉडल के लिए परिणाम प्रभावशाली थे।
शीर्ष DataCamp कोर्स
कोर्स
लर्निंग पाथ
लर्निंग पाथ