

在线运行和编辑此教程中的代码
运行代码| month | demand | |
|---|---|---|
| 0 | 1 | 290 |
| 1 | 2 | 260 |
| 2 | 3 | 288 |
| 3 | 4 | 300 |
| 4 | 5 | 310 |
让我们计算窗口大小为 3 的 SMA,这意味着每次将取三个值来计算移动平均,对于每个新值,最早的值将被忽略。
为此,您将使用 pandas 的 iloc 函数。由于您需要的是 demand 列,因此在 iloc 中固定该列的位置,而行使用变量 i,不断迭代直到抵达数据框末尾。
for i in range(0,df.shape[0]-2):
df.loc[df.index[i+2],'SMA_3'] = np.round(((df.iloc[i,1]+ df.iloc[i+1,1] +df.iloc[i+2,1])/3),1)| month | demand | SMA_3 | |
|---|---|---|---|
| 0 | 1 | 290 | NaN |
| 1 | 2 | 260 | NaN |
| 2 | 3 | 288 | 279.3 |
| 3 | 4 | 300 | 282.7 |
| 4 | 5 | 310 | 299.3 |
为进行合理性检查,我们也使用 pandas 内置的 rolling 函数,看看是否与我们基于自定义 Python 的简单移动平均一致。
df['pandas_SMA_3'] = df.iloc[:,1].rolling(window=3).mean()df.head()| month | demand | SMA_3 | pandas_SMA_3 | |
|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 |
| 3 | 4 | 300 | 282.7 | 282.666667 |
| 4 | 5 | 310 | 299.3 | 299.333333 |
很好,如您所见,自定义方法与 pandas 的移动平均完全一致,说明您对 SMA 的实现是正确的。
我们也快速计算一下 window_size 为 4 的简单移动平均。
for i in range(0,df.shape[0]-3):
df.loc[df.index[i+3],'SMA_4'] = np.round(((df.iloc[i,1]+ df.iloc[i+1,1] +df.iloc[i+2,1]+df.iloc[i+3,1])/4),1)
df.head()
| month | demand | SMA_3 | pandas_SMA_3 | SMA_4 | |
|---|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 | NaN |
| 3 | 4 | 300 | 282.7 | 282.666667 | 284.5 |
| 4 | 5 | 310 | 299.3 | 299.333333 | 289.5 |
df['pandas_SMA_4'] = df.iloc[:,1].rolling(window=4).mean()
df.head()
| month | demand | SMA_3 | pandas_SMA_3 | SMA_4 | pandas_SMA_4 | |
|---|---|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 | NaN | NaN |
| 3 | 4 | 300 | 282.7 | 282.666667 | 284.5 | 284.5 |
| 4 | 5 | 310 | 299.3 | 299.333333 | 289.5 | 289.5 |
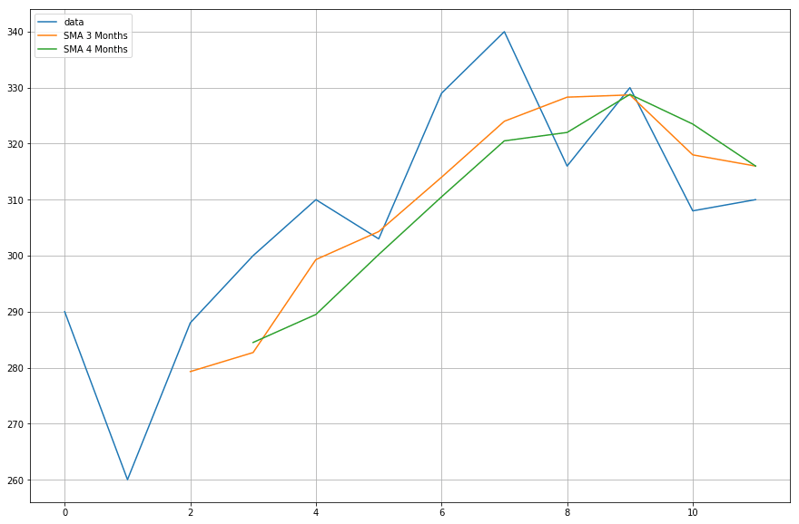
现在,您将把计算出的移动平均数据绘制出来。
import matplotlib.pyplot as plt
%matplotlib inlineplt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df['demand'],label='data')
plt.plot(df['SMA_3'],label='SMA 3 Months')
plt.plot(df['SMA_4'],label='SMA 4 Months')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x11fe15080>
累积移动平均
我认为我们现在可以转向一个真实的数据集了。
对于累积移动平均,我们来使用一个空气质量数据集,可从此链接下载。
df = pd.read_csv("AirQualityUCI/AirQualityUCI.csv", sep = ";", decimal = ",")
df = df.iloc[ : , 0:14]
df.head()
| Date | Time | CO(GT) | PT08.S1(CO) | NMHC(GT) | C6H6(GT) | PT08.S2(NMHC) | NOx(GT) | PT08.S3(NOx) | NO2(GT) | PT08.S4(NO2) | PT08.S5(O3) | T | RH | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 10/03/2004 | 18.00.00 | 2.6 | 1360.0 | 150.0 | 11.9 | 1046.0 | 166.0 | 1056.0 | 113.0 | 1692.0 | 1268.0 | 13.6 | 48.9 |
| 1 | 10/03/2004 | 19.00.00 | 2.0 | 1292.0 | 112.0 | 9.4 | 955.0 | 103.0 | 1174.0 | 92.0 | 1559.0 | 972.0 | 13.3 | 47.7 |
| 2 | 10/03/2004 | 20.00.00 | 2.2 | 1402.0 | 88.0 | 9.0 | 939.0 | 131.0 | 1140.0 | 114.0 | 1555.0 | 1074.0 | 11.9 | 54.0 |
| 3 | 10/03/2004 | 21.00.00 | 2.2 | 1376.0 | 80.0 | 9.2 | 948.0 | 172.0 | 1092.0 | 122.0 | 1584.0 | 1203.0 | 11.0 | 60.0 |
| 4 | 10/03/2004 | 22.00.00 | 1.6 | 1272.0 | 51.0 | 6.5 | 836.0 | 131.0 | 1205.0 | 116.0 | 1490.0 | 1110.0 | 11.2 | 59.6 |
在处理数据时,预处理是必不可少的一步。对于数值型数据,最常见的预处理步骤之一是检查 NaN(空值)。如果存在 NaN 值,您可以用 0、平均值、前一个或后一个值替换,或者直接删除。尽管通常替换优于删除,但由于该数据集的空值较少,删除它们不会影响序列的连续性。
df.isna().sum()
Date 114
Time 114
CO(GT) 114
PT08.S1(CO) 114
NMHC(GT) 114
C6H6(GT) 114
PT08.S2(NMHC) 114
NOx(GT) 114
PT08.S3(NOx) 114
NO2(GT) 114
PT08.S4(NO2) 114
PT08.S5(O3) 114
T 114
RH 114
dtype: int64
从以上输出可以看到,各列大约有 114 个 NaN 值,不过您会发现它们都位于时间序列的末尾,因此我们快速将其删除。
df.dropna(inplace=True)
df.isna().sum()
Date 0
Time 0
CO(GT) 0
PT08.S1(CO) 0
NMHC(GT) 0
C6H6(GT) 0
PT08.S2(NMHC) 0
NOx(GT) 0
PT08.S3(NOx) 0
NO2(GT) 0
PT08.S4(NO2) 0
PT08.S5(O3) 0
T 0
RH 0
dtype: int64
您将把累积移动平均应用于温度列(T),因此先从完整数据中快速分离出该列。
df_T = pd.DataFrame(df.iloc[:,-2])
df_T.head()
| T | |
|---|---|
| 0 | 13.6 |
| 1 | 13.3 |
| 2 | 11.9 |
| 3 | 11.0 |
| 4 | 11.2 |
现在,您将使用 pandas 的 expanding 方法来求上述数据的累积平均。回顾一下,在介绍部分中,与简单移动平均不同,累积移动平均在计算平均值时会考虑之前的所有数值。
df_T['CMA_4'] = df_T.expanding(min_periods=4).mean()
df_T.head(10)
| T | CMA_4 | |
|---|---|---|
| 0 | 13.6 | NaN |
| 1 | 13.3 | NaN |
| 2 | 11.9 | NaN |
| 3 | 11.0 | 12.450000 |
| 4 | 11.2 | 12.200000 |
| 5 | 11.2 | 12.033333 |
| 6 | 11.3 | 11.928571 |
| 7 | 10.7 | 11.775000 |
| 8 | 10.7 | 11.655556 |
| 9 | 10.3 | 11.520000 |
时间序列数据需相对于时间进行绘图,因此我们将日期和时间列合并并转换为 datetime 对象。为此,您将使用 Python 的 datetime 模块(来源:Time Series Tutorial)。
import datetime
df['DateTime'] = (df.Date) + ' ' + (df.Time)
df.DateTime = df.DateTime.apply(lambda x: datetime.datetime.strptime(x, '%d/%m/%Y %H.%M.%S'))
让我们将 temperature 数据框的索引改为 datetime。
df_T.index = df.DateTime
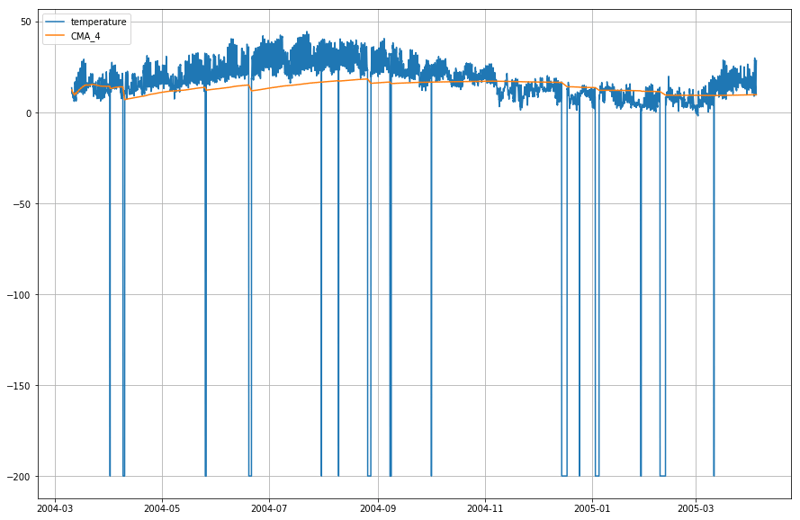
现在,我们将随时间绘制实际温度与累积移动平均。
plt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df_T['T'],label='temperature')
plt.plot(df_T['CMA_4'],label='CMA_4')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x1210a2d30>
指数移动平均
df_T['EMA'] = df_T.iloc[:,0].ewm(span=40,adjust=False).mean()
df_T.head()
| T | CMA_4 | EMA | |
|---|---|---|---|
| DateTime | |||
| 2004-03-10 18:00:00 | 13.6 | NaN | 13.600000 |
| 2004-03-10 19:00:00 | 13.3 | NaN | 13.585366 |
| 2004-03-10 20:00:00 | 11.9 | NaN | 13.503153 |
| 2004-03-10 21:00:00 | 11.0 | 12.45 | 13.381048 |
| 2004-03-10 22:00:00 | 11.2 | 12.20 | 13.274655 |
plt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df_T['T'],label='temperature')
plt.plot(df_T['CMA_4'],label='CMA_4')
plt.plot(df_T['EMA'],label='EMA')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x14b2a41d0>
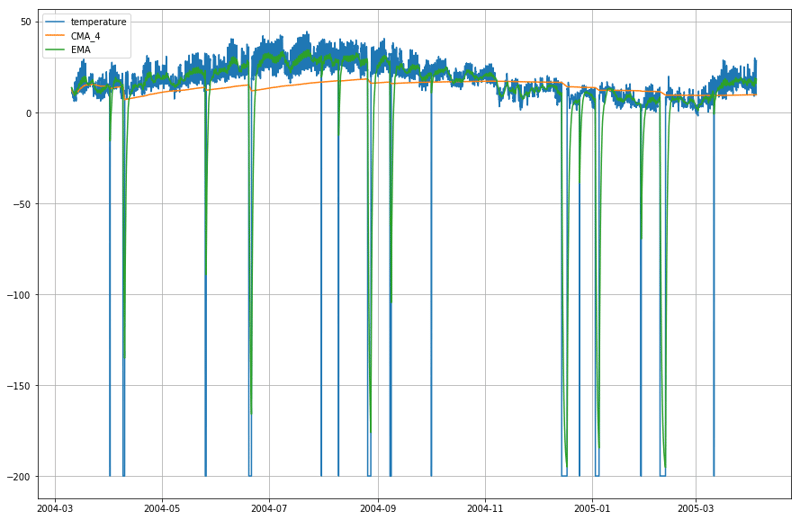
哇!正如您从上图所见,指数移动平均(EMA)在捕捉数据模式方面表现出色,而累积移动平均(CMA)则明显逊色。
更进一步
恭喜您完成本教程。
本教程为您计算数据的移动平均并理解其意义提供了一个良好的起点。
尝试在不使用 pandas 库的情况下,自己编写累积与指数移动平均的 Python 代码。这将让您更深入地理解它们的计算方式以及彼此的不同之处。
仍有许多内容值得尝试。试着计算输入数据与移动平均之间的偏自相关,并尝试找出它们之间的关系。
如果您想进一步学习 pandas 中的 DataFrame,请参加 DataCamp 的交互式课程 pandas Foundations。
参考资料:
如对本教程有任何疑问,欢迎在下方评论区留言。
简介
移动平均(也称为滚动平均或运行平均)用于通过对完整数据集的不同子集计算平均值来分析时间序列数据。由于它涉及对随时间变化的数据集取平均值,因此也称为移动均值(MM)或滚动均值。
滚动平均可以通过多种方式计算,其中一种方法是从一串完整的数字中取一个固定子集。第一个移动平均通过对第一个固定子集求平均得到,然后通过向前移动到下一个固定子集来更换子集(在子组中包含未来值,同时从序列中排除之前的数字)。
移动平均多用于时间序列数据,在关注长期趋势的同时捕捉短期波动。
时间序列数据的几个示例包括股票价格、天气报告、空气质量、国内生产总值、就业等。
一般而言,移动平均可以平滑数据。
移动平均是许多算法的基础,其中之一是自回归积分移动平均模型(ARIMA),它使用移动平均来对时间序列数据进行预测。
移动平均的类型有多种:
简单移动平均(SMA):简单移动平均(SMA)使用滑动窗口在设定的时间周期上取平均。它是对前面n个数据的等权均值。
为了进一步理解 SMA,我们来看一个示例:一列n个值:
那么对n个数据点的等权滚动平均,本质上就是前 M 个数据点的平均值,其中 M 为滑动窗口的大小:
类似地,在计算后续的滚动平均值时,会将一个新值加入求和中,同时剔除前一时间段的值。由于您已有前几个时间段的平均值,因此每次都无需完整求和:
由于 EMA 对近期数据的权重高于较早数据,与 SMA 相比,它对最新价格变化更为敏感,使得 EMA 的结果更及时,因此更受青睐。
理论够多了,对吧?让我们直接进入移动平均的实践实现。
在时间序列数据上实现移动平均
简单移动平均(SMA)
首先,我们创建一些虚拟的时间序列数据,并仅使用 Python 来尝试实现 SMA。
假设某产品的需求被观察了 12 个月(1 年),您需要计算 3 个月和 4 个月窗口期的移动平均。
导入模块