

Chạy và chỉnh sửa mã từ hướng dẫn trực tuyến này
Chạy mã| month | demand | |
|---|---|---|
| 0 | 1 | 290 |
| 1 | 2 | 260 |
| 2 | 3 | 288 |
| 3 | 4 | 300 |
| 4 | 5 | 310 |
Hãy tính SMA cho kích thước cửa sổ là 3, nghĩa là mỗi lần bạn sẽ xét ba giá trị để tính trung bình động, và với mỗi giá trị mới, giá trị cũ nhất sẽ bị bỏ qua.
Để triển khai điều này, bạn sẽ dùng hàm iloc của pandas; vì cột demand là thứ bạn cần, bạn sẽ cố định vị trí của cột đó trong hàm iloc còn hàng sẽ là biến i mà bạn sẽ lặp cho đến cuối dataframe.
for i in range(0,df.shape[0]-2):
df.loc[df.index[i+2],'SMA_3'] = np.round(((df.iloc[i,1]+ df.iloc[i+1,1] +df.iloc[i+2,1])/3),1)| month | demand | SMA_3 | |
|---|---|---|---|
| 0 | 1 | 290 | NaN |
| 1 | 2 | 260 | NaN |
| 2 | 3 | 288 | 279.3 |
| 3 | 4 | 300 | 282.7 |
| 4 | 5 | 310 | 299.3 |
Để kiểm tra cho chắc, hãy dùng thêm hàm dựng sẵn rolling của pandas và xem liệu nó có khớp với trung bình động đơn giản do bạn tự viết bằng python hay không.
df['pandas_SMA_3'] = df.iloc[:,1].rolling(window=3).mean()df.head()| month | demand | SMA_3 | pandas_SMA_3 | |
|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 |
| 3 | 4 | 300 | 282.7 | 282.666667 |
| 4 | 5 | 310 | 299.3 | 299.333333 |
Tuyệt, như bạn thấy, trung bình động tự viết và của pandas khớp nhau chính xác, nghĩa là bạn đã triển khai SMA đúng.
Hãy nhanh chóng tính thêm trung bình động đơn giản cho window_size là 4.
for i in range(0,df.shape[0]-3):
df.loc[df.index[i+3],'SMA_4'] = np.round(((df.iloc[i,1]+ df.iloc[i+1,1] +df.iloc[i+2,1]+df.iloc[i+3,1])/4),1)
df.head()
| month | demand | SMA_3 | pandas_SMA_3 | SMA_4 | |
|---|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 | NaN |
| 3 | 4 | 300 | 282.7 | 282.666667 | 284.5 |
| 4 | 5 | 310 | 299.3 | 299.333333 | 289.5 |
df['pandas_SMA_4'] = df.iloc[:,1].rolling(window=4).mean()
df.head()
| month | demand | SMA_3 | pandas_SMA_3 | SMA_4 | pandas_SMA_4 | |
|---|---|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 | NaN | NaN |
| 3 | 4 | 300 | 282.7 | 282.666667 | 284.5 | 284.5 |
| 4 | 5 | 310 | 299.3 | 299.333333 | 289.5 | 289.5 |
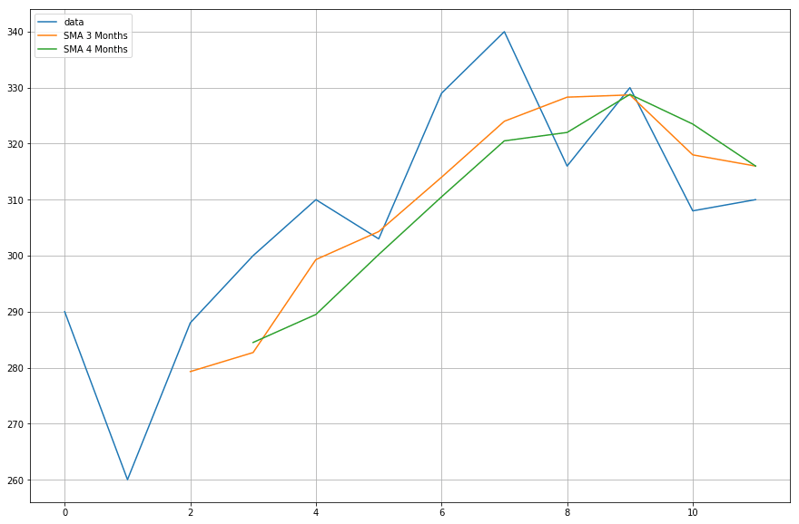
Bây giờ, bạn sẽ vẽ dữ liệu của các trung bình động đã tính.
import matplotlib.pyplot as plt
%matplotlib inlineplt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df['demand'],label='data')
plt.plot(df['SMA_3'],label='SMA 3 Months')
plt.plot(df['SMA_4'],label='SMA 4 Months')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x11fe15080>
Trung bình Động Tích lũy
Tôi nghĩ giờ chúng ta đã sẵn sàng chuyển sang một tập dữ liệu thực.
Đối với trung bình động tích lũy, hãy sử dụng một tập dữ liệu chất lượng không khí có thể tải về từ liên kết này.
df = pd.read_csv("AirQualityUCI/AirQualityUCI.csv", sep = ";", decimal = ",")
df = df.iloc[ : , 0:14]
df.head()
| Date | Time | CO(GT) | PT08.S1(CO) | NMHC(GT) | C6H6(GT) | PT08.S2(NMHC) | NOx(GT) | PT08.S3(NOx) | NO2(GT) | PT08.S4(NO2) | PT08.S5(O3) | T | RH | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 10/03/2004 | 18.00.00 | 2.6 | 1360.0 | 150.0 | 11.9 | 1046.0 | 166.0 | 1056.0 | 113.0 | 1692.0 | 1268.0 | 13.6 | 48.9 |
| 1 | 10/03/2004 | 19.00.00 | 2.0 | 1292.0 | 112.0 | 9.4 | 955.0 | 103.0 | 1174.0 | 92.0 | 1559.0 | 972.0 | 13.3 | 47.7 |
| 2 | 10/03/2004 | 20.00.00 | 2.2 | 1402.0 | 88.0 | 9.0 | 939.0 | 131.0 | 1140.0 | 114.0 | 1555.0 | 1074.0 | 11.9 | 54.0 |
| 3 | 10/03/2004 | 21.00.00 | 2.2 | 1376.0 | 80.0 | 9.2 | 948.0 | 172.0 | 1092.0 | 122.0 | 1584.0 | 1203.0 | 11.0 | 60.0 |
| 4 | 10/03/2004 | 22.00.00 | 1.6 | 1272.0 | 51.0 | 6.5 | 836.0 | 131.0 | 1205.0 | 116.0 | 1490.0 | 1110.0 | 11.2 | 59.6 |
Tiền xử lý là bước thiết yếu mỗi khi bạn làm việc với dữ liệu. Với dữ liệu số, một trong những bước tiền xử lý phổ biến nhất là kiểm tra các giá trị NaN (Null). Nếu có giá trị NaN, bạn có thể thay thế chúng bằng 0, hoặc bằng trung bình, hoặc bằng giá trị liền trước hay liền sau, hoặc thậm chí loại bỏ chúng. Dù thay thế thường là lựa chọn tốt hơn so với loại bỏ, nhưng vì tập dữ liệu này có ít giá trị NULL, việc loại bỏ chúng sẽ không ảnh hưởng đến tính liên tục của chuỗi.
df.isna().sum()
Date 114
Time 114
CO(GT) 114
PT08.S1(CO) 114
NMHC(GT) 114
C6H6(GT) 114
PT08.S2(NMHC) 114
NOx(GT) 114
PT08.S3(NOx) 114
NO2(GT) 114
PT08.S4(NO2) 114
PT08.S5(O3) 114
T 114
RH 114
dtype: int64
Từ kết quả trên, bạn có thể thấy có khoảng 114 giá trị NaN trên tất cả các cột, tuy nhiên bạn sẽ nhận ra rằng chúng đều nằm ở cuối chuỗi thời gian, nên hãy nhanh chóng loại bỏ chúng.
df.dropna(inplace=True)
df.isna().sum()
Date 0
Time 0
CO(GT) 0
PT08.S1(CO) 0
NMHC(GT) 0
C6H6(GT) 0
PT08.S2(NMHC) 0
NOx(GT) 0
PT08.S3(NOx) 0
NO2(GT) 0
PT08.S4(NO2) 0
PT08.S5(O3) 0
T 0
RH 0
dtype: int64
Bạn sẽ áp dụng trung bình động tích lũy lên cột Nhiệt độ (T), vì vậy hãy nhanh chóng tách cột đó ra khỏi toàn bộ dữ liệu.
df_T = pd.DataFrame(df.iloc[:,-2])
df_T.head()
| T | |
|---|---|
| 0 | 13.6 |
| 1 | 13.3 |
| 2 | 11.9 |
| 3 | 11.0 |
| 4 | 11.2 |
Bây giờ, bạn sẽ dùng phương thức expanding của pandas để tìm trung bình tích lũy của dữ liệu trên. Nếu bạn nhớ phần giới thiệu, khác với trung bình động đơn giản, trung bình động tích lũy xét tất cả các giá trị trước đó khi tính trung bình.
df_T['CMA_4'] = df_T.expanding(min_periods=4).mean()
df_T.head(10)
| T | CMA_4 | |
|---|---|---|
| 0 | 13.6 | NaN |
| 1 | 13.3 | NaN |
| 2 | 11.9 | NaN |
| 3 | 11.0 | 12.450000 |
| 4 | 11.2 | 12.200000 |
| 5 | 11.2 | 12.033333 |
| 6 | 11.3 | 11.928571 |
| 7 | 10.7 | 11.775000 |
| 8 | 10.7 | 11.655556 |
| 9 | 10.3 | 11.520000 |
Dữ liệu chuỗi thời gian được vẽ theo thời gian, nên hãy kết hợp cột ngày và giờ rồi chuyển thành đối tượng datetime. Để làm điều này, bạn sẽ dùng mô-đun datetime của python (Nguồn: Hướng dẫn Chuỗi thời gian).
import datetime
df['DateTime'] = (df.Date) + ' ' + (df.Time)
df.DateTime = df.DateTime.apply(lambda x: datetime.datetime.strptime(x, '%d/%m/%Y %H.%M.%S'))
Hãy đổi chỉ mục của dataframe temperature sang datetime.
df_T.index = df.DateTime
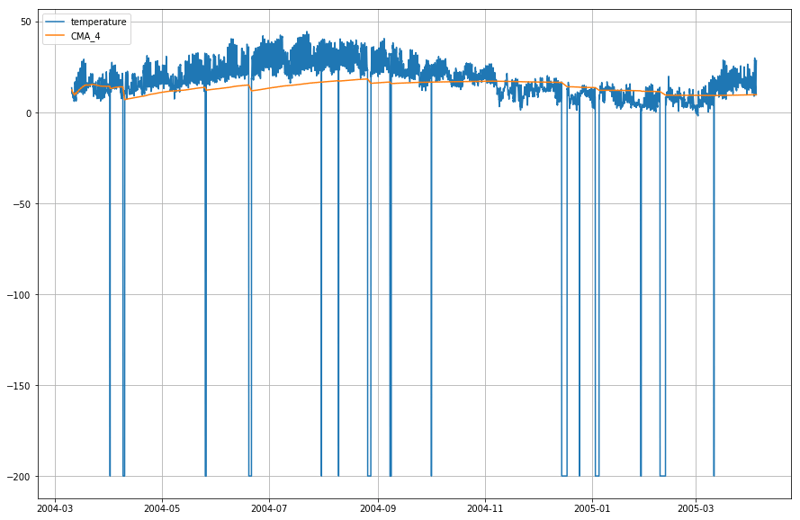
Giờ hãy vẽ nhiệt độ thực tế và trung bình động tích lũy theo thời gian.
plt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df_T['T'],label='temperature')
plt.plot(df_T['CMA_4'],label='CMA_4')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x1210a2d30>
Trung bình Động Hàm mũ
df_T['EMA'] = df_T.iloc[:,0].ewm(span=40,adjust=False).mean()
df_T.head()
| T | CMA_4 | EMA | |
|---|---|---|---|
| DateTime | |||
| 2004-03-10 18:00:00 | 13.6 | NaN | 13.600000 |
| 2004-03-10 19:00:00 | 13.3 | NaN | 13.585366 |
| 2004-03-10 20:00:00 | 11.9 | NaN | 13.503153 |
| 2004-03-10 21:00:00 | 11.0 | 12.45 | 13.381048 |
| 2004-03-10 22:00:00 | 11.2 | 12.20 | 13.274655 |
plt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df_T['T'],label='temperature')
plt.plot(df_T['CMA_4'],label='CMA_4')
plt.plot(df_T['EMA'],label='EMA')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x14b2a41d0>
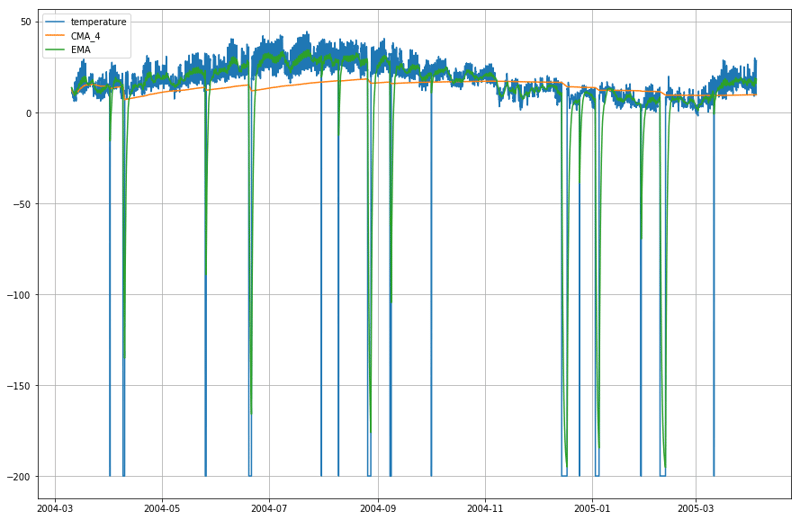
Wow! Như bạn có thể quan sát từ biểu đồ trên, Trung bình Động Hàm mũ (EMA) làm rất tốt việc nắm bắt mô hình của dữ liệu trong khi Trung bình Động Tích lũy (CMA) kém hơn đáng kể.
Tiến xa hơn!
Chúc mừng bạn đã hoàn thành hướng dẫn.
Hướng dẫn này là điểm khởi đầu tốt để bạn có thể tính trung bình động cho dữ liệu của mình và hiểu được ý nghĩa của nó.
Hãy thử viết mã Python cho trung bình động tích lũy và trung bình động hàm mũ mà không dùng thư viện pandas. Điều đó sẽ giúp bạn hiểu sâu hơn cách chúng được tính và chúng khác nhau như thế nào.
Vẫn còn rất nhiều điều để thử nghiệm. Hãy thử tính tự tương quan riêng phần giữa dữ liệu đầu vào và trung bình động, và cố gắng tìm một số mối quan hệ giữa hai thứ đó.
Nếu bạn muốn tìm hiểu thêm về DataFrame trong pandas, hãy học khóa học tương tác Nền tảng pandas của DataCamp.
Tài liệu tham khảo:
Vui lòng đặt mọi câu hỏi liên quan đến hướng dẫn này trong phần bình luận bên dưới.


Giới thiệu
Trung bình động, còn gọi là trung bình cuộn hoặc trung bình chạy, được dùng để phân tích dữ liệu chuỗi thời gian bằng cách tính trung bình của các tập con khác nhau trong toàn bộ tập dữ liệu. Vì liên quan đến việc lấy trung bình dữ liệu theo thời gian, nó cũng được gọi là trung bình động (MM) hoặc trung bình cuộn.
Có nhiều cách để tính trung bình cuộn, nhưng một cách là lấy một tập con cố định từ toàn bộ dãy số. Giá trị trung bình động đầu tiên được tính bằng cách lấy trung bình của tập con cố định đầu tiên, sau đó tập con được thay đổi bằng cách di chuyển tiến tới tập con cố định tiếp theo (bao gồm giá trị tương lai trong nhóm nhỏ trong khi loại trừ số trước đó khỏi dãy).
Trung bình động thường được dùng với dữ liệu chuỗi thời gian để nắm bắt các dao động ngắn hạn trong khi tập trung vào các xu hướng dài hạn.
Một vài ví dụ về dữ liệu chuỗi thời gian có thể là giá cổ phiếu, báo cáo thời tiết, chất lượng không khí, tổng sản phẩm quốc nội, việc làm, v.v.
Nhìn chung, trung bình động giúp làm trơn dữ liệu.
Trung bình động là nền tảng của nhiều thuật toán, trong đó có Mô hình Trung bình Động Tích hợp Tự hồi quy (ARIMA), sử dụng trung bình động để dự báo dữ liệu chuỗi thời gian.
Có nhiều loại trung bình động:
Trung bình Động Đơn giản (SMA): Trung bình Động Đơn giản (SMA) dùng một cửa sổ trượt để lấy trung bình trong một số khoảng thời gian nhất định. Đây là trung bình có trọng số bằng nhau của n dữ liệu trước đó.
Để hiểu rõ hơn về SMA, hãy lấy ví dụ một dãy gồm n giá trị:
khi đó, trung bình cuộn có trọng số bằng nhau cho n điểm dữ liệu về bản chất sẽ là trung bình của M điểm dữ liệu trước đó, trong đó M là kích thước cửa sổ trượt:
Tương tự, để tính các giá trị trung bình cuộn tiếp theo, một giá trị mới sẽ được thêm vào tổng, và giá trị của giai đoạn trước sẽ bị loại ra; vì bạn đã có trung bình của các giai đoạn trước nên không cần tính tổng đầy đủ mỗi lần:
Vì EMA đặt trọng số cao hơn cho dữ liệu gần đây so với dữ liệu cũ, chúng phản ứng nhanh hơn với các thay đổi giá mới nhất so với SMA, điều này khiến kết quả từ EMA kịp thời hơn và do đó EMA thường được ưa chuộng hơn các kỹ thuật khác.
Lý thuyết đủ rồi, phải không? Hãy chuyển sang triển khai thực tế trung bình động.
Triển khai Trung bình Động trên Dữ liệu Chuỗi thời gian
Trung bình Động Đơn giản (SMA)
Trước tiên, hãy tạo dữ liệu chuỗi thời gian giả và thử triển khai SMA chỉ bằng Python.
Giả sử có nhu cầu cho một sản phẩm và nó được quan sát trong 12 tháng (1 năm), và bạn cần tìm trung bình động cho các cửa sổ 3 và 4 tháng.
Nhập mô-đun