

Execute e edite o código deste tutorial online
Executar código| month | demand | |
|---|---|---|
| 0 | 1 | 290 |
| 1 | 2 | 260 |
| 2 | 3 | 288 |
| 3 | 4 | 300 |
| 4 | 5 | 310 |
Vamos calcular a SMA para uma janela de 3, o que significa considerar três valores por vez para calcular a média móvel; a cada novo valor, o mais antigo é descartado.
Para implementar, você vai usar a função iloc do pandas. Como a coluna demand é a que interessa, você fixa sua posição na função iloc, enquanto a linha será a variável i, que vai iterar até o final do dataframe.
for i in range(0,df.shape[0]-2):
df.loc[df.index[i+2],'SMA_3'] = np.round(((df.iloc[i,1]+ df.iloc[i+1,1] +df.iloc[i+2,1])/3),1)| month | demand | SMA_3 | |
|---|---|---|---|
| 0 | 1 | 290 | NaN |
| 1 | 2 | 260 | NaN |
| 2 | 3 | 288 | 279.3 |
| 3 | 4 | 300 | 282.7 |
| 4 | 5 | 310 | 299.3 |
Para validar, vamos usar também a função nativa rolling do pandas e ver se bate com nossa média móvel simples feita em Python.
df['pandas_SMA_3'] = df.iloc[:,1].rolling(window=3).mean()df.head()| month | demand | SMA_3 | pandas_SMA_3 | |
|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 |
| 3 | 4 | 300 | 282.7 | 282.666667 |
| 4 | 5 | 310 | 299.3 | 299.333333 |
Legal! Como você pode ver, as médias móveis personalizada e do pandas batem, o que confirma que sua implementação da SMA está correta.
Vamos também calcular rapidamente a média móvel simples para um window_size de 4.
for i in range(0,df.shape[0]-3):
df.loc[df.index[i+3],'SMA_4'] = np.round(((df.iloc[i,1]+ df.iloc[i+1,1] +df.iloc[i+2,1]+df.iloc[i+3,1])/4),1)
df.head()
| month | demand | SMA_3 | pandas_SMA_3 | SMA_4 | |
|---|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 | NaN |
| 3 | 4 | 300 | 282.7 | 282.666667 | 284.5 |
| 4 | 5 | 310 | 299.3 | 299.333333 | 289.5 |
df['pandas_SMA_4'] = df.iloc[:,1].rolling(window=4).mean()
df.head()
| month | demand | SMA_3 | pandas_SMA_3 | SMA_4 | pandas_SMA_4 | |
|---|---|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 | NaN | NaN |
| 3 | 4 | 300 | 282.7 | 282.666667 | 284.5 | 284.5 |
| 4 | 5 | 310 | 299.3 | 299.333333 | 289.5 | 289.5 |
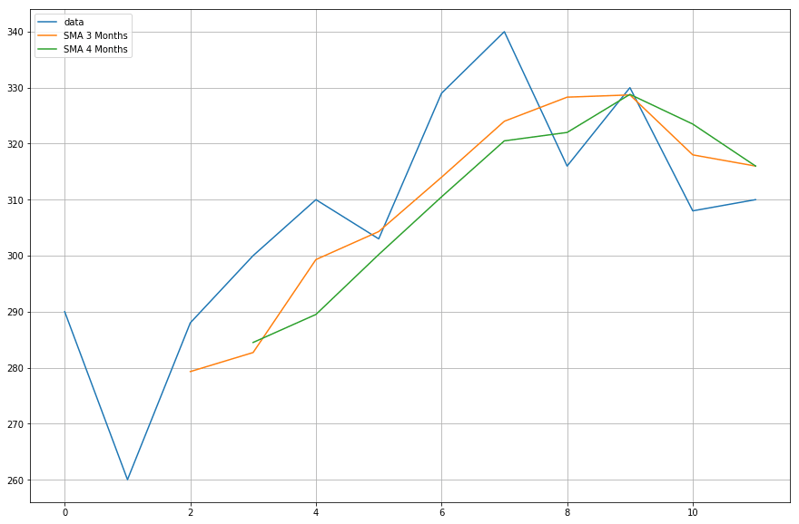
Agora, vamos plotar os dados das médias móveis que você calculou.
import matplotlib.pyplot as plt
%matplotlib inlineplt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df['demand'],label='data')
plt.plot(df['SMA_3'],label='SMA 3 Months')
plt.plot(df['SMA_4'],label='SMA 4 Months')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x11fe15080>
Média móvel cumulativa
Acho que agora estamos prontos para usar um dataset real.
Para a média móvel cumulativa, vamos usar um air quality dataset que pode ser baixado neste link.
df = pd.read_csv("AirQualityUCI/AirQualityUCI.csv", sep = ";", decimal = ",")
df = df.iloc[ : , 0:14]
df.head()
| Date | Time | CO(GT) | PT08.S1(CO) | NMHC(GT) | C6H6(GT) | PT08.S2(NMHC) | NOx(GT) | PT08.S3(NOx) | NO2(GT) | PT08.S4(NO2) | PT08.S5(O3) | T | RH | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 10/03/2004 | 18.00.00 | 2.6 | 1360.0 | 150.0 | 11.9 | 1046.0 | 166.0 | 1056.0 | 113.0 | 1692.0 | 1268.0 | 13.6 | 48.9 |
| 1 | 10/03/2004 | 19.00.00 | 2.0 | 1292.0 | 112.0 | 9.4 | 955.0 | 103.0 | 1174.0 | 92.0 | 1559.0 | 972.0 | 13.3 | 47.7 |
| 2 | 10/03/2004 | 20.00.00 | 2.2 | 1402.0 | 88.0 | 9.0 | 939.0 | 131.0 | 1140.0 | 114.0 | 1555.0 | 1074.0 | 11.9 | 54.0 |
| 3 | 10/03/2004 | 21.00.00 | 2.2 | 1376.0 | 80.0 | 9.2 | 948.0 | 172.0 | 1092.0 | 122.0 | 1584.0 | 1203.0 | 11.0 | 60.0 |
| 4 | 10/03/2004 | 22.00.00 | 1.6 | 1272.0 | 51.0 | 6.5 | 836.0 | 131.0 | 1205.0 | 116.0 | 1490.0 | 1110.0 | 11.2 | 59.6 |
Pré-processamento é uma etapa essencial ao trabalhar com dados. Para dados numéricos, uma das verificações mais comuns é por valores NaN (nulos). Se houver NaN, você pode substituí-los por 0, pela média, por valores anteriores ou posteriores, ou até removê-los. Embora substituir geralmente seja melhor do que descartar, como este dataset tem poucos valores nulos e estão no fim da série, removê-los não afetará a continuidade.
df.isna().sum()
Date 114
Time 114
CO(GT) 114
PT08.S1(CO) 114
NMHC(GT) 114
C6H6(GT) 114
PT08.S2(NMHC) 114
NOx(GT) 114
PT08.S3(NOx) 114
NO2(GT) 114
PT08.S4(NO2) 114
PT08.S5(O3) 114
T 114
RH 114
dtype: int64
Pelo resultado acima, dá para notar cerca de 114 valores NaN em todas as colunas; porém, eles estão todos no final da série temporal, então vamos descartá-los.
df.dropna(inplace=True)
df.isna().sum()
Date 0
Time 0
CO(GT) 0
PT08.S1(CO) 0
NMHC(GT) 0
C6H6(GT) 0
PT08.S2(NMHC) 0
NOx(GT) 0
PT08.S3(NOx) 0
NO2(GT) 0
PT08.S4(NO2) 0
PT08.S5(O3) 0
T 0
RH 0
dtype: int64
Você vai aplicar a média móvel cumulativa na coluna de temperatura (T), então vamos separá-la do conjunto completo.
df_T = pd.DataFrame(df.iloc[:,-2])
df_T.head()
| T | |
|---|---|
| 0 | 13.6 |
| 1 | 13.3 |
| 2 | 11.9 |
| 3 | 11.0 |
| 4 | 11.2 |
Agora, vamos usar o método expanding do pandas para encontrar a média cumulativa dos dados acima. Como vimos na introdução, diferente da média móvel simples, a média móvel cumulativa considera todos os valores anteriores ao calcular a média.
df_T['CMA_4'] = df_T.expanding(min_periods=4).mean()
df_T.head(10)
| T | CMA_4 | |
|---|---|---|
| 0 | 13.6 | NaN |
| 1 | 13.3 | NaN |
| 2 | 11.9 | NaN |
| 3 | 11.0 | 12.450000 |
| 4 | 11.2 | 12.200000 |
| 5 | 11.2 | 12.033333 |
| 6 | 11.3 | 11.928571 |
| 7 | 10.7 | 11.775000 |
| 8 | 10.7 | 11.655556 |
| 9 | 10.3 | 11.520000 |
Séries temporais são plotadas em função do tempo, então vamos combinar as colunas de data e hora e convertê-las em um objeto datetime. Para isso, vamos usar o módulo datetime do Python (Fonte: Time Series Tutorial).
import datetime
df['DateTime'] = (df.Date) + ' ' + (df.Time)
df.DateTime = df.DateTime.apply(lambda x: datetime.datetime.strptime(x, '%d/%m/%Y %H.%M.%S'))
Vamos alterar o índice do dataframe de temperatura para datetime.
df_T.index = df.DateTime
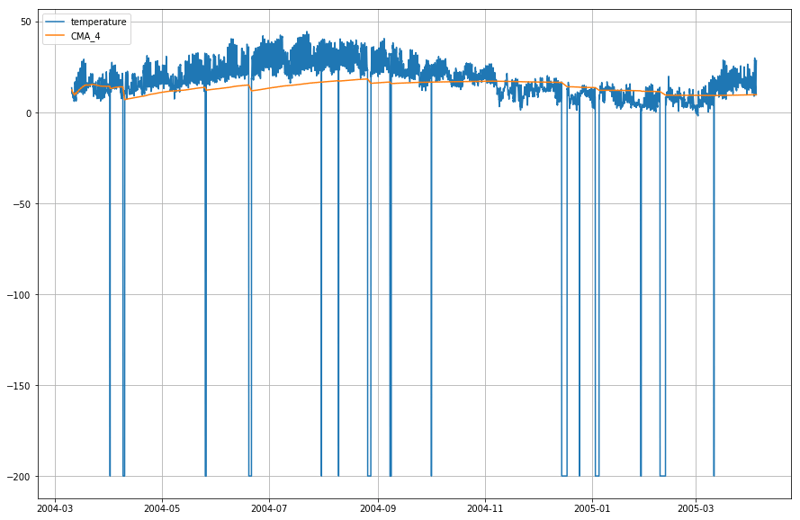
Agora vamos plotar a temperatura real e a média móvel cumulativa ao longo do tempo.
plt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df_T['T'],label='temperature')
plt.plot(df_T['CMA_4'],label='CMA_4')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x1210a2d30>
Média móvel exponencial
df_T['EMA'] = df_T.iloc[:,0].ewm(span=40,adjust=False).mean()
df_T.head()
| T | CMA_4 | EMA | |
|---|---|---|---|
| DateTime | |||
| 2004-03-10 18:00:00 | 13.6 | NaN | 13.600000 |
| 2004-03-10 19:00:00 | 13.3 | NaN | 13.585366 |
| 2004-03-10 20:00:00 | 11.9 | NaN | 13.503153 |
| 2004-03-10 21:00:00 | 11.0 | 12.45 | 13.381048 |
| 2004-03-10 22:00:00 | 11.2 | 12.20 | 13.274655 |
plt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df_T['T'],label='temperature')
plt.plot(df_T['CMA_4'],label='CMA_4')
plt.plot(df_T['EMA'],label='EMA')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x14b2a41d0>
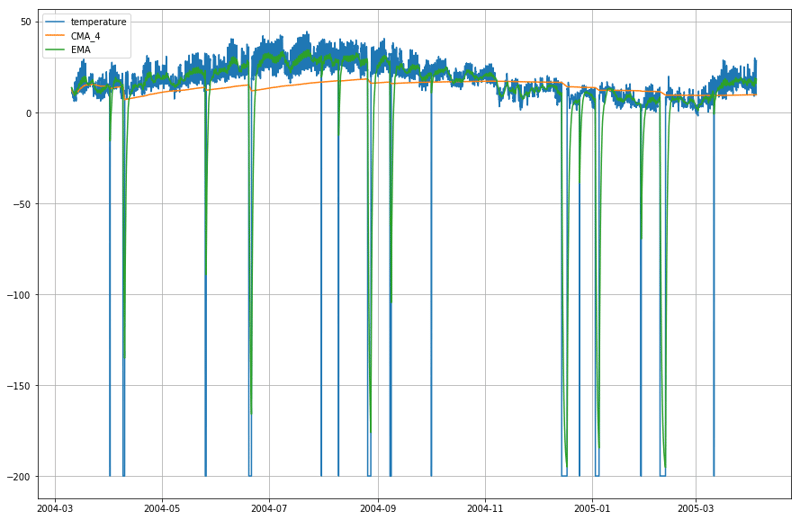
Uau! Como dá para observar no gráfico acima, a Exponential Moving Average (EMA) capta muito bem o padrão dos dados, enquanto a Cumulative Moving Average (CMA) fica bem atrás.
Vá além!
Parabéns por concluir o tutorial.
Este tutorial foi um ótimo ponto de partida para calcular médias móveis e interpretar suas séries temporais.
Tente escrever o código de média móvel cumulativa e exponencial em Python sem usar a biblioteca pandas. Isso vai dar uma visão bem mais profunda de como são calculadas e em que aspectos diferem uma da outra.
Ainda há muito para experimentar. Tente calcular a autocorrelação parcial entre os dados de entrada e a média móvel e busque alguma relação entre os dois.
Se quiser aprender mais sobre DataFrames no pandas, faça o curso interativo pandas Foundations da DataCamp.
Referências:
Fique à vontade para deixar suas perguntas sobre este tutorial na seção de comentários abaixo.



Introdução
A média móvel, também chamada de média rolante, é usada para analisar dados de séries temporais calculando médias de diferentes subconjuntos do conjunto completo. Como envolve tirar a média do conjunto ao longo do tempo, ela também é chamada de moving mean (MM) ou rolling mean.
Existem várias formas de calcular a média rolante; uma delas é tomar um subconjunto fixo de uma série completa de números. A primeira média móvel é calculada fazendo a média do primeiro subconjunto fixo; em seguida, esse subconjunto é alterado avançando para o próximo bloco fixo (incluindo o valor seguinte e excluindo o valor anterior da série).
A média móvel é usada principalmente com séries temporais para capturar flutuações de curto prazo enquanto foca nas tendências de longo prazo.
Alguns exemplos de séries temporais: preços de ações, registros meteorológicos, qualidade do ar, produto interno bruto, emprego etc.
Em geral, a média móvel suaviza os dados.
A média móvel é base para muitos algoritmos, como o modelo Autoregressive Integrated Moving Average (ARIMA), que usa médias móveis para prever séries temporais.
Existem vários tipos de médias móveis:
Média móvel simples (SMA): A Simple Moving Average (SMA) usa uma janela deslizante para calcular a média em um número definido de períodos. É uma média com pesos iguais dos n dados anteriores.
Para entender melhor a SMA, vamos a um exemplo: uma sequência de n valores:
então a média rolante com pesos iguais para n pontos de dados será essencialmente a média dos M dados anteriores, onde M é o tamanho da janela deslizante:
Da mesma forma, para calcular os valores seguintes da média rolante, um novo valor é adicionado à soma e o valor do período anterior é removido; como você já tem a média dos períodos anteriores, não é necessário somar tudo a cada vez:
Como a EMA dá um peso maior aos dados recentes do que aos antigos, ela responde mais rapidamente às últimas mudanças do que a SMA, o que torna seus resultados mais oportunos; por isso, a EMA costuma ser preferida em relação a outras técnicas.
Chega de teoria, certo? Vamos partir para a implementação prática da média móvel.
Implementando média móvel em dados de séries temporais
Média móvel simples (SMA)
Primeiro, vamos criar uma série temporal de exemplo e implementar a SMA usando apenas Python.
Suponha que a demanda por um produto foi observada por 12 meses (1 ano) e você precisa calcular as médias móveis com janelas de 3 e 4 meses.
Importar módulos