

Ejecuta y edita el código de este tutorial en línea
Ejecutar código| month | demand | |
|---|---|---|
| 0 | 1 | 290 |
| 1 | 2 | 260 |
| 2 | 3 | 288 |
| 3 | 4 | 300 |
| 4 | 5 | 310 |
Calculemos la SMA con una ventana de 3, lo que significa que considerarás tres valores cada vez para calcular la media móvil y, con cada nuevo valor, ignorarás el más antiguo.
Para implementarlo, usarás la función iloc de pandas. Como lo que necesitas es la columna demand, fijarás su posición en la función iloc, mientras que la fila será la variable i, que irás iterando hasta llegar al final del dataframe.
for i in range(0,df.shape[0]-2):
df.loc[df.index[i+2],'SMA_3'] = np.round(((df.iloc[i,1]+ df.iloc[i+1,1] +df.iloc[i+2,1])/3),1)| month | demand | SMA_3 | |
|---|---|---|---|
| 0 | 1 | 290 | NaN |
| 1 | 2 | 260 | NaN |
| 2 | 3 | 288 | 279.3 |
| 3 | 4 | 300 | 282.7 |
| 4 | 5 | 310 | 299.3 |
Para validar, usemos también la función integrada rolling de pandas y comprobemos si coincide con nuestra media móvil simple implementada en Python puro.
df['pandas_SMA_3'] = df.iloc[:,1].rolling(window=3).mean()df.head()| month | demand | SMA_3 | pandas_SMA_3 | |
|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 |
| 3 | 4 | 300 | 282.7 | 282.666667 |
| 4 | 5 | 310 | 299.3 | 299.333333 |
Genial: como ves, las medias móviles personalizada y la de pandas coinciden prácticamente, así que tu implementación de la SMA es correcta.
Calculemos también de forma rápida la media móvil simple para un window_size de 4.
for i in range(0,df.shape[0]-3):
df.loc[df.index[i+3],'SMA_4'] = np.round(((df.iloc[i,1]+ df.iloc[i+1,1] +df.iloc[i+2,1]+df.iloc[i+3,1])/4),1)
df.head()
| month | demand | SMA_3 | pandas_SMA_3 | SMA_4 | |
|---|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 | NaN |
| 3 | 4 | 300 | 282.7 | 282.666667 | 284.5 |
| 4 | 5 | 310 | 299.3 | 299.333333 | 289.5 |
df['pandas_SMA_4'] = df.iloc[:,1].rolling(window=4).mean()
df.head()
| month | demand | SMA_3 | pandas_SMA_3 | SMA_4 | pandas_SMA_4 | |
|---|---|---|---|---|---|---|
| 0 | 1 | 290 | NaN | NaN | NaN | NaN |
| 1 | 2 | 260 | NaN | NaN | NaN | NaN |
| 2 | 3 | 288 | 279.3 | 279.333333 | NaN | NaN |
| 3 | 4 | 300 | 282.7 | 282.666667 | 284.5 | 284.5 |
| 4 | 5 | 310 | 299.3 | 299.333333 | 289.5 | 289.5 |
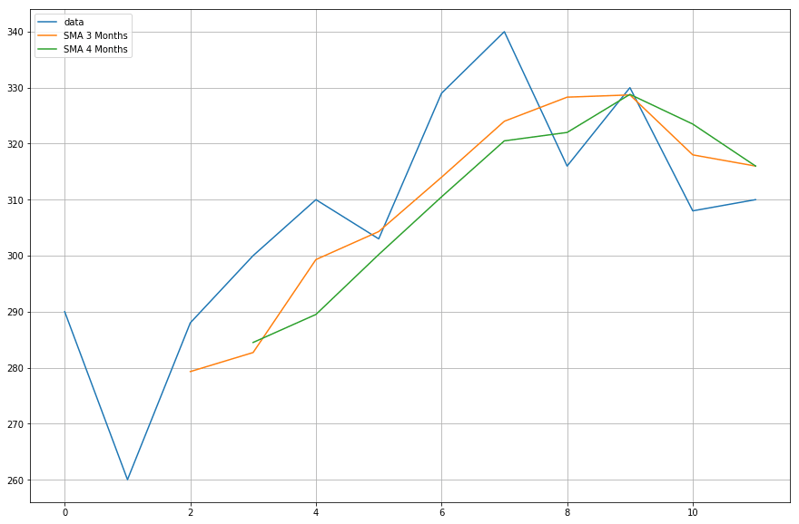
Ahora vamos a representar los datos de las medias móviles que has calculado.
import matplotlib.pyplot as plt
%matplotlib inlineplt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df['demand'],label='data')
plt.plot(df['SMA_3'],label='SMA 3 Months')
plt.plot(df['SMA_4'],label='SMA 4 Months')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x11fe15080>
Media móvil acumulada
Creo que ya estamos listos para pasar a un conjunto de datos real.
Para la media móvil acumulada, usaremos un conjunto de datos de calidad del aire que puedes descargar desde este enlace.
df = pd.read_csv("AirQualityUCI/AirQualityUCI.csv", sep = ";", decimal = ",")
df = df.iloc[ : , 0:14]
df.head()
| Date | Time | CO(GT) | PT08.S1(CO) | NMHC(GT) | C6H6(GT) | PT08.S2(NMHC) | NOx(GT) | PT08.S3(NOx) | NO2(GT) | PT08.S4(NO2) | PT08.S5(O3) | T | RH | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 10/03/2004 | 18.00.00 | 2.6 | 1360.0 | 150.0 | 11.9 | 1046.0 | 166.0 | 1056.0 | 113.0 | 1692.0 | 1268.0 | 13.6 | 48.9 |
| 1 | 10/03/2004 | 19.00.00 | 2.0 | 1292.0 | 112.0 | 9.4 | 955.0 | 103.0 | 1174.0 | 92.0 | 1559.0 | 972.0 | 13.3 | 47.7 |
| 2 | 10/03/2004 | 20.00.00 | 2.2 | 1402.0 | 88.0 | 9.0 | 939.0 | 131.0 | 1140.0 | 114.0 | 1555.0 | 1074.0 | 11.9 | 54.0 |
| 3 | 10/03/2004 | 21.00.00 | 2.2 | 1376.0 | 80.0 | 9.2 | 948.0 | 172.0 | 1092.0 | 122.0 | 1584.0 | 1203.0 | 11.0 | 60.0 |
| 4 | 10/03/2004 | 22.00.00 | 1.6 | 1272.0 | 51.0 | 6.5 | 836.0 | 131.0 | 1205.0 | 116.0 | 1490.0 | 1110.0 | 11.2 | 59.6 |
La preparación de datos es un paso esencial. En datos numéricos, uno de los pasos más comunes es comprobar si hay valores NaN (Null). Si los hay, puedes sustituirlos por 0, por la media, por valores anteriores o posteriores, o incluso eliminarlos. Aunque suele ser mejor imputar que eliminar, en este dataset hay pocos NULL y están al final, así que eliminarlos no afectará a la continuidad de la serie.
df.isna().sum()
Date 114
Time 114
CO(GT) 114
PT08.S1(CO) 114
NMHC(GT) 114
C6H6(GT) 114
PT08.S2(NMHC) 114
NOx(GT) 114
PT08.S3(NOx) 114
NO2(GT) 114
PT08.S4(NO2) 114
PT08.S5(O3) 114
T 114
RH 114
dtype: int64
Como ves en la salida anterior, hay unos 114 valores NaN en todas las columnas, pero están al final de la serie temporal, así que vamos a eliminarlos rápidamente.
df.dropna(inplace=True)
df.isna().sum()
Date 0
Time 0
CO(GT) 0
PT08.S1(CO) 0
NMHC(GT) 0
C6H6(GT) 0
PT08.S2(NMHC) 0
NOx(GT) 0
PT08.S3(NOx) 0
NO2(GT) 0
PT08.S4(NO2) 0
PT08.S5(O3) 0
T 0
RH 0
dtype: int64
Aplicarás la media móvil acumulada a la columna de temperatura (T), así que vamos a separarla del resto de datos.
df_T = pd.DataFrame(df.iloc[:,-2])
df_T.head()
| T | |
|---|---|
| 0 | 13.6 |
| 1 | 13.3 |
| 2 | 11.9 |
| 3 | 11.0 |
| 4 | 11.2 |
Ahora usarás el método expanding de pandas para obtener la media acumulada de los datos anteriores. Como recordarás de la introducción, a diferencia de la media móvil simple, la media móvil acumulada tiene en cuenta todos los valores anteriores al calcular la media.
df_T['CMA_4'] = df_T.expanding(min_periods=4).mean()
df_T.head(10)
| T | CMA_4 | |
|---|---|---|
| 0 | 13.6 | NaN |
| 1 | 13.3 | NaN |
| 2 | 11.9 | NaN |
| 3 | 11.0 | 12.450000 |
| 4 | 11.2 | 12.200000 |
| 5 | 11.2 | 12.033333 |
| 6 | 11.3 | 11.928571 |
| 7 | 10.7 | 11.775000 |
| 8 | 10.7 | 11.655556 |
| 9 | 10.3 | 11.520000 |
Las series temporales se representan respecto al tiempo, así que vamos a combinar las columnas de fecha y hora y convertirlas en un objeto datetime. Para ello, usarás el módulo datetime de Python (Fuente: Time Series Tutorial).
import datetime
df['DateTime'] = (df.Date) + ' ' + (df.Time)
df.DateTime = df.DateTime.apply(lambda x: datetime.datetime.strptime(x, '%d/%m/%Y %H.%M.%S'))
Cambiemos el índice del dataframe de temperatura por el datetime.
df_T.index = df.DateTime
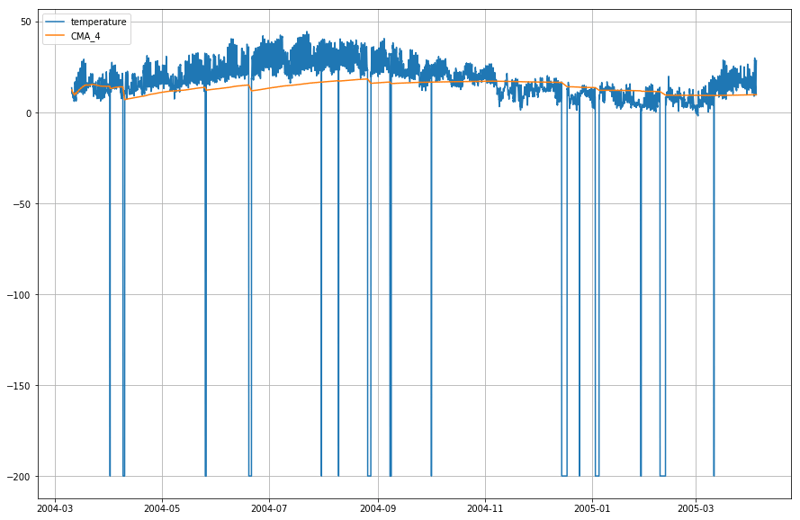
Ahora representemos la temperatura real y la media móvil acumulada con respecto al tiempo.
plt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df_T['T'],label='temperature')
plt.plot(df_T['CMA_4'],label='CMA_4')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x1210a2d30>
Media móvil exponencial
df_T['EMA'] = df_T.iloc[:,0].ewm(span=40,adjust=False).mean()
df_T.head()
| T | CMA_4 | EMA | |
|---|---|---|---|
| DateTime | |||
| 2004-03-10 18:00:00 | 13.6 | NaN | 13.600000 |
| 2004-03-10 19:00:00 | 13.3 | NaN | 13.585366 |
| 2004-03-10 20:00:00 | 11.9 | NaN | 13.503153 |
| 2004-03-10 21:00:00 | 11.0 | 12.45 | 13.381048 |
| 2004-03-10 22:00:00 | 11.2 | 12.20 | 13.274655 |
plt.figure(figsize=[15,10])
plt.grid(True)
plt.plot(df_T['T'],label='temperature')
plt.plot(df_T['CMA_4'],label='CMA_4')
plt.plot(df_T['EMA'],label='EMA')
plt.legend(loc=2)
<matplotlib.legend.Legend at 0x14b2a41d0>
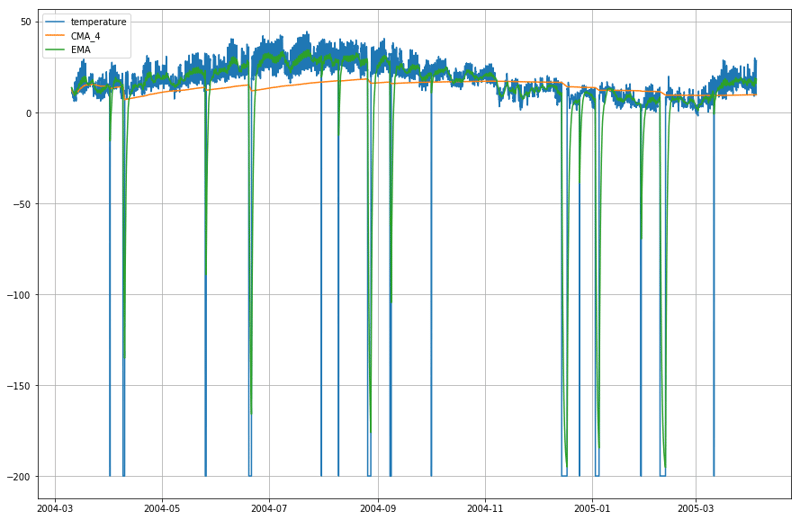
¡Vaya! Como puedes observar en el gráfico, la Exponential Moving Average (EMA) capta muy bien el patrón de los datos, mientras que la Cumulative Moving Average (CMA) se queda bastante atrás.
Sigue aprendiendo
Enhorabuena por completar el tutorial.
Este tutorial es un buen punto de partida para calcular medias móviles sobre tus datos y sacarles partido.
Intenta escribir el código de la media móvil acumulada y la media móvil exponencial en Python sin usar la librería pandas. Te dará una comprensión más profunda de cómo se calculan y en qué se diferencian.
Todavía hay mucho por experimentar. Prueba a calcular la autocorrelación parcial entre los datos de entrada y la media móvil, e intenta descubrir alguna relación entre ambos.
Si quieres aprender más sobre DataFrames en pandas, haz el curso interactivo pandas Foundations de DataCamp.
Referencias:
No dudes en dejar cualquier pregunta sobre este tutorial en los comentarios.



Introducción
La media móvil, también llamada media rodante o media deslizante, se utiliza para analizar series temporales calculando promedios de distintos subconjuntos del conjunto de datos completo. Como implica promediar el conjunto a lo largo del tiempo, también se conoce como media móvil (MM) o media rodante.
Hay varias formas de calcular la media móvil. Una de ellas consiste en tomar un subconjunto fijo de una serie completa de números. La primera media móvil se obtiene promediando el primer subconjunto fijo y, a continuación, el subconjunto se actualiza desplazándose al siguiente subconjunto fijo (incluyendo el nuevo valor y excluyendo el valor más antiguo de la serie).
La media móvil se usa sobre todo con datos de series temporales para captar fluctuaciones a corto plazo sin perder de vista las tendencias de fondo.
Algunos ejemplos de series temporales son los precios de acciones, los partes meteorológicos, la calidad del aire, el producto interior bruto, el empleo, etc.
En general, la media móvil suaviza los datos.
La media móvil es la base de muchos algoritmos; uno de ellos es el modelo ARIMA (Autoregressive Integrated Moving Average), que utiliza medias móviles para realizar predicciones sobre series temporales.
Existen varios tipos de medias móviles:
Simple Moving Average (SMA): la media móvil simple utiliza una ventana deslizante para calcular el promedio sobre un número determinado de periodos. Es una media con pesos iguales de los n datos anteriores.
Para entender mejor la SMA, veamos un ejemplo con una secuencia de n valores:
la media rodante con pesos iguales para n puntos será esencialmente la media de los M datos anteriores, donde M es el tamaño de la ventana deslizante:
De forma análoga, para calcular los siguientes valores de la media rodante, se añade el nuevo valor a la suma y se elimina el valor más antiguo; como ya tienes la media de los periodos previos, no necesitas recalcular la suma completa cada vez:
Como las EMA ponderan más los datos recientes que los antiguos, responden mejor a los cambios más recientes de precio que las SMA, lo que hace que sus resultados sean más oportunos. Por eso la EMA suele preferirse a otras técnicas.
Suficiente teoría, ¿verdad? Vamos a la implementación práctica de la media móvil.
Implementación de la media móvil en series temporales
Simple Moving Average (SMA)
Primero, vamos a crear unos datos ficticios de serie temporal e intentar aplicar una SMA usando solo Python.
Supón que observas la demanda de un producto durante 12 meses (1 año) y necesitas calcular las medias móviles con ventanas de 3 y 4 meses.
Importar módulos