

为什么要将 OpenClaw 与 Ollama 搭配运行?
将 OpenClaw 与本地的 Ollama 模型配合运行,会把您的系统变成一个自包含的 AI 环境。与其把提示与数据发往外部 API,不如让整个工作流(包括推理、文件访问与制品生成)都在您的机器上完成。
这种设置具备多项实用优势:
- 从设计上保证隐私: 所有数据集、文档与中间输出均保留在本机,不会传输到外部服务。
- 完全透明与可控: 从发送给 OpenClaw 的斜杠命令,到生成的文件与执行轨迹,每一步都可检查。
- 离线运行: 模型通过 Ollama 拉取完成后,系统即可在无网络环境下工作。
- 代理式执行: 单个用户请求即可触发多步工作流,而非只返回一段文本。
本教程聚焦于构建本地代理架构:OpenClaw 作为执行引擎,Ollama 提供推理层。
OpenClaw + Ollama 教程:构建本地数据分析助手
本节中,我们将使用 OpenClaw 和本地 Ollama 模型,在您的机器上完全运行一个“本地数据分析助手”应用。从整体来看,系统执行三项核心任务:
- 接收用户上传的 CSV 数据集
- 可选地摄取支持性上下文文档(PDF、TXT 或 Markdown)
- 运行多步分析工作流,生成洞见与可视化
系统会生成三类输出制品:
trend_chart.pnganalysis_report.mdtool_trace.json
在幕后,工作流由三部分协同完成:
- Web 界面(
web_assistant.py):该 Python 文件处理文件上传、创建运行目录,并向 OpenClaw 发送斜杠命令。 - OpenClaw 代理:OpenClaw 代理加载工作区技能,通过工具执行本地命令,并使用由 Ollama 托管的本地 LLM 进行推理与摘要。
- 分析引擎(
main.py):该文件读取数据集、推断相关列、生成图表与洞见,并将所有输出写入磁盘。
工作流完成后,Web 界面会预览生成的制品,方便用户查看结果与执行轨迹。
步骤 1:安装 OpenClaw
在构建“本地数据分析助手”工作流之前,需要在您的机器上运行 OpenClaw Gateway。您可以将 OpenClaw 视为本项目的执行层:它接收来自 Web UI 的请求,加载工作区技能,运行本地工具(如 shell 命令和 Python 脚本),并协调端到端的完整工作流。
curl -fsSL https://openclaw.ai/install.sh | bash
openclaw onboard --install-daemon该命令会安装 OpenClaw CLI,运行引导向导以配置本地环境,并设置网关守护进程,以便轻松启动与停止。尽管我们在本演示中会以前台方式运行网关,但安装守护进程可确保标准化设置并便于排障。
现在,让我们确认一切正常:
openclaw doctor
openclaw gateway statusOpenClaw doctor 会报告 OpenClaw 是否已正确安装。OpenClaw gateway status 会显示网关当前是否在运行。此时可能显示“未运行”,这没问题。关键在于命令可执行且安装已被识别。
若想详细了解全部引导选项(渠道、认证、技能、网关安全)逐步说明,可参考这篇OpenClaw 教程。
步骤 2:安装 Ollama
接下来我们将设置 Ollama,它将作为本项目的本地 LLM 后端。OpenClaw 仍负责编排工作流,但在需要模型智能进行摘要或推理时,会通过 Ollama 调用 LLM。
运行以下命令:
brew install ollama
ollama serve
ollama pull qwen3:8b上述命令会安装 Ollama 运行时,启动本地模型服务(OpenClaw 将与之通信),并下载 qwen3:8b 模型。我们选择 qwen3:8b,因为它在多数笔记本上兼顾性能与质量,但您也可根据设备资源选择其他模型。您还可以参考 Ollama 的这份集成指南进行设置。
步骤 3:配置 OpenClaw
接下来,我们需要将 OpenClaw 配置为使用本地的 Ollama 实例。这可确保所有推理、摘要与分析完全在您的机器上进行,不会调用任何外部 API。
创建本地配置目录:
mkdir -p .openclaw-local然后创建文件:
.openclaw-local/openclaw.json
{
"models": {
"providers": {
"ollama": {
"baseUrl": "http://127.0.0.1:11434/v1",
"apiKey": "ollama-local",
"api": "openai-completions",
"models": [
{
"id": "qwen3:8b",
"name": "qwen3:8b",
"reasoning": false,
"input": ["text"],
"cost": { "input": 0, "output": 0, "cacheRead": 0, "cacheWrite": 0 },
"contextWindow": 131072,
"maxTokens": 8192
}
]
}
}
},
"agents": {
"defaults": {
"model": { "primary": "ollama/qwen3:8b" }
}
},
"tools": {
"web": {
"search": { "enabled": false },
"fetch": { "enabled": true }
}
}
}上述配置定义了三项关键组件:
baseUrl指向由ollama serve暴露的本地 API 端点,而api: openai-completions设置启用与 OpenAI 兼容的通信。对 qwen3:8b 的模型注册声明了其能力,包括可处理大型数据集的 131K 上下文窗口,以及用于控制响应的 token 限制。由于模型在本地运行,成本值均设为 0。agent defaults部分控制 OpenClaw 代理用于推理的模型。将主模型设置为ollama/qwen3:8b后,所有代理任务(如解析提示、生成摘要或对数据进行推理)都会自动路由到本地 Ollama 模型,无需任何外部 API 调用。- 工具配置用于管理外部能力,如 Web 搜索被禁用以确保隐私并阻止出站请求;而 fetch 工具在需要时保留有限的资源获取能力。
上述设置共同确保整条工作流在您的机器上私密运行,由 OpenClaw 负责编排,Ollama 提供本地智能。
步骤 4:定义工作区技能
在此步骤中,我们定义工作区技能,以告知 OpenClaw 如何执行工作流。我们不依赖模型来规划工具使用,而是采用“命令分发模式”,允许斜杠命令直接触发本地执行命令,使工作流更快且完全本地化。
让我们在您的工作区中创建如下 SKILL.md 文件:
---
name: local-data-analyst
description: Local Data Analyst: analyze private local data with Ollama, generate chart/report, and keep all data on-device.
user-invocable: true
command-dispatch: tool
command-tool: exec
command-arg-mode: raw
---
Invoke as /local-data-analyst <raw command>.
This skill bypasses model planning and dispatches raw command text directly to the exec tool.
Use this exact command template in this workspace:
python3 /……/main.py --docs-dir <context_dir> --data-file <data_file> --output-dir <output_dir> --prompt "<prompt>" --use-ollama --model qwen3:8b
Expected outputs under <output_dir>:
- trend_chart.png
- analysis_report.md
- tool_trace.json此技能配置决定了 OpenClaw 如何执行分析:
- 顶部前言区(文件最上方的结构化元数据块)定义了一个可由用户调用的技能
local-data-analyst,它会以斜杠命令/local-data-analyst的形式提供。 - 斜杠命令是 OpenClaw 在聊天或 UI 中触发结构化操作的方式。
command-dispatch: tool启用命令分发模式,OpenClaw 会将命令直接路由到工具,而不是让模型决定该做什么。- 借助
command-arg-mode: raw,完整命令字符串会原样传递给exec工具,确保可预测的执行行为。 - 该命令运行本地的
main.py脚本,其功能包括: - 加载数据集与可选的上下文文档
- 使用
Ollama (qwen3:8b)进行推理与摘要 - 生成三类制品,包括图表、Markdown 报告与工具执行轨迹
因此,OpenClaw 负责编排与执行,而 Ollama 提供本地推理。下一步,我们将把该技能接入 Web 界面,让用户上传数据并一键触发分析。
步骤 5:创建 Web 界面
此时,我们已经拥有两个核心部分:OpenClaw 工作区技能,以及提供推理能力的本地模型后端(Ollama)。现在需要一个轻量级界面,让您无需每次都使用终端即可上传文件并触发运行。
web_assistant.py 文件充当一个精简的前端服务器,负责:
- 接收文件上传,
- 为每次执行创建隔离的运行目录,
- 构建指向磁盘文件的 OpenClaw 斜杠命令,
- 在本地调用 OpenClaw 代理,
- 等待输出,
- 将可预览的制品返回给浏览器。
这里的关键设计是:Web 服务器本身从不运行分析逻辑。它把一切委派给 OpenClaw,从而保持 UI 简洁。
步骤 5.1:构建斜杠命令
目标是生成一条 OpenClaw 可作为聊天消息接收的字符串,例如:/local-data-analyst python3 ... --data-file ... --output-dir …
def build_slash_command(
data_path: Path,
docs_dir: Path,
output_dir: Path,
prompt: str,
model: str,
x_col: str,
y_col: str,
) -> str:
args = [
"python3",
str(BASE_DIR / "src" / "main.py"),
"--docs-dir", str(docs_dir),
"--data-file", str(data_path),
"--output-dir", str(output_dir),
"--prompt", prompt,
"--use-ollama",
"--model", model,
]
if x_col:
args.extend(["--x-column", x_col])
if y_col:
args.extend(["--y-column", y_col])
raw = " ".join(shlex.quote(a) for a in args)
return f"/local-data-analyst {raw}"build_slash_command() 函数准备将发送给 OpenClaw 的精确指令。Web 应用并不直接执行分析,而是构造一个结构化的斜杠命令,OpenClaw 能将其路由到对应的工作区技能。该函数执行四项关键工作:
args列表定义了对src/main.py的 CLI 调用。这与您在终端中手动运行的命令完全一致。- 仅在提供时才追加
--x-column与--y-column标志。若缺失,这个分析脚本可自动从数据集中推断列。 shlex.quote()会对所有参数(包括用户提示)进行转义。对处理空格与特殊字符至关重要,并在将用户输入传给 shell 命令时防止命令注入风险。
该函数返回以 /local-data-analyst 开头的字符串。此前缀与 SKILL.md 中定义的技能名相匹配。OpenClaw 收到该斜杠命令后,会立即将请求路由到 local-data-analyst 工作区技能,并通过 exec 工具执行底层命令。
步骤 5.2:OpenClaw 执行
有了斜杠命令之后,我们使用 CLI 代理运行器将其发送给 OpenClaw。这一步正是 Web 应用交接执行权的地方。
slash_message = build_slash_command(
data_path=data_path,
docs_dir=docs_dir,
output_dir=output_dir,
prompt=prompt,
model=model,
x_col=x_col,
y_col=y_col,
)
agent_cmd = [
"openclaw", "agent",
"--local",
"--session-id", f"stealth-web-{run_id}",
"--message", slash_message,
"--timeout", "120",
]
proc = subprocess.run(agent_cmd, capture_output=True,
text=True, env=openclaw_env())OpenClaw 代理的调用即为交接点:Web 应用停止工作,转而请求 OpenClaw 端到端执行工作流。
- 使用
--local可确保运行留在本机;代理通过本地网关与 Ollama 支持的模型处理请求,而非任何托管服务。 --session-id stealth-web-{run_id}为每次运行分配独立会话命名空间,避免状态互相影响,也便于后续针对特定执行进行调试。--message参数会传入与用户在聊天中输入完全一致的斜杠命令字符串;OpenClaw 接收后,将其路由到/local-data-analyst技能,并通过exec工具执行底层命令。- 最后,
--timeout 120作为安全阀,避免分析停滞导致 Web UI 无限等待;env=openclaw_env()则强制子进程使用项目本地的 OpenClaw 配置与状态目录,从而稳定指向预期的 Ollama 设置。
下一步,我们将加载生成的制品(包括图表、报告与工具轨迹),并在浏览器中渲染轻量预览。
步骤 5.3:服务器设置
最后,web_assistant.py 会运行一个小型本地 HTTP 服务器,以便您通过浏览器进行交互。
def main() -> int:
host = "127.0.0.1"
port = 8765
server = ThreadingHTTPServer((host, port), Handler)
print(f"Local Data Analyst web UI: http://{host}:{port}")
print("Press Ctrl+C to stop.")
try:
server.serve_forever()
except KeyboardInterrupt:
pass
return 0这使得部署更为简单:
ThreadingHTTPServer允许并发处理多个请求,而不阻塞整个应用。- 所有“实际工作”都在请求
Handler中完成:接收上传、创建运行文件夹、触发 OpenClaw,并返回预览。
注意:完整的 web_assistant.py 实现可在项目GitHub 仓库中查看。
步骤 6:构建本地分析引擎
至此,OpenClaw 已可通过工作区技能执行工作流,Web UI 也能借助斜杠命令触发运行。剩下的部分是分析引擎:它接收您上传的文件,执行工作流步骤,并生成制品。
该仓库中的 main.py 重点实现了两项定义流水线核心的功能:加载表格数据与调用 Ollama 进行本地推理。
步骤 6.1:加载表格数据
这个辅助函数在保持工作流一致性的同时,支持多种输入格式。
def load_tabular_data(data_path: Path, events: List[SkillEvent]) -> pd.DataFrame:
ext = data_path.suffix.lower()
if ext == ".csv":
df = pd.read_csv(data_path)
elif ext in {".tsv", ".tab"}:
df = pd.read_csv(data_path, sep="\t")
elif ext in {".json", ".jsonl"}:
try:
df = pd.read_json(data_path)
except ValueError:
df = pd.read_json(data_path, lines=True)
elif ext in {".xlsx", ".xls"}:
df = pd.read_excel(data_path)
else:
raise ValueError(f"Unsupported data file...")
log_event(events, "fs", "read", f"Loaded data file: {data_path.name}")
return dfload_tabular_data() 使用 data_path.suffix 识别文件类型,并交由正确的 pandas 加载器处理。CSV 与 TSV 文件通过 read_csv() 读取,其中 TSV/TAB 只需将分隔符切换为 \t。JSON 输入先用 read_json() 读取,若 pandas 抛出 ValueError,则回退至 lines=True 处理 JSONL。通过 read_excel() 增加了对 Excel 的支持,用户可直接上传 .xlsx 文件,无需预处理。
最后,log_event() 会记录一条结构化的跟踪条目,流水线稍后会将其序列化为 tool_trace.json。
步骤 6.2:Ollama 集成
由于本演示不依赖 SDK,因此直接调用 Ollama 的本地 HTTP API。
def ollama_generate(model: str, prompt: str) -> str:
url = "http://localhost:11434/api/generate"
payload = json.dumps({
"model": model,
"prompt": prompt,
"stream": False
}).encode("utf-8")
req = request.Request(url, data=payload,
headers={"Content-Type": "application/json"})
with request.urlopen(req, timeout=45) as resp:
body = json.loads(resp.read().decode("utf-8"))
return str(body.get("response", "")).strip()ollama_generate() 函数向 localhost 的 Ollama /api/generate 端点发送 JSON 负载。负载包含模型名称(例如 qwen3:8b)、最终的提示字符串,并禁用流式输出,以便一次返回完整响应。
使用 urllib.request 使该封装轻量且可移植,同时 timeout=45 可防止模型响应缓慢或服务器不可用时导致工作流无限挂起。最后,函数从 response 字段中提取模型输出并返回干净文本,后续将用于写入 analysis_report.md 文件。
步骤 7:构建 Web 服务器
以下是一个迷你启动脚本,用于启动本地 Web UI,以接收上传并在后台触发 OpenClaw 运行。
set -euo pipefail
ROOT="$(cd "$(dirname "$0")" && pwd)"
cd "$ROOT/.."
python3 ../web_assistant.py此脚本执行三件事:
set -euo pipefail让脚本快速失败:遇到错误即停止、将未设置变量视为错误、并避免管道中的静默失败。ROOT=...解析脚本所在目录,即便您在其他位置运行也可正常工作。cd "$ROOT/.."进入预期的项目根目录,然后启动web_assistant.py,该脚本托管 UI 并处理整个流水线。
脚本运行后,浏览器 UI 就成为本演示的入口。
步骤 8:启动系统
最后一步,我们采用双进程方式运行系统。OpenClaw 网关处理所有任务执行,而 Web 界面则作为用户层,用于提交请求与查看生成的输出。
终端 1:网关
在启动界面之前,先启动 OpenClaw 网关。该进程充当系统的执行层,处理代理请求、加载工作区技能、调用本地工具,并将推理调用路由到 Ollama 模型。
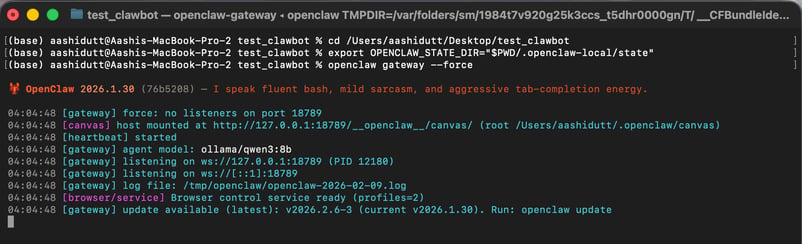
export OPENCLAW_CONFIG_PATH="$PWD/.openclaw-local/openclaw.json"
openclaw gateway --force在该终端中,OPENCLAW_CONFIG_PATH 指向项目本地配置(我们在其中将默认模型固定为 ollama/qwen3:8b,并为隐私禁用了 Web 搜索)。随后,openclaw gateway --force 会启动网关,即使 OpenClaw 认为已有进程在运行或部分配置存在也会强制启动。
网关就绪后,即可接受本地代理消息(包括我们的 /local-data-analyst 斜杠命令)。
终端 2:Web UI
网关启动后,运行 Web 界面,它会收集用户输入,将每个请求发送给本地 OpenClaw 代理,并显示生成的图表、报告与执行轨迹。
./local_data_analyst/run_web.sh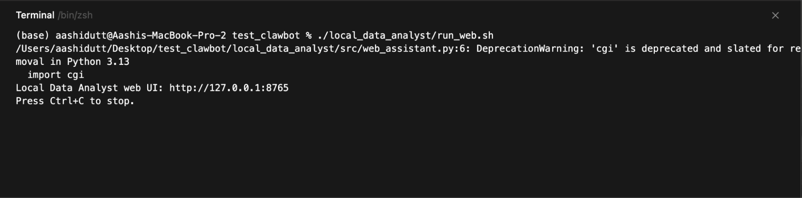
然后打开:
http://127.0.0.1:8765Web 服务器运行在 127.0.0.1,因此仅能从您的本机访问。点击“Run Analysis”后,UI 会写入运行文件夹、构造斜杠命令、调用 openclaw agent --local,随后轮询磁盘中的输出文件以便预览:
trend_chart.pnganalysis_report.mdtool_trace.json
最终输出看起来会类似如下。您可以使用一些示例文件进行测试。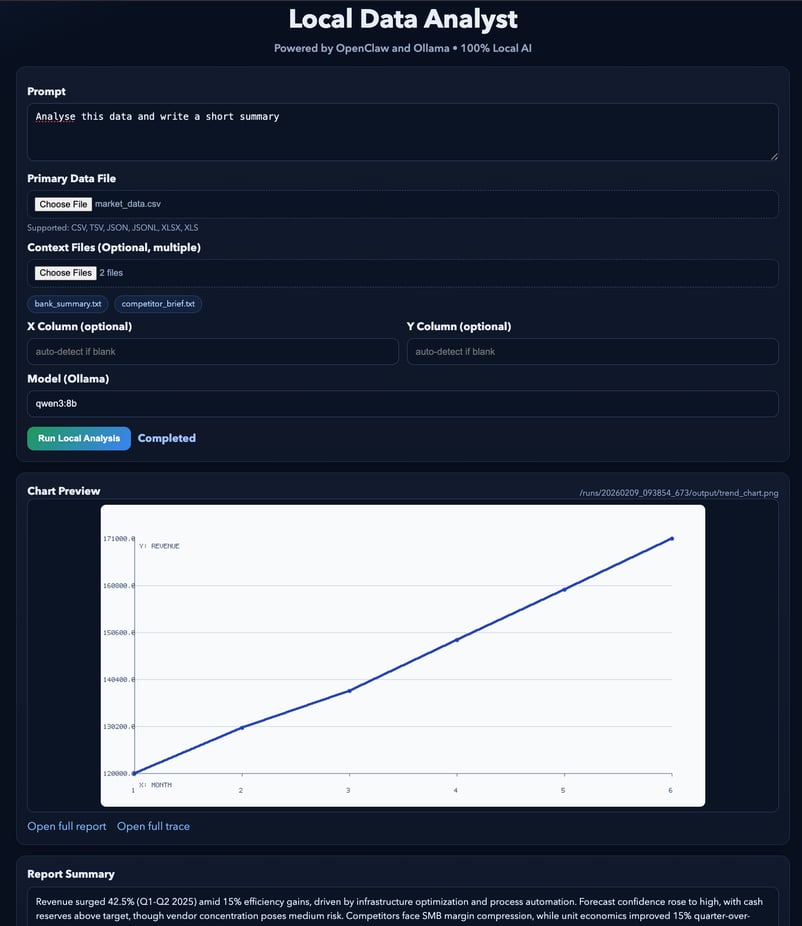
总结
在本教程中,我们构建了一个“本地优先”的 AI 应用:一个简洁的 Web 界面即可触发由 OpenClaw 与本地 Ollama 模型驱动的完整代理工作流。系统不调用外部 API,而是在您的机器上自洽闭环运行。
OpenClaw 负责编排与工具执行,Ollama 提供本地智能层。最终形成代理式工作流:单个请求即可产出结构化制品,如可视化、报告与审计轨迹。
接下来,您可以沿多个方向扩展本项目:为不同工作流添加新的工作区技能、集成更多本地工具(例如数据库查询或文档检索)、或将 OpenClaw 连接至 Slack、WhatsApp 等消息渠道以实现安全的远程访问。
您也可以尝试不同的 Ollama 模型,根据硬件在性能与质量间取得平衡。
若要进一步了解如何在工作流中使用 AI,建议查看《面向开发者的 AI 辅助编程》课程。也推荐查看我们的Moltbook 入门指南。
OpenClaw 与 Ollama 常见问题
在本地运行这个 OpenClaw + Ollama 项目是否需要 GPU?
不一定。qwen3:8b 模型可在 CPU 上运行,但性能会较慢。为了获得更流畅的体验,建议使用至少 16–32 GB 内存,或配备 8–12 GB 显存的 GPU。
这种设置下,我的任何数据会离开本机吗?
不会。所有处理均通过 OpenClaw 和 Ollama 在本地完成。配置中已禁用 Web 搜索,且不使用任何外部 API。
OpenClaw 与 Ollama 的角色分别是什么?
OpenClaw 是执行与编排引擎。它接收请求、运行工具并管理工作流。Ollama 是 OpenClaw 调用以进行推理与文本生成的本地模型后端。
我可以用其他模型替代 qwen3:8b 吗?
可以。您可以替换为任何 Ollama 支持的模型(例如适配轻量系统的 qwen3:1.5b,或追求更高质量的 qwen3:14b),只需先拉取模型并更新配置。
该系统能离线工作吗?
可以。一旦安装了 Ollama 和模型,整个工作流即可在无网络的情况下运行。

我是一名 Google Developers 机器学习(生成式 AI)领域的专家、Kaggle 三项专家,以及 Women Techmakers 大使,拥有 3 年以上的技术从业经验。2020 年我共同创办了一家健康科技初创公司,目前在佐治亚理工学院攻读计算机科学硕士,专攻机器学习。
现代 AI 工作流通常依赖云端 API。但如果您想要一个完全在本机运行、确保数据私密、同时仍支持多步代理工作流的系统,该怎么办?
在本教程中,您将构建一个“本地优先”的 AI 执行应用,其中:
这种模式对私有分析、内部工具,以及所有必须确保数据留在设备上的工作流尤为有价值。如果您的数据包含敏感的财务报表、法律文件或客户记录,云端 AI 方案可能并不合适。
该设置在保持全部数据与处理完全由您本地控制的同时,依然提供智能的多步行为能力。
得益于 OpenClaw 的渠道集成,同一套本地系统也可以扩展到 WhatsApp 或 Slack 等界面,让您在熟悉的环境中安全访问工作流。