

Ollama के साथ OpenClaw क्यों चलाएँ?
लोकल Ollama मॉडल के साथ OpenClaw चलाने से आपका सिस्टम एक स्व-निहित AI वातावरण बन जाता है। बाहरी API पर प्रॉम्प्ट और डेटा भेजने के बजाय, पूरा वर्कफ़्लो—तर्क, फ़ाइल एक्सेस, और आर्टिफैक्ट जनरेशन सहित—आपकी मशीन पर चलता है।
यह सेटअप कई व्यावहारिक लाभ देता है:
- डिज़ाइन से ही गोपनीयता: सभी डेटासेट, दस्तावेज़, और मध्यवर्ती आउटपुट डिवाइस पर ही रहते हैं। कुछ भी बाहरी सेवाओं को प्रेषित नहीं होता।
- पूर्ण पारदर्शिता और नियंत्रण: हर चरण जाँचा जा सकता है—OpenClaw को भेजे गए स्लैश कमांड से लेकर जनरेट हुई फ़ाइलों और एक्ज़ीक्यूशन ट्रेस तक।
- ऑफ़लाइन संचालन: एक बार मॉडल Ollama के माध्यम से पुल हो जाए, तो सिस्टम बिना इंटरनेट एक्सेस के काम करता है।
- एजेंट-स्टाइल एक्ज़ीक्यूशन: एकल उपयोगकर्ता अनुरोध एक मल्टी-स्टेप वर्कफ़्लो ट्रिगर कर सकता है, केवल एक टेक्स्ट उत्तर के बजाय।
यह ट्यूटोरियल एक लोकल एजेंट आर्किटेक्चर बनाने पर केंद्रित है, जहाँ OpenClaw एक्ज़ीक्यूशन इंजन का काम करता है, और Ollama तर्क की परत प्रदान करता है।
OpenClaw Ollama ट्यूटोरियल: एक लोकल डेटा एनालिस्ट बनाना
mइस सेक्शन में, हम OpenClaw और एक लोकल Ollama मॉडल का उपयोग करके एक लोकल डेटा एनालिस्ट ऐप बनाएँगे जो पूरी तरह आपकी मशीन पर चलता है। उच्च स्तर पर, सिस्टम तीन मुख्य कार्य करता है:
- उपयोगकर्ता से एक CSV डेटासेट स्वीकार करना
- वैकल्पिक रूप से सहायक संदर्भ दस्तावेज़ (PDF, TXT, या Markdown) इनजेस्ट करना
- इनसाइट्स और विज़ुअलाइज़ेशन जनरेट करने के लिए मल्टी-स्टेप विश्लेषण वर्कफ़्लो चलाना
सिस्टम तीन आउटपुट आर्टिफैक्ट बनाता है:
trend_chart.pnganalysis_report.mdtool_trace.json
पर्दे के पीछे, वर्कफ़्लो तीन घटकों द्वारा समन्वित होता है:
- वेब इंटरफ़ेस(
web_assistant.py): यह Python फ़ाइल फ़ाइल अपलोड हैंडल करती है, एक रन डायरेक्टरी बनाती है, और OpenClaw को एक स्लैश कमांड भेजती है। - OpenClaw एजेंट: OpenClaw एजेंट वर्कस्पेस स्किल लोड करता है, टूल्स के माध्यम से लोकल कमांड चलाता है, और तर्क और सारांश के लिए Ollama के माध्यम से होस्ट किए गए लोकल LLMs का उपयोग करता है।
- एनालिसिस इंजन (
main.py): यह फ़ाइल डेटासेट पढ़ती है, प्रासंगिक कॉलम्स का अनुमान लगाती है, चार्ट और इनसाइट्स बनाती है, और सभी आउटपुट डिस्क पर लिखती है।
वर्कफ़्लो पूर्ण होने पर, वेब इंटरफ़ेस जनरेट किए गए आर्टिफैक्ट का प्रीव्यू दिखाता है, जिससे उपयोगकर्ता परिणाम और एक्ज़ीक्यूशन ट्रेस देख सकता है।
चरण 1: OpenClaw इंस्टॉल करें
लोकल डेटा एनालिस्ट वर्कफ़्लो बनाने से पहले, हमें आपके सिस्टम पर OpenClaw Gateway चलाना होगा। इस प्रोजेक्ट में OpenClaw को एक्ज़ीक्यूशन लेयर के रूप में समझें, जो वेब UI से अनुरोध प्राप्त करता है, वर्कस्पेस स्किल लोड करता है, लोकल टूल्स (जैसे शेल कमांड और Python स्क्रिप्ट) चलाता है, और एंड-टू-एंड पूरे वर्कफ़्लो का समन्वय करता है।
curl -fsSL https://openclaw.ai/install.sh | bash
openclaw onboard --install-daemonयह कमांड OpenClaw CLI इंस्टॉल करता है, लोकल वातावरण कॉन्फ़िगर करने के लिए ऑनबोर्डिंग विज़ार्ड चलाता है, और गेटवे डेमन सेट करता है ताकि इसे आसानी से शुरू और बंद किया जा सके। यद्यपि हम इस डेमो के लिए गेटवे को फ़ोरग्राउंड में चलाएँगे, डेमन इंस्टॉल करने से मानक सेटअप सुनिश्चित होता है और ट्रबलशूटिंग सरल हो जाती है।
अब, आइए पुष्टि कर लें कि सब कुछ काम कर रहा है:
openclaw doctor
openclaw gateway statusOpenClaw doctor रिपोर्ट करता है कि OpenClaw सही तरीके से इंस्टॉल है। OpenClaw gateway status बताता है कि गेटवे वर्तमान में चल रहा है या नहीं। इस चरण में, यह “not running” भी कह सकता है, जो ठीक है। मुख्य बात यह है कि कमांड काम करता है और इंस्टॉलेशन पहचाना जा रहा है।
यदि आप हर ऑनबोर्डिंग विकल्प (चैनल, ऑथ, स्किल्स, गेटवे सिक्योरिटी) का विस्तृत वॉकथ्रू चाहते हैं, तो आप पूर्ण चरण-दर-चरण सेटअप के लिए OpenClaw ट्यूटोरियल देख सकते हैं।
चरण 2: Ollama इंस्टॉल करें
इसके बाद, हम Ollama सेटअप करेंगे, जो इस प्रोजेक्ट के लिए लोकल LLM बैकएंड की तरह काम करेगा। OpenClaw अभी भी वर्कफ़्लो का ऑर्केस्ट्रेशन करेगा, लेकिन जब उसे संक्षेप या तर्क के लिए मॉडल इंटेलिजेंस चाहिए होगा, तो वह Ollama के माध्यम से LLMs को कॉल करेगा।
निम्न कमांड चलाएँ:
brew install ollama
ollama serve
ollama pull qwen3:8bऊपर दिए गए कमांड Ollama रनटाइम इंस्टॉल करते हैं, लोकल मॉडल सर्वर शुरू करते हैं जिससे OpenClaw संचार करेगा, और qwen3:8b मॉडल डाउनलोड करते हैं। हम qwen3:8b का उपयोग करते हैं क्योंकि यह अधिकांश लैपटॉप के लिए प्रदर्शन और गुणवत्ता का अच्छा संतुलन देता है, लेकिन आप अपनी मशीन के संसाधनों के आधार पर कोई भी अन्य मॉडल चुन सकते हैं। आप Ollama के इस सेटअप गाइड को भी देख सकते हैं।
चरण 3: OpenClaw कॉन्फ़िगर करें
अब हमें OpenClaw को लोकल Ollama इंस्टेंस का उपयोग करने के लिए कॉन्फ़िगर करना है। इससे यह सुनिश्चित होता है कि सभी तर्क, संक्षेप और विश्लेषण आपकी मशीन पर ही हों और कोई बाहरी API कॉल न हो।
एक लोकल कॉन्फ़िगरेशन डायरेक्टरी बनाएँ:
mkdir -p .openclaw-localफिर यह फ़ाइल बनाएँ:
.openclaw-local/openclaw.json
{
"models": {
"providers": {
"ollama": {
"baseUrl": "http://127.0.0.1:11434/v1",
"apiKey": "ollama-local",
"api": "openai-completions",
"models": [
{
"id": "qwen3:8b",
"name": "qwen3:8b",
"reasoning": false,
"input": ["text"],
"cost": { "input": 0, "output": 0, "cacheRead": 0, "cacheWrite": 0 },
"contextWindow": 131072,
"maxTokens": 8192
}
]
}
}
},
"agents": {
"defaults": {
"model": { "primary": "ollama/qwen3:8b" }
}
},
"tools": {
"web": {
"search": { "enabled": false },
"fetch": { "enabled": true }
}
}
}ऊपर का कॉन्फ़िगरेशन तीन मुख्य घटक परिभाषित करता है:
baseUrlउस लोकल API एंडपॉइंट की ओर इशारा करता है जिसेollama serveएक्सपोज़ करता है, जबकिapi: openai-completionsसेटिंग OpenAI-कम्पैटिबल कम्युनिकेशन सक्षम करती है। qwen3:8b के लिए मॉडल रजिस्ट्रेशन उसकी क्षमताएँ बताता है, जिसमें बड़े डेटासेट संभालने के लिए 131K का बड़ा कॉन्टेक्स्ट विंडो और नियंत्रित उत्तरों के लिए टोकन लिमिट शामिल है। क्योंकि मॉडल लोकल चलता है, सभी कॉस्ट वैल्यू शून्य हैं।agent defaultsसेक्शन नियंत्रित करता है कि OpenClaw एजेंट तर्क के लिए कौन सा मॉडल उपयोग करें। प्राथमिक मॉडल कोollama/qwen3:8bपर सेट करके, हर एजेंट टास्क—जैसे प्रॉम्प्ट समझना, संक्षेप बनाना, या डेटा पर तर्क करना—स्वतः लोकल Ollama मॉडल पर रूट होता है, बिना किसी बाहरी API कॉल के।- टूल कॉन्फ़िगरेशन वेब सर्च जैसी बाहरी क्षमताएँ मैनेज करता है, जो गोपनीयता सुनिश्चित करने और आउटबाउंड अनुरोध रोकने के लिए डिसेबल्ड है। जब ज़रूरत हो तब सीमित संसाधन प्राप्ति के लिए फ़ेच टूल सक्षम रहता है।
साथ मिलकर, ये सेटिंग्स सुनिश्चित करती हैं कि पूरा वर्कफ़्लो आपकी मशीन पर निजी रूप से चले, जहाँ OpenClaw ऑर्केस्ट्रेशन संभाले और Ollama लोकल इंटेलिजेंस प्रदान करे।
चरण 4: वर्कस्पेस स्किल परिभाषित करें
इस चरण में, हम वह वर्कस्पेस स्किल परिभाषित करते हैं जो OpenClaw को बताती है कि हमारा वर्कफ़्लो कैसे चलाना है। मॉडल पर टूल उपयोग की योजना बनाने के बजाय, हम कमांड डिस्पैच मोड का उपयोग करते हैं, जो एक स्लैश कमांड को सीधे लोकल एक्ज़ीक्यूशन कमांड ट्रिगर करने देता है, जिससे वर्कफ़्लो तेज और पूरी तरह लोकल हो जाता है।
आइए अपने वर्कस्पेस में निम्नलिखित SKILL.md फ़ाइल बनाएँ:
---
name: local-data-analyst
description: Local Data Analyst: analyze private local data with Ollama, generate chart/report, and keep all data on-device.
user-invocable: true
command-dispatch: tool
command-tool: exec
command-arg-mode: raw
---
Invoke as /local-data-analyst <raw command>.
This skill bypasses model planning and dispatches raw command text directly to the exec tool.
Use this exact command template in this workspace:
python3 /……/main.py --docs-dir <context_dir> --data-file <data_file> --output-dir <output_dir> --prompt "<prompt>" --use-ollama --model qwen3:8b
Expected outputs under <output_dir>:
- trend_chart.png
- analysis_report.md
- tool_trace.jsonयह स्किल कॉन्फ़िगरेशन नियंत्रित करती है कि OpenClaw विश्लेषण कैसे चलाता है:
- फ्रंट मैटर (फ़ाइल के सबसे ऊपर का स्ट्रक्चर्ड मेटाडेटा ब्लॉक)
local-data-analystनामक एक यूज़र-इनवोकेबल स्किल परिभाषित करता है, जो/local-data-analystस्लैश कमांड के रूप में उपलब्ध हो जाती है। - स्लैश कमांड, चैट या UI से स्ट्रक्चर्ड एक्शन ट्रिगर करने का OpenClaw का तरीका है।
command-dispatch: toolसेटिंग कमांड डिस्पैच मोड सक्षम करती है, जिसमें OpenClaw मॉडल से यह पूछने के बजाय कि क्या करना है, कमांड को सीधे किसी टूल तक रूट करता है।command-arg-mode: rawके साथ, पूरा कमांड स्ट्रिंग बिना बदलेexecटूल को पास होता है, जिससे एक्ज़ीक्यूशन पूर्वानुमेय बनता है।- कमांड लोकल
main.pyस्क्रिप्ट चलाता है, जो: - डेटासेट और वैकल्पिक संदर्भ दस्तावेज़ लोड करता है
Ollama (qwen3:8b)का उपयोग तर्क और संक्षेप के लिए करता है- तीन आर्टिफैक्ट जनरेट करता है, जिनमें एक चार्ट, एक मार्कडाउन रिपोर्ट, और एक टूल एक्ज़ीक्यूशन ट्रेस शामिल हैं
इस प्रकार, OpenClaw ऑर्केस्ट्रेशन और एक्ज़ीक्यूशन संभालता है, जबकि Ollama लोकल तर्क प्रदान करता है। अगले चरण में, हम इस स्किल को वेब इंटरफ़ेस से जोड़ेंगे ताकि उपयोगकर्ता डेटा अपलोड कर सकें और एक ही एक्शन से विश्लेषण ट्रिगर कर सकें।
चरण 5: वेब इंटरफ़ेस बनाएँ
इस बिंदु पर, हमारे पास दो मुख्य हिस्से पहले से काम कर रहे हैं—एक OpenClaw वर्कस्पेस स्किल और तर्क प्रदान करने वाला लोकल मॉडल बैकएंड (Ollama)। अब हमें एक हल्का इंटरफ़ेस चाहिए जो आपको फ़ाइलें अपलोड करने और हर बार टर्मिनल छुए बिना रन ट्रिगर करने दे।
web_assistant.py फ़ाइल एक पतला फ़्रंटएंड सर्वर की तरह काम करती है जो:
- फ़ाइल अपलोड स्वीकार करता है,
- प्रत्येक एक्ज़ीक्यूशन के लिए एक अलग रन डायरेक्टरी बनाता है,
- डिस्क पर मौजूद फ़ाइलों की ओर इशारा करने वाला OpenClaw स्लैश कमांड बनाता है,
- लोकल रूप से OpenClaw एजेंट को कॉल करता है,
- आउटपुट का इंतज़ार करता है,
- ब्राउज़र को प्रीव्यू-रेडी आर्टिफैक्ट लौटाता है।
यहाँ मुख्य डिज़ाइन निर्णय यह है कि वेब सर्वर स्वयं विश्लेषण लॉजिक कभी नहीं चलाता। वह सब कुछ OpenClaw को डेलीगेट करता है, ताकि UI सरल बना रहे।
चरण 5.1: स्लैश कमांड बनाना
यहाँ लक्ष्य एक ऐसा सिंगल स्ट्रिंग तैयार करना है जिसे OpenClaw एक चैट संदेश के रूप में प्राप्त कर सके, जैसे: /local-data-analyst python3 ... --data-file ... --output-dir …
def build_slash_command(
data_path: Path,
docs_dir: Path,
output_dir: Path,
prompt: str,
model: str,
x_col: str,
y_col: str,
) -> str:
args = [
"python3",
str(BASE_DIR / "src" / "main.py"),
"--docs-dir", str(docs_dir),
"--data-file", str(data_path),
"--output-dir", str(output_dir),
"--prompt", prompt,
"--use-ollama",
"--model", model,
]
if x_col:
args.extend(["--x-column", x_col])
if y_col:
args.extend(["--y-column", y_col])
raw = " ".join(shlex.quote(a) for a in args)
return f"/local-data-analyst {raw}"build_slash_command() फ़ंक्शन वह सटीक निर्देश तैयार करता है जो OpenClaw को भेजा जाएगा। विश्लेषण को सीधे चलाने के बजाय, वेब ऐप एक स्ट्रक्चर्ड स्लैश कमांड बनाता है जिसे OpenClaw उपयुक्त वर्कस्पेस स्किल तक रूट कर सकता है। यह फ़ंक्शन चार प्रमुख काम करता है:
argsलिस्टsrc/main.pyके CLI कॉल को परिभाषित करती है। यह वही कमांड है जिसे आप टर्मिनल से मैन्युअली चला सकते हैं।--x-columnऔर--y-columnफ़्लैग्स केवल तभी जोड़े जाते हैं जब दिए जाएँ। यदि ये वैल्यू मिसिंग हों, तो विश्लेषण स्क्रिप्ट डेटासेट से कॉलम्स ऑटो-इन्फर कर सकती है।shlex.quote()कॉल सभी आर्गुमेंट्स, सहित यूज़र प्रॉम्प्ट, को एस्केप करता है। यह स्पेसेज़ और विशेष कैरेक्टर्स हैंडल करने के लिए अहम है और यूज़र इनपुट को शेल कमांड में पास करते समय कमांड-इंजेक्शन जोखिमों को रोकता है।
फ़ंक्शन एक स्ट्रिंग लौटाता है जो /local-data-analyst से शुरू होती है। यह प्रीफ़िक्स SKILL.md में परिभाषित स्किल नाम से मेल खाता है। जब OpenClaw यह स्लैश कमांड प्राप्त करता है, तो वह तुरंत रिक्वेस्ट को local-data-analyst वर्कस्पेस स्किल तक रूट करता है, जो फिर exec टूल के माध्यम से कमांड चलाता है।
चरण 5.2: OpenClaw एक्ज़ीक्यूशन
अब जबकि हमारे पास स्लैश कमांड है, हम इसे CLI एजेंट रनर का उपयोग करके OpenClaw को भेजते हैं। यहीं वेब ऐप एक्ज़ीक्यूशन हैंडऑफ़ करता है।
slash_message = build_slash_command(
data_path=data_path,
docs_dir=docs_dir,
output_dir=output_dir,
prompt=prompt,
model=model,
x_col=x_col,
y_col=y_col,
)
agent_cmd = [
"openclaw", "agent",
"--local",
"--session-id", f"stealth-web-{run_id}",
"--message", slash_message,
"--timeout", "120",
]
proc = subprocess.run(agent_cmd, capture_output=True,
text=True, env=openclaw_env())OpenClaw एजेंट इनवोकेशन वह हैंडऑफ़ पॉइंट है जहाँ वेब ऐप काम करना बंद कर देता है और OpenClaw से एंड-टू-एंड वर्कफ़्लो एक्ज़ीक्यूट करने के लिए कहता है।
--localका उपयोग यह सुनिश्चित करता है कि रन आपकी मशीन पर ही रहे, और एजेंट रिक्वेस्ट को आपके लोकल गेटवे और Ollama-बैक्ड मॉडल के माध्यम से प्रोसेस करे, न कि किसी होस्टेड सेवा से।--session-id stealth-web-{run_id}फ़्लैग हर रन को अपना अलग सेशन नेमस्पेस देता है, जिससे स्टेट रन के बीच मिक्स नहीं होती और बाद में किसी विशिष्ट एक्ज़ीक्यूशन को डीबग करना आसान होता है।--messageआर्गुमेंट स्लैश कमांड स्ट्रिंग को ठीक वैसे ही पास करता है जैसे किसी यूज़र ने इसे चैट में टाइप किया हो; OpenClaw इसे प्राप्त करता है,/local-data-analystस्किल तक रूट करता है, औरexecटूल के माध्यम से अंतर्निहित कमांड एक्ज़ीक्यूट करता है।- अंत में,
--timeout 120एक सेफ़्टी वाल्व की तरह काम करता है ताकि अगर विश्लेषण अटक जाए तो वेब UI अनिश्चितकाल के लिए हैंग न हो, औरenv=openclaw_env()सब-प्रोसेस को आपके प्रोजेक्ट-लोकल OpenClaw कॉन्फ़िग और स्टेट डायरेक्टरी का उपयोग करने के लिए बाध्य करता है ताकि वह लगातार इच्छित Ollama सेटअप को टार्गेट करे।
अगले चरण में, हम जनरेट किए गए आर्टिफैक्ट—चार्ट, रिपोर्ट, और टूल ट्रेस—लोड करेंगे और ब्राउज़र में हल्के प्रीव्यू रेंडर करेंगे।
चरण 5.3: सर्वर सेटअप
अंततः, web_assistant.py एक छोटा सा लोकल HTTP सर्वर चलाता है ताकि आप ब्राउज़र के माध्यम से इंटरैक्ट कर सकें।
def main() -> int:
host = "127.0.0.1"
port = 8765
server = ThreadingHTTPServer((host, port), Handler)
print(f"Local Data Analyst web UI: http://{host}:{port}")
print("Press Ctrl+C to stop.")
try:
server.serve_forever()
except KeyboardInterrupt:
pass
return 0यह डिप्लॉयमेंट सरल रखता है:
ThreadingHTTPServerपूरी ऐप को ब्लॉक किए बिना एकाधिक रिक्वेस्ट की अनुमति देता है।- सारा “वास्तविक काम” रिक्वेस्ट
Handlerमें होता है, जो अपलोड प्राप्त करता है, रन फ़ोल्डर बनाता है, OpenClaw ट्रिगर करता है, और प्रीव्यू लौटाता है।
नोट: web_assistant.py का पूरा कोड इम्प्लीमेंटेशन प्रोजेक्ट के GitHub रेपो में उपलब्ध है।
चरण 6: लोकल विश्लेषण इंजन बनाएँ
इस बिंदु पर, OpenClaw वर्कस्पेस स्किल के माध्यम से वर्कफ़्लो एक्ज़ीक्यूट करने में सक्षम है, और वेब UI स्लैश कमांड के जरिए रन ट्रिगर कर सकता है। शेष हिस्सा वह विश्लेषण इंजन है जो आपकी अपलोड की गई फ़ाइलें लेता है, वर्कफ़्लो स्टेप्स चलाता है, और आर्टिफैक्ट तैयार करता है।
इस रेपो में main.py फ़ाइल पाइपलाइन के हृदय को परिभाषित करने वाले दो फ़ंक्शंस पर केंद्रित है, यानी टैब्युलर डेटा लोड करना और लोकल तर्क के लिए Ollama को कॉल करना।
चरण 6.1: टैब्युलर डेटा लोड करना
यह हेल्पर कई इनपुट फ़ॉर्मैट सपोर्ट करता है, जबकि वर्कफ़्लो को सुसंगत रखता है।
def load_tabular_data(data_path: Path, events: List[SkillEvent]) -> pd.DataFrame:
ext = data_path.suffix.lower()
if ext == ".csv":
df = pd.read_csv(data_path)
elif ext in {".tsv", ".tab"}:
df = pd.read_csv(data_path, sep="\t")
elif ext in {".json", ".jsonl"}:
try:
df = pd.read_json(data_path)
except ValueError:
df = pd.read_json(data_path, lines=True)
elif ext in {".xlsx", ".xls"}:
df = pd.read_excel(data_path)
else:
raise ValueError(f"Unsupported data file...")
log_event(events, "fs", "read", f"Loaded data file: {data_path.name}")
return dfload_tabular_data() फ़ंक्शन data_path.suffix का उपयोग करके फ़ाइल टाइप डिटेक्ट करता है और उसे सही pandas लोडर तक रूट करता है। CSV और TSV फ़ाइलें read_csv() से हैंडल होती हैं, जहाँ TSV/टैब फ़ाइलें केवल डिलिमिटर को \t में बदलती हैं। JSON इनपुट पहले read_json() से हैंडल होते हैं, और यदि pandas ValueError फेंके, तो lines=True के साथ JSONL के लिए फॉलबैक होता है। Excel सपोर्ट read_excel() के माध्यम से जोड़ा गया है ताकि उपयोगकर्ता .xlsx फ़ाइलें बिना प्री-प्रोसेसिंग के अपलोड कर सकें।
अंत में, log_event() कॉल एक स्ट्रक्चर्ड ट्रेस एंट्री रिकॉर्ड करता है जिसे पाइपलाइन बाद में tool_trace.json में सीरियलाइज़ कर सकती है।
चरण 6.2: Ollama इंटीग्रेशन
क्योंकि यह डेमो SDK पर निर्भर नहीं है, यह सीधे Ollama के लोकल HTTP API को कॉल करता है।
def ollama_generate(model: str, prompt: str) -> str:
url = "http://localhost:11434/api/generate"
payload = json.dumps({
"model": model,
"prompt": prompt,
"stream": False
}).encode("utf-8")
req = request.Request(url, data=payload,
headers={"Content-Type": "application/json"})
with request.urlopen(req, timeout=45) as resp:
body = json.loads(resp.read().decode("utf-8"))
return str(body.get("response", "")).strip()ollama_generate() फ़ंक्शन localhost पर Ollama के /api/generate एंडपॉइंट को JSON पेलोड भेजता है। पेलोड मॉडल नाम (उदाहरण के लिए, qwen3:8b), अंतिम प्रॉम्प्ट स्ट्रिंग बताता है और स्ट्रीमिंग डिसेबल करता है ताकि फ़ंक्शन एक एकल पूर्ण रिस्पॉन्स लौटाए।
urllib.request का उपयोग इस रैपर को हल्का और पोर्टेबल रखता है, और timeout=45 गार्ड हमारे वर्कफ़्लो को अनिश्चितकाल तक हैंग होने से रोकता है अगर मॉडल धीमा हो या सर्वर डाउन हो। अंत में, फ़ंक्शन response फ़ील्ड से मॉडल आउटपुट एक्सट्रैक्ट करता है और साफ़ टेक्स्ट लौटाता है, जिसका बाद में analysis_report.md फ़ाइल लिखने में उपयोग होता है।
चरण 7: वेब सर्वर बनाएँ
यहाँ एक छोटा लॉन्चर स्क्रिप्ट है जो लोकल वेब UI शुरू करता है, जो अपलोड स्वीकार करता है और बैकग्राउंड में OpenClaw रन ट्रिगर करता है।
set -euo pipefail
ROOT="$(cd "$(dirname "$0")" && pwd)"
cd "$ROOT/.."
python3 ../web_assistant.pyयह स्क्रिप्ट तीन काम करती है:
set -euo pipefailस्क्रिप्ट को फ़ेल-फ़ास्ट बनाता है, यानी एरर पर रुकता है, अनसेट वेरिएबल्स को एरर मानता है, और पाइपलाइनों में साइलेंट फ़ेल्योर से बचाता है।ROOT=...उस डायरेक्टरी को रिज़ॉल्व करता है जहाँ स्क्रिप्ट रहती है, ताकि यह कहीं से भी चलाने पर काम करे।cd "$ROOT/.."अपेक्षित प्रोजेक्ट रूट में जाता है और फिरweb_assistant.pyशुरू करता है, जो UI होस्ट करता है और पूरी पाइपलाइन हैंडल करता है।
एक बार यह स्क्रिप्ट चलने लगे, आपका ब्राउज़र UI इस डेमो का फ्रंट डोर बन जाता है।
चरण 8: सिस्टम शुरू करें
अंतिम चरण के लिए, हम सिस्टम को दो-प्रोसेस सेटअप से चलाते हैं। OpenClaw गेटवे सभी टास्क एक्ज़ीक्यूशन संभालता है, जबकि वेब इंटरफ़ेस उपयोगकर्ता लेयर के रूप में अनुरोध सबमिट करने और जनरेट किए गए आउटपुट देखने का काम करता है।
टर्मिनल 1: गेटवे
इंटरफ़ेस लॉन्च करने से पहले, हम पहले OpenClaw गेटवे शुरू करते हैं। यह प्रोसेस सिस्टम के एक्ज़ीक्यूशन लेयर की तरह काम करता है—एजेंट रिक्वेस्ट हैंडल करना, वर्कस्पेस स्किल लोड करना, लोकल टूल्स इनवोक करना, और तर्क कॉल्स को Ollama मॉडल तक रूट करना।
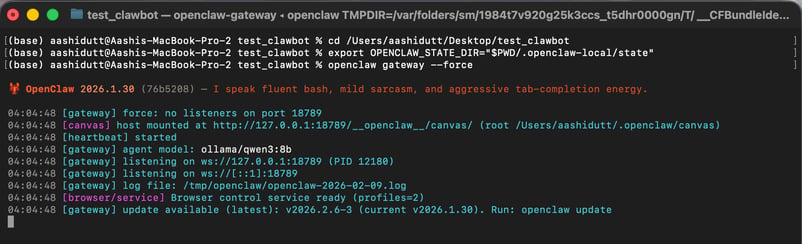
export OPENCLAW_CONFIG_PATH="$PWD/.openclaw-local/openclaw.json"
openclaw gateway --forceइस टर्मिनल में, OPENCLAW_CONFIG_PATH OpenClaw को प्रोजेक्ट-लोकल कॉन्फ़िग की ओर इंगित करता है, जहाँ हमने डिफ़ॉल्ट मॉडल को ollama/qwen3:8b पर पिन किया है और गोपनीयता के लिए वेब सर्च डिसेबल की है। अगला, openclaw gateway --force गेटवे शुरू करता है, भले ही OpenClaw को लगे कि कुछ पहले से चल रहा है या आंशिक रूप से कॉन्फ़िगर है।
जब गेटवे अप हो जाता है, तो वह लोकल एजेंट संदेश स्वीकार करने के लिए तैयार रहता है (हमारे /local-data-analyst स्लैश कमांड सहित)।
टर्मिनल 2: वेब UI
गेटवे चलने के बाद, हम वेब इंटरफ़ेस लॉन्च करते हैं, जो उपयोगकर्ता इनपुट एकत्र करता है, प्रत्येक अनुरोध को लोकल OpenClaw एजेंट को भेजता है, और जनरेट किए गए चार्ट, रिपोर्ट और एक्ज़ीक्यूशन ट्रेसेज़ दिखाता है।
./local_data_analyst/run_web.sh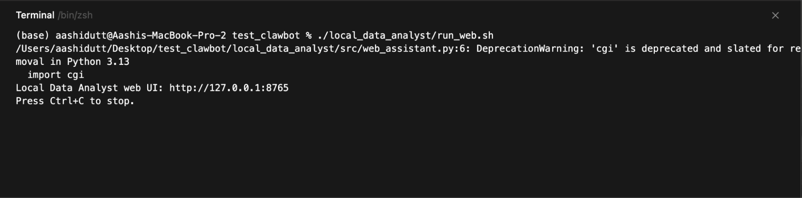
फिर यह खोलें:
http://127.0.0.1:8765वेब सर्वर 127.0.0.1 पर चलता है, इसलिए यह केवल आपकी मशीन से ही एक्सेसिबल है। जब आप Run Analysis पर क्लिक करते हैं, तो UI एक रन फ़ोल्डर लिखता है, स्लैश कमांड बनाता है, openclaw agent --local इनवोक करता है, और फिर आउटपुट फ़ाइलों के लिए डिस्क पोल करता है ताकि वह प्रीव्यू दिखा सके:
trend_chart.pnganalysis_report.mdtool_trace.json
अंतिम आउटपुट कुछ इस तरह दिखेगा। आप इस डेमो को कुछ उदाहरण फ़ाइलों के साथ टेस्ट कर सकते हैं।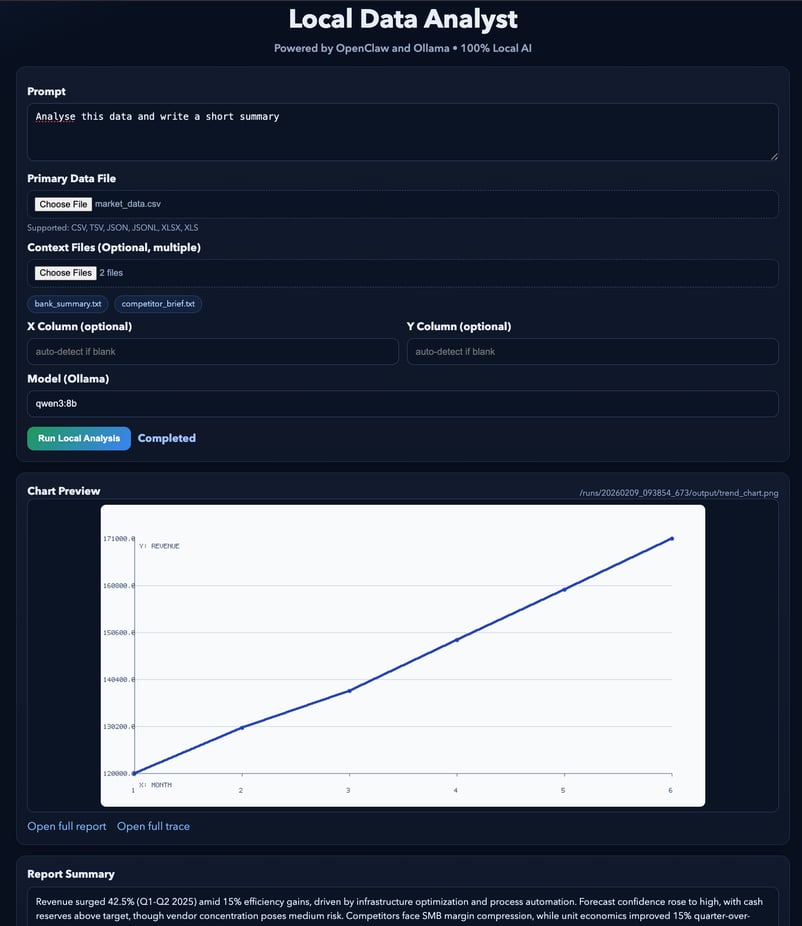
निष्कर्ष
इस ट्यूटोरियल में, हमने एक लोकल-फ़र्स्ट AI ऐप बनाया जहाँ एक सरल वेब इंटरफ़ेस OpenClaw और एक लोकल Ollama मॉडल द्वारा संचालित पूर्ण एजेंट वर्कफ़्लो ट्रिगर करता है। बाहरी API कॉल करने के बजाय, सिस्टम पूरा लूप आपकी मशीन पर रखता है।
OpenClaw ऑर्केस्ट्रेशन और टूल एक्ज़ीक्यूशन संभालता है, जबकि Ollama लोकल इंटेलिजेंस लेयर प्रदान करता है। नतीजा एक एजेंट-स्टाइल वर्कफ़्लो है जहाँ एकल अनुरोध विज़ुअलाइज़ेशन, रिपोर्ट और ऑडिट ट्रेल जैसे स्ट्रक्चर्ड आर्टिफैक्ट तैयार करता है।
यहाँ से, आप इस प्रोजेक्ट को कई दिशाओं में बढ़ा सकते हैं। आप अलग-अलग वर्कफ़्लो के लिए नई वर्कस्पेस स्किल्स जोड़ सकते हैं, अतिरिक्त लोकल टूल्स (उदाहरण के लिए, डेटाबेस क्वेरी या दस्तावेज़ खोज) इंटीग्रेट कर सकते हैं, या सुरक्षित रिमोट एक्सेस के लिए OpenClaw को Slack या WhatsApp जैसे मैसेजिंग चैनलों से जोड़ सकते हैं।
आप अलग-अलग Ollama मॉडल्स के साथ भी प्रयोग कर सकते हैं, ताकि अपने हार्डवेयर के आधार पर प्रदर्शन और गुणवत्ता का सही संतुलन मिल सके।
अपने वर्कफ़्लो में AI के साथ काम करने के बारे में अधिक जानने के लिए, मैं AI-Assisted Coding for Developers कोर्स देखने की सलाह देता/देती हूँ। साथ ही हमारा Moltbook गाइड भी देखें।
OpenClaw और Ollama से जुड़े सामान्य प्रश्न
क्या मुझे यह OpenClaw Ollama प्रोजेक्ट लोकली चलाने के लिए GPU चाहिए?
ज़रूरी नहीं। qwen3:8b मॉडल CPU पर चल सकता है, लेकिन प्रदर्शन धीमा होगा। बेहतर अनुभव के लिए, कम से कम 16–32 GB RAM या 8–12 GB VRAM वाले GPU वाली मशीन की सिफारिश की जाती है।
क्या इस सेटअप में कोई डेटा मेरी मशीन से बाहर जाता है?
नहीं। सारा प्रोसेसिंग OpenClaw और Ollama के माध्यम से लोकल होती है। कॉन्फ़िगरेशन में वेब सर्च डिसेबल है, और कोई बाहरी API इस्तेमाल नहीं होते।
OpenClaw और Ollama की भूमिकाएँ क्या हैं?
OpenClaw एक्ज़ीक्यूशन और ऑर्केस्ट्रेशन इंजन है। यह रिक्वेस्ट प्राप्त करता है, टूल्स चलाता है, और वर्कफ़्लो मैनेज करता है। Ollama लोकल मॉडल बैकएंड है जिसे OpenClaw तर्क और टेक्स्ट जनरेशन के लिए कॉल करता है।
क्या मैं qwen3:8b के बजाय कोई दूसरा मॉडल उपयोग कर सकता/सकती हूँ?
हाँ। आप किसी भी Ollama-समर्थित मॉडल से इसे बदल सकते हैं (उदाहरण के लिए, हल्की प्रणालियों के लिए qwen3:1.5b या बेहतर गुणवत्ता के लिए qwen3:14b), बशर्ते आप मॉडल पुल कर लें और कॉन्फ़िगरेशन अपडेट कर दें।
क्या यह सिस्टम ऑफ़लाइन काम कर सकता है?
हाँ। एक बार Ollama और मॉडल इंस्टॉल हो जाएँ, पूरा वर्कफ़्लो बिना इंटरनेट एक्सेस के चलता है।

मैं एमएल (Gen AI) में Google Developers Expert, Kaggle 3x Expert, और Women Techmakers एंबेसडर हूँ, तथा तकनीक क्षेत्र में 3+ वर्षों का अनुभव रखती हूँ। मैंने 2020 में एक हेल्थ-टेक स्टार्टअप की सह-स्थापना की और वर्तमान में Georgia Tech से कंप्यूटर विज्ञान में मास्टर कर रही हूँ, जिसमें मेरा विशेषज्ञता क्षेत्र मशीन लर्निंग है।
आधुनिक AI वर्कफ़्लो अक्सर क्लाउड API पर निर्भर रहते हैं। लेकिन अगर आप ऐसा सिस्टम चाहते हैं जो पूरी तरह आपकी मशीन पर चले, डेटा निजी रखे, और फिर भी मल्टी-स्टेप एजेंट वर्कफ़्लो सपोर्ट करे तो?
इस ट्यूटोरियल में, आप एक लोकल-फ़र्स्ट AI एक्ज़ीक्यूशन ऐप बनाएंगे जिसमें:
यह पैटर्न निजी एनालिटिक्स, आंतरिक टूल्स और ऐसे किसी भी वर्कफ़्लो के लिए विशेष रूप से मूल्यवान है जहाँ डेटा को डिवाइस पर ही रहना चाहिए। यदि आपके डेटा में संवेदनशील वित्तीय रिपोर्ट, कानूनी दस्तावेज़, या ग्राहक रिकॉर्ड शामिल हैं, तो क्लाउड AI समाधान स्वीकार्य नहीं हो सकते।
यह सेटअप वही बुद्धिमान, मल्टी-स्टेप व्यवहार प्रदान करता है, जबकि सभी डेटा और प्रोसेसिंग को आपके लोकल नियंत्रण में रखता है।
OpenClaw के चैनल इंटीग्रेशन के साथ, यही लोकल सिस्टम WhatsApp या Slack जैसे इंटरफ़ेस तक भी विस्तारित किया जा सकता है, जिससे आपको परिचित वातावरण से अपने वर्कफ़्लो तक सुरक्षित पहुँच मिलती है।