

课程
使用 Python 中的 statsmodels 进行回归入门
4 小时
63.4K
实践并学习路径你的进步。
使用 Google 继续在分析涉及事件计数的数据时——例如每天的客户投诉数量、每月的住院人数、或每小时的网站点击量——普通线性回归往往会产生误导性的结果。计数数据具有独特特征,需要专门的建模方法。
泊松回归为计数数据提供了一种专门的统计方法。不同于可能预测出负值的线性回归,泊松回归确保预测保持为非负整数。这使其在以事件计数为决策核心的任何领域都尤为有价值。
如果您是回归分析新手,我们的R 语言回归入门课程将提供本教程所需的基础概念。若您已准备好探索更广泛的回归技术家族,R 中的广义线性模型课程将全面讲解包含泊松回归在内的统计框架。
计数数据表示某事在固定时间或空间内发生的次数。示例包括每份保单每年提交的保险理赔次数,或某个路口每月发生的交通事故数。
计数数据具有一些显著特性,使得普通线性回归并不合适:
考虑基于产品复杂度和客户满意度评分来预测客户投诉数量。线性回归会将其视为连续结果,可能预测出如 -1.5 次或 14.7 次这样的不可能值。
更棘手的是,线性回归假设在所有预测水平上的方差恒定。事实上,在预测投诉数较高的周,变异性很可能比预测数较低的周更大。这种模式称为异方差性,会导致置信区间和假设检验不可靠。
泊松回归构建于泊松概率分布之上,它天然适用于描述计数数据。泊松分布只有一个参数(lambda),同时表示计数的均值和方差。均值与方差相等的性质(等散性)是我们在实践中需要验证的关键假设。
该分布擅长建模“稀有”事件——并非一定发生少见,而是指各次发生彼此独立,且在相似条件下发生率相对稳定的事件。
首先,让我们讨论泊松回归表现良好的理想条件。随后,再谈真实世界的应用。
当您的数据满足以下条件时,泊松回归效果最佳:
在医疗与流行病学中,研究者会在不同地区或时间段内跟踪疾病病例,并按人口规模进行调整。例如,他们可能研究疫苗接种率如何影响每 10 万人的感染数。
在商业与市场营销中,团队会分析客户行为,如购买频率、客服工单或参与度。电商公司常基于营销投入、季节性与促销活动来建模每日订单量。
还有一个泊松回归中常见的示例:制造团队按批量或检验周期监测缺陷率,以便及早发现质量问题并改进流程。
泊松回归并非直接建模计数,而是将期望计数的对数表示为预测变量的线性组合。
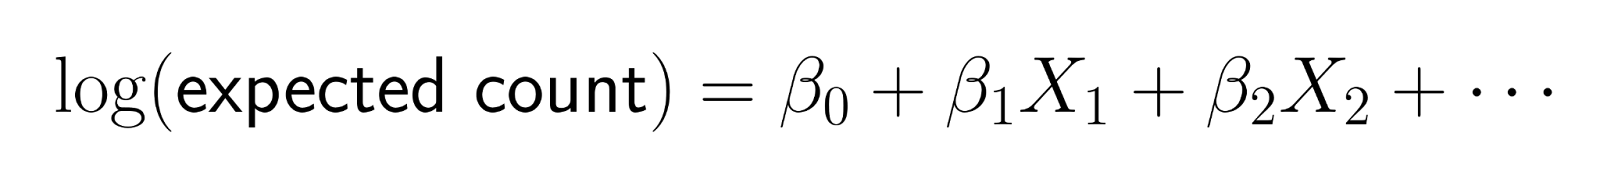
这种对数变换确保预测保持为正。具体而言,对数链接函数将期望计数变换到对数刻度,确保对均值计数的模型预测严格为正。反变换(取指数)后得到:
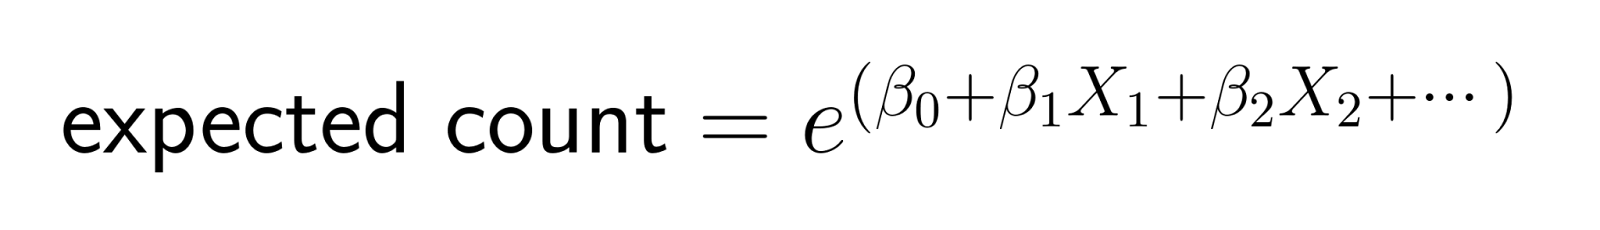
这种结构意味着预测变量的变化对期望计数产生乘法效应。
在线性回归中,预测变量增加一个单位会给结果加上一个常数;在泊松回归中,预测变量增加一个单位会将期望计数乘以一个常数因子。
例如,若“营销投入”的系数为 0.1,则每增加 1 美元的营销投入,会将期望客户数量乘以 e^0.1 ≈ 1.105,约等于 10.5% 的提升。
尽管看起来更复杂,但这种特性对商业应用往往更直观,因为我们常以百分比变化和相对效应来思考。
与任何模型一样,有些假设需要我们关注:
许多计数数据集涉及不同的暴露水平——时间段、人口规模或观测强度各不相同。例如,比较城市间事故数量需要考虑人口差异,而比较月度销售额则需注意不同月份天数不同。
暴露变量代表使计数可比的“分母”。若未进行适当调整,大城市理所当然会有更多事故,天数更长的月份销售额更高,从而可能掩盖您真正想研究的关系。
偏置项提供了一种将暴露变量以系数固定为 1 的方式纳入模型。偏置项让您在保持计数数据结构的同时,建模的是比率而非原始计数。
其数学形式为:
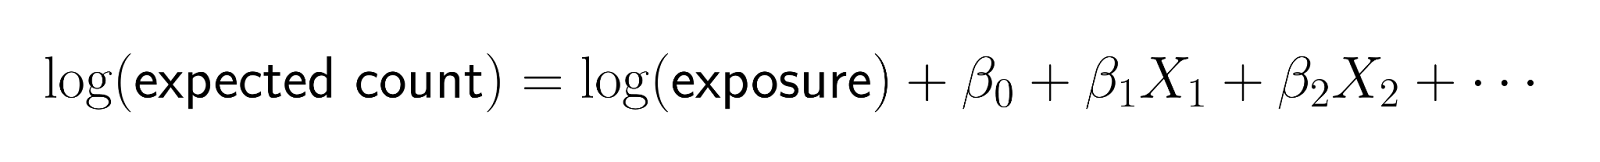
重排该等式:
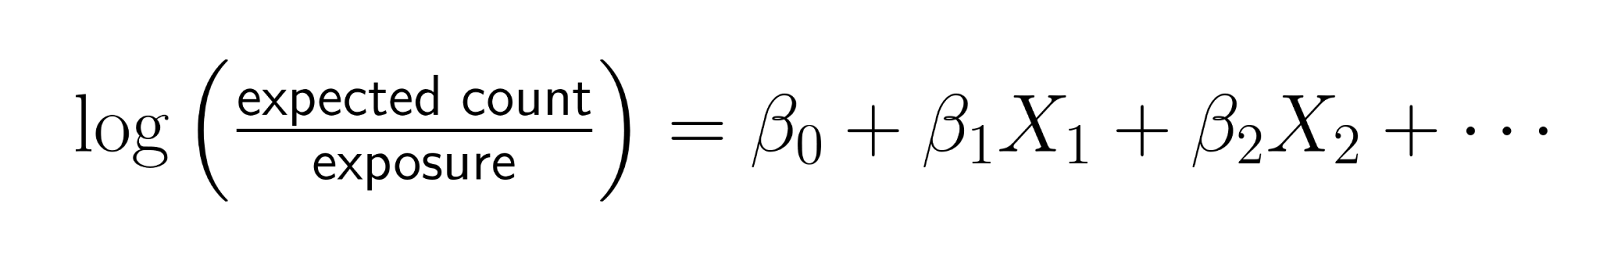
这表明您实际上在建模对数比率,其中比率 = 计数/暴露量。
偏置项确保当暴露量加倍时,期望计数也加倍(其他条件不变),这正是基于比率现象的自然关系。
原始的泊松回归系数表示对数计数的变化,不易直接解读。对系数取指数可将其转化为发生率比(IRR),更直观易懂。
IRR 表示当预测变量增加一个单位时,期望计数的乘法性变化:
IRR 的置信区间为您的比率估计提供不确定性范围。IRR 为 1.25,95% 置信区间为 [1.10, 1.42],表示您有充分把握认为真实效应介于发生率增加 10% 与 42% 之间。
若置信区间包含 1.0,则该效应可能不具统计显著性。例如,IRR 为 1.15 且 CI 为 [0.95, 1.39],暗示该预测变量可能没有影响。
向非技术受众呈现结果时,聚焦于百分比变化而非比率本身。与其说“IRR 为 1.3”,不如说“该因素与事件发生率提高约 30% 相关”。
给出具体示例:“基于我们的模型,营销投入增加 1000 美元,大约与客户获客增加 15% 相关,从平均每月 20 人提升到约 23 人。”
既然已经理解了结果解读的细节,接下来我们在 R 中实现。
在拟合任何模型之前,请认真检查您的计数数据。首先加载必要的库并探索分布:
library(ggplot2)
library(dplyr)

# Example: Website daily visitor counts
data <- data.frame(
  visitors = c(42, 48, 39, 52, 44, 58, 51, 47, 41, 49, 40, 46, 43, 54, 50),
  day_of_week = factor(c("Mon", "Tue", "Wed", "Thu", "Fri", "Sat", "Sun",
                        "Mon", "Tue", "Wed", "Thu", "Fri", "Sat", "Sun", "Mon")),
  marketing_spend = c(200, 150, 180, 250, 220, 400, 350, 300, 160, 190,
                     140, 210, 380, 420, 170),
  temperature = c(22, 25, 19, 24, 26, 28, 30, 27, 21, 23, 18, 25, 29, 31, 20)
)

# Check mean vs variance (should be similar for Poisson)
mean(data$visitors)
var(data$visitors)
var(data$visitors) / mean(data$visitors) # Should be close to 1

# Visualize the distribution
ggplot(data, aes(x = visitors)) +
  geom_histogram(bins = 8, fill = "lightblue", color = "black") +
  labs(title = "Distribution of Daily Visitors",
       x = "Number of Visitors", y = "Frequency")
> mean(data$visitors)
[1] 46.93333
> var(data$visitors)
[1] 30.35238
> var(data$visitors) / mean(data$visitors)
[1] 0.6467127方差与均值之比为 0.65,与 1 相当接近,说明我们的数据很适合使用泊松回归。尽管不完全相等,但一般 0.5 到 1.5 的比值可接受,提示泊松分布为建模此类计数数据提供了良好基础。
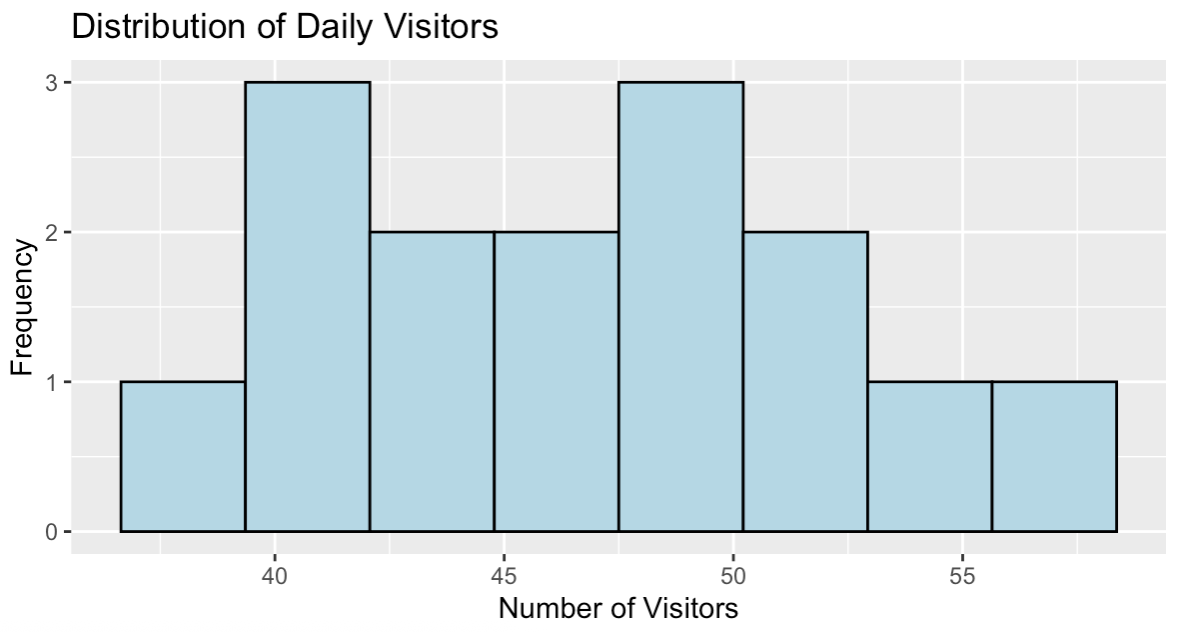
网站每日访客分布。图片作者自制。
该直方图显示访客数大致对称地分布在每日约 47 人附近,范围约为 39 至 58。这种分布模式与可通过泊松回归有效建模的计数数据一致。
glm() 函数配合 family = poisson 可拟合泊松回归模型:
# Basic Poisson regression
model <- glm(visitors ~ day_of_week + marketing_spend + temperature,
             family = poisson, data = data)

# View key model results
summary(model)

# Calculate Incidence Rate Ratios (IRRs)
exp(coefficients(model))
以下为系数表:
Coefficients:
                 Estimate Std. Error z value Pr(>|z|)
(Intercept)     3.2978122  0.5556601   5.935 2.94e-09 ***
day_of_weekMon  0.0724036  0.1635467   0.443    0.658
day_of_weekSat  0.0316265  0.2872878   0.110    0.912
day_of_weekSun  0.0339621  0.2502578   0.136    0.892
day_of_weekThu  0.1068756  0.1870821   0.571    0.568
day_of_weekTue  0.0442967  0.1633032   0.271    0.786
day_of_weekWed  0.0653789  0.1813230   0.361    0.718
marketing_spend 0.0001593  0.0018211   0.087    0.930
temperature     0.0186099  0.0317682   0.586    0.558
以下为发生率比(IRR):
(Intercept)  day_of_weekMon  day_of_weekSat  day_of_weekSun  day_of_weekThu  day_of_weekTue  day_of_weekWed marketing_spend
27.053386        1.075089        1.032132        1.034545        1.112796        1.045292        1.067563        1.000159
temperature
1.018784
系数显示的是对数尺度上的效应,但 IRR 更直观。例如,星期四(day_of_weekThu)的 IRR 为 1.11,表明相比参考类别星期五,访客多约 11%。营销投入的 IRR 为 1.0002,表示每增加 1 美元,预期访客增加约 0.02%。
请注意,如果我们计算这些 IRR 的置信区间,许多将包含 1.0,表明在这个小样本下效应并不显著。这在小数据集中很常见,也说明样本量的重要性。
如果数据具有不同的暴露时长,可将其作为偏置项加入:
# Example with exposure data
data$exposure_days <- c(rep(7, 10), rep(6, 5))  # Some weeks had 6 observation days

# Model with offset
model_offset <- glm(visitors ~ day_of_week + marketing_spend + temperature +
                   offset(log(exposure_days)),
                   family = poisson, data = data)

summary(model_offset)
Call:
glm(formula = visitors ~ day_of_week + marketing_spend + temperature +
offset(log(exposure_days)), family = poisson, data = data)
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) 1.734e+00 5.579e-01 3.109 0.00188 **
day_of_weekMon 2.371e-02 1.637e-01 0.145 0.88485
day_of_weekSat 9.873e-02 2.898e-01 0.341 0.73338
day_of_weekSun 1.208e-01 2.472e-01 0.489 0.62513
day_of_weekThu 5.642e-02 1.871e-01 0.302 0.76297
day_of_weekTue -6.713e-02 1.634e-01 -0.411 0.68128
day_of_weekWed -6.073e-02 1.825e-01 -0.333 0.73934
marketing_spend -4.231e-05 1.823e-03 -0.023 0.98149
temperature 8.210e-03 3.179e-02 0.258 0.79623加入偏置项后,系数会明显变化。截距从 3.30 降至 1.73,其他效应也变小。这是因为我们现在建模的是“每天的比率”,而不是在不同时长上的总计数。
偏置项通过调整不同的暴露时长来确保公平比较。若无此调整,观测天数更多的时段会虚高,从而可能掩盖真正的关系。模型现在回答的是“每日访客率是多少?”而非“总访客数是多少?”
为新情景生成预测:
# Create new data for prediction
new_data <- data.frame(
  day_of_week = factor("Fri", levels = levels(data$day_of_week)),
  marketing_spend = 300,
  temperature = 25
)

# Predict expected counts
predicted_counts <- predict(model, newdata = new_data, type = "response")
print(paste("Expected visitors:", round(predicted_counts, 1)))
[1] "Expected visitors: 45.2"该模型在周五、营销投入 300 美元且气温 25℃ 的情境下预测 45.2 名访客。此预测落在观测数据的合理范围(39–58)内,且接近整体均值 46.9。
与线性回归可能产生不可能的负值不同,泊松回归在四舍五入后自然确保预测为非负整数。type = "response" 参数返回的是原始计数尺度上的预测,而非模型内部使用的对数尺度。
当方差超过均值时,会出现过度离散,违背泊松的关键假设:
# Calculate dispersion statistic
residual_deviance <- model$deviance
df_residual <- model$df.residual
dispersion <- residual_deviance / df_residual

print(paste("Dispersion statistic:", round(dispersion, 3)))

if (dispersion > 1.5) {
  print("Possible overdispersion detected")
  print("Consider quasi-Poisson or negative binomial models")
}
[1] "Dispersion statistic: 0.849"离散统计量为 0.849,接近 1,说明模型拟合良好,不存在显著过度离散。值接近 1 表明该数据集满足泊松“均值等于方差”的假设是合理的。
由于该统计量低于 1.5,因此不会出现警告信息,确认标准泊松回归是合适的。若该值远大于 1(通常高于 1.5),则需要考虑准泊松或负二项模型来处理额外变异。
检查残差以发现模式或模型违背之处:
# Calculate Pearson residuals
fitted_values <- fitted(model)
pearson_residuals <- residuals(model, type = "pearson")

# Plot residuals vs fitted values
plot(fitted_values, pearson_residuals,
     xlab = "Fitted Values", ylab = "Pearson Residuals",
     main = "Residuals vs Fitted")
abline(h = 0, col = "red", lty = 2)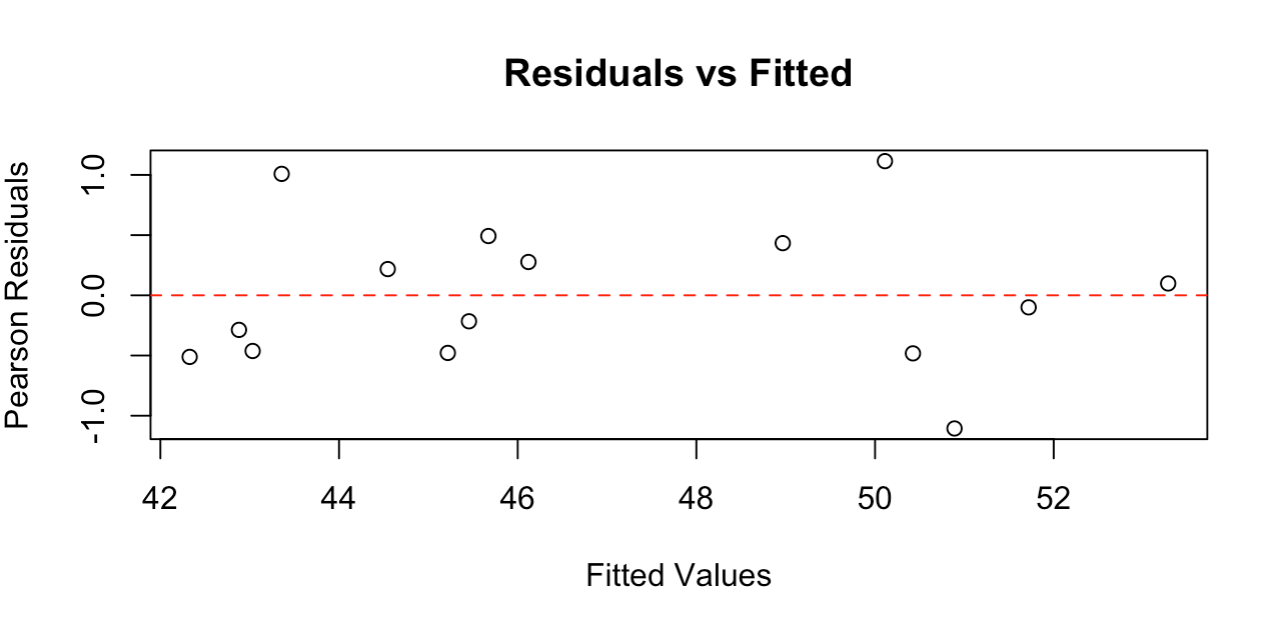
残差图显示围绕 0 的随机散点。 图片作者自制。
残差图中数据点围绕零线随机分布、无明显模式,表明模型拟合良好。残差大致在 -1 到 +1 之间波动,对该样本量而言合理。
好的残差图应具备:围绕零的随机散布(无曲线模式)、在拟合值范围内方差大致稳定(无喇叭口形状)、且无极端离群点。该图满足这些标准,说明泊松回归假设得到满足,我们的模型结果可靠。
若检测到过度离散,可考虑调整标准误的准泊松模型:
# Fit quasi-Poisson model
quasi_model <- glm(visitors ~ day_of_week + marketing_spend + temperature,
                   family = quasipoisson, data = data)
由于我们的模型离散度良好(0.849),此处无需准泊松调整。但当方差超过均值时,此方法能提供更保守的置信区间与 p 值,对于现实世界中常见的过度离散计数数据非常有用。
将模型输出转化为与业务相关的洞见,聚焦于 IRR 的实际含义。若模型显示周末相较工作日的 IRR 为 1.4,可表述为“周末访客约多 40%”。若营销投入的 IRR 为 1.002,可说明“每增加 1 美元营销投入,访客约增加 0.2%”。
对于连续变量,考虑用更有意义的区间来呈现效应。与其讨论气温上升 1 度的影响,不如展示 10 度差异的影响,这对业务规划更具参考价值。
泊松回归识别的是相关性,而非因果关系。即使营销投入与访客数量存在强相关,也不能证明营销导致了增长。其他因素可能共同影响二者。呈现结果时请承认这一点。
该模型假设在给定预测变量取值时,发生率保持恒定。若您的业务存在未纳入变量的季节性趋势,或预测变量与结果之间的关系随时间变化,模型对未来时期的外推可能不佳。
计数数据常包含零,这在泊松回归中完全合理。然而,若零值远多于泊松分布的预期,可能表明数据生成过程不同。某些观测可能代表事件根本不可能发生的时期或条件,而非可能发生但恰好未发生的时期。
例如,网站访客计数在网站维护停机的日子可能出现零。这些“结构性零”不同于泊松过程中自然出现的“随机零”。
从基于领域知识的最重要预测变量入手。逐个添加变量并评估其是否增强了您对数据的理解。更复杂的模型并不总是更好。
关注效应的实际意义,而不仅仅是统计显著性。统计上显著的 1% 变化可能不足以驱动业务行动,而 20% 的变化即便边际上不显著,也可能值得通过更多数据进一步研究。
当等散性不成立(方差远大于均值)时,准泊松回归提供了简单解决方案。它保持相同的模型结构,但调整标准误以反映额外变异,从而得到更保守的置信区间和 p 值。
对于严重的过度离散,负二项回归会显式建模额外变异,同时估计均值关系与附加变异。
不要忽视过度离散——这是最常见的泊松假设违背之一,会严重影响结论。始终检查方差与均值之比,并在必要时考虑替代方法。
谨慎外推超出数据范围的结论。若营销投入数据范围为 100 至 1000 美元,请勿自信地预测 5000 美元时的效应。极端值下关系可能不再保持对数线性。
避免将所有类别型预测变量视为等间距。教育水平(高中、部分大学、大学毕业)对结果变量的影响可能并不等距。
记录您的建模决策,尤其是对假设违背的处理方式。若发现过度离散并选择了准泊松调整,请记录该决定及其对解读的影响。
泊松回归为多个领域的计数数据分析提供了有效框架。在将这些技术应用于您的数据时,从简单模型出发,并基于统计证据与领域知识逐步增加复杂度。当假设被违背时,诸如准泊松或负二项模型等扩展是很好的替代方案。目标不仅是统计显著性,更是能指导更佳决策的务实洞见。
如果您希望深化回归方面的能力,我们的R 语言中级回归课程涵盖高级诊断技术与建模策略,可与您在此掌握的泊松回归技能形成互补。R 中的广义线性模型也是不错的选择。
与 DataCamp 一起学习
课程
课程
实践并学习路径你的进步。
使用 Google 继续