

कोर्स
Python में statsmodels के साथ Regression परिचय
4 घंटा
63.4K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंजब ऐसे डेटा का विश्लेषण करते हैं जिसमें घटनाओं की गिनती शामिल होती है—जैसे प्रति दिन ग्राहक शिकायतों की संख्या, प्रति माह अस्पताल में भर्ती, या प्रति घंटे वेबसाइट क्लिक—तो साधारण रैखिक रिग्रेशन अक्सर भ्रामक परिणाम देता है। काउंट डेटा की कुछ विशिष्ट विशेषताएँ होती हैं, जिनके कारण इसके लिए विशेष मॉडलिंग दृष्टिकोण आवश्यक होते हैं।
पॉइसन रिग्रेशन काउंट डेटा के लिए विशेष रूप से डिजाइन की गई एक सांख्यिकीय विधि प्रदान करता है। रैखिक रिग्रेशन के विपरीत, जो नकारात्मक मान भी भविष्यवाणी कर सकता है, पॉइसन रिग्रेशन यह सुनिश्चित करता है कि भविष्यवाणियाँ गैर-नकारात्मक पूर्णांक ही रहें। यह इसे उन सभी क्षेत्रों में विशेष रूप से उपयोगी बनाता है, जहाँ घटनाओं की गिनती निर्णय-निर्धारण के केंद्र में होती है।
यदि आप रिग्रेशन विश्लेषण में नए हैं, तो हमारा Introduction to Regression in R पाठ्यक्रम इस ट्यूटोरियल के लिए आवश्यक बुनियादी अवधारणाएँ प्रदान करता है। जो लोग रिग्रेशन तकनीकों के व्यापक परिवार को तलाशने के लिए तैयार हैं, उनके लिए Generalized Linear Models in R उस सांख्यिकीय ढाँचे का समग्र कवरेज देता है, जिसमें पॉइसन रिग्रेशन भी शामिल है।
काउंट डेटा किसी निश्चित अवधि या स्थान के भीतर किसी घटना के घटित होने की संख्या का प्रतिनिधित्व करता है। उदाहरण के लिए, प्रति पॉलिसी प्रति वर्ष दाखिल किए गए बीमा दावों की संख्या या किसी चौराहे पर प्रति माह होने वाली दुर्घटनाओं की संख्या।
काउंट डेटा की कई विशिष्ट विशेषताएँ होती हैं, जिनके कारण साधारण रैखिक रिग्रेशन उपयुक्त नहीं होता:
मान लीजिए कि आप उत्पाद जटिलता और ग्राहक संतुष्टि स्कोर जैसे कारकों के आधार पर ग्राहक शिकायतों की संख्या की भविष्यवाणी कर रहे हैं। रैखिक रिग्रेशन इसे किसी सतत परिणाम की तरह मानता है और -1.5 शिकायतें या 14.7 शिकायतें जैसे असंभव मान भी भविष्यवाणी कर सकता है।
और भी समस्या यह है कि रैखिक रिग्रेशन सभी पूर्वानुमान स्तरों पर स्थिर विचरण मानता है। वास्तविकता में, जिन हफ्तों में अनुमानित शिकायतें अधिक होंगी, वे कम अनुमानित गिनतियों वाले हफ्तों की तुलना में अधिक परिवर्तनशीलता दिखाएँगे। यह पैटर्नn, जिसे हेटेरोस्केडैस्टीसिटी कहते हैं, अविश्वसनीय कॉन्फिडेंस इंटरवल और परिकल्पना परीक्षणों की ओर ले जाता है।
पॉइसन रिग्रेशन पॉइसन प्रायिकता वितरण पर आधारित है, जो स्वाभाविक रूप से काउंट डेटा का वर्णन करता है। पॉइसन वितरण में एक ही पैरामीटर (लैम्ब्डा) होता है, जो माध्य और
गिनतियों के विचरण, दोनों का प्रतिनिधित्व करता है। माध्य-विचरण की यह समानता, जिसे इक्विडिस्पर्शन कहते हैं, एक प्रमुख धारणा है जिसे हमें व्यवहार में सत्यापित करना होगा।
यह वितरण “दुर्लभ” घटनाओं के मॉडलिंग में उत्कृष्ट है—जरूरी नहीं कि वे बहुत कम घटित हों, बल्कि ऐसी घटनाएँ, जिनकी प्रत्येक व्यक्तिगत घटना स्वतंत्र हो और समान परिस्थितियों में दर अपेक्षाकृत स्थिर रहे।
सबसे पहले, उन आदर्श परिस्थितियों की बात करते हैं जिनमें पॉइसन रिग्रेशन अच्छा प्रदर्शन करता है। उसके बाद वास्तविक अनुप्रयोगों पर आएँगे।
पॉइसन रिग्रेशन तब सबसे अच्छा काम करता है जब आपका डेटा इन शर्तों को पूरा करता है:
स्वास्थ्य सेवा और महामारी विज्ञान में, शोधकर्ता समय या क्षेत्रों में रोग मामलों को, जनसंख्या के अनुसार समायोजित करके, ट्रैक करते हैं। उदाहरण के लिए, वे अध्ययन कर सकते हैं कि टीकाकरण दरें प्रति 100,000 लोगों पर संक्रमणों को कैसे प्रभावित करती हैं।
व्यवसाय और विपणन में टीमें क्रय आवृत्ति, सपोर्ट टिकट या एंगेजमेंट जैसे ग्राहक व्यवहार की जाँच करती हैं। ई-कॉमर्स कंपनियाँ अक्सर दैनिक ऑर्डर को मार्केटिंग खर्च, मौसमी प्रभाव और प्रमोशनों के आधार पर मॉडल करती हैं।
या पॉइसन रिग्रेशन के साथ अक्सर दिया जाने वाला एक सामान्य उदाहरण यह है: मैन्युफैक्चरिंग टीमें गुणवत्ता समस्याओं को जल्दी पकड़ने और प्रक्रियाएँ सुधारने के लिए बैच आकार या निरीक्षण अवधि के अनुसार दोष दर की निगरानी करती हैं।
पॉइसन रिग्रेशन सीधे गिनतियों को मॉडल नहीं करता। इसके बजाय, यह अपेक्षित गिनती के लघुगणक (लॉग) को पूर्वानुमानकर्ताओं के रैखिक संयोजन के रूप में मॉडल करता है।
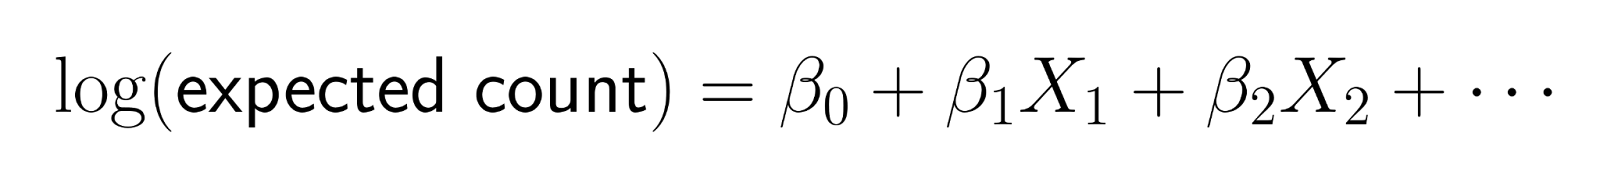
यह लघुगणकीय रूपांतरण यह सुनिश्चित करता है कि भविष्यवाणियाँ सकारात्मक रहें। विशेष रूप से, लॉग-लिंक फंक्शन अपेक्षित गिनती को लॉग स्केल पर रूपांतरित करता है, जिससे माध्य गिनती के लिए मॉडल की भविष्यवाणियाँ सख्ती से सकारात्मक रहें। जब हम रूपांतरण को उल्टा करते हैं (घातांकीकरण द्वारा), तो हमें मिलता है:
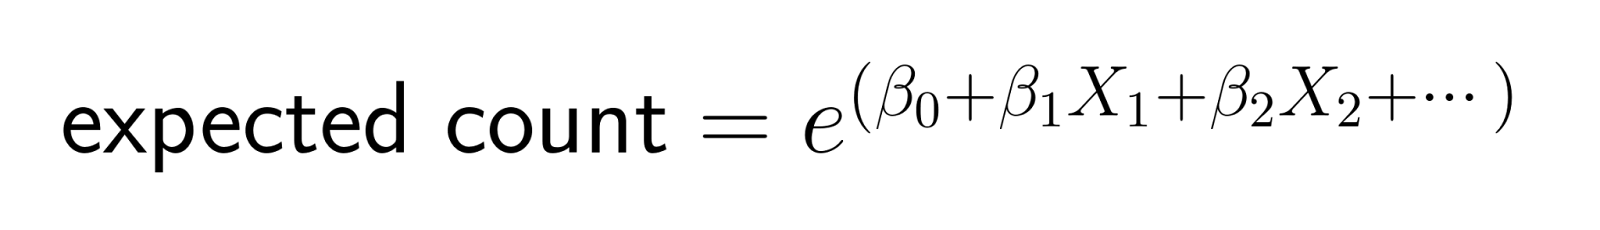
इस संरचना का अर्थ है कि पूर्वानुमानकर्ताओं में परिवर्तन अपेक्षित गिनती पर गुणात्मक (multiplicative) प्रभाव डालते हैं।
रैखिक रिग्रेशन में, किसी पूर्वानुमानकर्ता में एक इकाई की वृद्धि परिणाम में एक स्थिर मात्रा जोड़ती है। पॉइसन रिग्रेशन में, किसी पूर्वानुमानकर्ता में एक इकाई की वृद्धि अपेक्षित गिनती को एक स्थिर गुणांक से गुणा करती है।
उदाहरण के लिए, यदि "मार्केटिंग खर्च" का गुणांक 0.1 है, तो मार्केटिंग खर्च के प्रत्येक अतिरिक्त डॉलर से अपेक्षित ग्राहकों की संख्या e^0.1 ≈ 1.105 गुना हो जाती है, जो लगभग 10.5% वृद्धि दर्शाता है।
भले ही यह अधिक जटिल लगे, यह विशेषता व्यावसायिक अनुप्रयोगों के लिए सहज हो सकती है, जहाँ हम अक्सर प्रतिशत बदलाव और सापेक्ष प्रभावों में सोचते हैं।
किसी भी मॉडल की तरह, कुछ धारणाएँ हैं जिन पर ध्यान देना आवश्यक है:
कई काउंट डेटासेट में अलग-अलग एक्सपोज़र स्तर होते हैं—समय-सीमा, जनसंख्या आकार, या अवलोकन तीव्रता में भिन्नता। उदाहरण के लिए, शहरों के बीच दुर्घटना गिनतियों की तुलना करते समय जनसंख्या भिन्नताओं का हिसाब रखना आवश्यक है, या मासिक बिक्री की तुलना करते समय यह नोट करना कि कुछ महीनों में दिनों की संख्या अलग होती है।
एक्सपोज़र चर वह “हर” (denominator) दर्शाते हैं जो गिनतियों को तुलनीय बनाता है। उचित समायोजन के बिना, बड़े शहरों में स्वाभाविक रूप से अधिक दुर्घटनाएँ दिखेंगी, और लंबे महीनों में अधिक बिक्री, जिससे वे वास्तविक संबंध छिप सकते हैं जिन्हें आप अध्ययन करना चाहते हैं।
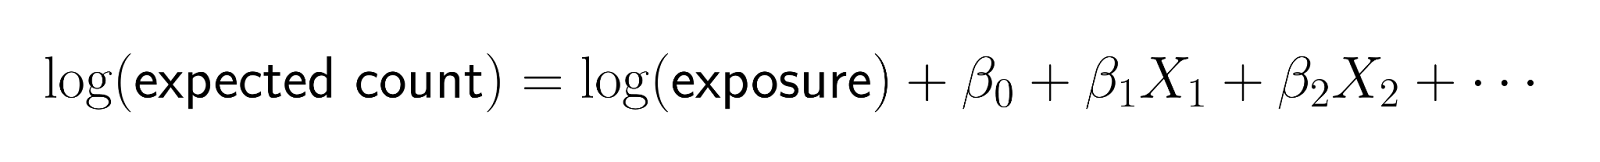
ऑफ़सेट ऐसे एक्सपोज़र चर को शामिल करने का तरीका प्रदान करते हैं, जिनका गुणांक 1 पर नियत होता है। कच्ची गिनतियों को मॉडल करने के बजाय, ऑफ़सेट आपको दरों (rates) को मॉडल करने देते हैं, जबकि आपके डेटा की काउंट संरचना बनी रहती है।
गणितीय रूप बनता है:
इस समीकरण को पुनर्व्यवस्थित करने पर:
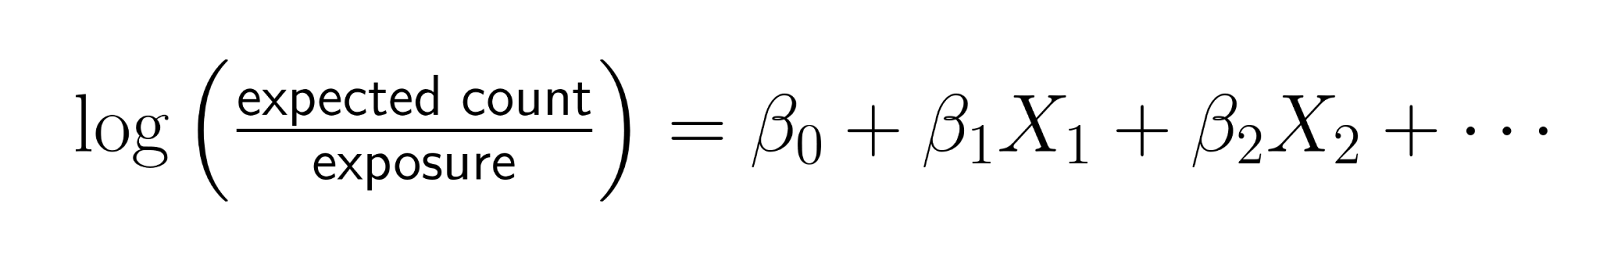
यह दर्शाता है कि आप प्रभावी रूप से लॉग-रेट को मॉडल कर रहे हैं, जहाँ rate = count/exposure।
ऑफ़सेट यह सुनिश्चित करता है कि एक्सपोज़र दोगुना होने पर अपेक्षित गिनती भी दोगुनी हो (अन्य सभी समान रहने पर), जो दर-आधारित घटनाओं के लिए स्वाभाविक संबंध है।
कच्चे पॉइसन रिग्रेशन गुणांक लॉग-गिनती में बदलाव का प्रतिनिधित्व करते हैं, जिनकी सीधे व्याख्या करना कठिन हो सकता है। गुणांकों का घातांकीकरण उन्हें इन्सिडेन्स रेट रेशियो (IRR) में बदल देता है, जिनकी व्याख्या सहज होती है।
IRR किसी पूर्वानुमानकर्ता में एक इकाई वृद्धि पर अपेक्षित गिनती में गुणात्मक परिवर्तन दर्शाता है:
IRR के कॉन्फिडेंस इंटरवल आपकी दर-अनुपातों के आसपास अनिश्चितता का अनुमान देते हैं। 1.25 का IRR और 95% कॉन्फिडेंस इंटरवल [1.10, 1.42] यह सुझाता है कि वास्तविक प्रभाव दर में 10% से 42% वृद्धि के बीच है—इस पर आप उचित भरोसा कर सकते हैं।
यदि कोई कॉन्फिडेंस इंटरवल 1.0 को शामिल करता है, तो प्रभाव सांख्यिकीय रूप से महत्त्वपूर्ण न भी हो सकता है। उदाहरण के लिए, 1.15 का IRR और CI [0.95, 1.39] यह संकेत देता है कि पूर्वानुमानकर्ता का प्रभाव शून्य भी हो सकता है।
गैर-तकनीकी दर्शकों को परिणाम प्रस्तुत करते समय, अनुपातों के बजाय प्रतिशत बदलाव पर ध्यान दें। "IRR 1.3 है" कहने के बजाय कहें, "यह कारक घटना की दर में लगभग 30% वृद्धि से जुड़ा है।"
ठोस उदाहरण दें: "हमारे मॉडल के आधार पर, मार्केटिंग खर्च में $1000 की वृद्धि से ग्राहक अधिग्रहण में लगभग 15% की बढ़ोतरी जुड़ी है—औसतन 20 से बढ़कर प्रति माह लगभग 23 ग्राहक।"
अब जब हम व्याख्या का विवरण देख चुके हैं, तो इसे R में लागू करते हैं।
किसी भी मॉडल को फिट करने से पहले, अपने काउंट डेटा की सावधानी से जाँच करें। आवश्यक लाइब्रेरी लोड करने और वितरण की खोज से शुरू करें:
library(ggplot2)
library(dplyr)

# Example: Website daily visitor counts
data <- data.frame(
  visitors = c(42, 48, 39, 52, 44, 58, 51, 47, 41, 49, 40, 46, 43, 54, 50),
  day_of_week = factor(c("Mon", "Tue", "Wed", "Thu", "Fri", "Sat", "Sun",
                        "Mon", "Tue", "Wed", "Thu", "Fri", "Sat", "Sun", "Mon")),
  marketing_spend = c(200, 150, 180, 250, 220, 400, 350, 300, 160, 190,
                     140, 210, 380, 420, 170),
  temperature = c(22, 25, 19, 24, 26, 28, 30, 27, 21, 23, 18, 25, 29, 31, 20)
)

# Check mean vs variance (should be similar for Poisson)
mean(data$visitors)
var(data$visitors)
var(data$visitors) / mean(data$visitors) # Should be close to 1

# Visualize the distribution
ggplot(data, aes(x = visitors)) +
  geom_histogram(bins = 8, fill = "lightblue", color = "black") +
  labs(title = "Distribution of Daily Visitors",
       x = "Number of Visitors", y = "Frequency")
> mean(data$visitors)
[1] 46.93333
> var(data$visitors)
[1] 30.35238
> var(data$visitors) / mean(data$visitors)
[1] 0.64671270.65 का विचरण-से-माध्य अनुपात 1 के काफी निकट है, जो दर्शाता है कि हमारा डेटा पॉइसन रिग्रेशन के लिए उपयुक्त है। भले ही यह बिल्कुल बराबर न हो, 0.5 से 1.5 के बीच के अनुपात सामान्यतः स्वीकार्य माने जाते हैं और संकेत देते हैं कि यह काउंट डेटा मॉडलिंग के लिए पॉइसन वितरण एक अच्छा आधार प्रदान करता है।
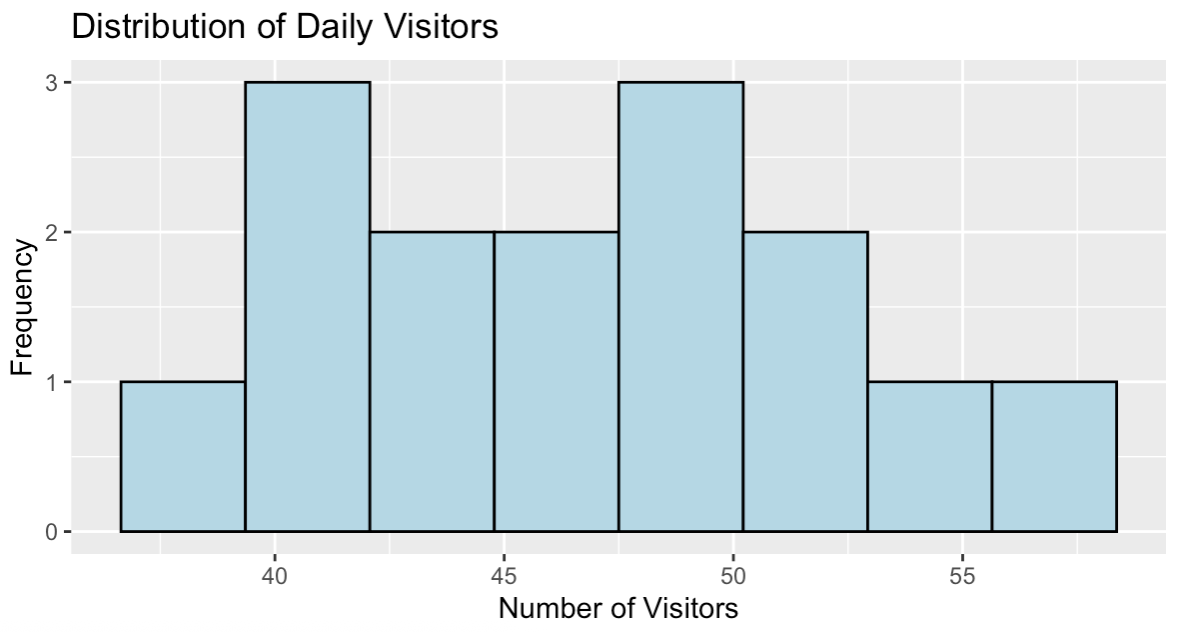
दैनिक वेबसाइट आगंतुकों का वितरण। चित्र: लेखक।
हिस्टोग्राम लगभग 47 आगंतुक प्रति दिन के आसपास केंद्रित एक मोटे तौर पर सममित वितरण दिखाता है, जिसकी मान सीमा लगभग 39 से 58 तक है। यह पैटर्न ऐसे काउंट डेटा के अनुरूप है जिसे पॉइसन रिग्रेशन का उपयोग कर प्रभावी रूप से मॉडल किया जा सकता है।
glm() फंक्शन को family = poisson के साथ उपयोग करने पर पॉइसन रिग्रेशन मॉडल फिट होते हैं:
# Basic Poisson regression
model <- glm(visitors ~ day_of_week + marketing_spend + temperature,
             family = poisson, data = data)

# View key model results
summary(model)

# Calculate Incidence Rate Ratios (IRRs)
exp(coefficients(model))
यह रहा गुणांकों का सारणी:
Coefficients:
                 Estimate Std. Error z value Pr(>|z|)
(Intercept)     3.2978122  0.5556601   5.935 2.94e-09 ***
day_of_weekMon  0.0724036  0.1635467   0.443    0.658
day_of_weekSat  0.0316265  0.2872878   0.110    0.912
day_of_weekSun  0.0339621  0.2502578   0.136    0.892
day_of_weekThu  0.1068756  0.1870821   0.571    0.568
day_of_weekTue  0.0442967  0.1633032   0.271    0.786
day_of_weekWed  0.0653789  0.1813230   0.361    0.718
marketing_spend 0.0001593  0.0018211   0.087    0.930
temperature     0.0186099  0.0317682   0.586    0.558
यह रहे इन्सिडेन्स रेट रेशियो (IRR):
(Intercept)  day_of_weekMon  day_of_weekSat  day_of_weekSun  day_of_weekThu  day_of_weekTue  day_of_weekWed marketing_spend
27.053386        1.075089        1.032132        1.034545        1.112796        1.045292        1.067563        1.000159
temperature
1.018784
गुणांक लॉग-स्केल प्रभाव दिखाते हैं, पर IRR अधिक सहज व्याख्या देते हैं। उदाहरण के लिए, गुरुवार (day_of_weekThu) का IRR 1.11 है, जो शुक्रवार (संदर्भ श्रेणी) की तुलना में लगभग 11% अधिक आगंतुकों का संकेत देता है। मार्केटिंग खर्च का IRR 1.0002 है, जो दिखाता है कि प्रत्येक अतिरिक्त डॉलर अपेक्षित आगंतुकों में लगभग 0.02% की वृद्धि करता है।
ध्यान दें कि यदि हम इन IRR के लिए कॉन्फिडेंस इंटरवल निकालें, तो कई में 1.0 शामिल होगा, जो इस छोटे नमूने के साथ प्रभावों के सांख्यिकीय रूप से महत्त्वपूर्ण न होने का संकेत देता है। यह छोटे डेटासेट में आम है और बताता है कि नमूना आकार क्यों मायने रखता है।
यदि आपके डेटा में एक्सपोज़र अवधियाँ अलग-अलग हैं, तो उन्हें ऑफ़सेट के रूप में शामिल करें:
# Example with exposure data
data$exposure_days <- c(rep(7, 10), rep(6, 5))  # Some weeks had 6 observation days

# Model with offset
model_offset <- glm(visitors ~ day_of_week + marketing_spend + temperature +
                   offset(log(exposure_days)),
                   family = poisson, data = data)

summary(model_offset)
Call:
glm(formula = visitors ~ day_of_week + marketing_spend + temperature +
offset(log(exposure_days)), family = poisson, data = data)
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) 1.734e+00 5.579e-01 3.109 0.00188 **
day_of_weekMon 2.371e-02 1.637e-01 0.145 0.88485
day_of_weekSat 9.873e-02 2.898e-01 0.341 0.73338
day_of_weekSun 1.208e-01 2.472e-01 0.489 0.62513
day_of_weekThu 5.642e-02 1.871e-01 0.302 0.76297
day_of_weekTue -6.713e-02 1.634e-01 -0.411 0.68128
day_of_weekWed -6.073e-02 1.825e-01 -0.333 0.73934
marketing_spend -4.231e-05 1.823e-03 -0.023 0.98149
temperature 8.210e-03 3.179e-02 0.258 0.79623ऑफ़सेट शामिल करने पर गुणांक किस तरह उल्लेखनीय रूप से बदलते हैं, इसे नोट करें। इंटरसेप्ट 3.30 से घटकर 1.73 हो गया, और अन्य सभी प्रभाव छोटे हो गए। यह रूपांतरण इसलिए होता है क्योंकि अब हम अलग-अलग अवधियों के कुल गिनतियों के बजाय प्रति दिन की दर को मॉडल कर रहे हैं।
ऑफ़सेट अलग-अलग एक्सपोज़र लंबाइयों के लिए समायोजन करके निष्पक्ष तुलना सुनिश्चित करता है। इस समायोजन के बिना, अधिक अवलोकन दिनों वाली अवधियाँ कृत्रिम रूप से अधिक आगंतुक गिनतियाँ दिखाएँगी, जिससे वे वास्तविक संबंध छिप सकते हैं जिन्हें हम अध्ययन करना चाहते हैं। अब मॉडल "दैनिक आगंतुक दर क्या है?" का उत्तर देता है, न कि "कुल कितने आगंतुक हुए?"
नए परिदृश्यों के लिए भविष्यवाणियाँ जनरेट करें:
# Create new data for prediction
new_data <- data.frame(
  day_of_week = factor("Fri", levels = levels(data$day_of_week)),
  marketing_spend = 300,
  temperature = 25
)

# Predict expected counts
predicted_counts <- predict(model, newdata = new_data, type = "response")
print(paste("Expected visitors:", round(predicted_counts, 1)))
[1] "Expected visitors: 45.2"मॉडल शुक्रवार के लिए, $300 मार्केटिंग खर्च और 25°C तापमान पर 45.2 आगंतुकों की भविष्यवाणी करता है। यह पूर्वानुमान हमारे प्रेक्षित डेटा (39-58 आगंतुक) की उचित सीमा में है और 46.9 के समग्र माध्य के करीब है।
पॉइसन रिग्रेशन स्वाभाविक रूप से यह सुनिश्चित करता है कि राउंड करने पर भविष्यवाणियाँ सकारात्मक पूर्णांक ही रहें, जबकि रैखिक रिग्रेशन असंभव नकारात्मक मान दे सकता है। type = "response" पैरामीटर मॉडल के आंतरिक लॉग-स्केल के बजाय मूल काउंट स्केल पर भविष्यवाणियाँ लौटाता है।
ओवरडिस्पर्शन तब होता है जब विचरण माध्य से अधिक हो, जो पॉइसन की एक प्रमुख धारणा का उल्लंघन है:
# Calculate dispersion statistic
residual_deviance <- model$deviance
df_residual <- model$df.residual
dispersion <- residual_deviance / df_residual

print(paste("Dispersion statistic:", round(dispersion, 3)))

if (dispersion > 1.5) {
  print("Possible overdispersion detected")
  print("Consider quasi-Poisson or negative binomial models")
}
[1] "Dispersion statistic: 0.849"0.849 का डिस्पर्शन सांख्यक 1 के निकट है, जो दर्शाता है कि हमारा मॉडल बिना महत्त्वपूर्ण ओवरडिस्पर्शन के डेटा को अच्छी तरह फिट करता है। 1 के आसपास के मान संकेत देते हैं कि इस डेटासेट के लिए पॉइसन की माध्य-विचरण समानता की धारणा उचित है।
चूँकि यह मान 1.5 से कम है, कोई चेतावनी संदेश नहीं आता, जो पुष्टि करता है कि मानक पॉइसन रिग्रेशन उपयुक्त है। यदि यह मान 1 से काफी बड़ा (आम तौर पर 1.5 से ऊपर) होता, तो हमें अतिरिक्त परिवर्तनशीलता को समायोजित करने के लिए क्वाज़ी-पॉइसन या नकारात्मक द्विपद (negative binomial) मॉडल पर विचार करना चाहिए।
पैटर्न या मॉडल उल्लंघनों का पता लगाने के लिए अवशेषों की जाँच करें:
# Calculate Pearson residuals
fitted_values <- fitted(model)
pearson_residuals <- residuals(model, type = "pearson")

# Plot residuals vs fitted values
plot(fitted_values, pearson_residuals,
     xlab = "Fitted Values", ylab = "Pearson Residuals",
     main = "Residuals vs Fitted")
abline(h = 0, col = "red", lty = 2)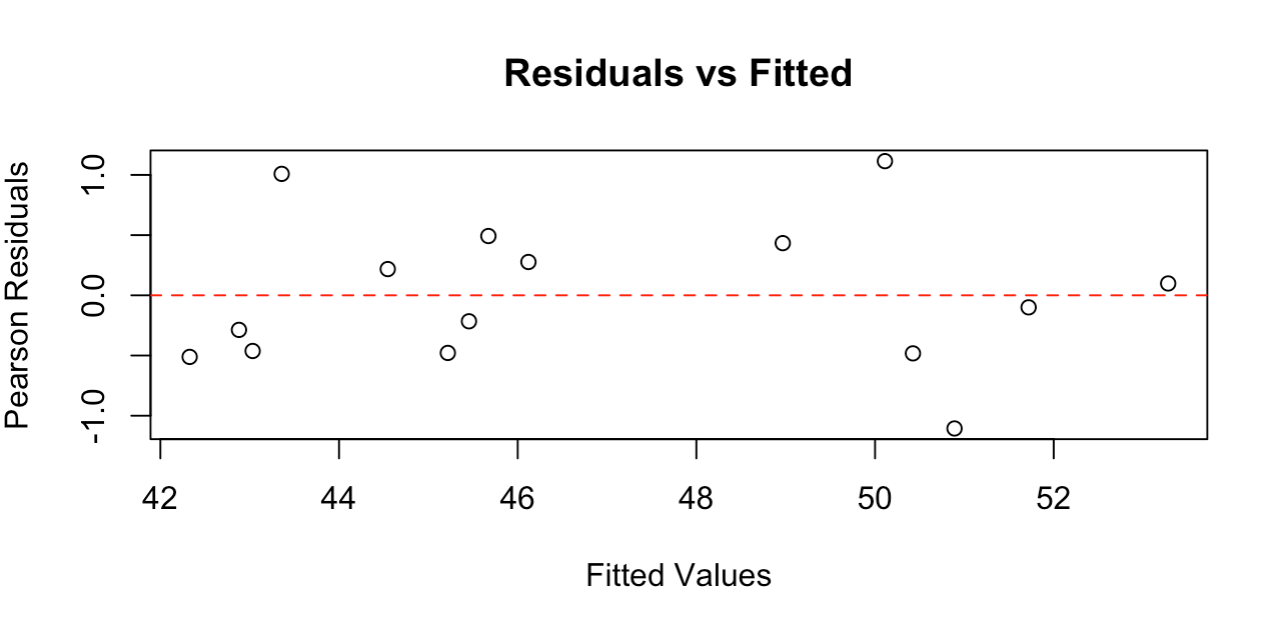
अवशेष प्लॉट शून्य के आसपास अनियमित बिखराव दिखाता है। चित्र: लेखक।
अवशेष प्लॉट शून्य रेखा के आसपास बिंदुओं का यादृच्छिक बिखराव दिखाता है, जिसमें कोई स्पष्ट पैटर्न नहीं है—यह दर्शाता है कि हमारा मॉडल डेटा को अच्छी तरह फिट करता है। अवशेष लगभग -1 से +1 के बीच हैं, जो इस नमूना आकार के लिए उचित है।
अच्छे अवशेष प्लॉट में यह होना चाहिए: शून्य के आसपास यादृच्छिक बिखराव (कोई वक्राकार पैटर्न नहीं), फिटेड मानों के पार लगभग स्थिर फैलाव (कोई फ़नल आकार नहीं), और कोई चरम अपवाद नहीं। यह प्लॉट इन सभी मानदंडों को पूरा करता है, जो पुष्टि करता है कि पॉइसन रिग्रेशन की धारणाएँ पूरी होती हैं और हमारा मॉडल विश्वसनीय परिणाम देता है।
यदि ओवरडिस्पर्शन का पता चले, तो मानक त्रुटियों को समायोजित करने वाले क्वाज़ी-पॉइसन मॉडल पर विचार करें:
# Fit quasi-Poisson model
quasi_model <- glm(visitors ~ day_of_week + marketing_spend + temperature,
                   family = quasipoisson, data = data)
चूँकि हमारा मॉडल अच्छा डिस्पर्शन (0.849) दिखाता है, यहाँ क्वाज़ी-पॉइसन समायोजन की आवश्यकता नहीं है। फिर भी, जब विचरण माध्य से अधिक होता है, तो यह दृष्टिकोण अधिक रूढ़िवादी कॉन्फिडेंस इंटरवल और p-मान प्रदान करता है—जो वास्तविक दुनिया के काउंट डेटा में उपयोगी होता है, जहाँ ओवरडिस्पर्शन अक्सर दिखता है।
अपने IRR के व्यावहारिक अर्थ पर ध्यान देकर मॉडल आउटपुट को व्यवसाय-संबंधी अंतर्दृष्टियों में बदलें। जब आपका मॉडल दिखाता है कि सप्ताहांत दिनों का IRR सप्ताह के दिनों की तुलना में 1.4 है, तो इसे इस तरह संप्रेषित करें: "सप्ताहांत में सप्ताह के दिनों की तुलना में लगभग 40% अधिक आगंतुक आते हैं।" जब मार्केटिंग खर्च का IRR 1.002 है, तो समझाएँ कि "मार्केटिंग में प्रत्येक अतिरिक्त डॉलर से आगंतुकों में लगभग 0.2% वृद्धि जुड़ी है।"
सतत चरों के लिए, अर्थपूर्ण अंतरालों पर प्रभाव प्रस्तुत करने पर विचार करें। एक-डिग्री तापमान परिवर्तन के प्रभाव की चर्चा करने के बजाय 10-डिग्री के अंतर का प्रभाव दिखाएँ—जो व्यवसाय नियोजन के लिए अधिक प्रासंगिक हो सकता है।
पॉइसन रिग्रेशन सहसंबंधों की पहचान करता है, कारण संबंधों की नहीं। मार्केटिंग खर्च और आगंतुक गिनती के बीच एक प्रबल सहसंबंध यह सिद्ध नहीं करता कि वृद्धि का कारण मार्केटिंग ही है। अन्य कारक दोनों चरों को प्रभावित कर सकते हैं। परिणाम प्रस्तुत करते समय इस सीमा को स्वीकार करें।
मॉडल मानता है कि दिए गए पूर्वानुमानकर्ता मानों पर दर स्थिर रहती है। यदि आपके व्यवसाय में ऐसे मौसमी रुझान हैं जो आपके चरों में कैद नहीं हैं, या यदि समय के साथ पूर्वानुमानकर्ताओं और परिणामों के बीच संबंध बदलता है, तो आपका मॉडल भविष्य की अवधियों में अच्छी तरह सामान्यीकृत नहीं हो सकता।
काउंट डेटा में अक्सर शून्य होते हैं, जो पॉइसन रिग्रेशन में पूरी तरह मान्य हैं। पर यदि आपके डेटा में पॉइसन वितरण की अपेक्षा कहीं अधिक शून्य हैं, तो यह किसी अलग डेटा-उत्पादन प्रक्रिया का संकेत हो सकता है। कुछ प्रेक्षण ऐसी अवधियों/स्थितियों का प्रतिनिधित्व कर सकते हैं जहाँ घटना घटित हो ही नहीं सकती थी, न कि ऐसी अवधि जहाँ वह हो सकती थी पर नहीं हुई।
उदाहरण के लिए, वेबसाइट विज़िटर गिनतियों में मेंटेनेंस के कारण साइट डाउन रहने वाले दिनों के लिए शून्य शामिल हो सकते हैं। ये "स्ट्रक्चरल ज़ीरो" पॉइसन प्रक्रियाओं में स्वाभाविक रूप से आने वाले "रैंडम ज़ीरो" से भिन्न होते हैं।
डोमेन ज्ञान के आधार पर अपने सबसे महत्वपूर्ण पूर्वानुमानकर्ताओं से शुरू करें। एक-एक कर चर जोड़ें और आकलन करें कि क्या वे आपके डेटा की समझ में सुधार करते हैं। अधिक जटिल मॉडल हमेशा बेहतर नहीं होते।
केवल सांख्यिकीय महत्त्व पर नहीं, बल्कि व्यावहारिक महत्त्व पर भी ध्यान दें। दरों में सांख्यिकीय रूप से महत्त्वपूर्ण 1% बदलाव व्यवसायिक कार्रवाई का औचित्य न दे, जबकि 20% बदलाव जो सीमांत रूप से गैर-महत्त्वपूर्ण हो, अधिक डेटा के साथ जाँच के योग्य हो सकता है।
जब इक्विडिस्पर्शन विफल हो (विचरण माध्य से बहुत बड़ा हो), तो क्वाज़ी-पॉइसन रिग्रेशन एक सरल समाधान देता है। यह वही मॉडल संरचना रखता है, पर अतिरिक्त परिवर्तनशीलता के लिए मानक त्रुटियों को समायोजित करता है। इससे अधिक रूढ़िवादी कॉन्फिडेंस इंटरवल और p-मान मिलते हैं।
गंभीर ओवरडिस्पर्शन के लिए, नकारात्मक द्विपद रिग्रेशन अतिरिक्त भिन्नता का स्पष्ट रूप से मॉडल करता है। यह दृष्टिकोण माध्य संबंध के साथ-साथ अतिरिक्त परिवर्तनशीलता का भी अनुमान लगाता है।
ओवरडिस्पर्शन की अनदेखी न करें—यह पॉइसन धारणाओं के सबसे आम उल्लंघनों में से एक है और आपके निष्कर्षों को गंभीर रूप से प्रभावित कर सकता है। हमेशा विचरण-से-माध्य अनुपात जाँचें और आवश्यकता होने पर विकल्पों पर विचार करें।
अपने डेटा दायरे से परे एक्स्ट्रापोलेशन करते समय सावधान रहें। यदि आपके मार्केटिंग खर्च का दायरा $100 से $1000 है, तो $5000 के स्तरों के लिए आत्मविश्वास से प्रभाव न बताएं। चरम मानों पर संबंध लॉग-रैखिक न रह सकता है।
सभी वर्गीय पूर्वानुमानकर्ताओं को समान दूरी (equal spacing) वाला न मानें। शिक्षा श्रेणियाँ (हाई स्कूल, कुछ कॉलेज, कॉलेज ग्रेजुएट) आपके आउटपुट चर पर समान प्रभाव न डाल सकती हैं।
अपने मॉडलिंग निर्णयों का दस्तावेज़ीकरण करें, विशेष रूप से धारणाओं के उल्लंघन और उन्हें आपने कैसे संबोधित किया। यदि आपने ओवरडिस्पर्शन पाया पर क्वाज़ी-पॉइसन समायोजन चुना, तो इस निर्णय और उसकी व्याख्या पर प्रभाव का उल्लेख करें।
पॉइसन रिग्रेशन कई क्षेत्रों में काउंट डेटा का विश्लेषण करने के लिए एक प्रभावी ढाँचा प्रदान करता है। जब आप इन तकनीकों को अपने डेटा पर लागू करें, तो सरल मॉडलों से शुरू करें और सांख्यिकीय साक्ष्य और डोमेन विशेषज्ञता, दोनों के आधार पर धीरे-धीरे जटिलता बढ़ाएँ। जब धारणाएँ टूटें, तो क्वाज़ी-पॉइसन या नकारात्मक द्विपद जैसे विस्तार अच्छे विकल्प प्रदान करते हैं। लक्ष्य केवल सांख्यिकीय महत्त्व नहीं, बल्कि ऐसे व्यावहारिक अंतर्दृष्टि हैं जो बेहतर निर्णयों को सूचित करें।
यदि आप अपनी रिग्रेशन विशेषज्ञता को गहरा करना चाहते हैं, तो हमारा Intermediate Regression in R पाठ्यक्रम उन्नत डायग्नॉस्टिक तकनीकों और मॉडलिंग रणनीतियों को कवर करता है, जो आपने यहाँ सीखे पॉइसन रिग्रेशन कौशल का पूरक है। Generalized Linear Models in R भी एक उत्कृष्ट विकल्प है।
DataCamp के साथ सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें