课程
R 中级回归
4 小时
35.8K
当您的数据呈曲线趋势时,用一条直线去估计新数据点就不合理了。这样做会得到一个错过模式的模型,残差很大,预测也很差。真实世界的数据很少严格线性,无论您是在建模药物剂量对反应的影响、温度对材料应力的影响,还是资产价格随时间的变化。
多项式回归通过将线性回归扩展为拟合曲线而非直线来解决这个问题。只需加入几个高次项——x²、x³——您的模型就能把握数据的真实形状。
本文将介绍什么是多项式回归、其背后的数学原理、如何用 Python 实现,以及如何避免大多数人会陷入的陷阱:过拟合。
如果您对机器学习的概念还不熟悉,请先阅读我们的Python 线性回归要点教程。
当一条直线无法描述您的数据时,多项式回归就是您该选择的算法。
线性回归将变量之间的关系建模为一条直线。这在关系确实线性时有效——但大多数真实世界的数据并非如此。想想汽车刹车距离如何随速度变化,或植物的生长速率如何响应肥料。这些关系是弯曲的。无论您怎么做,一条直线都不会很好地拟合它们。
多项式回归通过在方程中加入高次项来扩展线性回归。不再是拟合 y = b0 + b1x,而是拟合类似 y = b0 + b1x + b2x² + b3x³ 这样的形式。多项式的次数——“第 n 次”的那个 n——决定了曲线可以有多少个转折。
用简单直白的话来说,两者的关键区别在于:
线性回归: 拟合直线。每个特征一个系数,曲线只有一个自由度。
多项式回归: 拟合曲线。每增加一个项(x²、x³ 等)都会让模型更灵活,更能跟随数据的形状。
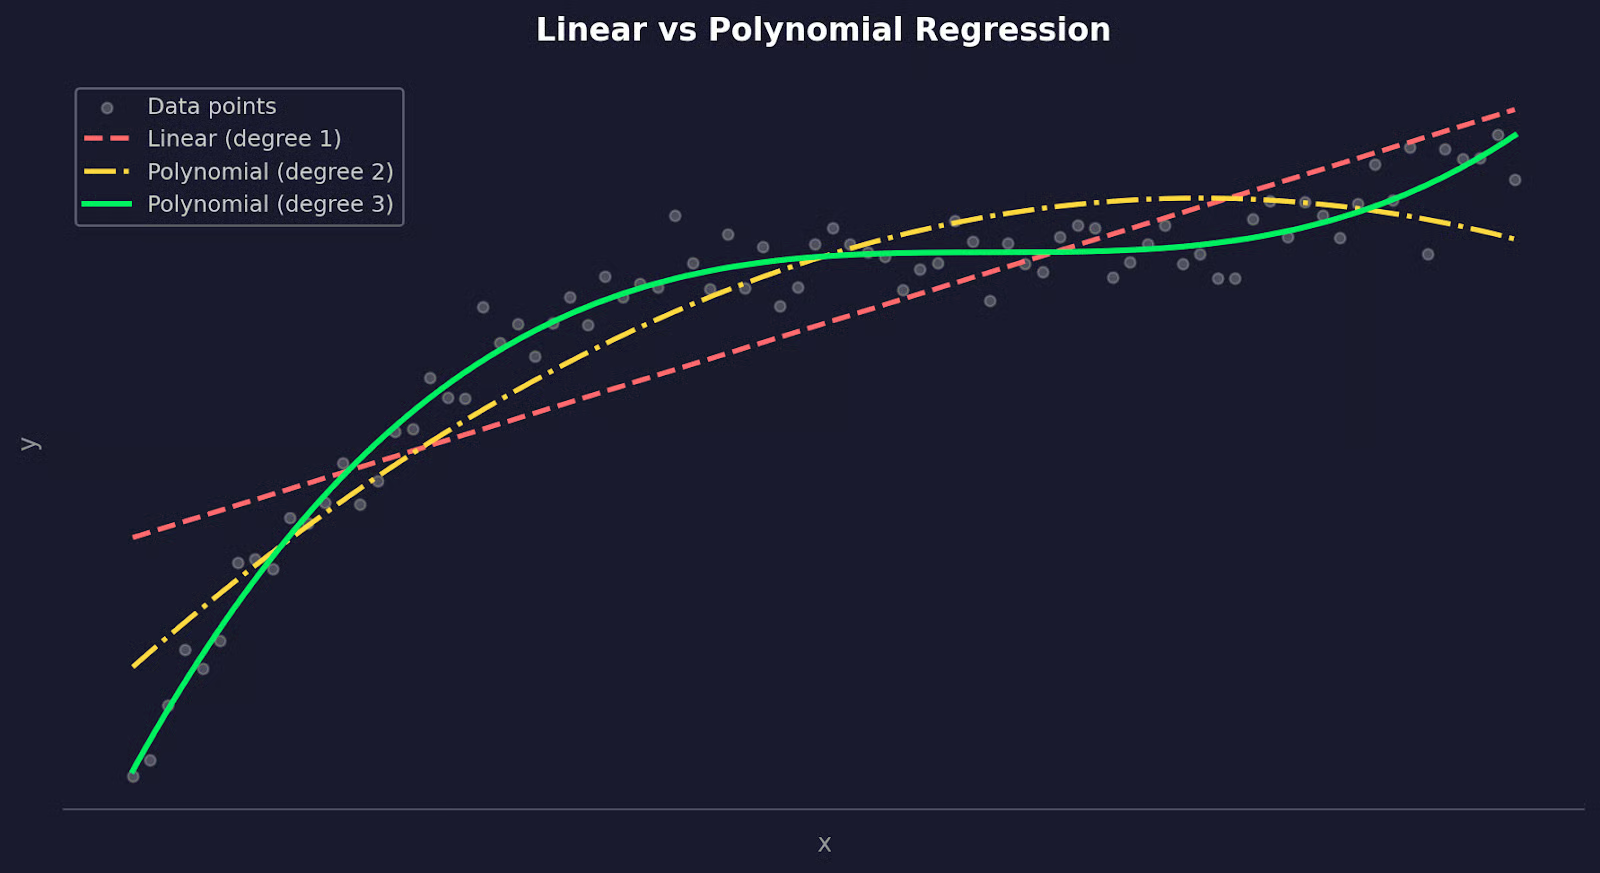
线性回归与多项式回归对比
在表面之下,多项式回归本质上仍是线性模型。这里的“线性”是指模型对待系数的方式,而不是产生的曲线形状。您是在添加新特征(x²、x³),然后在这些特征之上拟合线性方程。
那么,实际中何时使用它?
当线性模型的残差图显示出某种模式时,就该采用多项式回归了——这表明关系并非线性。当您基于领域知识怀疑存在曲线关系时(如物理、生物或经济学中),它也非常适用。
权衡在于,高次多项式可能变得不稳定。二次或三次多项式能处理大多数现实中的曲线,但更高次时,您很可能是在拟合噪声而非信号。
大多数真实世界中变量之间的关系都不是线性的。
直线也许能接近,但当您要预测敏感事项时,“接近”并不够。如果数据中的关系出现弯折,线性模型会持续错过那个弯折。
多项式回归通过允许模型弯曲来做得更好。与其强行用直线穿过数据,不如拟合一条可以跟随关系形状的曲线。
以下是在不同行业中它能带来实质性差异的一些领域:
上述所有情形的共同点是:输入与输出之间的关系会在不同的 x 取值处发生变化。线性回归假设这种变化是恒定的。多项式回归则不这么假设。
但话说回来,多项式回归并非万能。
当您有领域知识提示存在曲线关系,或当残差图清晰显示出直线无法修复的模式时,它效果最佳。带着明确的问题去使用它——而不是仅仅因为线性模型的 R² 不够高。
了解多项式回归的基础数学有助于更好地理解它。
在线性回归中,您的模型如下所示:
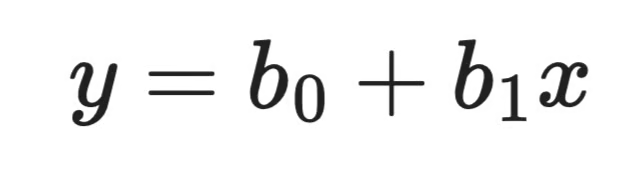
线性回归公式
这是一元输入、一个系数、一条直线。多项式回归通过加入高次项来扩展它:
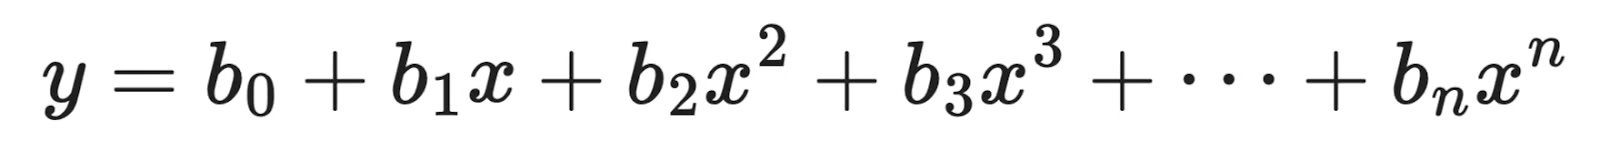
多项式回归公式
每个新项——x²、x³ 等——都为模型多提供一个“转折”。二次多项式可以拟合单峰曲线,三次多项式可以拟合方向变化一次的曲线。次数 n决定了模型的灵活性。
底层算法保持不变。您只是添加了新特征。x² 会被当作一个独立的输入变量,就像 x 一样。模型仍然是在这些变换后的特征上拟合线性方程。
拟合多项式回归模型的方式与线性回归相同——即使用最小二乘估计。
其思想是找到能使残差平方和最小的系数:
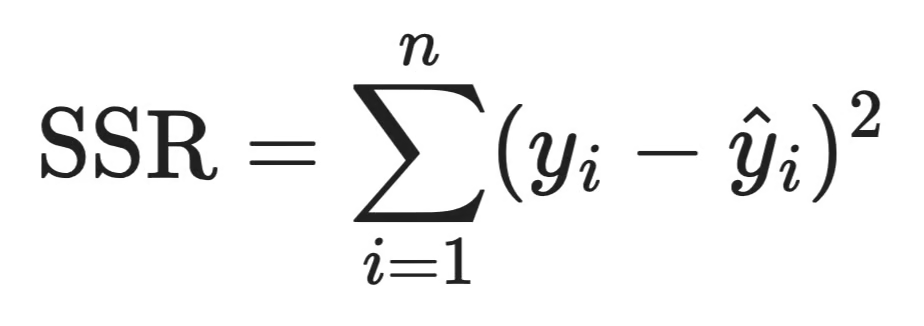
SSR 公式
每个平方差都是一个残差——即模型预测与实际观测之间的差距。平方处理可避免正负误差相互抵消,并对大误差给予更高惩罚。
实践中,库会替您完成这些。但了解最小二乘是目标函数,有助于理解为何异常值会严重影响多项式模型——单个大的残差被平方后,会把系数往它的方向拉。
在线性回归中,b1 有一个直观的解释:x 每增加 1 个单位,y 变化 b1。
多项式回归要复杂一些。当模型包含 b_1x + b_2x^2 时,x 对 y 的影响取决于当前的 x 值——您无法孤立地读取 b2 并得出结论。曲线的斜率始终在变化,您可以通过对 x 求导来看到这一点:
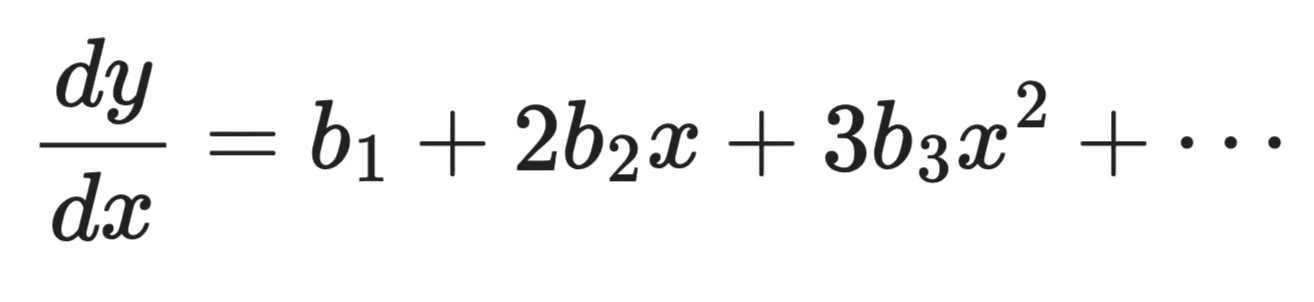
对 x 的导数
斜率本身是 x 的函数。这意味着 x 每增加 1 个单位,在曲线上不同位置的影响都不同。
这就是为什么不应尝试解释多项式模型中的单个系数。相反,应整体看待曲线。将预测与数据一起可视化展示。
多项式回归广泛存在于众多领域,因为真实数据中的曲线关系无处不在。
金融数据很少按直线变化。
资产价格、收入增长以及需求曲线往往会根据市场状况而加速、减速,甚至反转。线性模型假设变化率恒定,这几乎从不成立。多项式回归允许您建模这些转变——例如,消费者需求最初缓慢下降,而当价格超过某个阈值后会急剧下降。
它也适用于时间上的趋势分析。当您为历史价格数据拟合曲线,或建模某个指标在商业周期不同阶段的增长时,二次或三次多项式往往比直线更能准确估计其形状。
物理过程是非线性关系的最佳示例之一。
材料的应力和应变、流体动力学、热膨胀和空气阻力都遵循曲线而非直线。许多物理学中的主导方程本质上就是多项式形式。当您有测量数据但没有简洁的解析式时,多项式回归为拟合这些曲线提供了一种数据驱动的方法。
一个很好的例子是阻力,它随速度的平方增加。线性模型会低估高速下的阻力,而二次多项式能正确拟合这种关系。
在机器学习中,多项式回归常作为一种特征工程技术,而非独立模型。
通过向特征集中加入多项式项——x²、x³、交互项——您可以在不切换到更复杂算法的情况下,让线性模型具备拟合非线性模式的能力。当您的线性模型欠拟合并希望先增加灵活性,而不是立刻转向决策树或神经网络等方法时,这是一种常用的第一步。
它也常用作基线模型。
在训练更复杂的模型之前,拟合多项式回归可以告诉您一条简单曲线能解释多少方差。如果三次多项式已经能达到大部分效果,您可能就不需要更复杂的模型了。
选择多项式的次数是您最重要的决策之一。无论错在哪一边,都会得到一个不够准确的模型。
好在,几行 Python 代码就能完成这项工作。
当次数太低时会发生欠拟合。在弯曲数据上使用一次多项式会错过模式——偏差高、预测差,模型在训练集和新数据上表现都不好。
过拟合则相反,更危险之处在于它一开始看起来不错。高次多项式可以几乎零误差地穿过训练集中的每个数据点。但模型只是记住了噪声。到了新数据上就会崩溃。
您可以通过比较不同次数下的训练误差与测试误差来观察这一点:
import numpy as np
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import train_test_split

np.random.seed(42)

# Generate sample data
x = np.linspace(-3, 3, 80).reshape(-1, 1)
y = 0.6 * x.ravel()**2 - x.ravel() + np.random.normal(0, 0.6, 80)

x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.25)

for deg in [1, 2, 12]:
    poly = PolynomialFeatures(deg)
    model = LinearRegression()
    model.fit(poly.fit_transform(x_train), y_train)

    train_err = mean_squared_error(y_train, model.predict(poly.transform(x_train)))
    test_err  = mean_squared_error(y_test,  model.predict(poly.transform(x_test)))

    print(f"Degree {deg:>2} | Train MSE: {train_err:.4f} | Test MSE: {test_err:.4f}")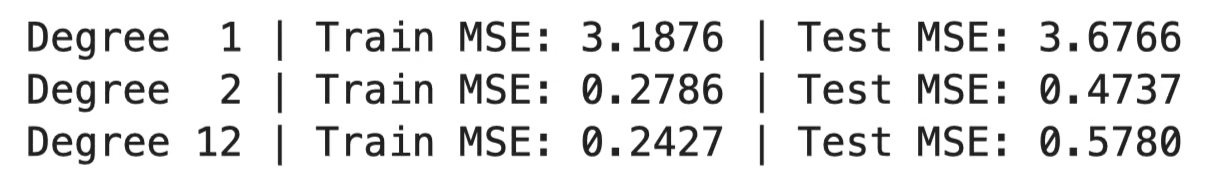
不同次数的 MSE
或以可视化方式呈现:
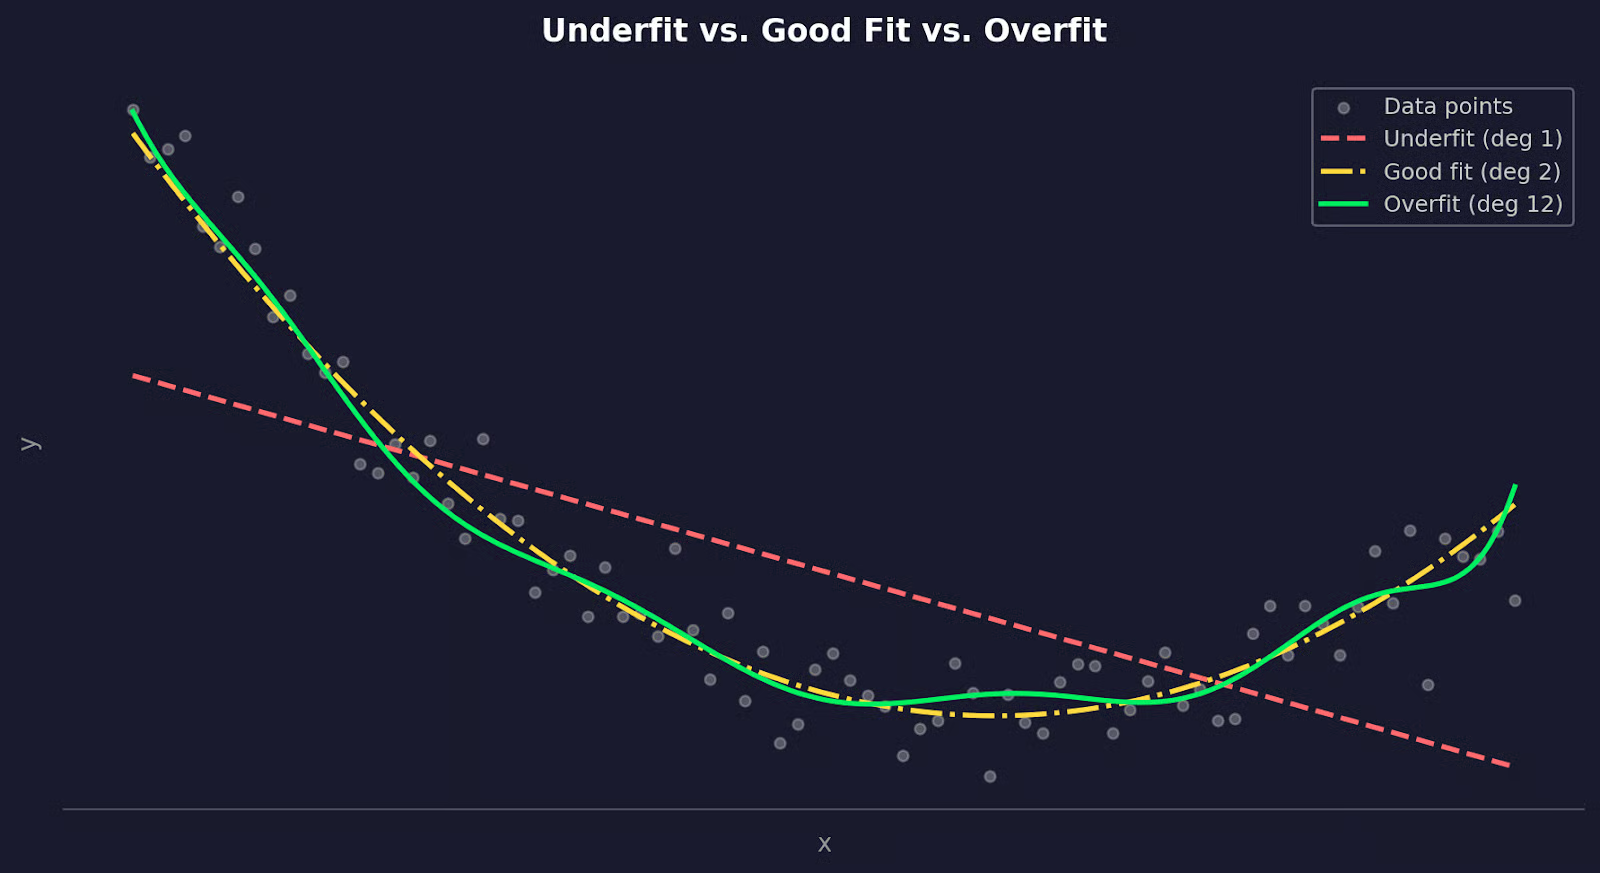
不同多项式次数的拟合效果
一次多项式在两个数据集上误差都很高——这是欠拟合。二次多项式较为均衡。十二次多项式的训练误差更低,但测试误差却高得多——这是过拟合。
寻找最佳次数的正确方法是交叉验证——更具体地说是 k 折交叉验证。
其思想是将数据划分为 k 个子集,然后用其中 k-1 个进行训练,剩下一个作为留出集进行测试,重复此过程,直到每个子集都做过一次测试集。最后对所有折的误差取平均,对每个候选次数执行这一过程,并选择平均测试误差最低的次数。
实现起来比解释简单得多:
import numpy as np
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import make_pipeline
import matplotlib.pyplot as plt

np.random.seed(42)

# Generate sample data
x = np.linspace(-3, 3, 80).reshape(-1, 1)
y = 0.6 * x.ravel()**2 - x.ravel() + np.random.normal(0, 0.6, 80)

# Test degrees 1 through 10
degrees = range(1, 11)
mean_errors = []

for deg in degrees:
    model = make_pipeline(PolynomialFeatures(deg), LinearRegression())
    scores = cross_val_score(model, x, y, cv=5, scoring="neg_mean_squared_error")
    mean_errors.append(-scores.mean())
    print(f"Degree {deg:>2} | Mean error: {-scores.mean():.4f}")

best_degree = np.argmin(mean_errors) + 1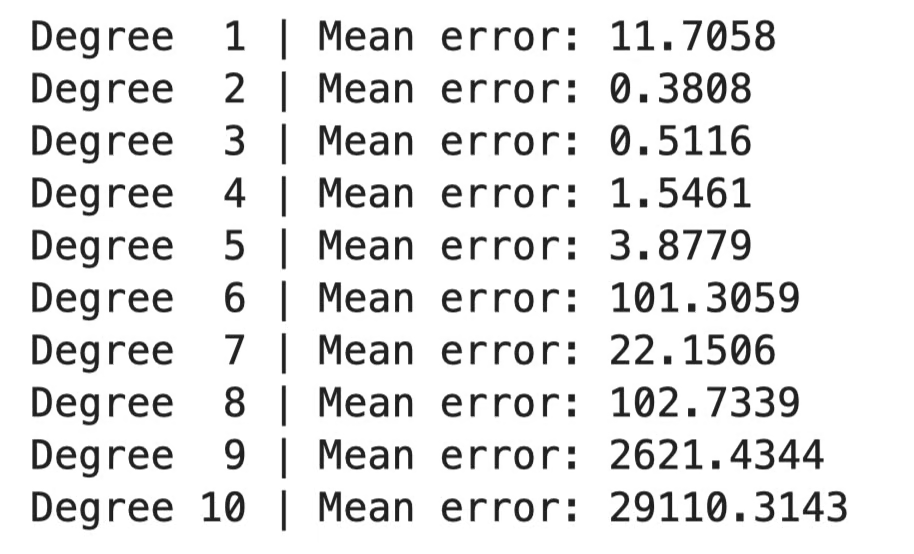
次数误差对比
或以可视化方式呈现:
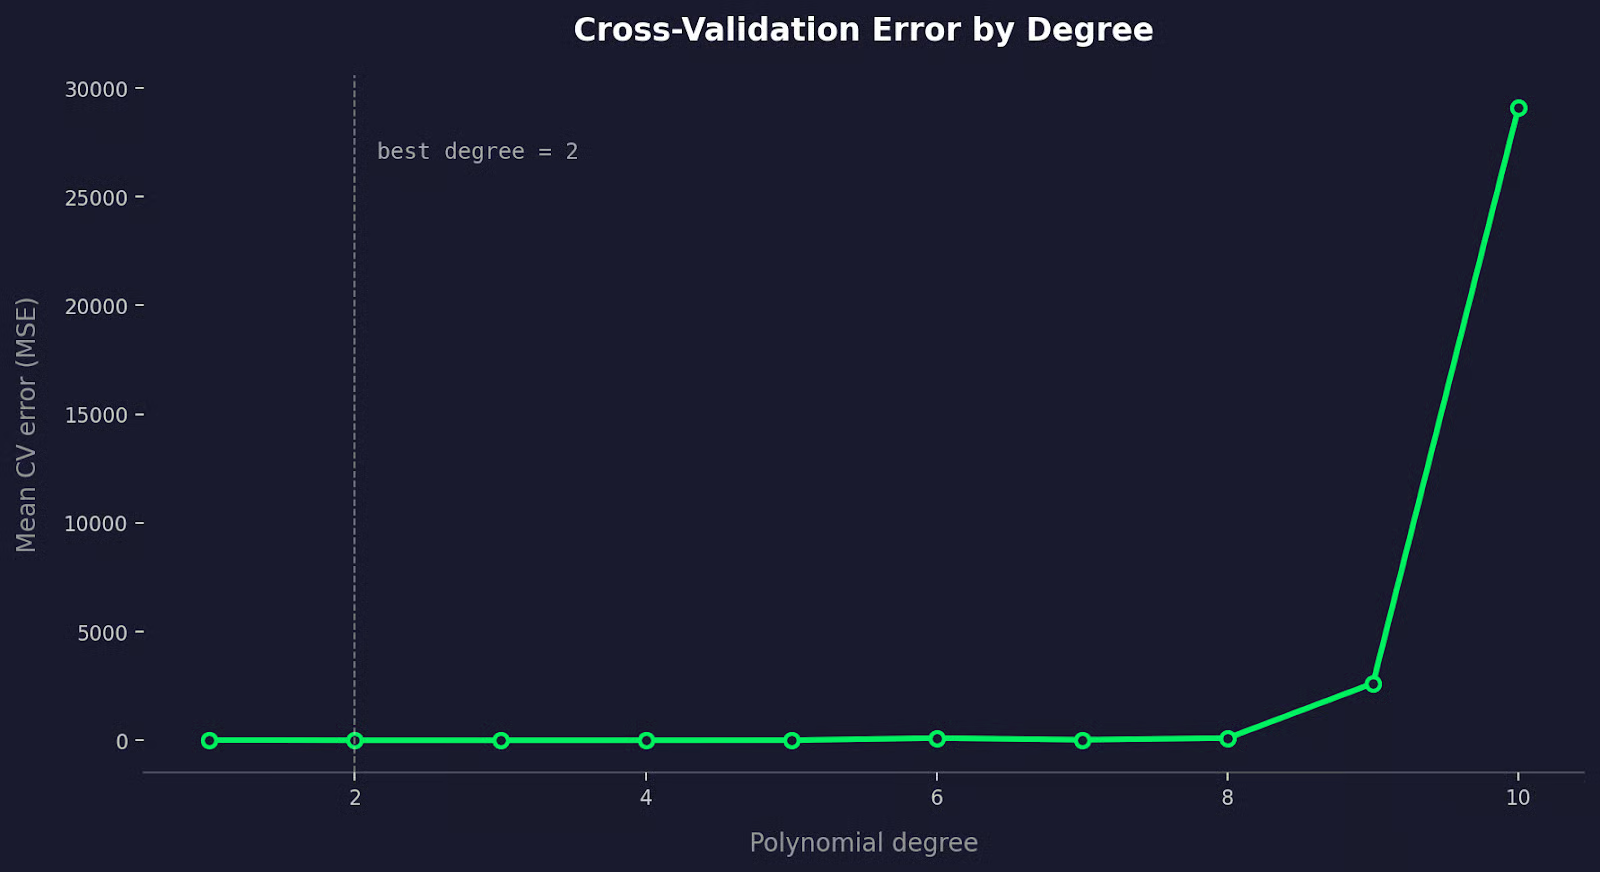
交叉验证误差对比
随着您加入有用的多项式项,CV 误差会下降;当模型开始过拟合时,误差又会上升。
当两个次数给出的 CV 误差相近时,选择较低的那个。性能相当的更简单模型永远是更好的选择。
多项式回归有几种方式会把您引向错误的结论。我们来逐一看看。
与线性回归相比,多项式回归更容易受异常值影响。
最小二乘会在求和前对每个残差进行平方。离趋势较远的单个数据点会带来不成比例的大误差,模型会为了降低该误差而扭曲整条曲线——即使这会让其它地方的拟合变差。
随着次数增加,这种影响会加剧。高次多项式有足够的灵活性去追逐某个异常值,从而把曲线从数据主体处拉离,只为拟合那一个坏点。
解决办法之一是在拟合前清洗数据。先画图,识别异常值,并判断它们代表真实信号还是噪声。如果是噪声——测量误差、数据录入错误、记录损坏——就移除它们。如果是真实存在,考虑使用对异常值更稳健的拟合方法,比如 RANSAC 或 Huber 回归。
每添加一个多项式项,您就赋予模型更多灵活性。某个时刻,这种灵活性不再有益,模型开始拟合训练数据中的随机噪声而非实际模式。结果是在训练数据上表现良好、但在新数据上崩溃的曲线。
棘手之处在于,如果您只看训练误差,过拟合是不可见的。十次多项式几乎总会比二次多项式有更低的训练 MSE。这并不意味着它是更好的模型。
您应这样做:
当您有充分理由认为存在曲线关系,且能将次数保持在较低水平时,多项式回归效果最佳。
多项式回归并非总是正确工具——以下一些替代方法可能更适合您(双关语有意而为)。
样条能解决全局不稳定的问题。
当您拟合十次多项式时,每个系数都受每个数据点影响。数据某一区域的变化会影响到曲线的其它地方。样条通过将数据分段、并对每一段分别拟合低次多项式来避免这种情况。各段在称为节点的点上拼接,并通过约束使拼接处的整体曲线保持平滑。
结果是:该弯的地方足够灵活,其它地方保持稳定。
在 Python 中,scipy 和 scikit-learn 都提供了可靠的样条实现:
from scipy.interpolate import UnivariateSpline

spline = UnivariateSpline(x, y, k=3)
y_pred = spline(x_new)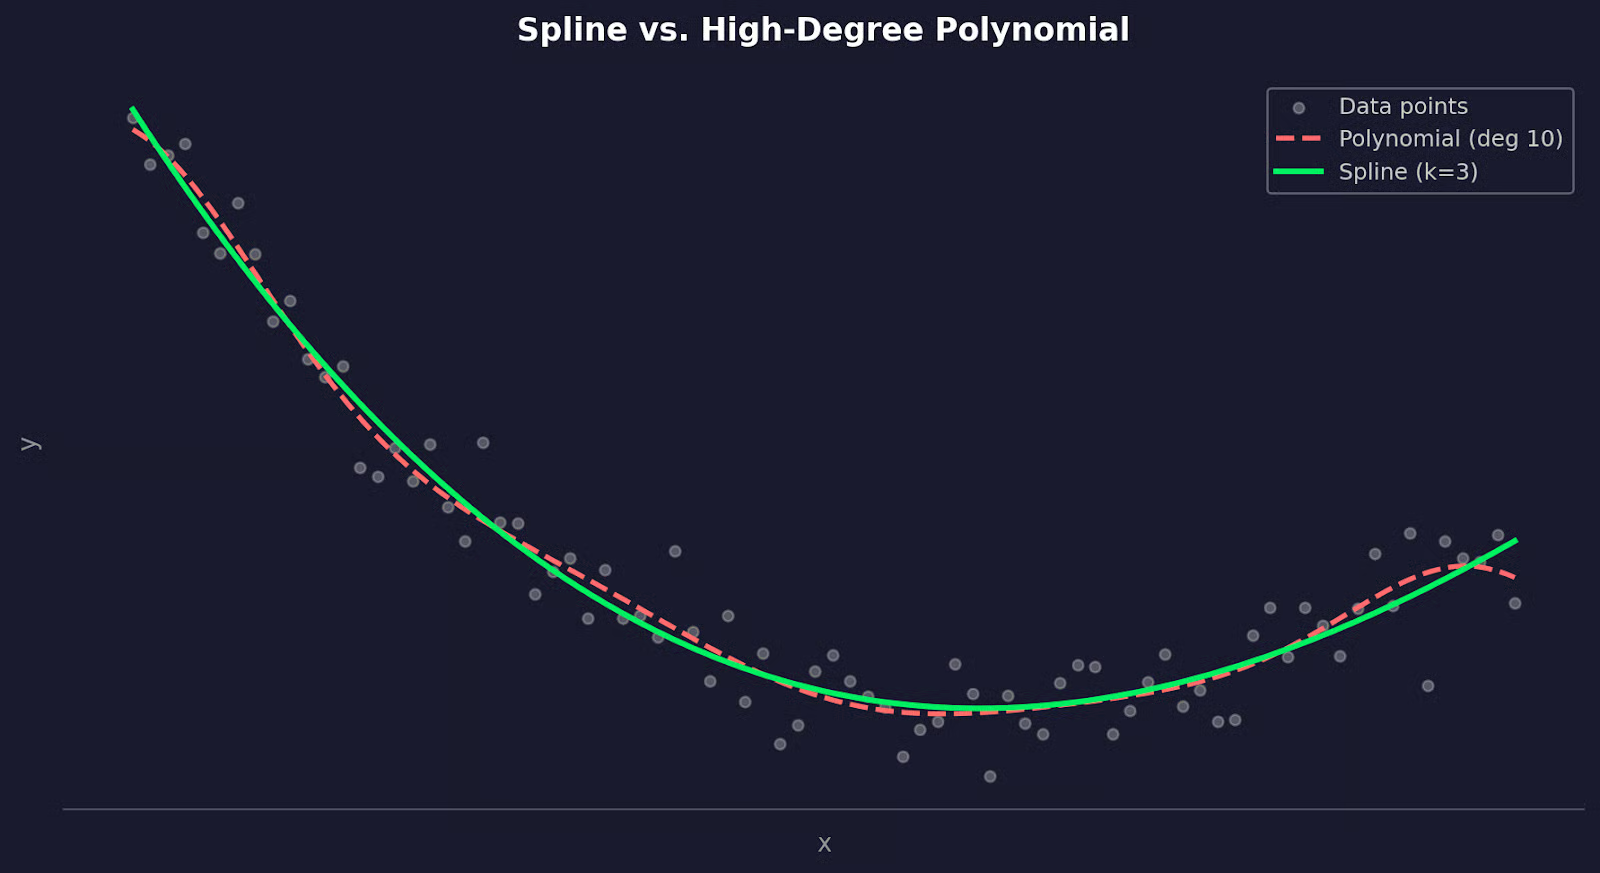
样条与高次多项式对比
重申一下,当您的数据在不同区域呈现不同行为,或单一多项式曲线只有在高次数下才能捕捉形状时,请选择样条。
支持向量回归(SVR)采用不同思路。
它并不拟合一条让所有点平方误差最小的曲线,而是尽量找到一个函数,使其对尽可能多的点保持在某个误差边界内,同时忽略落在该边界内的点。这让它相较多项式回归对异常值不那么敏感。
与多项式回归的联系体现在核技巧上。使用多项式核的 SVR 可以拟合与多项式回归类似的非线性关系——但通过正则化参数,具备更好的泛化能力与更可控的拟合。
from sklearn.svm import SVR

model = SVR(kernel="poly", degree=3, C=1.0, epsilon=0.1)
model.fit(x_train, y_train)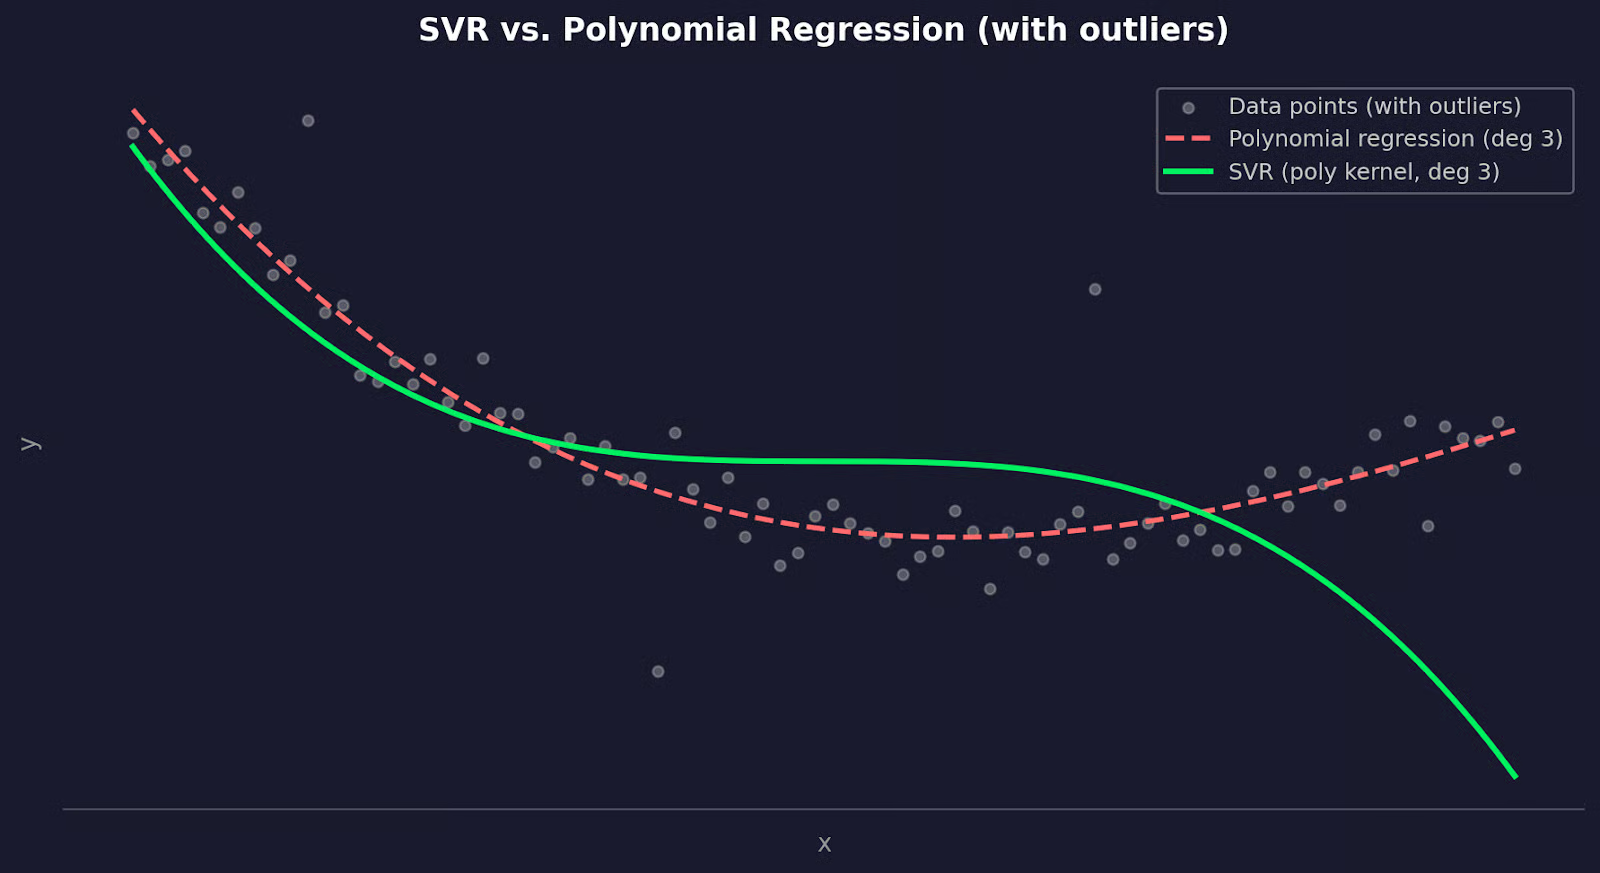
SVR 与高次多项式对比
当数据中存在无法去除的异常值、您需要更好地控制偏差-方差权衡,或尽管进行了交叉验证多项式回归仍不断过拟合时,SVR 是不错的选择。
在本文中,我向您展示了多项式回归如何将线性回归扩展为拟合曲线,最小二乘估计如何找到最佳系数,以及为何单独解释这些系数并不能说明太多问题。
您选择的次数比其他任何因素都更重要。次数过低会导致欠拟合,过高会导致过拟合。交叉验证为您提供了一种客观方式来找到最佳平衡点。而当多项式回归不合适时,样条和 SVR 是值得了解的可靠替代方案。
培养直觉的最佳方式是将其用于您自己的数据。选择一个您怀疑存在非线性关系的数据集,先拟合线性模型,绘制残差,再看看多项式回归会带来怎样的不同。阅读我们的非线性模型与 R 中的洞见指南,了解这一流程的实践。
与 DataCamp 一起学习
课程
课程
课程