
课程
使用 Python 中的 statsmodels 进行回归入门
4 小时
63K
平方和是一种复杂的统计度量,在回归分析中起着至关重要的作用。它描述了因变量的变异性,并可分解为三个组成部分——总平方和(SST)、回归平方和(SSR)和误差平方和(SSE)——共同用于评估回归模型的表现。
在本文中,我们将讨论平方和的三个组成部分,以及决定系数 R²。我们将先分别概述每一种平方和,然后再考察它们之间的数学关系。最后,我们将探讨 SST、SSR 和 SSE 与 R²(一个关键的模型评估指标)之间的联系。
我们先来定义什么是 SST、SSR 和 SSE,说明各自如何反映总体变异性,以及它们如何帮助评估回归模型的拟合优度。此外,我们还将看看在一个只有一个因变量和一个自变量的简单线性回归中,每种平方和的含义和图示。
如果在阅读定义时,您希望复习不涉及编码的统计学内容,欢迎查看我们的课程 Introduction to Statistics。针对特定技术的统计入门课程包括 Introduction to Statistics in Google Sheets、Introduction to Statistics in Python 和 Introduction to Statistics in R。
总平方和(SST)是观测到的因变量每个取值与该变量均值之间差异的平方之和。它也称为全平方和(TSS)。
总平方和表示因变量的总体变异性,其中既包含被回归模型解释的部分,也包含未被解释的部分。按照其本质,SST 反映了观测因变量各个取值相对于其均值的整体离散程度。
下面是计算 SST 的数学公式:
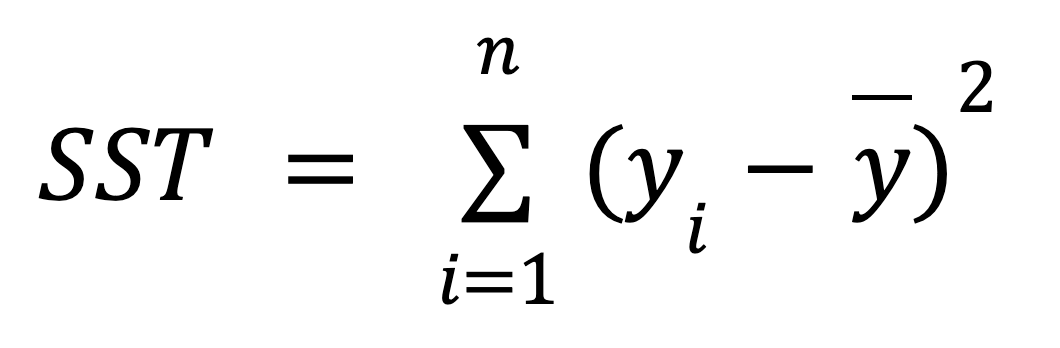
其中:
下图是一个简单线性回归中该公式的几何示意:
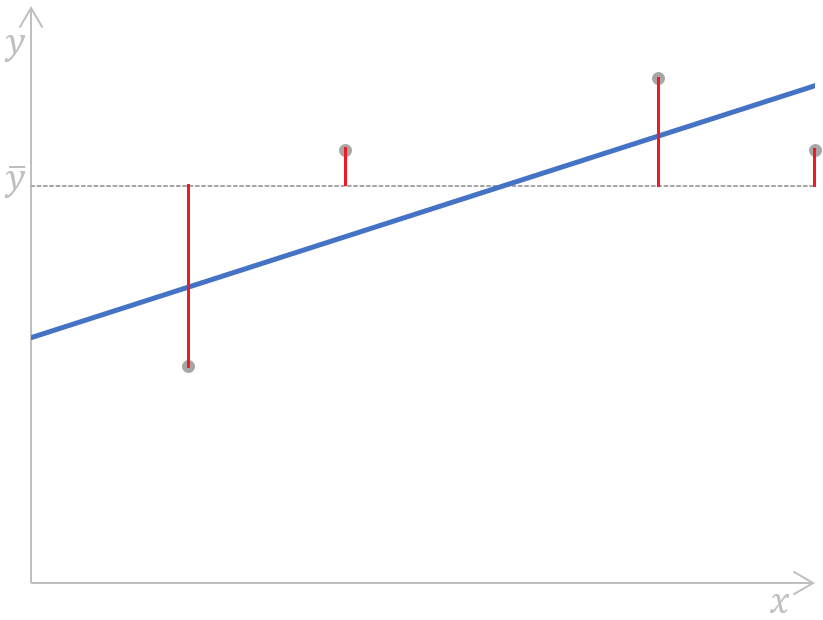
在简单线性回归中计算总平方和。图片来源:作者
如图所示,将观测因变量的均值(灰色虚线)与该变量每个取值(灰点)之间的距离(图中的红色线段)进行度量、平方并求和。此外,该图也清楚地表明,SST 不依赖于回归模型;它只取决于观测到的 y 值及其均值。
回归平方和(SSR)是回归模型对每个自变量数据点所预测的因变量取值,与观测因变量均值之间差异的平方之和。该度量也称为:回归平方和、回归所致平方和、解释平方和,另一个常用缩写是 ESS。
回归平方和刻画了回归模型所能解释的因变量总体变异性的那一部分(因此也被称为解释平方和)。我们也可以把它看作由于引入回归模型而减少的误差。
计算 SSR 的公式如下:
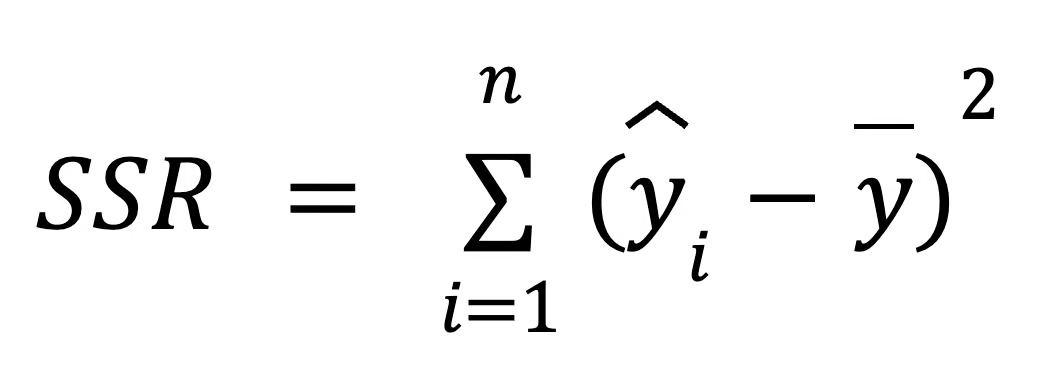
其中:
我们可以用下图的简单线性回归来示意该公式:
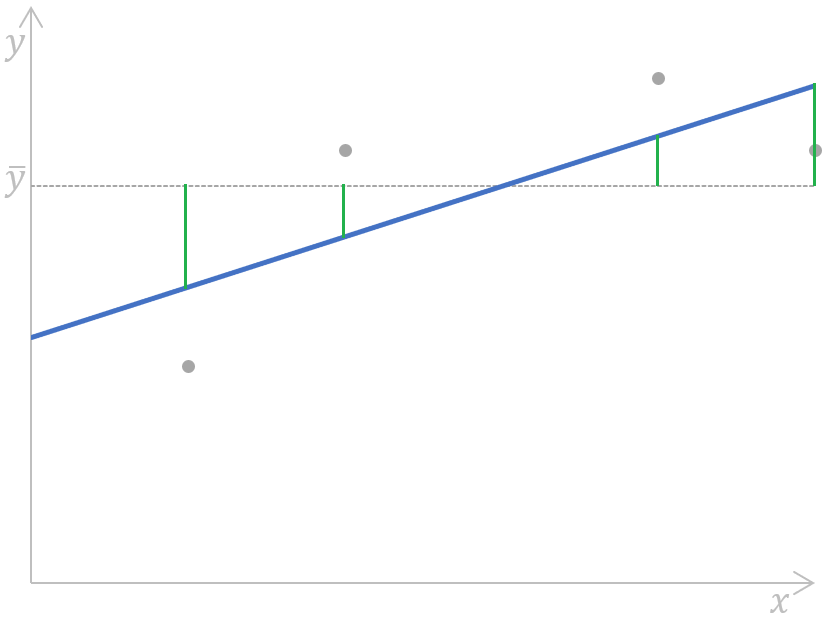 在简单线性回归中计算回归平方和。图片来源:作者
简单来说,就是将观测因变量的均值(灰色虚线)与回归模型对每个自变量数据点所预测的因变量取值(蓝色直线)之间的距离(绿色线段)进行度量、平方并求和。
在回归分析中,SSR 有助于衡量模型拟合程度,帮助判断模型对数据点的预测效果。稍后在讨论三种平方和度量之间的关系时,我们会更清楚地看到其作用。
误差平方和(SSE)是观测到的因变量每个取值与回归模型对同一自变量数据点所预测的因变量取值之间差异的平方之和。换言之,该度量衡量因变量的实际值与预测值之间的差异。
误差平方和也被称为:误差平方和、残差平方和、残差平方和(另一说法)或未解释平方和。除 SSE 外,它还可缩写为 RSS、ESS,甚至 SSR——最后一种容易与前面提到的回归平方和 SSR 混淆。
误差平方和反映了剩余误差或未解释的变异性,即因变量总体变异性中无法被回归模型解释的那一部分(因此也称为未解释平方和)。
我们可以用以下公式计算 SSE:
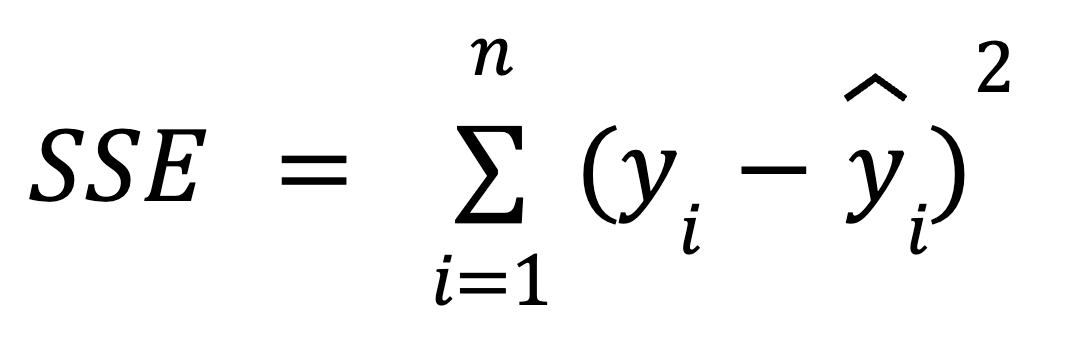
其中:
从图形上看,该公式可表示为:
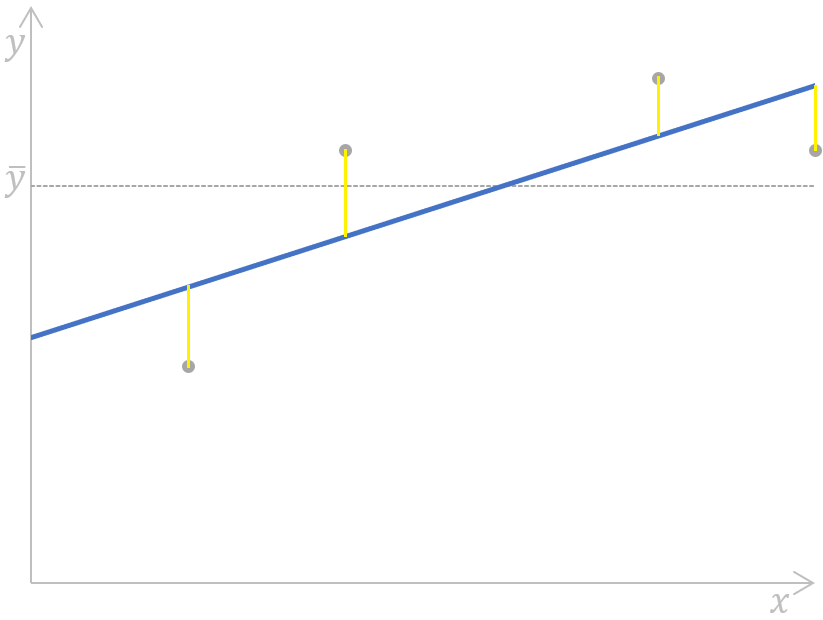 在简单线性回归中计算误差平方和。图片来源:作者
这里,将每一对因变量的实际值与预测值之间的距离(黄色线段)进行度量、平方并求和。
在回归分析中,最小化 SSE 是提升回归模型准确性的关键,下一章我们将进一步建立这方面的直觉。
我们还为特定技术准备了一系列教程,帮助您掌握构建简单线性回归和逻辑回归模型所需的技能,包括 Essentials of Linear Regression in Python、How to Do Linear Regression in R 和 Linear Regression in Excel: A Comprehensive Guide For Beginners。
SST、SSR 与 SSE 之间的数学关系可由下式表示:
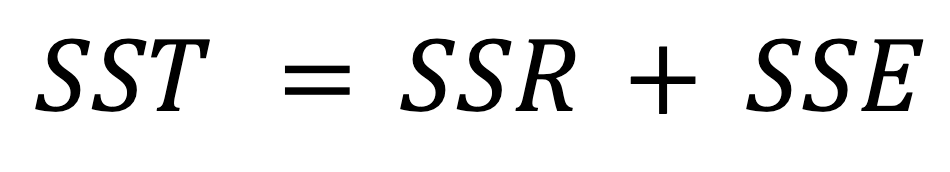
此前我们提到,总体变异性(SST)由已解释的变异性(SSR)和未解释的变异性(SSE)共同构成,这一点体现在上式中。
正如之前所见,SST 不依赖回归模型,而另外两个度量则依赖。这意味着提升模型准确性与 SSR 或 SSE 的变化相关——具体来说,是通过最小化 SSE、从而最大化 SSR。由上述公式可知,SSE 越小,SSR 越接近 SST;因此,我们的回归模型对因变量观测值的拟合就越好。
如果 SSE 等于 0,则 SSR 将与 SST 重合,这意味着因变量的所有观测值都被回归模型完美解释,即全部精确落在回归线上。现实场景中这几乎不会发生,但我们应努力最小化 SSE,以获得更可靠的回归模型。
由于 SST 表示数据的总体变异性,当我们拟合回归模型时,会将这部分总体变异性分解为两部分:SSR 和 SSE。这个分解在几何上很有趣,因为它在高维空间中体现了毕达哥拉斯定理。这是因为总体变异性被划分成两个正交分量:模型解释的变异性与未解释的误差。这种解释是合理的,因为回归本质上是在将数据投影到一个由预测变量张成的低维空间。要进一步了解如子空间之类的概念,请学习我们的课程 Linear Algebra for Data Science in R。
在岭回归和套索回归中,将 SST 分解为 SSR 和 SSE 并不遵循相同的关系。因为岭回归和套索回归都在其损失函数中加入了正则化项(惩罚项),从而改变了这种关系。在正则化回归中,SST 仍然是明确可定义的,但由于存在正则化项,已解释变异性与残差变异性不再相加等于 SST。想了解更多,请阅读我们的教程 Regularization in R Tutorial: Ridge, Lasso and Elastic Net。
R²,也称为决定系数,是评估回归模型拟合质量及其预测能力的重要统计度量。它表示因变量的变异性中可以由自变量解释的比例。R² 可以通过将相关系数 r 平方得到,也可以按照以下公式计算:
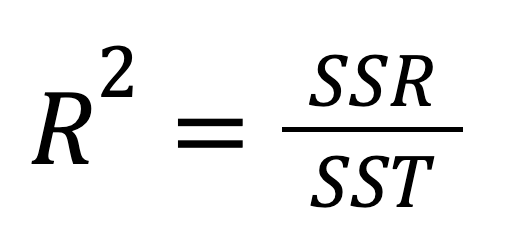
或者:
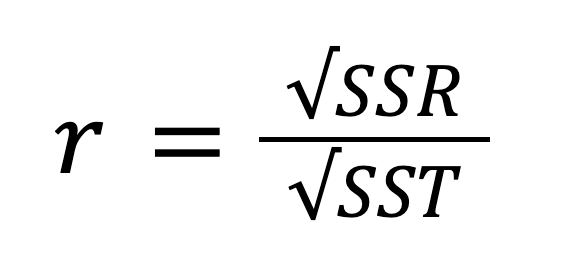
结合 SST、SSR 与 SSE 之间的关系,上式还可改写为:
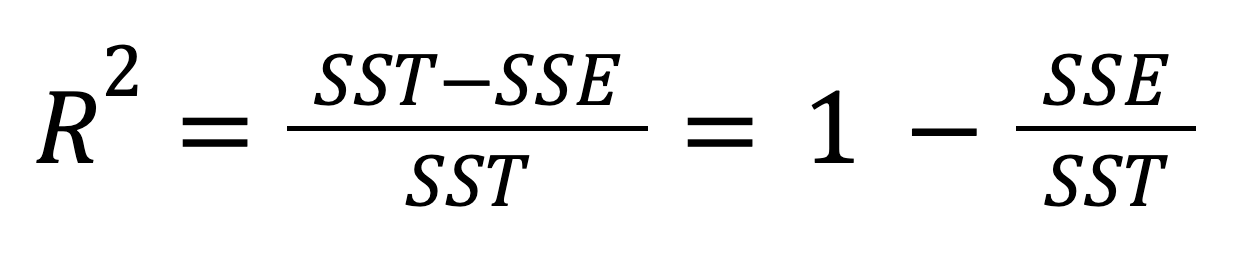
R² 的取值范围为 0 到 1(含端点)。若 R2 = 0,表示我们的回归模型完全无法解释因变量的变异性;若 R2 = 1,表示我们的回归模型能完美解释因变量的全部变异性。在实际中,这些极端值几乎不可能出现——现实案例中我们通常会看到介于二者之间的数值。
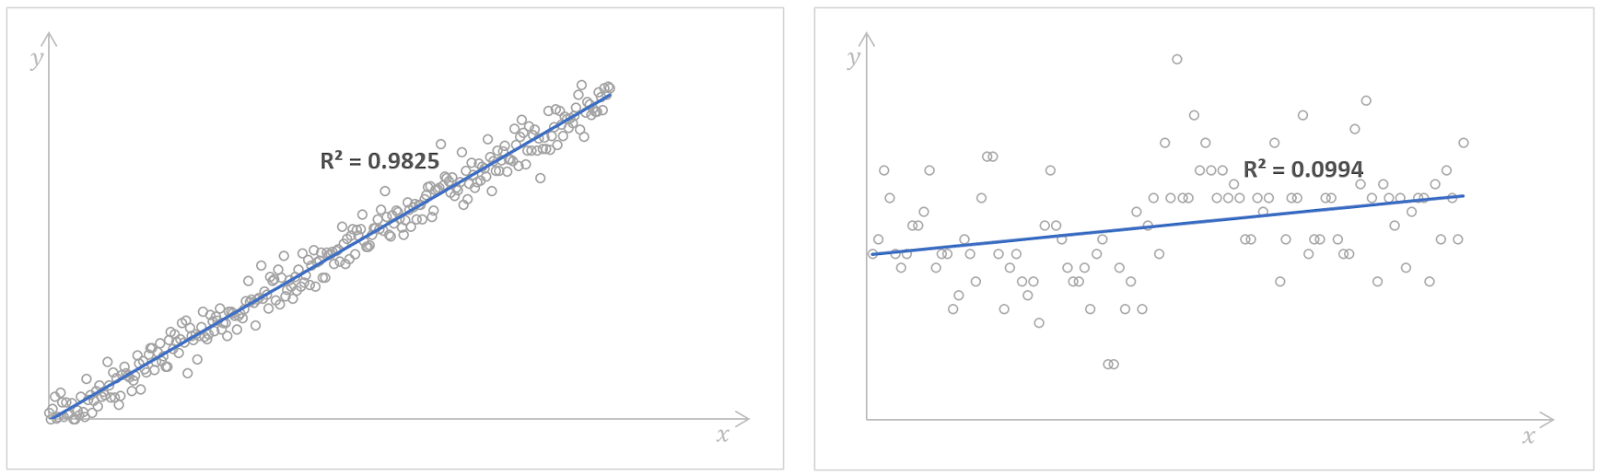
R² 较高(左)与较低(右)的回归模型。来源:Kaggle Number of Books Read 与 Kaggle Possum Regression。图片来源:作者。
较高的 R² 值表明模型表现良好,意味着自变量能够以较高的准确度预测因变量。然而,并不存在一个通用的“经验阈值”来判断 R² 多高才算足够好。这取决于具体情境、对回归模型精度的要求,以及我们对数据中变异性的预期。通常,这也与回归分析所涉及的领域有关。例如,在自然科学领域,我们可能希望 R² 高于 0.8;而在社会科学中,0.3 的数值可能就已经足够。
最后需要说明的是,在多元线性回归(即包含多个自变量的回归)中,我们常常考虑调整后的 R²,它是在 R² 基础上进行的扩展,用于考虑预测变量数量和样本量的影响。
如今我们可以在大多数统计软件和编程语言中轻松快速地计算 SST、SSR 和 SSE,但真正理解它们的含义、相互关系,尤其是它们在回归分析中的重要性,仍然非常有价值。理解这三种变异性组成部分与 R² 之间的关系,有助于数据分析师和数据科学家通过最小化 SSE、最大化 SSR 来提升模型表现,从而对回归模型做出更明智的判断。
要夯实统计学基础,并通过处理真实世界数据来学习强大的统计技术,建议参考以下系统且适合初学者的技能路径:Statistics Fundamentals in Python 和 Statistics Fundamentals in R。最后,如果您对回归系数的计算方式感兴趣,欢迎阅读我们的 Normal Equation for Linear Regression Tutorial 和 QR Decomposition in Machine Learning: A Detailed Guide。
与 DataCamp 一起学习
课程
课程
课程