कोर्स
Intermediate Regression in R
4 घंटा
35.8K
जब आपका डेटा वक्र लेता है, तो नए डेटा पॉइंट्स का अनुमान लगाने के लिए सीधी रेखा का उपयोग करना समझदारी नहीं है। ऐसा करने पर आपको ऐसा मॉडल मिलेगा जो पैटर्न को पकड़ ही नहीं पाएगा, अवशेष (रेजिड्युअल) अधिक होंगे, और भविष्यवाणियाँ खराब होंगी। वास्तविक दुनिया का डेटा शायद ही कभी रैखिक (लिनियर) व्यवहार करता है—चाहे आप दवा की खुराक का प्रतिक्रिया पर प्रभाव, तापमान का सामग्री के तनाव पर असर, या समय के साथ एसेट कीमतों की चाल मॉडल कर रहे हों।
पॉलीनॉमियल रिग्रेशन इसे इस तरह ठीक करता है कि यह रैखिक रिग्रेशन का विस्तार कर सीधी रेखा के बजाय वक्र फिट करता है। बस कुछ उच्च-घात के टर्म जोड़ें—x², x³—और आपका मॉडल आपके डेटा के वास्तविक आकार का पीछा कर सकेगा।
इस लेख में, मैं बताऊँगा कि पॉलीनॉमियल रिग्रेशन क्या है, इसके पीछे का गणित क्या है, इसे Python में कैसे लागू करें, और उस जाल से कैसे बचें जिसमें अधिकतर लोग फँसते हैं: ओवरफिटिंग।
यदि आप मशीन लर्निंग की अवधारणा में नए हैं, तो पहले हमारा Essentials of Linear Regression in Python ट्यूटोरियल पढ़ें।
जब आपकी डेटा कहानी को सीधी रेखा बयाँ नहीं कर सकती, तब आप पॉलीनॉमियल रिग्रेशन का सहारा लेते हैं।
लिनियर रिग्रेशन चर (वेरिएबल) के बीच संबंध को सीधी रेखा के रूप में मॉडल करता है। यह तब काम करता है जब संबंध सचमुच रैखिक हो—पर अधिकांश वास्तविक डेटा ऐसा नहीं होता। सोचिए, कार की ब्रेकिंग दूरी स्पीड के साथ कैसे बदलती है, या किसी पौधे की वृद्धि दर उर्वरक पर कैसे प्रतिक्रिया देती है। ये संबंध वक्र लेते हैं। सीधी रेखा उन्हें चाहे जितना मोड़ें, ठीक से फिट नहीं करेगी।
पॉलीनॉमियल रिग्रेशन समीकरण में उच्च-घात के टर्म जोड़कर लिनियर रिग्रेशन का विस्तार करता है। y = b0 + b1x फिट करने के बजाय, आप कुछ इस तरह फिट करते हैं: y = b0 + b1x + b2x² + b3x³। पॉलीनॉमियल की डिग्री—"nवीं डिग्री" में वह n—नियंत्रित करती है कि वक्र कितनी बार मुड़ सकता है।
संक्षेप में, दोनों के बीच मुख्य अंतर यह है:
लिनियर रिग्रेशन: सीधी रेखा फिट करता है। प्रति फीचर एक गुणांक (कोएफिशिएंट), वक्र में एक ही डिग्री की स्वतंत्रता।
पॉलीनॉमियल रिग्रेशन: वक्र फिट करता है। हर अतिरिक्त टर्म (x², x³, ...) मॉडल को डेटा के आकार का अनुसरण करने के लिए अधिक लचीलापन देता है।
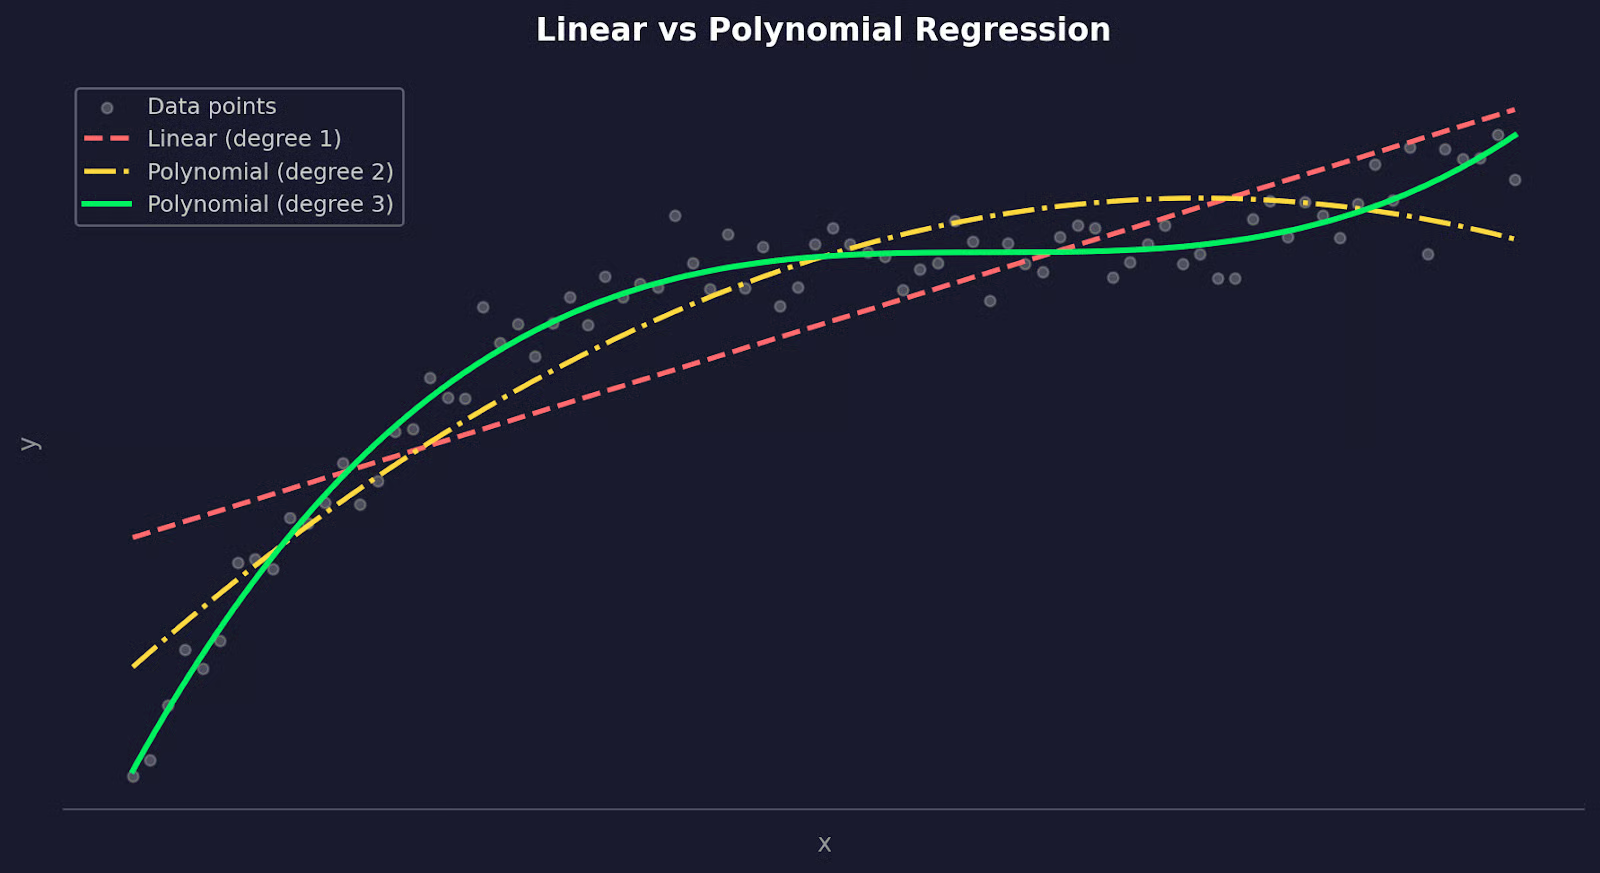
लिनियर बनाम पॉलीनॉमियल रिग्रेशन
अंदरूनी तौर पर, पॉलीनॉमियल रिग्रेशन अब भी एक लिनियर मॉडल ही है। यहाँ "लिनियर" से तात्पर्य यह है कि मॉडल अपने गुणांकों के साथ कैसा व्यवहार करता है, न कि उससे बनने वाले वक्र के आकार से। आप नए फीचर जोड़ रहे हैं (x², x³) और उन पर एक रैखिक समीकरण फिट कर रहे हैं।
तो इसे वास्तव में कब उपयोग करना चाहिए?
जब लिनियर मॉडल के रेजिड्युअल प्लॉट में कोई पैटर्न दिखे—यह इस बात का संकेत है कि संबंध रैखिक नहीं है—तो पॉलीनॉमियल रिग्रेशन अपनाएँ। यह तब भी उपयुक्त है जब डोमेन ज्ञान किसी वक्र संबंध का सुझाव देता है, जैसे भौतिकी, जीवविज्ञान, या अर्थशास्त्र में।
समझौता यह है कि उच्च-डिग्री पॉलीनॉमियल अस्थिर हो सकते हैं। डिग्री-2 या डिग्री-3 अधिकतर वास्तविक वक्रों को संभाल लेते हैं, पर उससे आगे जाने पर आप संकेत (सिग्नल) की बजाय शोर फिट करने लगते हैं।
अधिकांश वास्तविक संबंध रैखिक नहीं होते।
सीधी रेखा पास-पहुँच तो सकती है, पर "पास" पर्याप्त नहीं है जब आप किसी संवेदनशील चीज़ की भविष्यवाणी कर रहे हों। डेटा के संबंध में मोड़ हो तो लिनियर मॉडल उस मोड़ को लगातार चूकता रहेगा।
पॉलीनॉमियल रिग्रेशन मॉडल को वक्र लेने देता है, इसलिए यह बेहतर काम करता है। अपने डेटा में ज़बरदस्ती सीधी रेखा घुसाने के बजाय, आप ऐसा वक्र फिट कर रहे हैं जो संबंध के आकार का अनुसरण कर सके।
यहाँ अलग-अलग व्यवसाय क्षेत्रों में कुछ उदाहरण हैं जहाँ इसका वास्तविक फर्क पड़ता है:
इन सभी मामलों में साझा बात यह है: इनपुट और आउटपुट के बीच संबंध x के अलग-अलग मानों पर बदलता है। लिनियर रिग्रेशन मानता है कि यह बदलाव स्थिर है। पॉलीनॉमियल रिग्रेशन ऐसा नहीं मानता।
यह कहा, पॉलीनॉमियल रिग्रेशन कोई जादुई हल नहीं है।
यह तब सबसे अच्छा काम करता है जब डोमेन ज्ञान वक्र संबंध का इशारा करता है, या जब आपका रेजिड्युअल प्लॉट स्पष्ट रूप से ऐसा पैटर्न दिखाता है जिसे सीधी रेखा ठीक नहीं कर सकती। किसी खास समस्या के लिए इसे अपनाएँ—सिर्फ इसलिए नहीं कि आपके लिनियर मॉडल का R² काफी ऊँचा नहीं है।
पॉलीनॉमियल रिग्रेशन का बुनियादी गणित जानना इसे बेहतर समझने में मदद करेगा।
लिनियर रिग्रेशन में आपका मॉडल कुछ ऐसा दिखता है:
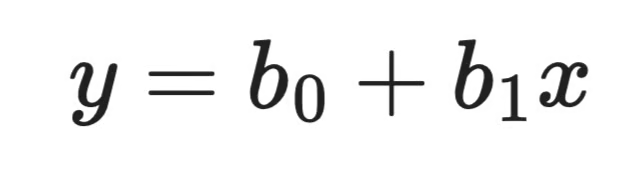
लिनियर रिग्रेशन फार्मूला
यह एक इनपुट वेरिएबल, एक गुणांक, एक सीधी रेखा है। पॉलीनॉमियल रिग्रेशन उच्च-घात के टर्म जोड़कर इसे आगे बढ़ाता है:
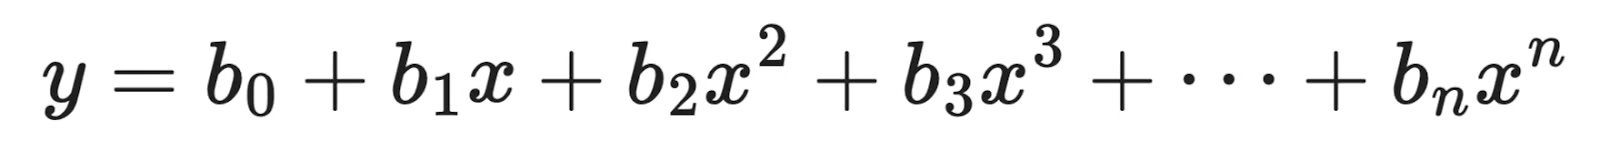
पॉलीनॉमियल रिग्रेशन फार्मूला
हर नया टर्म—x², x³, आदि—मॉडल को एक और "मोड़" देता है। डिग्री-2 पॉलीनॉमियल एकल वक्र फिट कर सकता है। डिग्री-3 पॉलीनॉमियल ऐसा वक्र फिट कर सकता है जिसकी दिशा एक बार बदलती है। डिग्री n मॉडल के लचीलेपन को नियंत्रित करती है।
अंतर्निहित एल्गोरिदम वही रहता है। आप बस नए फीचर जोड़ते हैं। x² को एक स्वतंत्र इनपुट वेरिएबल की तरह ही ट्रीट किया जाता है, जैसे x। मॉडल अब भी एक रैखिक समीकरण ही फिट करता है—बस ट्रांसफॉर्म किए गए फीचर पर।
पॉलीनॉमियल रिग्रेशन फिट करना लिनियर रिग्रेशन जैसा ही होता है—यानी least squares estimation से।
विचार यह है कि ऐसे गुणांक खोजे जाएँ जो वर्ग अवशेषों के योग को न्यूनतम करें:
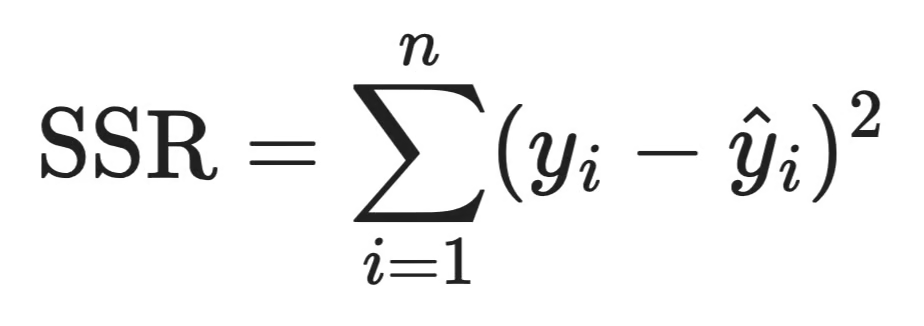
SSR फार्मूला
हर वर्गांतर (स्क्वेयर्ड डिफरेंस) एक रेजिड्युअल है—मॉडल की भविष्यवाणी और प्रेक्षित मान के बीच का अंतर। उन्हें वर्ग करने से नकारात्मक और सकारात्मक त्रुटियाँ एक-दूसरे को रद्द नहीं करतीं, और बड़ी त्रुटियों को छोटी त्रुटियों की तुलना में अधिक दंड मिलता है।
व्यवहार में, आपकी लाइब्रेरी यह आपके लिए संभाल लेती है। पर यह जानना कि least squares उद्देश्य है, समझने में मदद करता है कि आउटलायर पॉलीनॉमियल मॉडलों को इतना क्यों नुकसान पहुँचाते हैं—एक बड़ा रेजिड्युअल वर्ग होकर गुणांकों को अपनी दिशा में खींच लेता है।
लिनियर रिग्रेशन में b1 की सरल व्याख्या होती है: x में हर एक इकाई वृद्धि पर y में b1 का बदलाव आता है।
पॉलीनॉमियल रिग्रेशन थोड़ा जटिल है। जब आपके मॉडल में b_1x + b_2x^2 शामिल हों, तो x का y पर प्रभाव वर्तमान x के मान पर निर्भर करता है—आप b2 को अलग-थलग पढ़कर निष्कर्ष नहीं निकाल सकते। वक्र का ढलान लगातार बदलता है, जिसे आप x के सापेक्ष अवकलज लेकर देख सकते हैं:
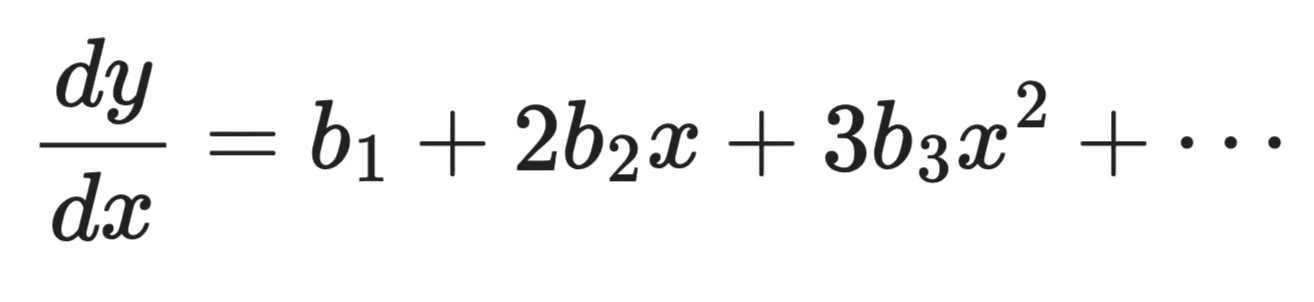
x के सापेक्ष अवकलज
ढलान स्वयं x का फलन है। यानी x में एक इकाई बदलाव का प्रभाव वक्र के हर बिंदु पर अलग होता है।
इसीलिए पॉलीनॉमियल मॉडल में व्यक्तिगत गुणांकों की व्याख्या करने की कोशिश नहीं करनी चाहिए। इसके बजाय, पूरे वक्र को देखें। अपनी भविष्यवाणियों को अपने डेटा के विरुद्ध प्लॉट करें।
पॉलीनॉमियल रिग्रेशन कई क्षेत्रों में दिखता है क्योंकि वास्तविक डेटा में वक्र संबंध हर जगह हैं।
वित्तीय डेटा शायद ही कभी सीधी रेखा में चलता है।
एसेट कीमतें, राजस्व वृद्धि, और डिमांड कर्व अक्सर बाज़ार स्थितियों के आधार पर तेज़ी, मंदी, या दिशा-परिवर्तन दिखाते हैं। लिनियर मॉडल स्थिर परिवर्तन-दर मानता है, जो लगभग कभी सही नहीं होता। पॉलीनॉमियल रिग्रेशन इन बदलावों को मॉडल करने देता है—जैसे, कैसे उपभोक्ता मांग पहले धीरे-धीरे गिरती है, फिर किसी खास कीमत से आगे तेज़ी से।
यह समय के साथ ट्रेंड विश्लेषण में भी उपयोगी है। जब आप ऐतिहासिक कीमत डेटा पर वक्र फिट कर रहे हों, या किसी मीट्रिक की वृद्धि को बिज़नेस साइकिल के अलग-अलग चरणों में मॉडल कर रहे हों, तो डिग्री-2 या डिग्री-3 पॉलीनॉमियल अक्सर सीधी रेखा से कहीं बेहतर आकार का अनुमान लगाता है।
भौतिक प्रक्रियाएँ नॉन-लिनियर संबंधों के बेहतरीन उदाहरण हैं।
सामग्री में स्ट्रेस और स्ट्रेन, द्रव गतिकी, थर्मल एक्सपैंशन, और एयरोडायनामिक ड्रैग सभी रेखाओं नहीं, वक्रों का अनुसरण करते हैं। भौतिकी में कई शासक समीकरण स्वभाव से पॉलीनॉमियल होते हैं। जब आपके पास मापन हैं पर कोई साफ, क्लोज़्ड-फॉर्म समीकरण नहीं, तो पॉलीनॉमियल रिग्रेशन उन वक्रों को डेटा-आधारित तरीके से फिट करने देता है।
एक अच्छा उदाहरण ड्रैग फोर्स है, जो वेग के वर्ग के साथ बढ़ता है। लिनियर मॉडल उच्च गति पर ड्रैग को कम आँकेगा, जबकि डिग्री-2 पॉलीनॉमियल संबंध को ठीक से फिट करेगा।
मशीन लर्निंग में, पॉलीनॉमियल रिग्रेशन अक्सर एक स्टैंडअलोन मॉडल के बजाय फीचर इंजीनियरिंग तकनीक के रूप में उपयोग होता है।
पॉलीनॉमियल टर्म—x², x³, इंटरेक्शन टर्म—जोड़कर, आप एक लिनियर मॉडल को नॉन-लिनियर पैटर्न फिट करने की क्षमता देते हैं, बिना अधिक जटिल एल्गोरिदम अपनाए। जब आपका लिनियर मॉडल अंडरफिट करता हो और आप डिसीज़न ट्री या न्यूरल नेटवर्क जैसा कुछ लेने से पहले लचीलापन जोड़ना चाहें, तो यह एक आम पहला कदम है।
यह एक बेसलाइन मॉडल के रूप में भी उपयोगी है।
किसी जटिल मॉडल को ट्रेन करने से पहले, पॉलीनॉमियल रिग्रेशन फिट करके आप देख सकते हैं कि एक साधारण वक्र डेटा की वैरिएंस का कितना हिस्सा समझा देता है। यदि डिग्री-3 पॉलीनॉमियल ही आपको अधिकांश रास्ता तय करा दे, तो शायद आपको कुछ और जटिल चीज़ की ज़रूरत नहीं।
अपने पॉलीनॉमियल की डिग्री चुनना सबसे महत्वपूर्ण फैसलों में एक है। यदि आप इसे किसी भी दिशा में ग़लत चुनते हैं, तो आपका मॉडल कम सटीक होगा।
अच्छी बात यह है कि कुछ पंक्तियों के Python कोड से काम हो जाता है।
अंडरफिटिंग तब होती है जब आपकी डिग्री बहुत कम हो। वक्र डेटा पर डिग्री-1 पॉलीनॉमियल पैटर्न चूक देगा—उच्च बायस, खराब भविष्यवाणियाँ, और ट्रेनिंग तथा नए दोनों डेटा पर कमजोर प्रदर्शन।
ओवरफिटिंग उलटी समस्या है, और अधिक खतरनाक क्योंकि शुरुआत में अच्छा दिखता है। उच्च-डिग्री पॉलीनॉमियल ट्रेनिंग सेट के हर डेटा पॉइंट से लगभग-शून्य त्रुटि के साथ गुजर सकता है। पर मॉडल बस शोर याद कर रहा होता है। नया डेटा आते ही वह बिखर जाएगा।
आप इसे विभिन्न डिग्रियों पर ट्रेनिंग त्रुटि बनाम टेस्ट त्रुटि की तुलना करके देख सकते हैं:
import numpy as np
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import train_test_split

np.random.seed(42)

# Generate sample data
x = np.linspace(-3, 3, 80).reshape(-1, 1)
y = 0.6 * x.ravel()**2 - x.ravel() + np.random.normal(0, 0.6, 80)

x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.25)

for deg in [1, 2, 12]:
    poly = PolynomialFeatures(deg)
    model = LinearRegression()
    model.fit(poly.fit_transform(x_train), y_train)

    train_err = mean_squared_error(y_train, model.predict(poly.transform(x_train)))
    test_err  = mean_squared_error(y_test,  model.predict(poly.transform(x_test)))

    print(f"Degree {deg:>2} | Train MSE: {train_err:.4f} | Test MSE: {test_err:.4f}")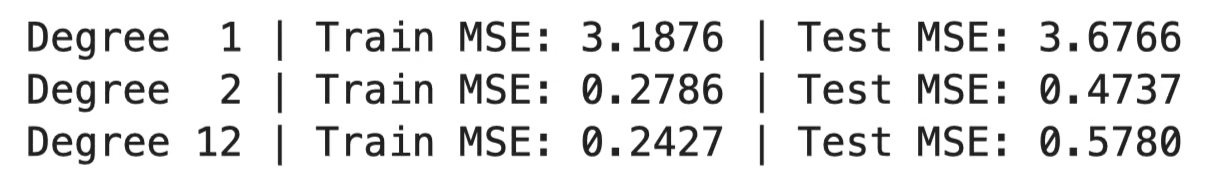
विभिन्न डिग्रियों पर MSE
या, दृश्य रूप में प्रस्तुत:
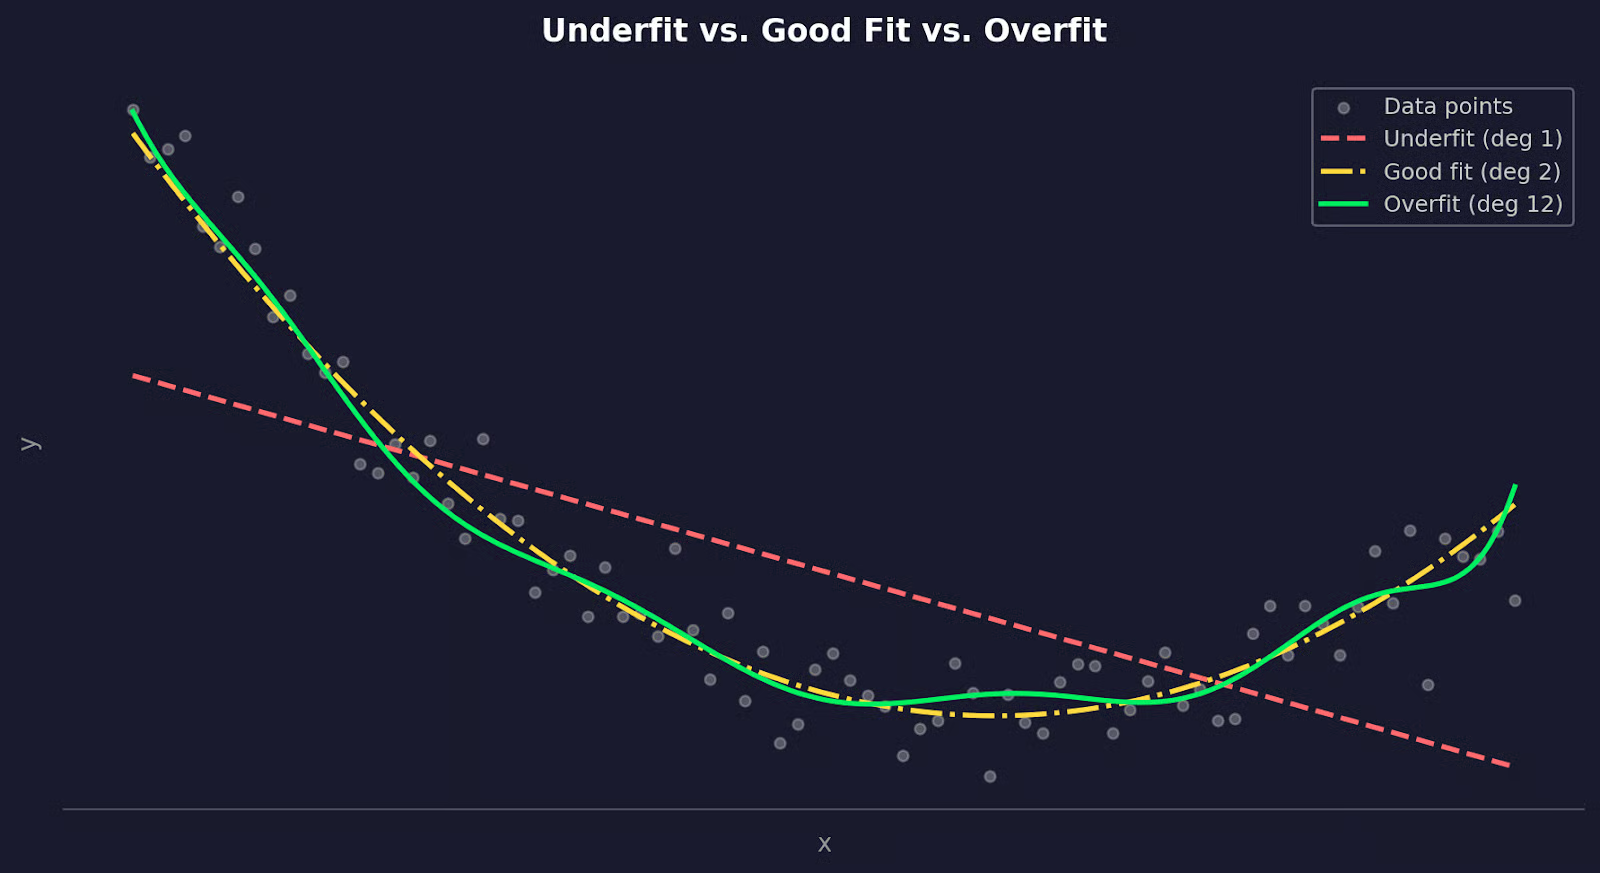
अलग-अलग पॉलीनॉमियल डिग्री के साथ डेटा फिट
डिग्री 1 दोनों सेट पर उच्च त्रुटि दिखाता है—यह अंडरफिटिंग है। डिग्री 2 संतुलित है। डिग्री 12 में ट्रेनिंग त्रुटि कम पर टेस्ट त्रुटि बहुत अधिक—यह ओवरफिटिंग है।
सबसे अच्छी डिग्री खोजने का सही तरीका क्रॉस-वैलिडेशन—विशेषकर, k-fold क्रॉस-वैलिडेशन—है।
विचार यह है कि अपने डेटा को k उपसमूहों में बाँटें, फिर k-1 पर ट्रेन करें और एक को होल्ड-आउट टेस्ट के रूप में रखें, और तब तक दोहराएँ जब तक हर उपसमूह एक बार टेस्ट सेट न बन जाए। अंत में, सभी फोल्ड्स पर त्रुटि का औसत लें, और प्रत्येक प्रत्याशी डिग्री के लिए ऐसा करें तथा जिस डिग्री का औसत टेस्ट त्रुटि सबसे कम हो उसे चुनें।
इम्प्लीमेंटेशन समझाने से सरल है:
import numpy as np
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import make_pipeline
import matplotlib.pyplot as plt

np.random.seed(42)

# Generate sample data
x = np.linspace(-3, 3, 80).reshape(-1, 1)
y = 0.6 * x.ravel()**2 - x.ravel() + np.random.normal(0, 0.6, 80)

# Test degrees 1 through 10
degrees = range(1, 11)
mean_errors = []

for deg in degrees:
    model = make_pipeline(PolynomialFeatures(deg), LinearRegression())
    scores = cross_val_score(model, x, y, cv=5, scoring="neg_mean_squared_error")
    mean_errors.append(-scores.mean())
    print(f"Degree {deg:>2} | Mean error: {-scores.mean():.4f}")

best_degree = np.argmin(mean_errors) + 1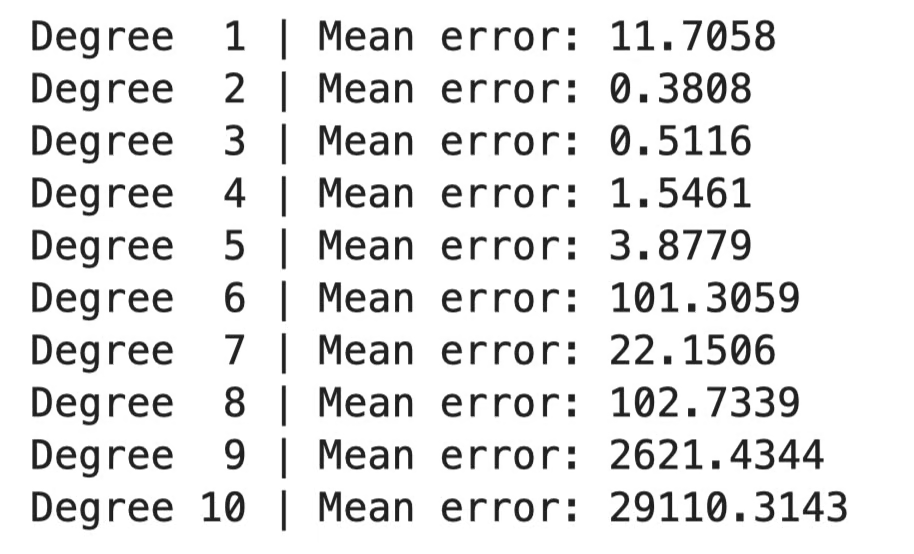
डिग्री त्रुटि तुलना
या, दृश्य रूप में दर्शाया गया:
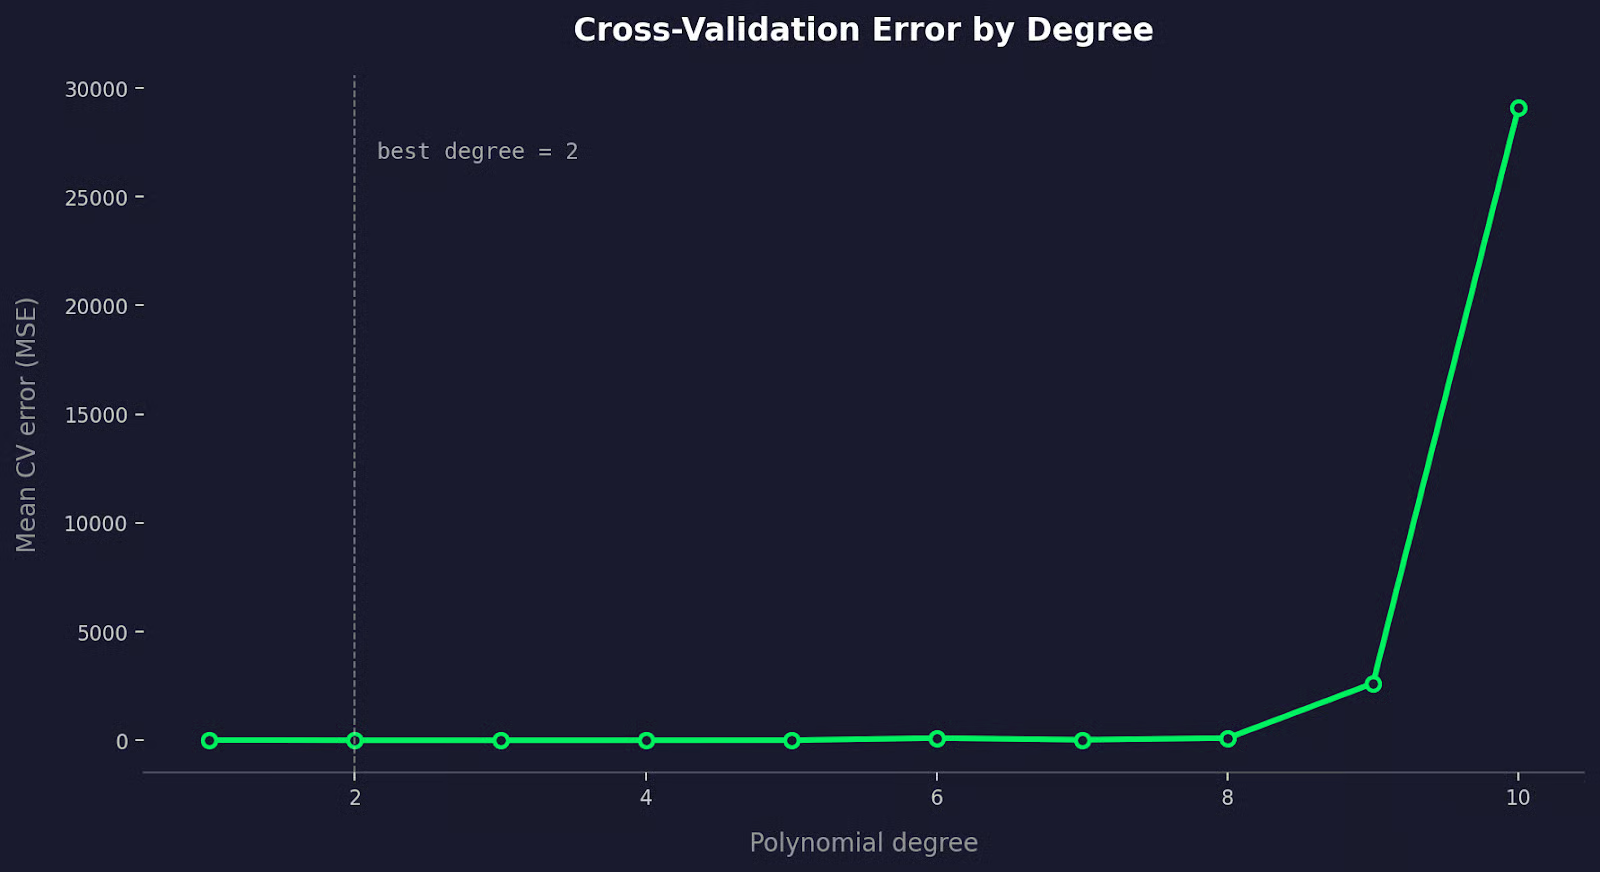
क्रॉस-वैलिडेशन त्रुटि तुलना
उपयोगी पॉलीनॉमियल टर्म जोड़ते ही CV त्रुटि गिरती है, फिर मॉडल के ओवरफिट होने लगते ही फिर बढ़ती है।
जब दो डिग्रियाँ समान CV त्रुटि दें, तो कम वाली चुनें। जो सरल मॉडल उतना ही अच्छा प्रदर्शन करता है, वह हमेशा बेहतर विकल्प है।
ऐसे कुछ तरीके हैं जिनसे पॉलीनॉमियल रिग्रेशन आपको गलत नतीजों तक ले जा सकता है। आइए उन पर नज़र डालते हैं।
पॉलीनॉमियल रिग्रेशन आउटलायर के प्रति लिनियर रिग्रेशन से ज्यादा संवेदनशील है।
लीस्ट स्क्वेर्स हर रेजिड्युअल का वर्ग लेकर जोड़ता है। ट्रेंड से बहुत दूर एक अकेला डेटा पॉइंट असंगत रूप से बड़ी त्रुटि देता है, और मॉडल उस त्रुटि को घटाने के लिए अपने वक्र को मोड़ देगा—भले ही इसका मतलब बाकी जगह फिटिंग बिगाड़ना हो।
डिग्री बढ़ने के साथ यह प्रभाव बदतर होता है। उच्च-डिग्री पॉलीनॉमियल में इतना लचीलापन होता है कि वह आउटलायर का पीछा करने लगे, और एक खराब पॉइंट को फिट करने के लिए वक्र को आपके अधिकांश डेटा से दूर खींच दे।
इससे निपटने का तरीका है, फिट करने से पहले अपने डेटा को साफ करें। डेटा प्लॉट करें, आउटलायर पहचानें, और तय करें कि वे वास्तविक संकेत हैं या शोर। यदि वे शोर हैं—मापन त्रुटियाँ, डेटा एंट्री की गलतियाँ, करप्ट रिकॉर्ड—तो उन्हें हटाएँ। यदि वे वास्तविक हैं, तो RANSAC या Huber रिग्रेशन जैसी अधिक आउटलायर-प्रतिरोधी फिटिंग पद्धति पर विचार करें।
जब भी आप एक पॉलीनॉमियल टर्म जोड़ते हैं, आप मॉडल को अधिक लचीलापन देते हैं। एक बिंदु पर यह लचीलापन मदद करना बंद कर देता है, और मॉडल वास्तविक पैटर्न की जगह ट्रेनिंग डेटा के रैंडम शोर को फिट करने लगता है। नतीजा ऐसा वक्र है जो ट्रेनिंग डेटा पर अच्छा और नए डेटा पर खराब प्रदर्शन करता है।
पेचिदगी यह है कि केवल ट्रेनिंग त्रुटि देखने पर ओवरफिटिंग अदृश्य रहती है। डिग्री-10 पॉलीनॉमियल का ट्रेनिंग MSE लगभग हमेशा डिग्री-2 पॉलीनॉमियल से कम होगा। इसका अर्थ यह नहीं कि वह बेहतर मॉडल है।
इसे ऐसे अप्रोच करें:
पॉलीनॉमियल रिग्रेशन तब सबसे अच्छा काम करता है जब आपके पास वक्र संबंध की उचित वजह हो, और आप डिग्री को पर्याप्त कम रख सकें।
पॉलीनॉमियल रिग्रेशन हमेशा सही औज़ार नहीं—इनमें से कुछ विकल्प आपके लिए अधिक उपयुक्त हो सकते हैं, pun अभिप्रेत।
स्प्लाइन्स ग्लोबल अस्थिरता की समस्या हल करते हैं।
जब आप डिग्री-10 पॉलीनॉमियल फिट करते हैं, तो हर गुणांक पर हर डेटा पॉइंट का प्रभाव पड़ता है। आपके डेटा के एक हिस्से में बदलाव पूरे वक्र को प्रभावित करता है। स्प्लाइन्स आपका डेटा खंडों में बाँटकर प्रत्येक पर अलग कम-डिग्री पॉलीनॉमियल फिट करके इससे बचते हैं। खंडों को नॉट्स कहलाने वाले बिंदुओं पर जोड़ा जाता है, और जोड़ पर वक्र को स्मूथ बनाए रखने के लिए बाधाएँ लगाई जाती हैं।
नतीजा ऐसा वक्र होता है जो जहाँ ज़रूरत हो वहाँ लचीला और बाकी जगह स्थिर रहता है।
Python में, scipy और scikit-learn दोनों में स्प्लाइन के अच्छे इम्प्लीमेंटेशन हैं:
from scipy.interpolate import UnivariateSpline

spline = UnivariateSpline(x, y, k=3)
y_pred = spline(x_new)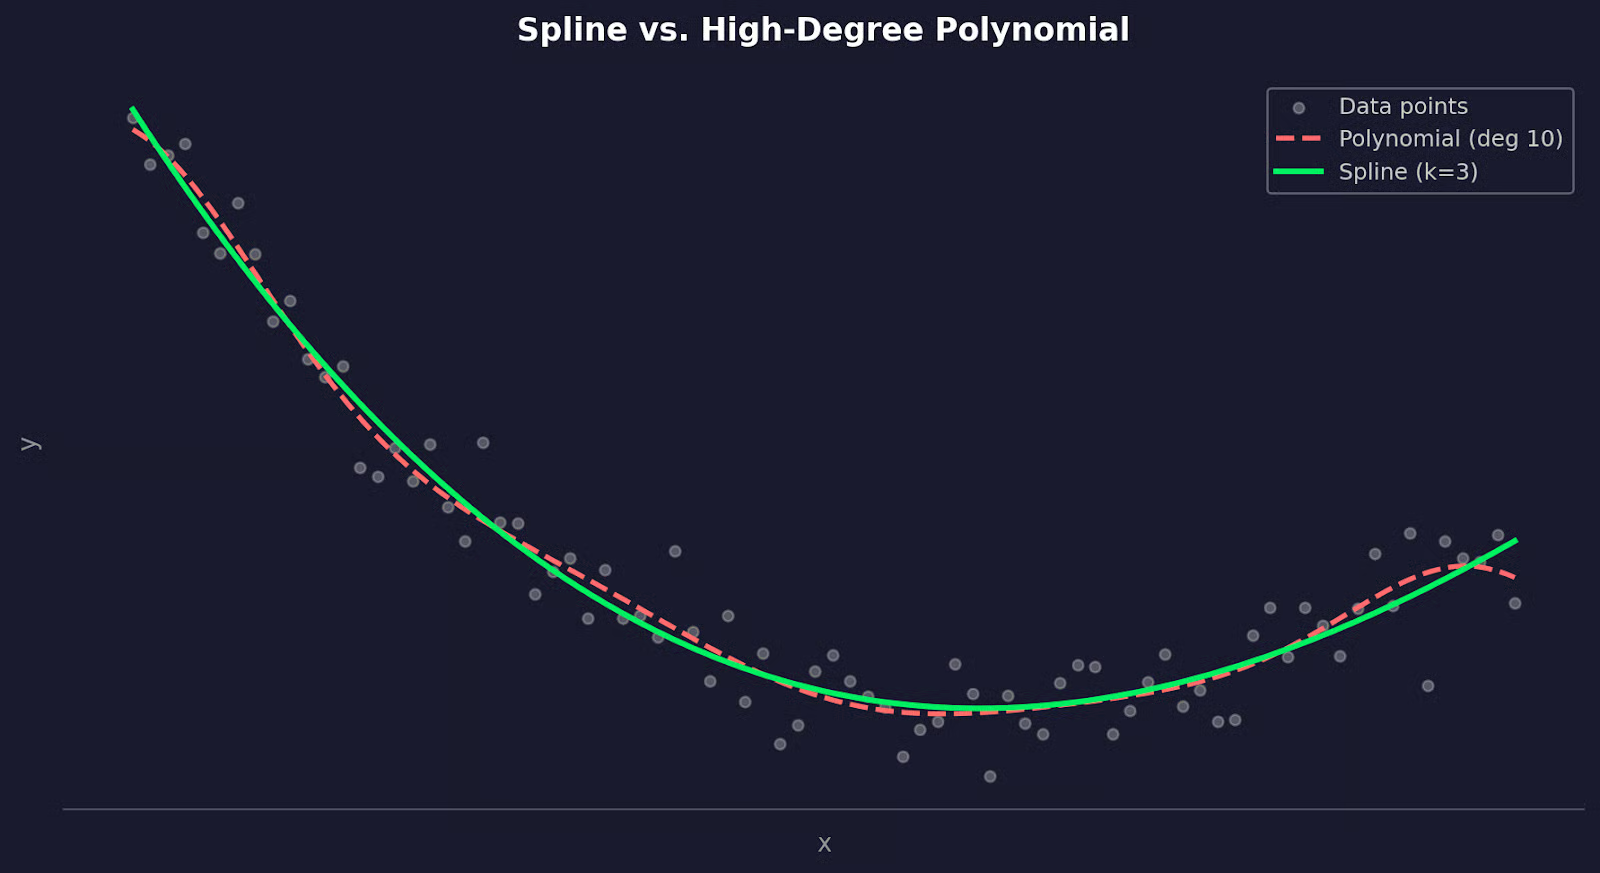
स्प्लाइन बनाम उच्च-डिग्री पॉलीनॉमियल
फिर से कहें, जब आपके डेटा का व्यवहार अलग-अलग क्षेत्रों में अलग हो, या जब एक ही पॉलीनॉमियल वक्र उच्च डिग्री पर जाए बिना आकार को पकड़ न पाए, तो स्प्लाइन्स अपनाएँ।
सपोर्ट वेक्टर रिग्रेशन (SVR) अलग तरीका अपनाता है।
यह सभी बिंदुओं पर वर्ग त्रुटि को न्यूनतम करने वाला वक्र फिट नहीं करता, बल्कि ऐसी फ़ंक्शन ढूँढता है जो अधिकतम बिंदुओं के लिए एक परिभाषित त्रुटि-मार्जिन के भीतर रहे, और उस मार्जिन के भीतर आने वाले बिंदुओं को नज़रअंदाज़ करे। इससे यह पॉलीनॉमियल रिग्रेशन की तुलना में आउटलायर के प्रति कम संवेदनशील हो जाता है।
पॉलीनॉमियल रिग्रेशन से इसका संबंध कर्नेल ट्रिक के ज़रिए आता है। पॉलीनॉमियल कर्नेल वाला SVR, पॉलीनॉमियल रिग्रेशन जैसा ही नॉन-लिनियर संबंध फिट कर सकता है—लेकिन बेहतर जनरलाइज़ेशन और रेग्युलराइज़ेशन पैरामीटरों के ज़रिए फिट पर अधिक नियंत्रण के साथ।
from sklearn.svm import SVR

model = SVR(kernel="poly", degree=3, C=1.0, epsilon=0.1)
model.fit(x_train, y_train)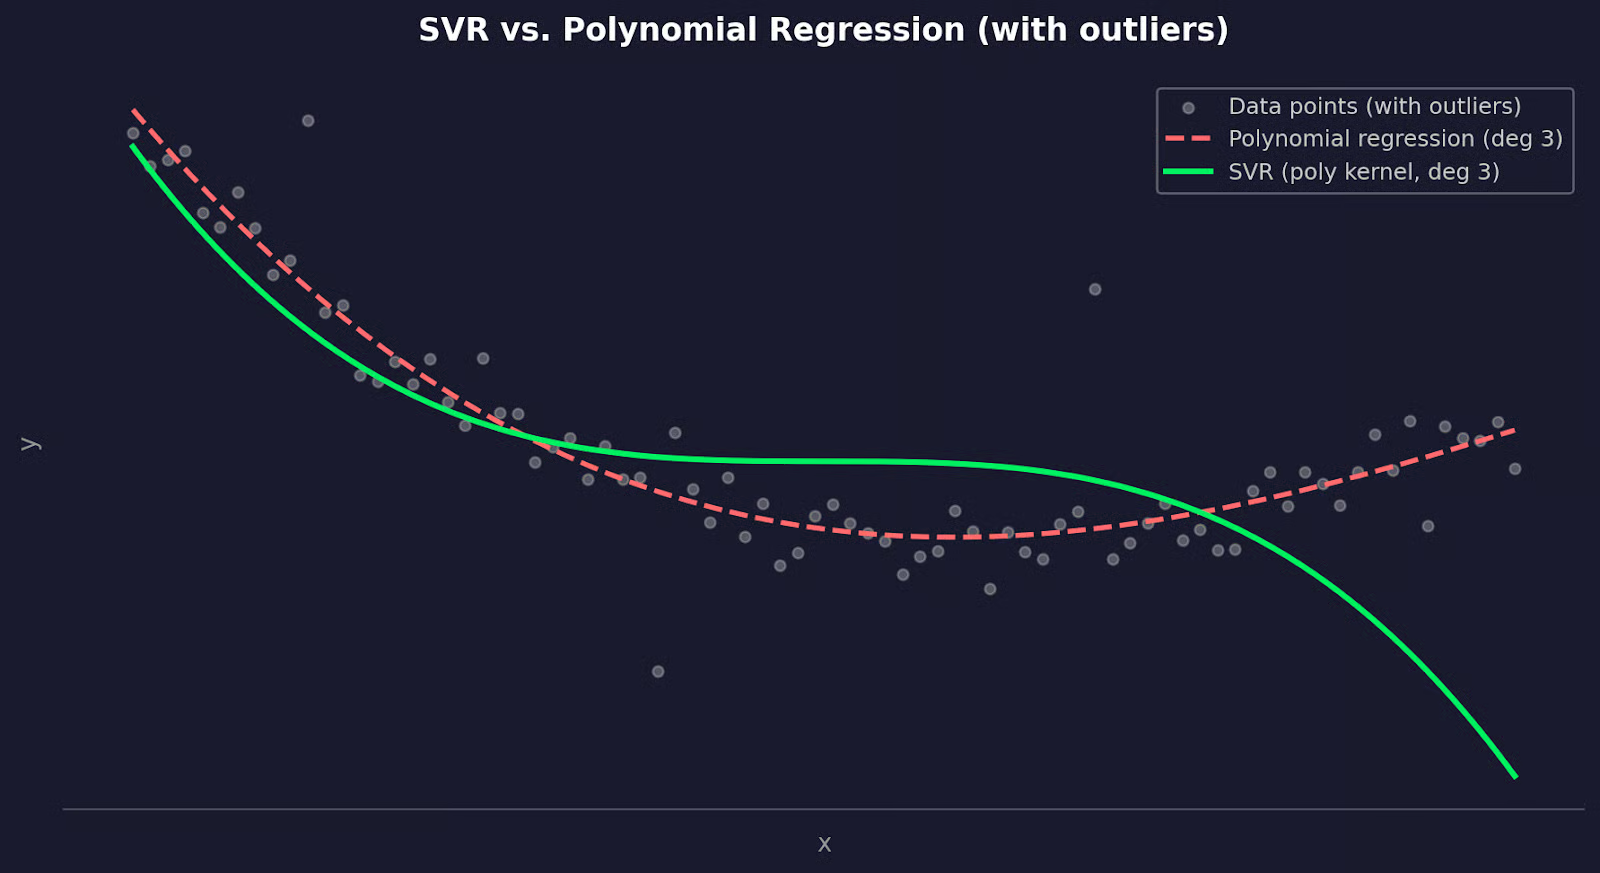
SVR बनाम उच्च-डिग्री पॉलीनॉमियल
जब आपके डेटा में ऐसे आउटलायर हों जिन्हें आप हटा नहीं सकते, जब आपको बायस-वैरिएंस संतुलन पर अधिक नियंत्रण चाहिए, या जब क्रॉस-वैलिडेशन के बावजूद पॉलीनॉमियल रिग्रेशन बार-बार ओवरफिट कर रहा हो—तब SVR अच्छा विकल्प है।
इस लेख में, मैंने दिखाया कि यह कैसे लिनियर रिग्रेशन का विस्तार कर वक्र फिट करता है, कैसे लीस्ट स्क्वेर्स एस्टिमेशन सर्वोत्तम गुणांक खोजता है, और क्यों उन गुणांकों की अलग-अलग व्याख्या बहुत अर्थपूर्ण नहीं होती।
आपके द्वारा चुनी गई डिग्री सबसे अधिक मायने रखती है। बहुत कम होने पर अंडरफिटिंग, और बहुत अधिक होने पर ओवरफिटिंग। क्रॉस-वैलिडेशन आपको मीठा बिंदु (स्वीट स्पॉट) वस्तुनिष्ठ रूप से ढूँढने देता है। और यदि पॉलीनॉमियल रिग्रेशन सही फिट नहीं बैठता, तो स्प्लाइन्स और SVR जानने लायक ठोस विकल्प हैं।
इन सबकी समझ बनाने का सबसे अच्छा तरीका है इसे अपने डेटा पर आज़माना। ऐसा डेटासेट चुनें जिसमें आपको नॉन-लिनियर संबंध का संदेह हो, पहले एक लिनियर मॉडल फिट करें, रेजिड्युअल प्लॉट करें, और देखें कि पॉलीनॉमियल रिग्रेशन क्या अलग करता है। हमारे गाइड Non-Linear Models and Insights Using R को पढ़ें और इस पाइपलाइन को क्रिया में देखें।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स