

学习路径
开发 AI 应用程序
21 小时
实践并学习路径你的进步。
使用 Google 继续Microsoft 的RStar-math 论文提出了一种将强化学习、符号推理与蒙特卡罗树搜索(MCTS)相结合来解决数学问题的创新方法。
在这篇博客中,我将介绍 RStar 框架及其核心组件。随后,我会带您一步步完成一个使用 Gradio 演示关键概念的简化实现。尽管本演示受论文启发,但为便于上手,我们对部分复杂点做了简化。
RStar-math 致力于将符号推理与预训练神经模型的泛化能力相结合。该框架整合了蒙特卡罗树搜索(MCTS)、预训练语言模型以及强化学习 等组件,以高效探索解题策略。
其核心思想是将数学推理表示为在一个结构化的、由可能步骤构成的树上进行搜索的过程,其中每个节点表示一个部分解或状态。
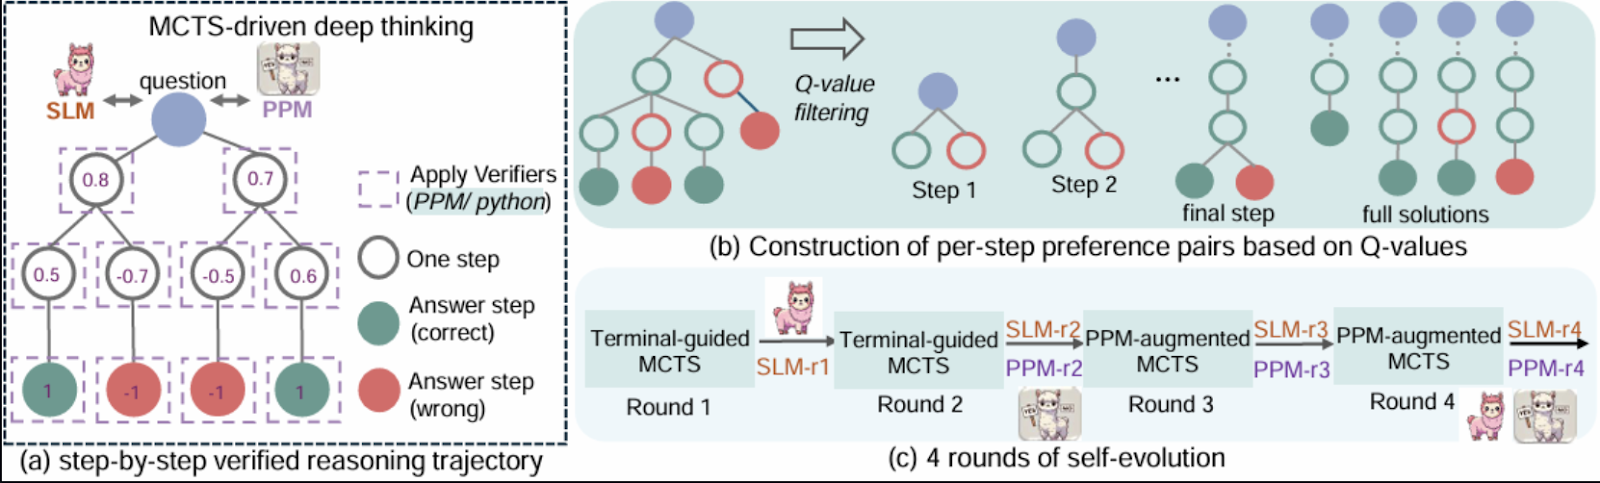
来源:Guan 等,2025
让我对 rStar-Math 特别感兴趣的一些原因包括:
该演示展示了策略模型与奖励模型如何结合 sympy 库进行符号推理,以结构化方式解决数学问题。此实现的关键特性包括:
为保持演示简洁聚焦,论文中提到的部分高级功能超出了本教程范围。这些功能包括:
该演示由多个组件组成,分别对应 RStar 方法论的不同部分。开始前,请确保已安装以下内容:
pip install requests gradio, sympy 然后,导入这些库:
import gradio as gr
import numpy as np
import torch
import re
import torch.nn as nn
import torch.optim as optim
from sympy import symbols, Eq, solve, N, sin, cos, tan, exp, log, E, sympify
from random import choice
依赖安装完成后,我们来设置主要组件。
这些网络是论文中模型的轻量版本,用于预测下一步动作与评估成功与否。策略模型预测解给定方程所需的下一步,采用前馈神经网络处理问题的编码表示。
同样,奖励模型评估部分解以引导 MCTS 过程。两个模型均使用 PyTorch 实现。
class PolicyModel(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.fc1 = nn.Linear(input_size, hidden_size)
        self.fc2 = nn.Linear(hidden_size, output_size)
        self.relu = nn.ReLU()
    def forward(self, x):
        x = self.relu(self.fc1(x))
        x = self.fc2(x)
        return x
class RewardModel(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.fc1 = nn.Linear(input_size, hidden_size)
        self.fc2 = nn.Linear(hidden_size, output_size)
        self.relu = nn.ReLU()
    def forward(self, x):
        x = self.relu(self.fc1(x))
        x = self.fc2(x)
        return x
接下来,我们为 MCTS 树构建一个节点类。
TreeNode 类表示 MCTS 树中的节点。每个节点对应搜索过程中的一个状态,包含:
class TreeNode:
    """Represents a node in the MCTS tree."""
    def __init__(self, state, parent=None):
        self.state = state  # Current state
        self.parent = parent
        self.children = []
        self.visits = 0
        self.q_value = 0.0  # Accumulated rewards
    def is_fully_expanded(self):
        return len(self.children) > 0
    def best_child(self, exploration_weight=1.4):
        """Select the best child using UCT formula."""
        def uct_value(child):
            return (child.q_value / (child.visits + 1e-6)) + exploration_weight * np.sqrt(np.log(self.visits + 1) / (child.visits + 1e-6))
        return max(self.children, key=uct_value)
    def add_child(self, child_state):
        """Add a child node with the given state."""
        child = TreeNode(state=child_state, parent=self)
        self.children.append(child)
        return child
至此我们已有基本结构,接下来进入演示的核心组件。
MathSolver 类是演示的核心,将符号推理与神经引导搜索结合。它实现了若干关键组件:
PolicyModel 预测解方程的下一步,而 RewardModel 评估部分或完整解的成功程度。
class MathSolver:
    def __init__(self, dataset=None):
        self.dataset = dataset or []  # Dataset of math problems
        self.policy_model = PolicyModel(input_size=128, hidden_size=64, output_size=4)
        self.reward_model = RewardModel(input_size=128, hidden_size=64, output_size=1)
        self.policy_optimizer = optim.Adam(self.policy_model.parameters(), lr=0.001)
        self.reward_optimizer = optim.Adam(self.reward_model.parameters(), lr=0.001)
        self.execution_context = {}
上述方法通过设置求解数学问题所需的组件来初始化 MathSolver 类。它可选地接收一个数学问题数据集,并初始化两个神经网络:用于预测下一步动作的策略模型,以及用于评估动作成败的奖励模型。
我们已具备策略与奖励函数。接下来,需要解析并编码输入方程。
使用 sympy 解析方程,并将其编码为特征向量,供策略与奖励模型处理。
def encode_problem(self, problem):
 # Advanced encoding using symbolic representation and problem length
     variables = len(re.findall(r'[a-zA-Z]', problem))
     operators = len(re.findall(r'[\+\-\*/\^]', problem))
      problem_length = len(problem)
      return np.array([variables, operators, problem_length] + [0] * 125)
encode_problem 方法将数学问题转换为固定大小的数值表示,供模型使用。它提取诸如变量数量、运算符数量和问题长度等特征,并编码为一个 128 维的 NumPy 数组。该表示捕捉了问题的结构,便于模型有效处理。
以下代码生成求解给定方程的下一步,包括定义变量、创建方程和进行求解。
def policy_model_predict(self, equation1, equation2=None):
    try:
        equations = []
        if equation1:
            equations.append(sympify(equation1.strip()))  # Sympify only equations
        if equation2:
            equations.append(sympify(equation2.strip()))
        all_variables = set()
        for eq in equations:
            all_variables.update(eq.free_symbols)
        var_definitions = [f"{v} = symbols('{v}')" for v in all_variables]
        steps = [
            ("Define variables", "\n".join(var_definitions)),
            ("Define equation(s)", f"equations = {equations}"),
            ("Solve equation(s)", f"solution = solve(equations, {list(all_variables)})"),
            ("Print solution", "print(solution)")
        ]
        return steps
    except Exception as e:
        print(f"Error during policy model prediction: {e}")
        return []
policy_model_predict 函数使用 SymPy 的 sympify 解析输入方程,确保其为有效的数学表达式。随后识别方程中的所有变量,并使用 SymPy 的 solve 函数进行求解。该方法作为解题工作流的高层指引。
reward_model_predict 方法在强化学习中发挥关键作用,为 MCTS rollout 期间采取的动作提供反馈。
  def reward_model_predict(self, steps, success):
        encoded_steps = self.encode_problem(str(steps))
        encoded_steps = torch.tensor(encoded_steps, dtype=torch.float32)
        reward = self.reward_model(encoded_steps)
        return reward.item() if success else -reward.item()
该函数将解题步骤编码为数值格式,并通过奖励模型进行评估;成功时返回正奖励,失败时返回负奖励。此反馈用于训练策略模型,引导其优先选择有效动作并改进决策。有了策略与奖励模型的预测函数后,我们可以着手执行任务。
该方法将多变量解处理为元组或字典,并使用 SymPy 的 N 函数将符号结果转换为数值近似。
    def execute_code(self, code):
        try:
            # Ensure necessary imports and variables are in the execution context
            exec("from sympy import symbols, Eq, solve, N, sin, cos, tan, exp, log, E", self.execution_context)
            # Dynamically initialize variables in the context
            for var_def in self.execution_context.get('var_definitions', []):
                exec(var_def, self.execution_context)
            exec(code, self.execution_context)
            if "solution" in self.execution_context:
                symbolic_solution = self.execution_context["solution"]
                # Handle multi-variable solutions as tuples
                if isinstance(symbolic_solution, list):
                    self.execution_context["solution"] = [tuple(map(N, sol)) if isinstance(sol, tuple) else N(sol) for sol in symbolic_solution]
                elif isinstance(symbolic_solution, dict):
                    self.execution_context["solution"] = {k: N(v) for k, v in symbolic_solution.items()}
                else:
                    self.execution_context["solution"] = N(symbolic_solution)
            return True
        except Exception as e:
            print(f"Error executing code: {e}")
            return False
该方法确保计算准确,并灵活支持多种解的格式。如遇错误,会记录问题并返回 False,从而保证健壮的错误处理。
MCTS 方法迭代地选择最佳状态、扩展搜索树并模拟可能的解。模拟得到的回报会回传以改进决策。
def mcts(self, equation1, equation2=None, num_rollouts=10):
    root = TreeNode(state=(equation1, equation2))
    for _ in range(num_rollouts):
        # Selection
        node = root
        while node.is_fully_expanded() and node.children:
            node = node.best_child()
        # Expansion
        if not node.is_fully_expanded():
            steps = self.policy_model_predict(*node.state)
            for step, code in steps:
                child_state = (step, code)
                node.add_child(child_state)
        # Simulation
        success = True
        for step, code in steps:
            if not self.execute_code(code):
                success = False
                break
        # Backpropagation
        reward = self.reward_model_predict(steps, success)
        while node:
            node.visits += 1
            node.q_value += reward
            node = node.parent
    return root.best_child().state if root.children else None
mcts 方法迭代执行四个关键步骤:
policy_model_predict 方法创建新的子节点。reward_model_predict 计算奖励并沿树向上传播,更新节点取值。在指定次数的 rollout 后,该方法返回最佳子节点的状态,即搜索中发现的最有希望的解。
solve 方法统筹整个过程,从解析方程到执行与验证解。
def solve(self, equation1, equation2=None):
    self.execution_context = {}
    steps = self.policy_model_predict(equation1, equation2)
    variables = set()
    for eq in [equation1, equation2] if equation2 else [equation1]:
        if eq:
            variables.update(sympify(eq.strip()).free_symbols)
    self.execution_context['var_definitions'] = [f"{v} = symbols('{v}')" for v in variables]
    steps_output = ["Best solution found:"]
    for step, code in steps:
        steps_output.append(f"Step: {step}")
        steps_output.append(f"Code: {code}")
        if self.execute_code(code):
            steps_output.append("Execution successful.")
        else:
            steps_output.append("Execution failed.")
    if "solution" in self.execution_context:
        final_answer = self.execution_context["solution"]
        if isinstance(final_answer, dict):
            for var, value in final_answer.items():
                steps_output.append(f"{var} = {value}")
        elif isinstance(final_answer, list):
            for solution in final_answer:
                if isinstance(solution, tuple):
                    for idx, var in enumerate(variables):
                        steps_output.append(f"{list(variables)[idx]} = {solution[idx]}")
                else:
                    steps_output.append(f"Solution: {solution}")
        else:
            steps_output.append(f"Final Answer: {final_answer}")
    else:
        steps_output.append("No final answer found.")
    return "\n".join(steps_output)
solve 方法处理用户提供的一或两个方程:初始化执行上下文并通过 policy_model_predict 生成步骤。它依次执行每一步,记录进度并报告成功或失败。包含单变量与多变量在内的解会配合变量名与数值进行格式化展示;若未找到解,则显示相应提示。
核心组件已就绪,接下来构建 Gradio 应用。
Gradio 界面允许用户交互式输入方程(一个或多个)、求解并查看结果。
with gr.Blocks() as app:
    gr.Markdown("# Math Problem Solver with Advanced Multi-Step Reasoning and Learning")
    with gr.Row():
        equation1_input = gr.Textbox(label="Enter the first equation (e.g., x + y - 3)", placeholder="x + y - 3")
        equation2_input = gr.Textbox(label="Enter the second equation (optional, e.g., x - y - 1)", placeholder="x - y - 1")
    solve_button = gr.Button("Solve")
    solution_output = gr.Textbox(label="Solution", interactive=False)
    solve_button.click(solve_math_problem, inputs=[equation1_input, equation2_input], outputs=[solution_output])
app.launch(debug=True)
上述代码创建了一个用于高级推理解方程的 Gradio 用户界面。该界面包裹在 gr.Blocks 容器中,包含两个 gr.Textbox 输入框:一个用于输入第一个方程(必填),另一个用于输入第二个方程(可选)。
输出显示在一个名为 "Solution" 的 gr.Textbox 中。interface.launch() 命令会在浏览器中启动 Gradio 应用,debug=True 标志启用详细日志以便排错。
现在开始测试我们的数学问题求解器应用。以下是我进行的一些测试:
1. 单变量单方程: 我尝试在给定单个方程的情况下,求单个变量 x 的可能取值。
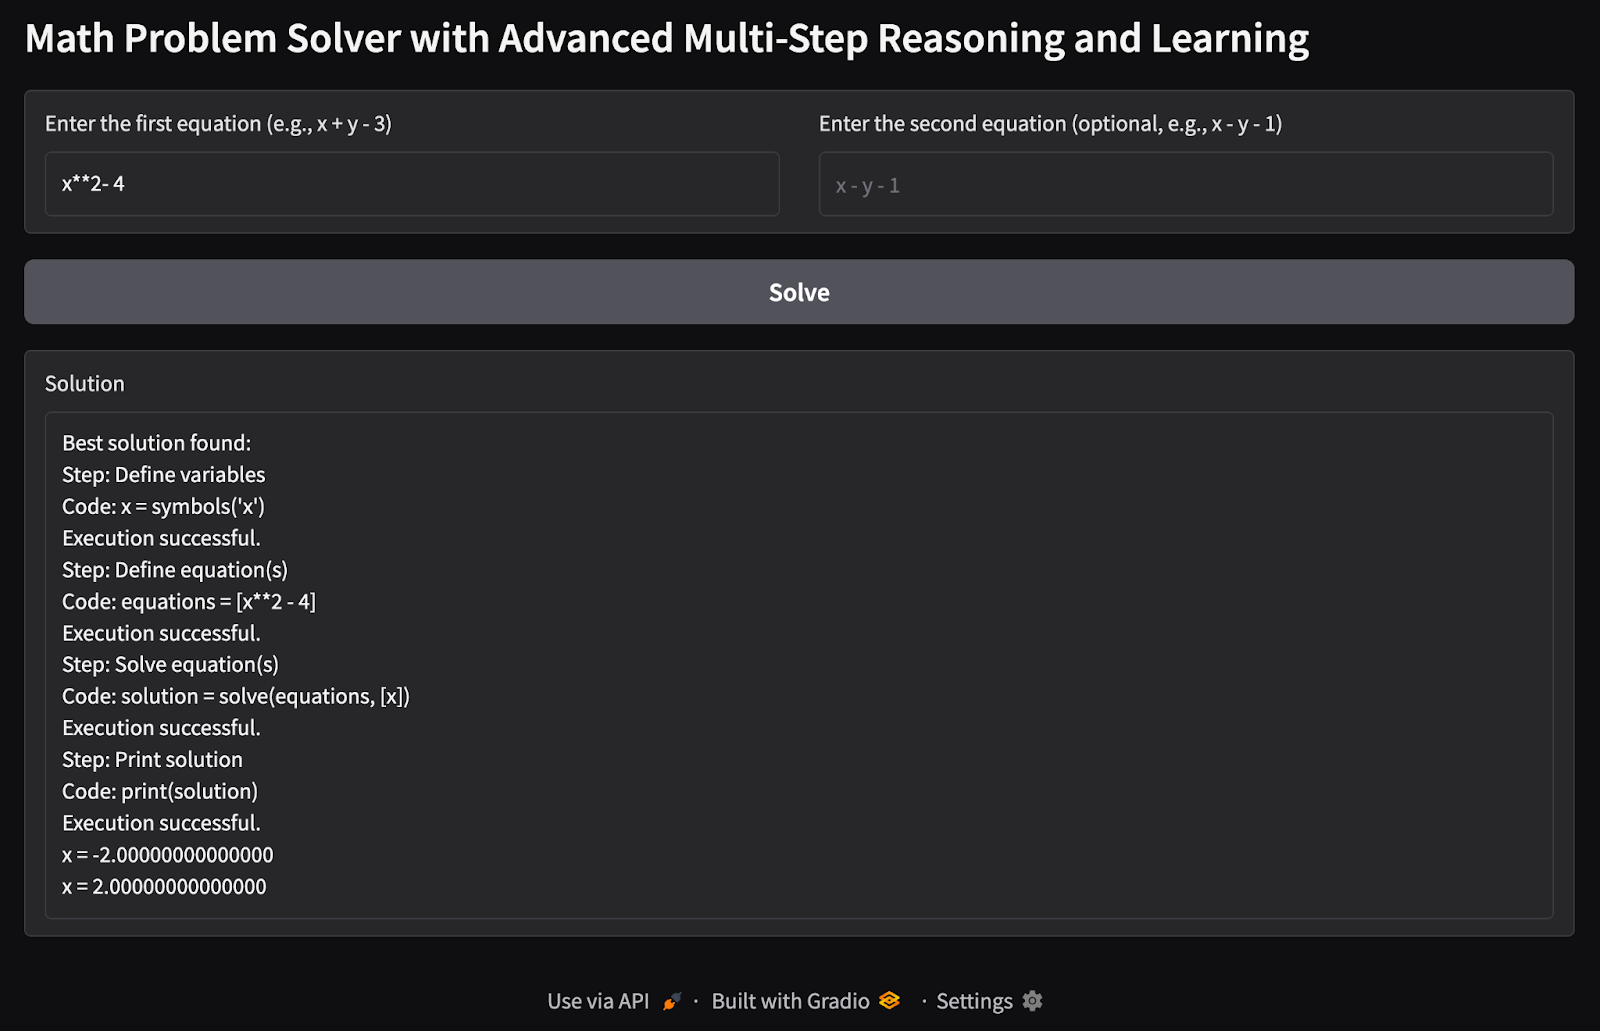
2. 多变量多方程问题: 我输入了包含两个变量的两个方程,以求变量 x 与 y 的可能取值。
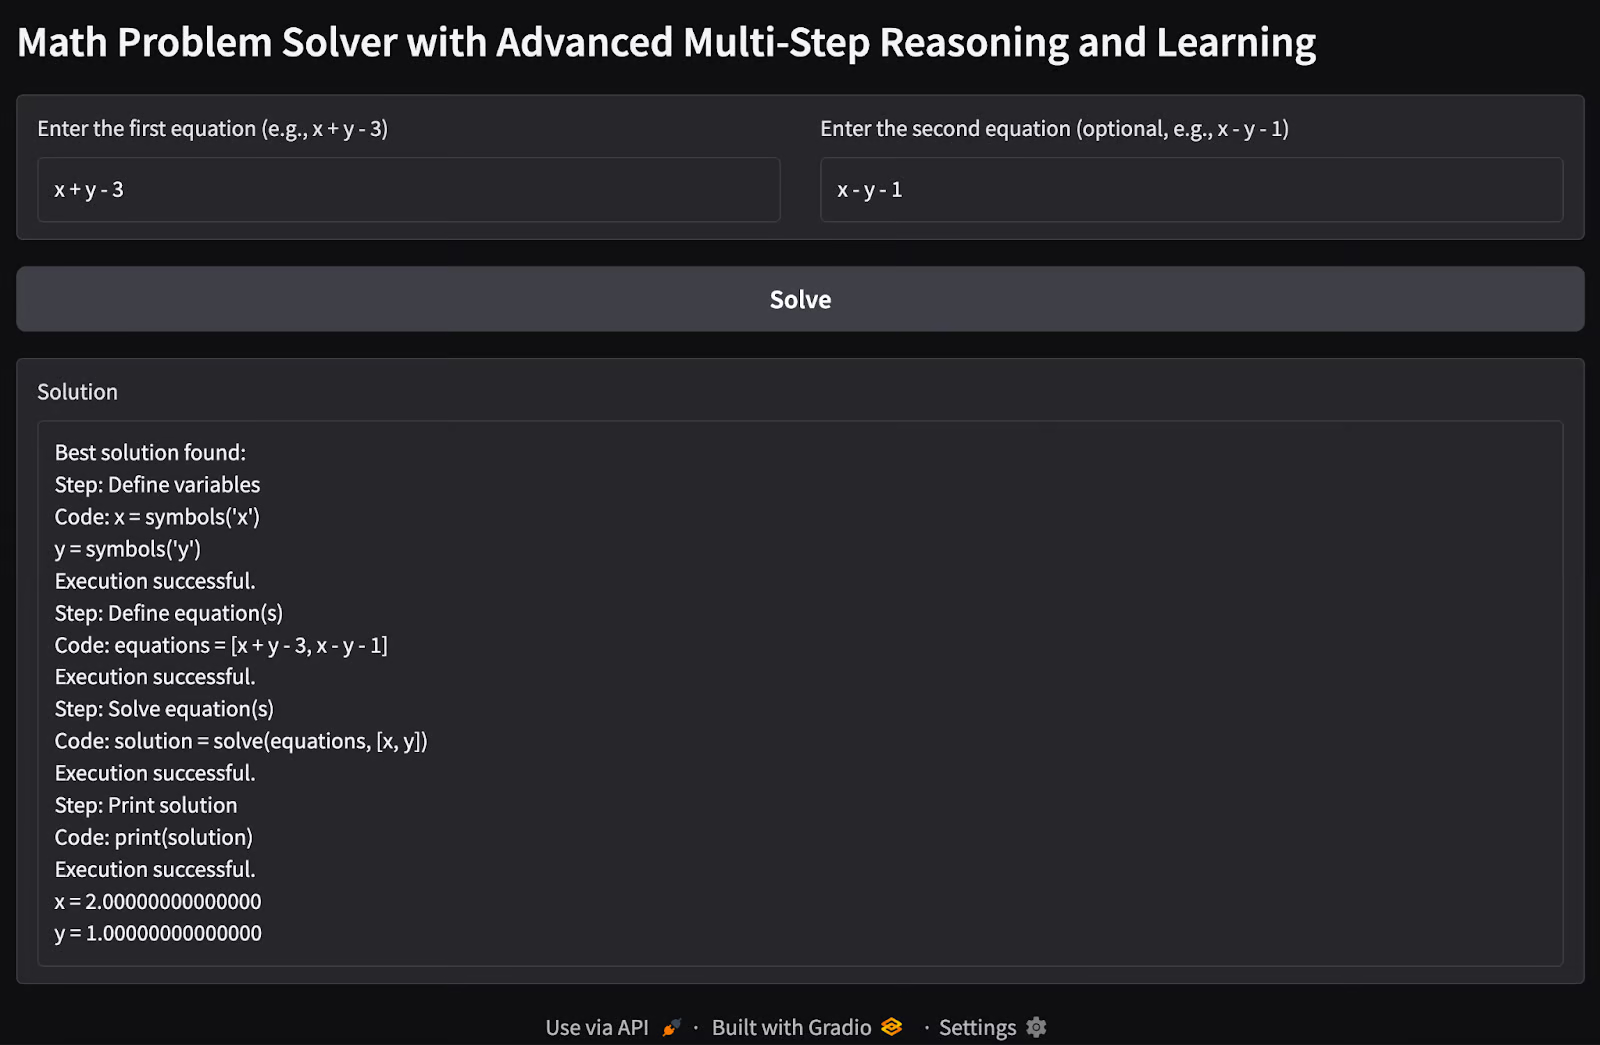
本演示是 rStar-math 方法能力的基础版示例,仍有大量工作可用于扩展其能力。
您可以在 GitHub 上参考 rStar-math 论文的原始代码库。
本演示展示了用于求解数学方程的多步推理的实用实现。通过将神经网络、符号推理与 MCTS 结合,它让我们一窥先进 AI 技术如何处理结构化推理任务。未来的增强有望使其更接近 RStar 框架的完整能力。
通过这些课程学习 AI!
学习路径
学习路径
实践并学习路径你的进步。
使用 Google 继续