
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
एआई अनुप्रयोग विकसित करना
{hours} घंटा
Microsoft का RStar-math पेपर रिइनफोर्समेंट लर्निंग, सांकेतिक तर्क, और Monte Carlo Tree Search (MCTS) के संयोजन से गणितीय समस्याओं को हल करने का एक अभिनव तरीका प्रस्तुत करता है।
इस ब्लॉग में, मैं RStar फ़्रेमवर्क और उसके मुख्य घटकों का विश्लेषण करूंगा। फिर मैं Gradio का उपयोग करके इसके प्रमुख सिद्धांतों को दर्शाने वाले एक सरल इम्प्लीमेंटेशन के माध्यम से आपको चरण-दर-चरण मार्गदर्शन दूंगा। यह डेमो पेपर से प्रेरित है, पर पहुंच को आसान बनाने के लिए कुछ जटिलताओं को सरल किया गया है।
RStar-math का उद्देश्य सांकेतिक तर्क को प्री-ट्रेन्ड न्यूरल मॉडलों की जनरलाइजेशन क्षमता से जोड़ना है। यह फ़्रेमवर्क Monte Carlo Tree Search (MCTS), प्री-ट्रेन्ड भाषा मॉडल्स और रिइनफोर्समेंट लर्निंग जैसे घटकों को एकीकृत करता है, ताकि समस्या-समाधान रणनीतियों की प्रभावी खोज संभव हो सके।
मुख्य विचार यह है कि गणितीय तर्क को संभावित चरणों के संरचित वृक्ष (ट्री) पर एक खोज प्रक्रिया के रूप में प्रस्तुत किया जाए, जहां प्रत्येक नोड किसी आंशिक समाधान या अवस्था का प्रतिनिधित्व करता है।
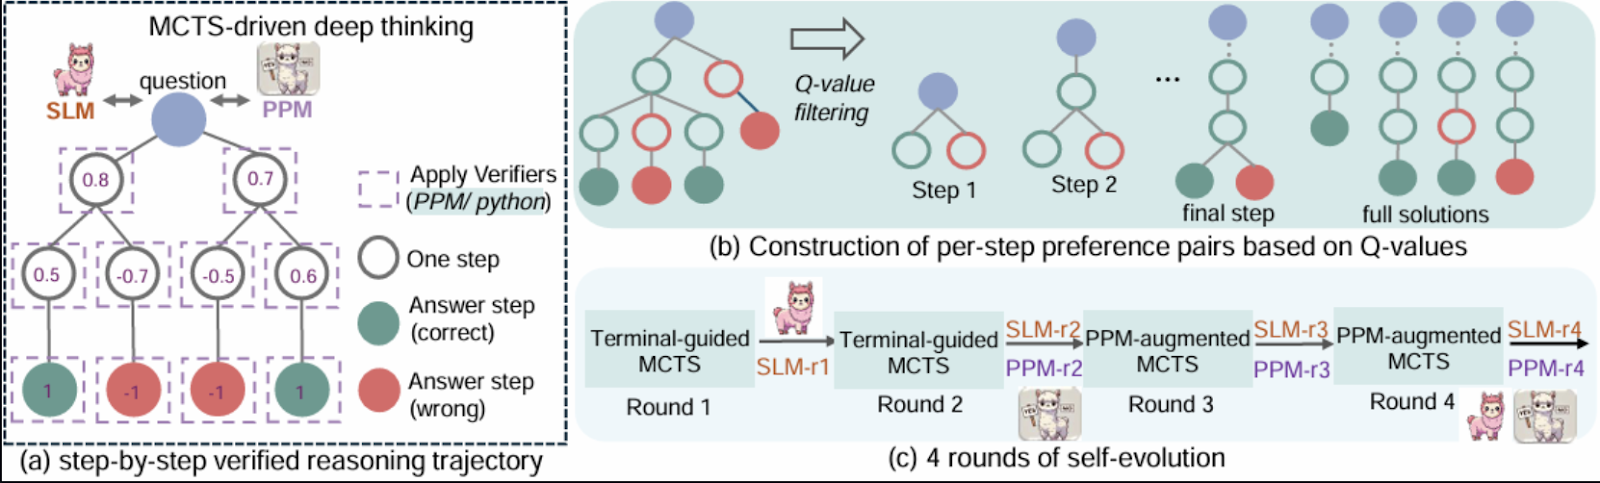
स्रोत: Guan et al., 2025
मेरे लिए rStar-Math को विशेष रूप से रोचक बनाने वाले कुछ कारण:
यह डेमो दिखाता है कि कैसे पॉलिसी मॉडल और रिवॉर्ड मॉडल, sympy लाइब्रेरी के साथ सांकेतिक तर्क का उपयोग करके, गणितीय समस्याओं को संरचित तरीके से हल कर सकते हैं। इस इम्प्लीमेंटेशन की प्रमुख विशेषताएं:
डेमो को सरल और केंद्रित रखने के लिए, पेपर में उल्लिखित कुछ उन्नत फीचर्स इस ट्यूटोरियल के दायरे से बाहर हैं। वे फीचर्स हैं:
डेमो को कई घटकों में विभाजित किया गया है, जिनमें से प्रत्येक RStar पद्धति के एक हिस्से को दर्शाता है। शुरू करने से पहले, सुनिश्चित करें कि आपके पास ये इंस्टॉल हैं:
pip install requests gradio, sympy इसके बाद, इन लाइब्रेरीज़ को इम्पोर्ट करें:
import gradio as gr
import numpy as np
import torch
import re
import torch.nn as nn
import torch.optim as optim
from sympy import symbols, Eq, solve, N, sin, cos, tan, exp, log, E, sympify
from random import choice
अब जब सभी डिपेंडेंसीज़ इंस्टॉल हो चुकी हैं, तो मुख्य घटकों को सेट अप करते हैं।
ये नेटवर्क्स पेपर में वर्णित मॉडलों के हल्के संस्करण हैं, जिनका उपयोग अगला एक्शन भविष्यवाणी करने और सफलता का आकलन करने के लिए किया जाता है। पॉलिसी मॉडल दिए गए समीकरणों को हल करने के अगले कदमों की भविष्यवाणी करता है। यह समस्या के एन्कोडेड रिप्रेजेंटेशन को प्रोसेस करने के लिए एक फीडफॉरवर्ड न्यूरल नेटवर्क का उपयोग करता है।
इसी तरह, रिवॉर्ड मॉडल आंशिक समाधानों का मूल्यांकन करता है ताकि MCTS प्रक्रिया को दिशा मिल सके। दोनों मॉडल PyTorch का उपयोग करके इम्प्लीमेंट किए गए हैं।
class PolicyModel(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.fc1 = nn.Linear(input_size, hidden_size)
        self.fc2 = nn.Linear(hidden_size, output_size)
        self.relu = nn.ReLU()
    def forward(self, x):
        x = self.relu(self.fc1(x))
        x = self.fc2(x)
        return x
class RewardModel(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.fc1 = nn.Linear(input_size, hidden_size)
        self.fc2 = nn.Linear(hidden_size, output_size)
        self.relu = nn.ReLU()
    def forward(self, x):
        x = self.relu(self.fc1(x))
        x = self.fc2(x)
        return x
अगला, हम MCTS ट्रीज़ के लिए एक नोड क्लास बनाते हैं।
TreeNode क्लास MCTS ट्री में नोड्स का प्रतिनिधित्व करता है। प्रत्येक नोड खोज प्रक्रिया में एक अवस्था के अनुरूप होता है, जिसमें शामिल हैं:
class TreeNode:
    """Represents a node in the MCTS tree."""
    def __init__(self, state, parent=None):
        self.state = state  # Current state
        self.parent = parent
        self.children = []
        self.visits = 0
        self.q_value = 0.0  # Accumulated rewards
    def is_fully_expanded(self):
        return len(self.children) > 0
    def best_child(self, exploration_weight=1.4):
        """Select the best child using UCT formula."""
        def uct_value(child):
            return (child.q_value / (child.visits + 1e-6)) + exploration_weight * np.sqrt(np.log(self.visits + 1) / (child.visits + 1e-6))
        return max(self.children, key=uct_value)
    def add_child(self, child_state):
        """Add a child node with the given state."""
        child = TreeNode(state=child_state, parent=self)
        self.children.append(child)
        return child
अब जब हमारे पास बुनियादी संरचना है, तो हम डेमो के मुख्य घटकों पर काम करेंगे।
MathSolver क्लास इस डेमो का कोर है, जो सांकेतिक तर्क को न्यूरल-गाइडेड सर्च के साथ जोड़ता है। यह कई प्रमुख घटकों को लागू करता है:
PolicyModel समीकरणों को हल करने के अगले चरणों की भविष्यवाणी करता है, जबकि RewardModel आंशिक या पूर्ण समाधानों की सफलता का आकलन करता है।
class MathSolver:
    def __init__(self, dataset=None):
        self.dataset = dataset or []  # Dataset of math problems
        self.policy_model = PolicyModel(input_size=128, hidden_size=64, output_size=4)
        self.reward_model = RewardModel(input_size=128, hidden_size=64, output_size=1)
        self.policy_optimizer = optim.Adam(self.policy_model.parameters(), lr=0.001)
        self.reward_optimizer = optim.Adam(self.reward_model.parameters(), lr=0.001)
        self.execution_context = {}
ऊपर की विधि MathSolver क्लास को आरंभ करती है और गणितीय समस्याएँ हल करने के लिए आवश्यक घटक सेट करती है। यह वैकल्पिक रूप से गणितीय समस्याओं का एक डेटासेट लेती है और दो न्यूरल नेटवर्क्स इनिशियलाइज़ करती है: पॉलिसी मॉडल, जो अगला एक्शन भविष्यवाणी करता है, और रिवॉर्ड मॉडल, जो एक्शन्स की सफलता का आकलन करता है।
अब हमारे पास पॉलिसी और रिवॉर्ड फ़ंक्शंस हैं। अगला, हमें इनपुट समीकरणों को पार्स और एन्कोड करना होगा।
समीकरणों को sympy से पार्स किया जाता है और पॉलिसी व रिवॉर्ड मॉडल्स द्वारा प्रोसेसिंग के लिए फीचर वेक्टर में एन्कोड किया जाता है।
def encode_problem(self, problem):
 # Advanced encoding using symbolic representation and problem length
     variables = len(re.findall(r'[a-zA-Z]', problem))
     operators = len(re.findall(r'[\+\-\*/\^]', problem))
      problem_length = len(problem)
      return np.array([variables, operators, problem_length] + [0] * 125)
encode_problem मेथड किसी गणितीय समस्या को मॉडलों के लिए एक निश्चित आकार के संख्यात्मक रिप्रेजेंटेशन में बदलता है। यह चरों की संख्या, ऑपरेटर्स की संख्या और समस्या की लंबाई जैसे फीचर्स निकालता है, और उन्हें 128-डाइमेंशनल NumPy एरे में एन्कोड करता है। यह रिप्रेजेंटेशन समस्या की संरचना को कैप्चर करता है, जिससे प्रभावी मॉडल प्रोसेसिंग संभव होती है।
निम्नलिखित कोड दिए गए समीकरणों को हल करने के लिए अगले चरण जेनरेट करता है, जिनमें वेरिएबल्स को परिभाषित करना, समीकरण बनाना और उन्हें हल करना शामिल है।
def policy_model_predict(self, equation1, equation2=None):
    try:
        equations = []
        if equation1:
            equations.append(sympify(equation1.strip()))  # Sympify only equations
        if equation2:
            equations.append(sympify(equation2.strip()))
        all_variables = set()
        for eq in equations:
            all_variables.update(eq.free_symbols)
        var_definitions = [f"{v} = symbols('{v}')" for v in all_variables]
        steps = [
            ("Define variables", "\n".join(var_definitions)),
            ("Define equation(s)", f"equations = {equations}"),
            ("Solve equation(s)", f"solution = solve(equations, {list(all_variables)})"),
            ("Print solution", "print(solution)")
        ]
        return steps
    except Exception as e:
        print(f"Error during policy model prediction: {e}")
        return []
policy_model_predict फ़ंक्शन SymPy के sympify से इनपुट समीकरणों को पार्स करता है ताकि वे वैध गणितीय अभिव्यक्तियाँ हों। फिर यह समीकरणों में मौजूद सभी चरों की पहचान करता है और SymPy के solve फ़ंक्शन का उपयोग करके उन्हें हल करता है। यह मेथड समस्या-समाधान वर्कफ़्लो के लिए एक उच्च-स्तरीय गाइड के रूप में कार्य करता है।
reward_model_predict मेथड रिइनफोर्समेंट लर्निंग में एक अहम भूमिका निभाता है, क्योंकि यह MCTS रोलआउट्स के दौरान लिए गए एक्शनों के लिए फीडबैक प्रदान करता है।
  def reward_model_predict(self, steps, success):
        encoded_steps = self.encode_problem(str(steps))
        encoded_steps = torch.tensor(encoded_steps, dtype=torch.float32)
        reward = self.reward_model(encoded_steps)
        return reward.item() if success else -reward.item()
यह फ़ंक्शन समस्या-समाधान चरणों को संख्यात्मक प्रारूप में एन्कोड करता है और उन्हें रिवॉर्ड मॉडल से मूल्यांकित करवाता है, सफलता पर पॉज़िटिव और असफलता पर नेगेटिव रिवॉर्ड लौटाता है। यह फीडबैक पॉलिसी मॉडल को ट्रेन करता है, जिससे वह प्रभावी एक्शनों को प्राथमिकता दे और निर्णय-प्रक्रिया बेहतर हो। पॉलिसी और रिवॉर्ड प्रीडिक्शन फ़ंक्शंस तैयार होने के बाद, अब हम निष्पादन कार्य पर काम कर सकते हैं।
यह मेथड बहु-चर समाधानों को ट्यूपल्स या डिक्शनरीज़ के रूप में संभालता है और SymPy के N फ़ंक्शन का उपयोग करके सांकेतिक परिणामों को संख्यात्मक समीपानुमान (numerical approximations) में बदल देता है।
    def execute_code(self, code):
        try:
            # Ensure necessary imports and variables are in the execution context
            exec("from sympy import symbols, Eq, solve, N, sin, cos, tan, exp, log, E", self.execution_context)
            # Dynamically initialize variables in the context
            for var_def in self.execution_context.get('var_definitions', []):
                exec(var_def, self.execution_context)
            exec(code, self.execution_context)
            if "solution" in self.execution_context:
                symbolic_solution = self.execution_context["solution"]
                # Handle multi-variable solutions as tuples
                if isinstance(symbolic_solution, list):
                    self.execution_context["solution"] = [tuple(map(N, sol)) if isinstance(sol, tuple) else N(sol) for sol in symbolic_solution]
                elif isinstance(symbolic_solution, dict):
                    self.execution_context["solution"] = {k: N(v) for k, v in symbolic_solution.items()}
                else:
                    self.execution_context["solution"] = N(symbolic_solution)
            return True
        except Exception as e:
            print(f"Error executing code: {e}")
            return False
यह मेथड सटीक गणना सुनिश्चित करता है और विभिन्न समाधान फ़ॉर्मैट्स को लचीले तरीके से हैंडल करता है। त्रुटि की स्थिति में, यह समस्या लॉग करता है और False लौटाता है, जिससे मजबूत एरर हैंडलिंग बनी रहती है।
MCTS मेथड बार-बार सर्वोत्तम अवस्थाओं का चयन करता है, सर्च ट्री का विस्तार करता है और संभावित समाधानों का सिमुलेशन करता है। सिमुलेशन्स से प्राप्त रिवॉर्ड्स को बैक-प्रोपेगेट कर निर्णय-प्रक्रिया को बेहतर किया जाता है।
def mcts(self, equation1, equation2=None, num_rollouts=10):
    root = TreeNode(state=(equation1, equation2))
    for _ in range(num_rollouts):
        # Selection
        node = root
        while node.is_fully_expanded() and node.children:
            node = node.best_child()
        # Expansion
        if not node.is_fully_expanded():
            steps = self.policy_model_predict(*node.state)
            for step, code in steps:
                child_state = (step, code)
                node.add_child(child_state)
        # Simulation
        success = True
        for step, code in steps:
            if not self.execute_code(code):
                success = False
                break
        # Backpropagation
        reward = self.reward_model_predict(steps, success)
        while node:
            node.visits += 1
            node.q_value += reward
            node = node.parent
    return root.best_child().state if root.children else None
mcts मेथड चार मुख्य चरणों को क्रमिक रूप से करता है:
policy_model_predict मेथड का उपयोग करके नए चाइल्ड नोड्स बनाए जाते हैं।reward_model_predict से गणना कर ट्री में ऊपर की ओर प्रसारित किया जाता है ताकि नोड वैल्यू अपडेट हों। निर्धारित संख्या के रोलआउट्स के बाद, यह मेथड सर्वश्रेष्ठ चाइल्ड नोड की अवस्था लौटाता है, जो खोज के दौरान एक्सप्लोर किया गया सबसे आशाजनक समाधान दर्शाता है।
solve मेथड पूरे प्रोसेस का समन्वयन करता है—समीकरण पार्स करने से लेकर समाधान निष्पादित करने और उसे वैलीडेट करने तक।
def solve(self, equation1, equation2=None):
    self.execution_context = {}
    steps = self.policy_model_predict(equation1, equation2)
    variables = set()
    for eq in [equation1, equation2] if equation2 else [equation1]:
        if eq:
            variables.update(sympify(eq.strip()).free_symbols)
    self.execution_context['var_definitions'] = [f"{v} = symbols('{v}')" for v in variables]
    steps_output = ["Best solution found:"]
    for step, code in steps:
        steps_output.append(f"Step: {step}")
        steps_output.append(f"Code: {code}")
        if self.execute_code(code):
            steps_output.append("Execution successful.")
        else:
            steps_output.append("Execution failed.")
    if "solution" in self.execution_context:
        final_answer = self.execution_context["solution"]
        if isinstance(final_answer, dict):
            for var, value in final_answer.items():
                steps_output.append(f"{var} = {value}")
        elif isinstance(final_answer, list):
            for solution in final_answer:
                if isinstance(solution, tuple):
                    for idx, var in enumerate(variables):
                        steps_output.append(f"{list(variables)[idx]} = {solution[idx]}")
                else:
                    steps_output.append(f"Solution: {solution}")
        else:
            steps_output.append(f"Final Answer: {final_answer}")
    else:
        steps_output.append("No final answer found.")
    return "\n".join(steps_output)
solve मेथड एक या दो उपयोगकर्ता-प्रदत्त समीकरणों को प्रोसेस करता है: यह एक्ज़ीक्यूशन कॉन्टेक्स्ट इनिशियलाइज़ करता है और policy_model_predict के जरिए चरण जनरेट करता है। यह प्रत्येक चरण को निष्पादित करता है, प्रगति लॉग करता है, और सफलता/विफलता रिपोर्ट करता है। सिंगल और मल्टी-वैरियेबल दोनों प्रकार के समाधानों को स्पष्टता के लिए वेरिएबल नाम और मान सहित फ़ॉर्मैट किया जाता है। यदि कोई समाधान नहीं मिलता, तो उपयुक्त संदेश दिखाया जाता है।
अब सभी मुख्य घटक तैयार हैं, इसलिए अगला कदम Gradio ऐप पर काम करना है।
Gradio इंटरफ़ेस उपयोगकर्ताओं को समीकरण (एक या अधिक) इनपुट करने, उन्हें हल करने और इंटरैक्टिव रूप से परिणाम देखने देता है।
with gr.Blocks() as app:
    gr.Markdown("# Math Problem Solver with Advanced Multi-Step Reasoning and Learning")
    with gr.Row():
        equation1_input = gr.Textbox(label="Enter the first equation (e.g., x + y - 3)", placeholder="x + y - 3")
        equation2_input = gr.Textbox(label="Enter the second equation (optional, e.g., x - y - 1)", placeholder="x - y - 1")
    solve_button = gr.Button("Solve")
    solution_output = gr.Textbox(label="Solution", interactive=False)
    solve_button.click(solve_math_problem, inputs=[equation1_input, equation2_input], outputs=[solution_output])
app.launch(debug=True)
उपरोक्त कोड उन्नत मल्टी-स्टेप रीजनिंग के साथ गणितीय समीकरण हल करने के लिए Gradio यूज़र इंटरफ़ेस बनाता है। इंटरफ़ेस gr.Blocks कंटेनर में रैप किया गया है, जिसमें gr.Textbox का उपयोग करते हुए दो इनपुट फ़ील्ड शामिल हैं: पहला समीकरण (अनिवार्य) और दूसरा समीकरण (वैकल्पिक) के लिए।
आउटपुट एकल gr.Textbox में "Solution" लेबल के साथ दिखाया जाता है। interface.launch() कमांड ब्राउज़र में Gradio ऐप लॉन्च करता है, और debug=True फ्लैग त्रुटियों के समाधान के लिए विस्तृत लॉग सक्षम करता है।
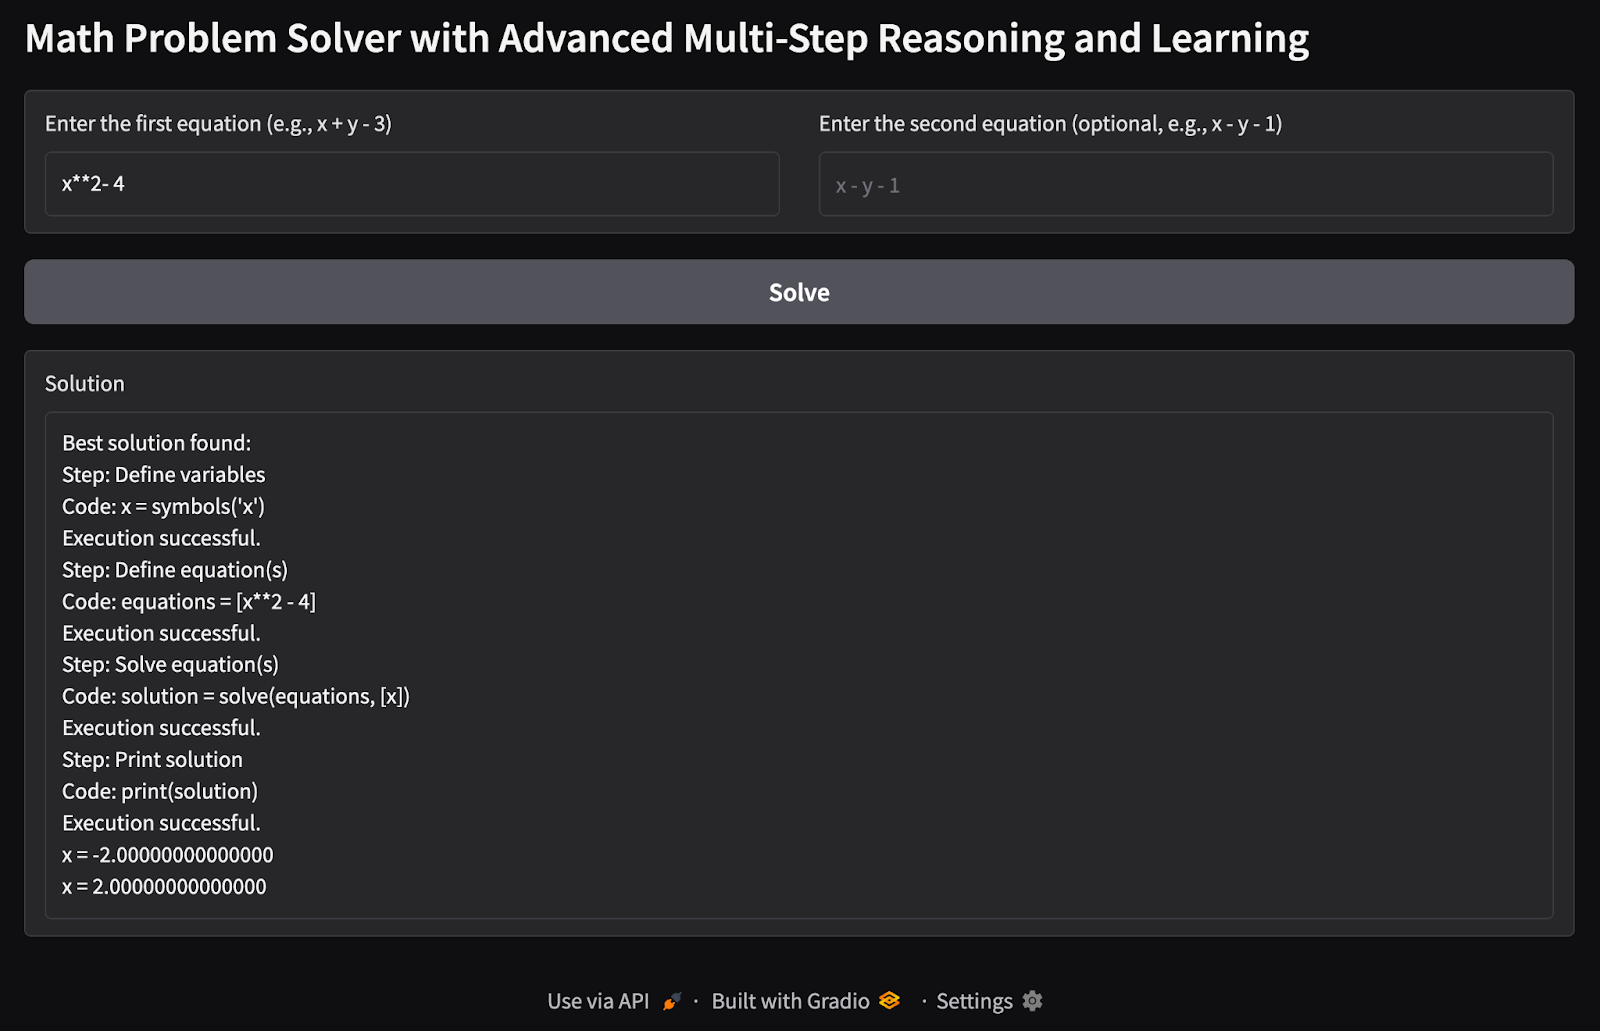
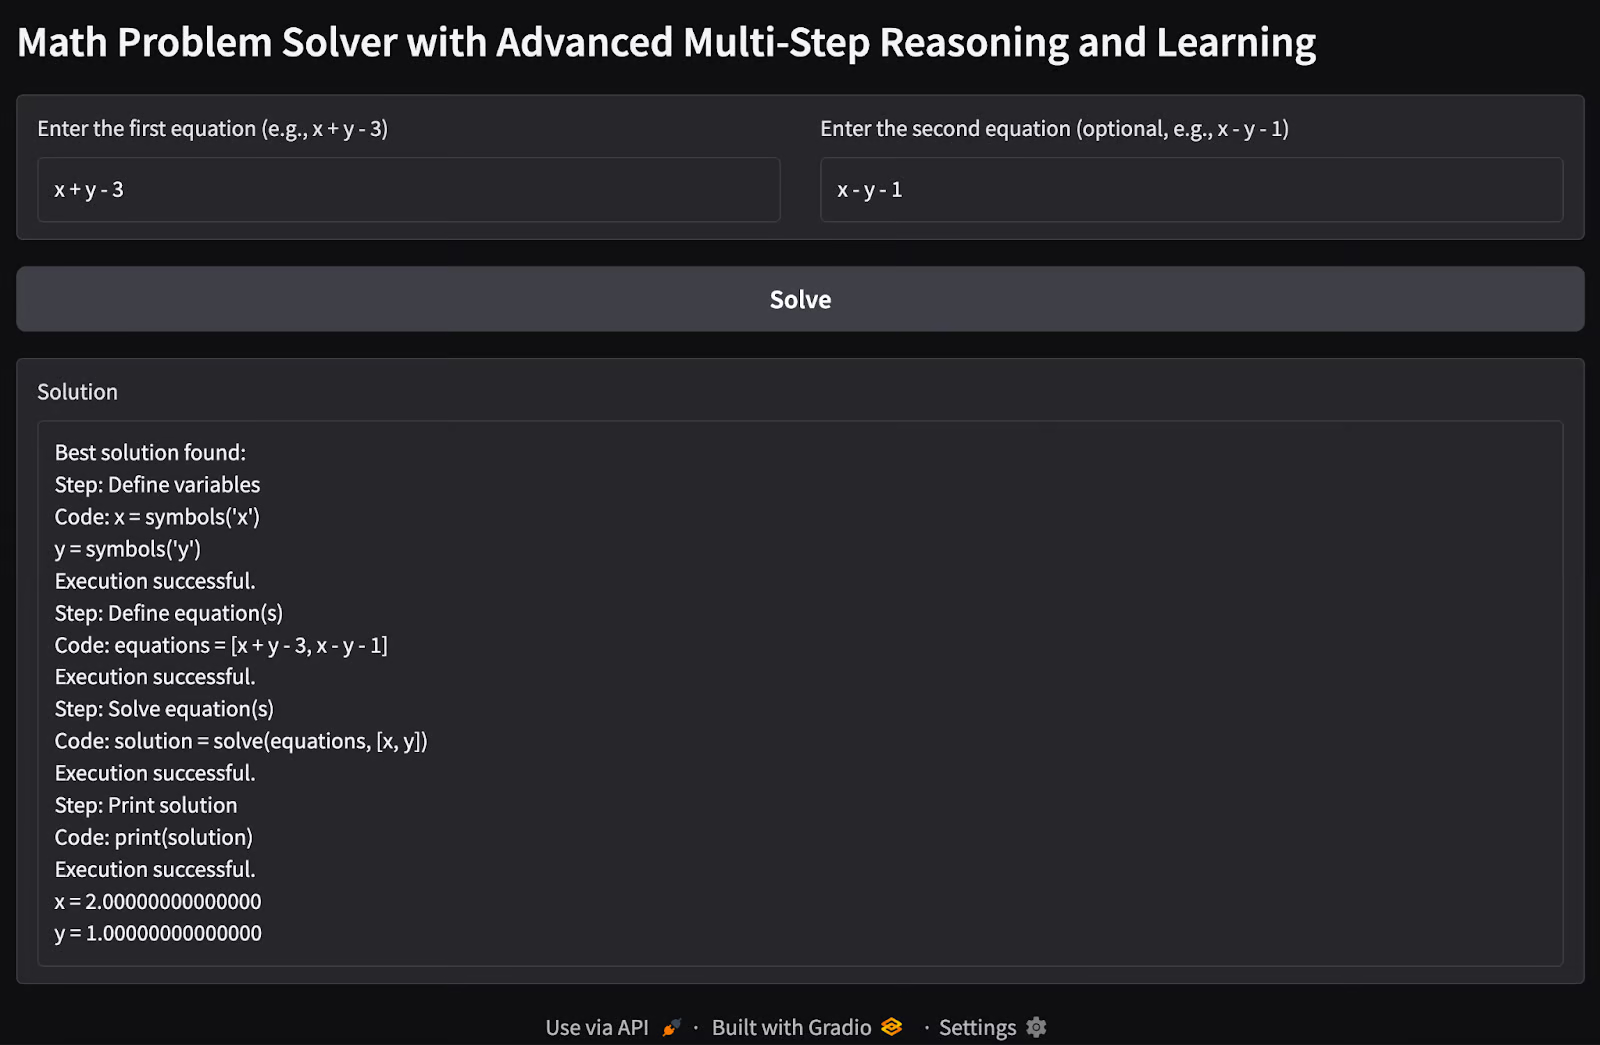
अब हमारे Math Problem Solver ऐप का परीक्षण करने का समय है। यहां कुछ परीक्षण हैं जो मैंने चलाए:
1. एकल चर, एकल समीकरण: मैंने एकल समीकरण दिए जाने पर एकल चर x के संभावित मान खोजने की कोशिश की।
2. बहु-चर, बहु-समीकरण समस्या: मैंने दो समीकरणों के साथ दो-चर वाली समस्या पास की ताकि चरों x और y के संभावित मान मिल सकें।
यह डेमो rStar-math विधि की क्षमताओं से हम क्या हासिल कर सकते हैं, उसकी बुनियादी झलक देता है। इसकी क्षमताओं का विस्तार करने के लिए अभी बहुत कुछ किया जा सकता है।
आप rStar-math पेपर के मूल रिपॉज़िटरी को GitHub पर देख सकते हैं।
यह डेमो गणितीय समीकरणों को हल करने के लिए मल्टी-स्टेप तर्क का एक व्यावहारिक इम्प्लीमेंटेशन प्रदर्शित करता है। न्यूरल नेटवर्क्स, सांकेतिक तर्क और MCTS को जोड़कर, यह दिखाता है कि उन्नत AI तकनीकें संरचित रीजनिंग कार्यों को कैसे संभाल सकती हैं। भविष्य के सुधार इसे RStar फ़्रेमवर्क की पूर्ण क्षमताओं के और करीब ला सकते हैं।
इन पाठ्यक्रमों के साथ AI सीखें!
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}